Digitális kutatásmódszertan történészeknek
Online tankönyv történelem szakos hallgatóknak
Szerkesztette: Ring Orsolya
v0.1 – 2026. augusztus
Előszó
A digitális bölcsészeti módszerek nagy hatással lehetnek a történettudomány kutatási módszertanára, hiszen eszközeik használatával lehetőség nyílik kiemelkedően nagy adathalmazok elemzésére, korábbi vagy új kutatási kérdések új módszerekkel történő megválaszolására. Az új módszerek és eszközök adatközpontúbb és alulról felfelé építkező megközelítést tesznek lehetővé a történeti kutatásokban, de egyben megkövetelik, hogy a történész módszertani eszköztárának részévé váljon a forráskritika mellett az eszközkritika is.
Ennek a tankönyvnek az a célja, hogy történelem szakos hallgatóknak áttekintést adjon a történeti kutatásokban leggyakrabban használt digitális módszerekről. A könyv minden esetben történettudományi példákon keresztül mutatja be az adott témát, és gyakorlatorientált: a lehető legtöbb helyen olyan feladatokat ad, amelyekben Ön ki is próbálhatja a megtanultakat. Éppen ezért kizárólag olyan alkalmazásokkal dolgozunk, amelyek legalább próbaverzióban ingyenesen bárki számára elérhetők.
A tankönyv a Bevezetés a történeti kutatás módszereibe és segédleteibe című tárgy anyagára épít. Erre támaszkodunk, de nem feltételezünk előzetes digitális készségeket.
Kinek szól ez a könyv?
Elsősorban azoknak a történelem szakos hallgatóknak, akik most kezdik el önállóan használni a digitális kutatási eszközöket – függetlenül attól, a képzés melyik szakaszában járnak. Haszonnal forgathatja azonban mindenki, aki magyar történeti forrásokkal és szakirodalommal dolgozik.
Hogyan épül fel a könyv?
A könyv öt nagy egységre tagolódik, amelyek a kutatási folyamat logikáját követik:
- Alapok – hogyan épül fel egy történeti kutatás, és mit jelent a digitális bölcsészet, illetve a digitális történettudomány.
- Szakirodalom – hol és hogyan keressünk szakirodalmat, hogyan azonosítjuk a szerzőket és a műveket.
- Források – mi a forrás, hogyan kezeljük a hivatkozásainkat, milyen levéltári keresőfelületek állnak rendelkezésre, mit jelent a digitalizálás, az OCR és a digitális forráskiadás.
- Adat a történettudományban – konkrét történeti adatbázisok bemutatása lépésről lépésre.
- Kitekintés – mesterséges intelligencia, vizualizáció, adatkezelés és adatvédelem.
A kötetet függelék zárja: szószedet és linkgyűjtemény. Az egyes fejezetek forrásait a fejezetek végén álló Felhasznált és ajánlott irodalom szakaszok sorolják fel.
Kolofon
Digitális kutatásmódszertan történészeknek
Online tankönyv történelem szakos hallgatóknak
| Kiadó műhely | Eötvös Loránd Tudományegyetem, Bölcsészettudományi Kar – Történelem Segédtudományai Tanszék |
| Kurzus | BBN-DIG-001/TÖR |
| Szerkesztő, tárgyfelelős | Ring Orsolya |
| Szerzők | Bakó Zsigmond, Gyulai Katalin, Havasi-Mészáros Dániel, Kulcsár Anna, Ring Orsolya, Selmeczi Péter |
| Online | https://eltebtktortsegedtud.github.io/Digitalis_kutatasmodszertan_tortenesz_hallgatoknak/ |
| Verzió / dátum | v0.1 – 2026. augusztus |
| Licenc | CC BY-NC-SA 4.0 – a kötet szövegére és a hozzá készült ábrákra |
A fejezetek szerzői
Az alábbi táblázat fejezetenként sorolja fel a szerzőket. Ugyanez az adat minden fejezet elején, a fejezetfejlécben is megtalálható.
I. Alapok
| Fejezet | Szerző |
|---|---|
| Hogyan épül fel egy történeti kutatás? | Ring Orsolya |
| Digitális bölcsészet és digitális történettudomány | Ring Orsolya |
| Digitalizálás és optikai karakterfelismerés (OCR) | Selmeczi Péter |
II. Mi a szakirodalom?
| Fejezet | Szerző |
|---|---|
| Könyvtári keresőfelületek: katalógusok és közös keresők | Ring Orsolya |
| Cikkszintű és nemzetközi keresés | Ring Orsolya |
| Magyar Tudományos Művek Tára (MTMT) | Selmeczi Péter |
| Repozitóriumok és nyílt hozzáférés | Ring Orsolya |
| Academia.edu és ResearchGate | Selmeczi Péter |
| Szerzői és dokumentumazonosítók: ORCID és DOI | Selmeczi Péter |
| Szaktárs: magyar szakkönyvek egy felületen | Ring Orsolya |
| Az Arcanum tudományos gyűjteményei | Ring Orsolya |
| Hivatkozáskezelés: a Zotero | Ring Orsolya |
III. Mi a forrás?
| Fejezet | Szerző |
|---|---|
| Mi a forrás? | Ring Orsolya |
| A magyar levéltári rendszer és a levéltári források | Ring Orsolya |
| Elektronikus Levéltári Portál (ELP) | Bakó Zsigmond |
| Levéltári Információs Rendszer (LIR) | Havasi-Mészáros Dániel |
| Digitalizált sajtó és térkép: az Arcanum forrásgyűjteményei | Gyulai Katalin |
| Europeana: európai közgyűjtemények egy felületen | Ring Orsolya |
| Fortepan: közösségi fotóarchívum | Ring Orsolya |
| Filmhíradók Online: a mozgókép mint forrás | Ring Orsolya |
| Oral history: az elbeszélt emlékezet mint forrás | Ring Orsolya |
| Digitális forráskiadás | Ring Orsolya |
IV. Adat a történettudományban
| Fejezet | Szerző |
|---|---|
| Adat a történettudományban | Ring Orsolya |
| Mi az adatbázis? | Ring Orsolya |
| Hungaricana Közgyűjteményi Portál | Ring Orsolya |
| AdatbázisokOnline: a levéltári adatbázisok gyűjtőhelye | Ring Orsolya |
| Budapest Időgép | Kulcsár Anna |
| Térbeli adatbázisok: amikor az adat egy helyhez tartozik | Ring Orsolya |
| Állambiztonsági archontológia | Kulcsár Anna |
| Tüntetések, demonstrációk 1988–1989 | Havasi-Mészáros Dániel |
| Családfakutatás: felületek és forráskritika | Ring Orsolya |
| A táblázattól az adatbázisig: Excel és Access (haladó) | Ring Orsolya |
| Adatbázisépítés saját adatokon (haladó) | Ring Orsolya |
V. Kitekintés
| Fejezet | Szerző |
|---|---|
| Mesterséges intelligencia a történeti kutatásban | Ring Orsolya |
| Kutatási eredmények vizualizálása | Ring Orsolya |
| Adatkezelés és adatvédelem | Ring Orsolya |
| Adatok publikálása, dokumentáció, etika | Ring Orsolya |
Az ábrákról
A kötet kétféle képet használ:
- Képernyőképek. Az adott felületről egy megadott időpontban készült felvételek; a felvétel dátuma minden esetben ott áll a képaláírásban. A bemutatott felületek időközben megváltozhattak.
- Magyarázó ábrák. A kötethez készült sematikus rajzok (folyamatábrák, fogalmi vázlatok). Ezek nem képernyőképek, hanem a szöveg állításait összefoglaló szerkesztői ábrák.
Ahol egy ábra nem a kötethez készült, a képaláírás megnevezi a forrását. Az egyes fejezetek szöveges forrásait a fejezetek végén álló Felhasznált és ajánlott irodalom szakaszok sorolják fel.
Felhasználás és hivatkozás
A kötet szövege és a hozzá készült magyarázó ábrák a Creative Commons Nevezd meg! – Ne add el! – Így add tovább! 4.0 licenc alatt állnak: szabadon másolhatók, terjeszthetők és átdolgozhatók, ha megnevezi a szerzőket, nem használja őket kereskedelmi célra, és a származékos művet ugyanezzel a licenccel adja tovább.
Figyelem A képernyőképekre ez nem vonatkozik. A kötet mások által üzemeltetett felületekről készült képernyőképeket is tartalmaz. Ezek az illető szolgáltatás és a rajtuk megjelenő tartalom jogosultjait illetik, és a kötetben oktatási célú idézésként szerepelnek, a forrás megnevezésével. Ha egy ilyen képet újra felhasználna, ahhoz külön engedélyt kell kérnie – vagy készítsen saját képernyőképet.
Hivatkozási rend
A kötet a Korall folyóirat hivatkozási rendjét követi.
Online források esetén a hivatkozás mindig tartalmazza az elérés
dátumát, egységesen elérve: ÉÉÉÉ. HH. NN. alakban.
Használati útmutató
Ez a rövid fejezet elmagyarázza, hogyan olvassa a könyvet: mit jelentenek a színes dobozok, mi a kötelező és mi az opcionális anyag, és hogyan érdemes dolgozni a feladatokkal.
Három tartalmi szint
A tankönyv három tartalmi szintet különböztet meg, és ezeket vizuálisan is elkülöníti:
| Szint | Mit jelent? |
|---|---|
| Törzsanyag | A folyó szöveg. Kötelező anyag, számon kérhető. |
| Kitérő | A „Mélyebben” doboz. Opcionális, érdeklődőknek. |
| Továbblépés | A fejezetek végén álló ajánlott irodalom és linkgyűjtemény. |
A dobozok
Tanulási célok Minden fejezet elején 3–5 mérhető cél. Ha a fejezet végén mindegyiket ki tudja pipálni, akkor jó úton jár. Ezek a célok fogalmazzák meg, mit kell tudnia csinálni – nem azt, hogy mit „ért”.
Definíció Fogalom: definíciós doboz
Egy fogalom pontos meghatározása. Minden definíciós doboz tartalma változatlan formában bekerül a kötet végén álló Szószedetbe is.
Tipp Praktikus tanács: billentyűkombináció, ajánlott munkamenet, gyorsítótrükk. A gyakorlati fejezetekben itt találja a „Ha elakad” típusú segítséget is.
Figyelem Tipikus hiba, csapda, jogi vagy adatvédelmi buktató.
Mélyebben Haladó, opcionális tartalom: részletes technikai magyarázat, tudománytörténeti kontextus, ritka funkció.
Példa Rövid, konkrét illusztráció egy fogalomra vagy eljárásra. A hosszabb, kibontott példa az esettanulmányba kerül.
Esettanulmány Hosszabb, végigvezetett példa: konkrét kutatási kérdés → forrásválasztás → lépések → részeredmények → reflexió.
Feladat Önálló gyakorlat. Megoldókulcs szándékosan nincs a tankönyvben.
Önellenőrző kérdések
A fejezetek végén álló önellenőrző kérdéseknél a helyes válasz először rejtve van. Kattintson a „Válasz megjelenítése” feliratra – de csak azután, hogy magában megfogalmazta a saját válaszát.
Válasz megjelenítése
Így néz ki egy megjelenített válasz.
Hivatkozási rend
A könyv a Korall folyóirat hivatkozási rendjét követi. Online források esetén mindig szerepel az elérés dátuma, mert a webes tartalmak változnak.
Figyelem A könyvben szereplő képernyőképek egy adott időpontban készültek. A bemutatott felületek időközben megváltozhattak. Ha eltérést tapasztal, a leírt logika (mit keresünk, milyen lépésekben) akkor is használható marad – a gombok helye változhat, a kutatási munkamenet nem.
Mielőtt az első dolgozatát beadja
Egy dolog van, amit érdemes már az első héten elolvasni: a Mesterséges Intelligencia (MI)-használatának szabályozása. Ez mondja meg, mit szabad egy beadandó dolgozatban mesterséges intelligenciával csinálni és mit nem. A megsértése az egyetemi szabályok szerint a plágiummal azonos megítélés alá esik.
A BA-s és OT-s hallgatóra vonatkozó tiltott, feltételes és megengedett használatokat, valamint a kötelező nyilatkozatot a Mesterséges intelligencia a történeti kutatásban fejezet 4. szakasza tárgyalja. Azt, hogy mit nem szabad soha MI-eszköz bemeneteként felhasználni, az Adatkezelés és adatvédelem fejezet 5. szakasza is összefoglalja.
Hogyan épül fel egy történeti kutatás?
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 90 perc |
| Előfeltétel | Bevezetés a történeti kutatás módszereibe és segédleteibe c. tárgy |
| Verzió / dátum | v0.1 / 2026. augusztus |
Miről szól ez a fejezet?
Ez a fejezet a tankönyv fogalmi kiindulópontja. Áttekinti, mi jellemzi a történettudományt mint tudományterületet, milyen korlátok között dolgozik a történész, majd végigveszi egy történeti kutatás megtervezésének lépéseit – a kutatási kérdés megfogalmazásától a dolgozat szerkezetének felvázolásáig. Az itt tisztázott fogalmakra és munkamenetre a könyv minden további fejezete épít: amikor később egy adatbázis vagy egy eszköz használatát tanuljuk, mindig az itt leírt kutatási folyamat valamelyik lépését támogatjuk vele.
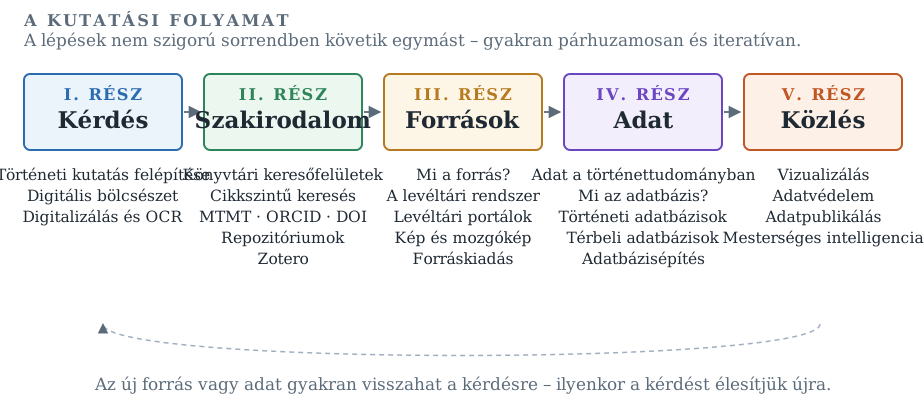
Az alábbi ábra azt mutatja, hogyan felel meg a kutatási folyamat öt szakasza a könyv öt részének. A HTML-változatban a fejezetcímek kattinthatók: innen bármikor oda ugorhat, ahol az adott lépés eszközeit tárgyaljuk.
1. ábra. A kutatási folyamat öt szakasza és a könyv öt része közötti kapcsolat. A fejezetnevek kattinthatók.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- megkülönbözteti a múlt eseményeit a történettudomány által róluk alkotott képtől, és példával alátámasztja, miért változik ez a kép;
- felsorolja és saját szavaival elmagyarázza a múlt teljes körű megismerhetőségének forrásoldali és a történész személyéből fakadó korlátait;
- egy megadott kutatási kérdésről eldönti, hogy specifikus, megválaszolható, releváns és analitikus-e, és indokolja a döntését;
- saját témájához megfogalmaz egy jól körülhatárolt kutatási kérdést, megadva az időbeli és térbeli kereteket;
- felvázolja egy történeti kutatás megtervezésének fő lépéseit, és elhelyezi bennük a digitális eszközök szerepét.
Bevezetés
A történettudomány hagyományosan a bölcsészettudományok körébe tartozik, de kapcsolódik a társadalomtudományokhoz is. Alapvetően kutatáson, a releváns források összegyűjtésén, azok kritikus értelmezésén és a következtetések levonásán alapul. A történettudomány paradigmákkal, azaz értelmezési mintákkal dolgozik, amelyek folyamatosan változnak.
Ebből következik a fejezet egyik legfontosabb állítása: a történelem nem egyszerűen az egykori események kronológiája. A múlt eseményeit a maguk teljességében nem lehet rekonstruálni, elmesélni. A történész munkája során egyfajta olvasatát adhatja az egykor történteknek azáltal, hogy a rendelkezésére álló forrásokat elemzi és értelmezi. Az újonnan fellelt források és a módszertani újítások révén a történelem egyes eseményeiről, jelenségeiről alkotott képünk folyamatosan változik.
Figyelem A történész soha nem egészítheti ki forrásait fikciókkal, amelyeket nem tud alátámasztani – de nem is hallgathat el olyan tényeket, amelyekre nézve forrásai vannak, még akkor sem, ha azok ellentmondanak korábbi tudásának.
A történésznek munkája során nem elég csak a források tartalmát visszaadnia: értelmeznie is kell azokat. Közben tisztában kell lennie azzal, hogy a források szubjektívek – azaz egy bizonyos nézőpontot mutatnak be – és töredékesek, azaz nem képesek az egykori eseményeket a maguk teljességében leírni.
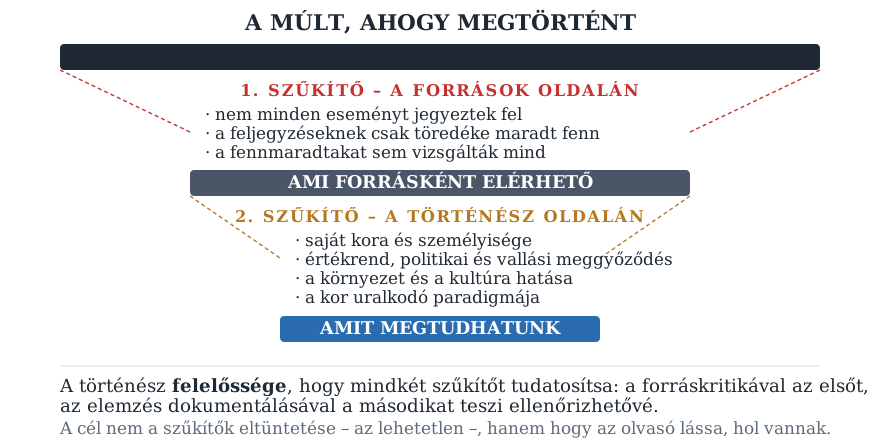
1. Mit tudhatunk meg a múltról?
1.1 A megismerés forrásoldali korlátai
A múlt teljes körű megismerhetőségét több tényező korlátozza:
- nem minden eseményt jegyeztek fel;
- a feljegyzéseknek csak töredéke maradt fenn;
- a fennmaradt források közül nem mindegyiket vizsgálták – például mert az egyes források nem egy időben kerülnek napvilágra.
Definíció Fogalom: paradigma (a történettudományban)
Értelmezési minta: az a fogalmi és módszertani keret, amelyen belül egy adott korszak történészei a kérdéseiket megfogalmazzák és a forrásaikat értelmezik. A paradigmák folyamatosan változnak, és ezzel együtt változik a múltról alkotott képünk is.
1.2 A történész személyes korlátai
A forrásoldali korlátok mellett számolni kell a történész személyes korlátaival is. A történész
- nem tudja teljesen függetleníteni magát saját korától és személyiségétől;
- befolyásolhatja az értékrendje, politikai nézetei, vallási meggyőződése;
- a környezete és a kultúrája is hat a munkájára.
A történész felelőssége, hogy mindezeknek tudatában legyen, minél inkább próbáljon meg függetlenedni tőlük, és forrásaira támaszkodva, szigorú forráskritikát alkalmazva, elemzéseit dokumentálva dolgozzon.
Mélyebben Az itt vázolt áttekintés a Bevezetés a történelemtudományba és a történelemkutatás módszereibe (szerk. Kerepeszki Róbert – Schrek Katalin, Pécs, Kronosz Kiadó, 2023) Történelem és történettudomány című fejezetén alapul. Ezt a kötetet a kurzus egészéhez kiegészítő irodalomként ajánljuk.
2. Egy történeti kutatás megtervezése
Az alábbiakban egy történeti kutatás megtervezésének fontosabb lépéseit foglaljuk össze. Fontos megjegyezni, hogy ezek a lépések nem feltétlenül követik szigorúan egymást: sokszor párhuzamosan vagy iteratív módon történnek. A kutatás során új szempontok merülhetnek fel, amelyek miatt módosítani kell az eredeti tervet.
2.1 A kutatási téma pontos meghatározása
a) A vizsgálni kívánt történelmi időszak és földrajzi terület behatárolása
- Pontosan meg kell határozni a vizsgált korszak kezdő- és végpontját (például „1867–1918” vagy „a Rákóczi-szabadságharc időszaka”).
- Indokolni kell, miért épp ezt az időszakot választottuk.
- Figyelembe kell venni, hogy az időkeret kezelhető mennyiségű forrásanyagot jelentsen.
- A vizsgált terület pontos meghatározása (lehet egy ország, régió, város vagy akár több helyszín összehasonlítása).
- A korabeli közigazgatási határok figyelembevétele.
- A terület történeti kontextusának tisztázása.
b) A kutatás fókuszának és főbb kérdéseinek megfogalmazása
- 2–3 főbb kutatási kérdés meghatározása.
- Több alkérdés kidolgozása.
- A kérdések legyenek konkrétak és megválaszolhatók a rendelkezésre álló források alapján.
c) A téma aktualitásának és jelentőségének indoklása.
2.2 A szakirodalom áttekintése
a) Historiográfiai áttekintés
- A téma kutatástörténetének feldolgozása.
- A különböző történészi iskolák, megközelítések azonosítása.
- A téma nemzetközi és hazai szakirodalmának feltérképezése.
b) A szakirodalom rendszerezése
- Alapmunkák, monográfiák összegyűjtése.
- Szakcikkek, tanulmányok felkutatása.
- A legújabb kutatási eredmények számbavétele.
- Bibliográfia készítése és kategorizálása.
c) Szakirodalmi viták feltárása
- Az eltérő történészi értelmezések azonosítása.
- A vitás kérdések tisztázása.
- A különböző álláspontok ütköztetése.
Tipp Ezt a lépést támogatják a könyv II. részének fejezetei: az MTMT, a könyvtári és tudományos keresőfelületek, valamint a repozitóriumok. A bibliográfia rendszerezéséhez a Zotero hivatkozáskezelőt ajánljuk.
2.3 Források azonosítása és kritikai értékelése
a) Forrástípusok
- Hivatalos iratok, jegyzőkönyvek, személyes dokumentumok.
- Korabeli sajtótermékek.
- Visszaemlékezések, naplók, levelezések.
- Tárgyi emlékek, régészeti leletek.
- Statisztikai adatok, összeírások.
b) A források kritikai értékelése
- A források megbízhatóságának vizsgálata.
- A forrásokban rejlő esetleges torzítások azonosítása.
- A források reprezentativitásának elemzése.
Figyelem Ha nincs elég forrás, a kérdést gondolja újra – ne a forrásokat erőltesse.
A leggyakoribb kezdő reakció az, hogy a hallgató ragaszkodik az eredeti kérdéséhez, és a hiányzó forrásokat próbálja pótolni: egyre távolabbi anyagokból következtet, vagy néhány véletlenszerű adatot általánosít. Ez tudományosan nem védhető.
A helyes lépés a másik irányba mutat: a kérdést kell a fennmaradt forrásbázishoz igazítani. Ha nincs meg egy vármegye teljes összeírása, de egy járásé igen, akkor a járásról szóló kérdés a jó kérdés. Ha egy döntés hivatalos indoklása nem maradt fenn, de a sajtóvisszhangja igen, akkor nem a döntés okáról, hanem a döntés fogadtatásáról érdemes kérdezni.
Ez nem kudarc, hanem maga a történészi munka: a Mi a forrás? fejezet forráshiányról szóló szakasza és a kutatási folyamat ábrájának visszacsatoló nyilai ugyanezt mutatják – a kérdés és a forrás egymást alakítja.
2.4 A módszertan kidolgozása
a) Történeti módszerek
- Forráskritika alkalmazása (külső és belső kritika).
- Összehasonlító elemzés módszertana.
- Prozopográfiai módszer (ha személyek csoportját vizsgáljuk).
- Kvantitatív és kvalitatív módszerek meghatározása.
b) Adatgyűjtési módszerek
- Jegyzetelési rendszer kialakítása.
- Adatbázis-építés megtervezése.
- Fotózási, digitalizálási stratégia kidolgozása.
- Interjúkészítési módszertan (ha oral history is része a kutatásnak).
c) Elemzési szempontrendszer
- Az összegyűjtött adatok rendszerezési módjának meghatározása.
- Az elemzés főbb szempontjainak kidolgozása.
- Az eredmények értékelési kritériumainak meghatározása.
- A következtetések levonásának módszertana.
2.5 Időbeli ütemezés
- A kutatás főbb szakaszainak meghatározása.
- Reális határidők kitűzése.
- A levéltári és könyvtári kutatómunka időbeli beosztása.
2.6 A dolgozat szerkezetének felvázolása
- A fejezetek előzetes struktúrájának kialakítása.
- A főbb gondolati egységek meghatározása.
- A várható eredmények előrevetítése.
3. Milyen a jó kutatási kérdés?
Egy kutatás sikere nagyrészt azon múlik, hogy a kérdését jól tette-e fel. Négy ismérv segít eldönteni, hogy jó kérdéssel dolgozunk-e.
1. Specifikus és konkrét. Nem túl általános vagy túl tág. („Milyen volt a középkor?” helyett: „Hogyan változott a céhes ipar szerepe Kassán 1400–1450 között?”) Pontosan meghatározott időbeli és térbeli keretekkel rendelkezik, és világosan körülhatárolt témára fókuszál.
2. Megválaszolható. A rendelkezésre álló források alapján kutatható; a válasz nem evidens, de nem is lehetetlen megtalálni; a szakdolgozat terjedelmi és időbeli keretein belül feldolgozható.
3. Releváns és jelentős. Új ismeretekkel gazdagítja a történettudományt, kapcsolódik a meglévő szakirodalomhoz, és társadalmi vagy tudományos szempontból értékes kérdésre keres választ.
4. Analitikus jellegű. Nem csak leíró vagy narratív választ igényel; lehetőséget ad az elemzésre és értelmezésre; ok-okozati összefüggések feltárására ösztönöz.
Példa Két jó kutatási kérdés
„Hogyan befolyásolta a filoxérajárvány a tokaji bortermelő közösségek társadalmi összetételét 1875–1895 között?” – Specifikus időkeret; konkrét földrajzi terület; vizsgálható források (birtokösszeírások, népszámlálási adatok); elemzési lehetőség (társadalmi változások).
„Milyen szerepet játszottak a katolikus női szerzetesrendek a leánynevelésben Pest-Budán 1850–1870 között?” – Jól körülhatárolt téma; elérhető források (iskolai anyakönyvek, rendházi iratok); társadalomtörténeti jelentőség; lehetőség összehasonlító elemzésre.
Figyelem Kerülendő kérdéstípusok
Túl tág kérdések: „Milyen volt a magyar társadalom a dualizmus korában?”, „Hogyan fejlődött a középkori városiasodás?”
Túl szűk kérdések: „Hány ablaka volt a kassai városházának 1780-ban?”, „Mi volt a pozsonyi polgármester kedvenc étele 1845-ben?”
Források hiányában megválaszolhatatlan kérdések: „Mit gondoltak a parasztok a földesurakról a 11. században?”, „Hogyan élték meg a jobbágyok a mindennapi életüket 1514-ben?”
Egyszerű igen/nem választ igénylő kérdések: „Volt-e iskola Debrecenben 1700-ban?”, „Létezett-e céhrendszer Budán a 15. században?”
Gyakorlás: mi a baj ezzel a kérdéssel?
A négy ismérv akkor válik használhatóvá, ha gyenge kérdéseken próbálja ki. Az alábbi nyolc kérdés a fenti „Kerülendő kérdéstípusok” doboz példáiból való. Döntse el mindegyikről, melyik hibatípusba tartozik – utána megnézheti, hogyan lehet ugyanabból a témából jó kérdést feltenni.
Feladat Mi a baj ezzel a kérdéssel?
Döntse el minden kérdésről, melyik hibatípusba tartozik: túl tág, túl szűk, források hiányában megválaszolhatatlan, vagy igen/nem kérdés. Ezután fogalmazza át mindegyiket jó kutatási kérdéssé.
| # | A kérdés |
|---|---|
| 1 | „Milyen volt a magyar társadalom a dualizmus korában?” |
| 2 | „Hogyan fejlődött a középkori városiasodás?” |
| 3 | „Hány ablaka volt a kassai városházának 1780-ban?” |
| 4 | „Mi volt a pozsonyi polgármester kedvenc étele 1845-ben?” |
| 5 | „Mit gondoltak a parasztok a földesurakról a 11. században?” |
| 6 | „Hogyan élték meg a jobbágyok a mindennapi életüket 1514-ben?” |
| 7 | „Volt-e iskola Debrecenben 1700-ban?” |
| 8 | „Létezett-e céhrendszer Budán a 15. században?” |
Végül: fogalmazza meg a saját témájának kutatási kérdését, és nézze meg, melyik hibatípusba csúszik bele a legkönnyebben. A megoldókulcs az oktatói segédletben található.
Esettanulmány
Esettanulmány Egy kérdés felépítése lépésről lépésre
Tegyük fel, hogy Önt „a 19. századi Budapest” érdekli. Ez még nem kutatási kérdés, hanem témamegjelölés: nincs benne sem pontos időhatár, sem konkrét vizsgálati szempont, és nem lehet rá forrásokból választ adni.
Első szűkítés: térben és időben. „Pest belvárosa 1873 és 1900 között.” Ez már kezelhető forrásmennyiséget jelöl ki, és egybeesik egy értelmes történeti cezúrával (Pest, Buda és Óbuda 1873-as egyesítése).
Második szűkítés: tárgyban. Mi az, ami a területen vizsgálható és amiről maradt fenn irat? Például a beépítés és a tulajdonosi kör változása – ehhez telekkönyvi betétek, cím- és lakásjegyzékek, közjegyzői okiratok állnak rendelkezésre (lásd a Budapest Időgép fejezetet).
Harmadik lépés: analitikus megfogalmazás. Nem „Milyen volt Pest belvárosa?”, hanem: „Hogyan változott a Múzeum körút menti telkek tulajdonosi összetétele 1873 és 1900 között, és mennyiben követte ez a városrész intézményi átalakulását?” Ez a kérdés specifikus, forrásokból megválaszolható, kapcsolódik a várostörténeti szakirodalomhoz, és összefüggés feltárására ösztönöz.
Figyelje meg, hogy a szűkítés minden lépésében a forrásadottság volt a döntő szempont. A jó kutatási kérdés nem a levegőben születik, hanem a téma és az elérhető forrásbázis párbeszédéből.
Reflexiós feladat
Feladat 1. feladat – Kutatási kérdés élesítése
Válasszon egy témát, amely érdekli.
Fogalmazzon meg hozzá egy első, még tág kutatási kérdést.
Szűkítse a kérdést három lépésben – időben, térben és tárgyban –, ahogyan az esettanulmányban láttuk.
A végleges kérdésről írja le pontokba szedve, hogy a négy ismérv (specifikus, megválaszolható, releváns, analitikus) miért teljesül rá.
Nevezzen meg legalább három forráscsoportot, amelyből a kérdés megválaszolható lenne.
Elvárt formátum: kb. féloldalas (250–300 szavas) szöveg.
Feladat 2. feladat – Rossz kérdések javítása
Az alábbi négy kérdés mindegyike hibás. Nevezze meg, melyik hibatípusba tartozik, majd írja át mindegyiket használható kutatási kérdéssé.
- „Milyen volt a magyar társadalom a dualizmus korában?”
- „Hány ablaka volt a kassai városházának 1780-ban?”
- „Mit gondoltak a parasztok a földesurakról a 11. században?”
- „Volt-e iskola Debrecenben 1700-ban?”
Elvárt formátum: négysoros táblázat (eredeti kérdés – hibatípus – javított kérdés).
Önellenőrző kérdések
1. Miért nem azonos a történelem az egykori események kronológiájával?
Válasz megjelenítése
Mert a múlt eseményeit a maguk teljességében nem lehet rekonstruálni. A történész a rendelkezésére álló források elemzésével és értelmezésével egyfajta olvasatát adja az egykor történteknek. Új források és módszertani újítások nyomán ez a kép folyamatosan változik.
2. Soroljon fel három okot, amiért a múlt nem ismerhető meg teljes körűen a források oldaláról!
Válasz megjelenítése
Nem minden eseményt jegyeztek fel; a feljegyzéseknek csak töredéke maradt fenn; a fennmaradt források közül nem mindegyiket vizsgálták (például mert nem egy időben kerülnek napvilágra).
3. Mit jelent az, hogy a források szubjektívek és töredékesek?
Válasz megjelenítése
Szubjektívek: egy bizonyos nézőpontot mutatnak be. Töredékesek: nem képesek az egykori eseményeket a maguk teljességében leírni. Ezért nem elég a források tartalmát visszaadni, értelmezni is kell őket.
4. Melyik a négy ismérv, amely alapján egy kutatási kérdés minősége megítélhető?
Válasz megjelenítése
Specifikus és konkrét; megválaszolható; releváns és jelentős; analitikus jellegű.
5. Miért mondjuk, hogy a kutatás tervezésének lépései iteratívak?
Válasz megjelenítése
Mert nem szigorú sorrendben követik egymást: sokszor párhuzamosan zajlanak, és a kutatás közben felmerülő új szempontok miatt az eredeti tervet módosítani kell.
Összefoglalás
Ebben a fejezetben azt tisztáztuk, hogy a történettudomány forrásokon alapuló, értelmező tevékenység, amely nem a múlt teljes rekonstrukciójára, hanem annak kritikailag megalapozott olvasatára törekszik. Láttuk, milyen forrásoldali és személyes korlátok között dolgozik a történész, és hogy ebből milyen szakmai felelősség következik. Végigvettük egy kutatás megtervezésének hat fő lépését, és négy ismérv mentén megtanultuk megítélni, mikor jó egy kutatási kérdés.
A könyv további fejezetei mind ennek a munkamenetnek egy-egy lépését támogatják digitális eszközökkel: a II. rész a szakirodalom feltárását, a III. rész a források elérését és kezelését, a IV. rész pedig konkrét történeti adatbázisok használatát mutatja be. A következő fejezet azt tisztázza, mit értünk digitális bölcsészeten és digitális történettudományon.
Kulcsfogalmak
forráskritika – A források megbízhatóságának, keletkezési körülményeinek és torzításainak módszeres vizsgálata; külső és belső kritikára osztható.
historiográfia – A történetírás története; egy téma kutatástörténete, a korábbi értelmezések és viták számbavétele.
kutatási kérdés – A kutatás vezérkérdése, amely időben és térben behatárolt, a források alapján megválaszolható, releváns és elemzésre ösztönző.
paradigma – Értelmezési minta, amelyen belül egy adott korszak történészei a kérdéseiket megfogalmazzák; folyamatosan változik.
prozopográfia – Módszer, amely személyek egy csoportjának közös életrajzi jellemzőit vizsgálja a csoportra vonatkozó következtetések levonása érdekében.
reprezentativitás – Annak kérdése, hogy a fennmaradt és vizsgált források mennyire tükrözik a vizsgált jelenség egészét.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Kerepeszki Róbert – Schrek Katalin (szerk.): Bevezetés a történelemtudományba és a történelemkutatás módszereibe. Pécs, Kronosz Kiadó, 2023. (Különösen: Történelem és történettudomány c. fejezet.)
Ajánlott irodalom
- Babbie, Earl: A társadalomtudományi kutatás gyakorlata. Hatodik, átdolgozott kiadás. Budapest, Balassi Kiadó, 2003. – a kutatási kérdés, a fogalmi operacionalizálás és a kutatási terv klasszikus kézikönyve; a Szaktárs felületén teljes szöveggel olvasható.
- Kerepeszki Róbert – Schrek Katalin (szerk.): Bevezetés a történelemtudományba és a történelemkutatás módszereibe. Pécs, Kronosz Kiadó, 2023. – a kötet egésze a félév során kiegészítő irodalomként ajánlott.
Linkek és eszközök
- Podcast a történettudomány kérdéseiről – https://open.spotify.com/episode/6cRkBN1PXiIMdcdGILMLQl – elérve: 2026. 08. 20.
Digitális bölcsészet és digitális történettudomány
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 90 perc |
| Előfeltétel | Hogyan épül fel egy történeti kutatás? |
| Verzió / dátum | v0.1 / 2026. augusztus |
Miről szól ez a fejezet?
Ez a fejezet két fogalmat tisztáz – a digitális bölcsészetet és a digitális történettudományt –, és elhelyezi mellettük a digitális kulturális örökség fogalmát. Áttekinti, hogy a digitális eszközök a kutatási folyamat mely szakaszaiban segíthetnek, és hol vannak a korlátaik. Egy magyar projektet mutat be közelebbről: a Budapest Időgépet.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- megkülönbözteti a digitális bölcsészet és a digitális történettudomány fogalmát, és megnevezi a köztük lévő viszonyt;
- felsorol legalább három hazai digitális bölcsészeti műhelyt és megnevezi, melyik intézményhez tartozik;
- a kutatási folyamat négy szakaszához (forrásgyűjtés, elemzés, publikálás, ismeretterjesztés) hozzárendeli a jellemző digitális eszköztípusokat;
- kritikailag értékeli a digitális eszközök korlátait, és érvel amellett, hogy miért nem helyettesítik a történészi kritikai gondolkodást;
- egy konkrét digitális történeti projektről (Budapest Időgép) megállapítja, milyen forrásokra és technológiákra épül, és milyen kutatási kérdésekhez használható.
Bevezetés
A történettudomány hagyományosan a levéltárakban és könyvtárakban fellelhető forrásokra támaszkodik. A digitalizáció és az informatikai fejlődés azonban alapjaiban változtatta meg a kutatás lehetőségeit. Egyre több történelmi dokumentum, térkép és levéltári anyag válik elérhetővé digitális formában, ami lehetővé teszi a kutatók számára, hogy könnyebben érjék el a forrásokat és a szakirodalmat.
A digitalizáció előnyei egyértelműek: az online adatbázisok és digitalizált levéltári források révén olyan anyagok is hozzáférhetővé válnak, amelyekhez korábban csak levéltárakban vagy könyvtárakban lehetett hozzájutni. Ez lehetővé teszi az idő- és térbeli korlátok áthidalását. Emellett a digitális adatkezelés és elemzés új módszereket biztosít a kutatóknak.
Ez a fejezet előbb a fogalmakat tisztázza, majd végigveszi, hogy a kutatási folyamat mely pontján milyen digitális eszközök jönnek szóba, és a végén két konkrét magyar projekten mutatja be, mit jelent mindez a gyakorlatban.
1. A digitális bölcsészet
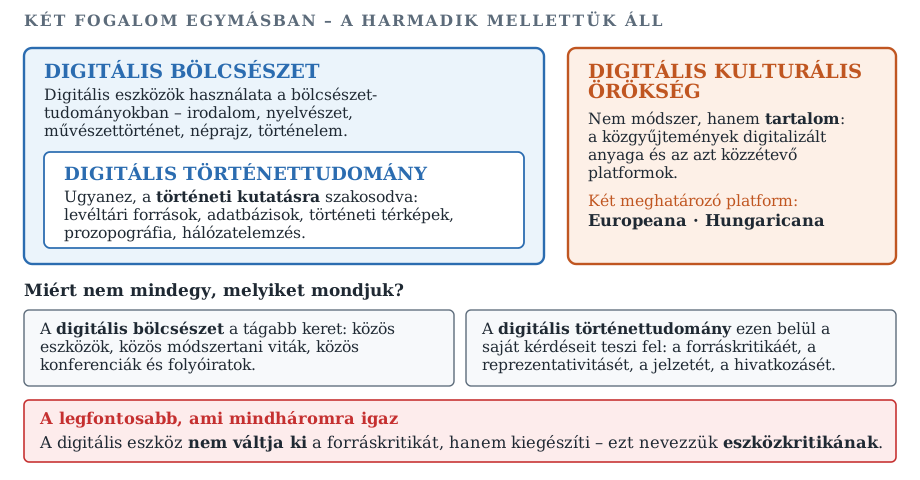
A digitális bölcsészet kifejezés a digitális eszközök és technikák használatára utal a bölcsészettudományi kutatásokban. Interdiszciplináris terület, amely a kutatók széles körét tömöríti: irodalmároktól a történészeken át a nyelvészekig és az informatikusokig. A digitális bölcsészet területén működő kutatócsoportok együtt dolgoznak a digitális technológiák kifejlesztésén és az azokkal történő elemzéseken azért, hogy a hagyományos humán tudományok kutatását fejlesszék a digitális módszerekkel és eszközökkel.
Definíció Fogalom: digitális bölcsészet
Interdiszciplináris terület, amely a digitális eszközök és technikák használatát jelenti a bölcsészettudományi kutatásokban. Művelői egyszerre fejlesztik a digitális technológiákat és végzik velük az elemzéseket, azzal a céllal, hogy a hagyományos humán tudományok kutatását digitális módszerekkel gazdagítsák.
A digitális bölcsészetnek több hazai műhelye működik, például:
- az Országos Széchényi Könyvtár digitális bölcsészeti platformja, a dHUpla;
- az Irodalomtudományi Intézet digitális filológiai projektje, a DigiPhil;
- a Digitális Bölcsészet folyóirat.
2. A digitális történettudomány
A digitális történettudomány a digitális bölcsészet egyik ága, amely digitális kutatási módszerekkel kapcsolja össze a történeti kutatást. Eredményei közé tartoznak a digitális archívumok, a történeti adatvizualizációk, az interaktív térképek, és akár a különböző virtuális világok, amelyek a felhasználó számára hozzáférhetőbbé teszik a történelmet.
A legújabb digitális történeti projektek középpontjában a technikai innováció, a szövegbányászat, a korpusznyelvészet, a hálózatelemzés, a 3D modellezés, a nagy adatelemzés, illetve a legkorszerűbb mesterséges intelligencia alapú eszközök történettudományi kutatásban való alkalmazása áll.
Definíció Fogalom: digitális történettudomány
A digitális bölcsészet azon ága, amely digitális kutatási módszereket kapcsol össze a történeti kutatással. Tipikus eredményei: digitális archívumok, történeti adatvizualizációk, interaktív térképek, virtuális rekonstrukciók.
3. Digitális kulturális örökség
A digitális technológiák új lehetőségeket kínálnak a kulturális örökség megőrzésére is, emellett arra, hogy annak tartalmai minél szélesebb körben elérhetők legyenek. A technológiát alkalmazó múzeumok például lehetővé tehetik a közönség számára, hogy távolról is megtekinthesse a kiállításokat, sőt akár a ki nem állított anyagokat is; kiállításaikat pedig interaktívvá fejleszthetik a digitális eszközök segítségével.
Az Europeana portál az Európai Unió digitális platformja a kulturális örökség megőrzésére. A portál több, a történeti kutatás számára is hasznos gyűjteménnyel rendelkezik. Hasonló kezdeményezés a magyar Hungaricana portál, amely a magyar kulturális örökség egyik legjelentősebb online gyűjteménye (lásd a Hungaricana fejezetet).
4. Digitális eszközök a kutatási folyamatban
Az alábbiakban áttekintjük, milyen szerepe lehet a digitális eszközöknek a történeti kutatás egyes szakaszaiban.
4.1 Forrásgyűjtés és -kezelés
Adatbázisok és archívumok
- digitális levéltári és könyvtári gyűjtemények használata a források és a szakirodalom felkutatásához;
- online katalógusrendszerek a különböző gyűjtemények anyagainak áttekintéséhez;
- szkennelt dokumentumok és digitalizált források közvetlen elérése;
- OCR (optikai karakterfelismerés) használata régi szövegek digitalizálásához (lásd az OCR fejezetet).
Adattárolás és rendszerezés
- digitális forráskezelő szoftverek a dokumentumok kategorizálásához;
- metaadatok hozzáadása a források könnyebb visszakereshetőségéért;
- felhőalapú tárolás a bárhonnan való hozzáféréshez;
- verziókövetés a források különböző változatainak nyilvántartásához.
4.2 Forráskritika és elemzés támogatása
Automatizált elemzési eszközök
- szövegelemző szoftverek a források tartalmi vizsgálatához;
- plágiumkereső eszközök a források eredetiségének ellenőrzéséhez;
- nyelvtörténeti elemző programok régi szövegek értelmezéséhez;
- MI-alapú eszközök mintázatok felismeréséhez nagy mennyiségű adatban.
Időrendi és térbeli vizualizáció
- digitális idővonalas szoftverek az események kronológiai rendszerezéséhez;
- térinformatikai rendszerek (GIS) történelmi helyszínek és események térképezéséhez;
- 3D rekonstrukciós eszközök történelmi helyszínek vizualizációjához.
4.3 Tudományos munka és publikálás
Kollaborációs eszközök
- online közös munkát lehetővé tevő platformok;
- verziókövetési rendszerek a kutatási dokumentumok kezeléséhez;
- videokonferencia-eszközök távoli együttműködéshez;
- projektmenedzsment-szoftverek a kutatási folyamatok koordinálásához.
Publikációs támogatás
- digitális hivatkozáskezelő rendszerek (lásd a Zotero fejezetet);
- online publikációs platformok;
- digitális folyóirat-menedzsment rendszerek;
- tudományos közösségi hálózatok a kutatások megosztásához (lásd az Academia.edu és ResearchGate fejezetet).
4.4 Oktatás és ismeretterjesztés
Oktatási eszközök
- e-learning platformok történelmi kurzusok létrehozásához;
- interaktív történelmi idővonalas alkalmazások;
- virtuális múzeumok és kiállítások készítése;
- digitális tananyagfejlesztő eszközök.
Ismeretterjesztés
- közösségi média platformok a kutatási eredmények megosztásához;
- történelmi podcastok és videók készítéséhez szükséges eszközök;
- digitális storytelling alkalmazások;
- interaktív webes prezentációs eszközök.
5. A digitális eszközök korlátai és kritikai értékelése
Technikai kihívások
- régi formátumok és fájltípusok kompatibilitási problémái;
- a digitális tartalmak hosszú távú megőrzésének kérdései;
- adatbiztonság és adatvédelem;
- az eszközök használatához szükséges képzések időigénye.
Módszertani megfontolások
- a digitális eszközök nem helyettesíthetik a történészi kritikai gondolkodást;
- az automatizált elemzések eredményeinek kritikus értékelése szükséges;
- meg kell találni a hagyományos és digitális módszerek megfelelő egyensúlyát;
- a források digitalizálásának minőségi kérdései.
Figyelem Tipikus hiba: „a digitális eszköz elvégzi helyettem a források felkutatását és elemzését”
Nem végzi el. Egy keresőfelület csak azt találja meg, ami digitalizálva és metaadatolva van; egy OCR-szöveg tartalmazhat felismerési hibákat; egy adatbázisban a benne szereplő adatok kiválogatása maga is szerkesztői döntések eredménye. A digitális eszközök használata ezért nem váltja ki, hanem kiegészíti a forráskritikát – ezt nevezzük eszközkritikának.
Definíció Fogalom: eszközkritika
Annak módszeres vizsgálata, hogy egy digitális eszköz vagy adatbázis milyen elvek szerint épült fel, mit tartalmaz és mit nem, milyen torzításokat visz a kutatásba, és hogy az általa adott eredmény mennyiben függ a rendszer felépítésétől. A forráskritika kiegészítése a digitális kutatásban.
6. Egy magyar példa: a Budapest Időgép
A Budapest Időgép egy digitális történeti projekt, amelynek célja, hogy interaktív módon rekonstruálja Budapest történelmét. Az online platform lehetőséget biztosít térképek, levéltári dokumentumok és fotók együttes megtekintésére és elemzésére.
Az időgépben a felhasználók egy adott korszak térképein böngészhetnek, megtekinthetik az épületek változását, és hozzáférhetnek az adott helyszínekhez kapcsolódó dokumentumokhoz. Az adatbázis a történészek, urbanisták és helytörténeti kutatók számára egyaránt hasznos lehet. A Budapest Főváros Levéltára gondozásában megvalósult alkalmazás térben és időben történő barangolás lehetőségét kínálja interaktív térképeken keresztül.
A projekt részletes bemutatását a Budapest Időgép fejezet tartalmazza.
Feladat Feladat – Budapest Időgép
Nézze meg a projektet bemutató videót (https://youtu.be/dezSYxb2T70), majd írásban válaszoljon az alábbi kérdésekre:
Mi a Budapest Időgép projekt célja?
Milyen forrásokat és technológiai eszközöket használnak a projektben?
Hogyan lehet ezt az eszközt a történeti kutatásban hasznosítani?
Elvárt formátum: kérdésenként 3–5 mondat.
Esettanulmány
Esettanulmány Miért nem elég a keresőmező? – egy eszközkritikai gondolatmenet
Tegyük fel, hogy egy digitalizált sajtóadatbázisban rákeres egy kifejezésre, és tizenkét találatot kap. Mit tud ebből?
Első pillantásra azt, hogy a kifejezés tizenkétszer fordul elő. Valójában viszont csak azt tudja, hogy tizenkétszer fordul elő abban az anyagban, amit digitalizáltak, olyan minőségben, amit az OCR fel tudott ismerni, olyan íráskép mellett, amit a rendszer az Ön keresőkifejezésével azonosnak fogadott el. Ha az adott lap egyik évfolyama nem került be a gyűjteménybe, ha a szkennelés minősége rossz volt, ha a korabeli helyesírás eltért a maitól – a találatszám máris mást jelent.
A helyes eljárás ezért három lépésből áll. Először: nézze meg, mit tartalmaz az adatbázis (mely lapok, mely évfolyamok, milyen teljességgel). Másodszor: futtasson több változatot – írásváltozatokat, csonkolást, korabeli alakokat. Harmadszor: a találatot mindig vesse össze az eredeti oldalképpel, ne a nyers OCR-szöveget idézze.
Ez a három lépés az, amit ebben a könyvben eszközkritikának nevezünk. A tanulság nem az, hogy a digitális eszközök megbízhatatlanok, hanem az, hogy – mint minden forrás – önmagukban is kritikai vizsgálat tárgyai.
Önellenőrző kérdések
1. Mi a viszony a digitális bölcsészet és a digitális történettudomány között?
Válasz megjelenítése
A digitális történettudomány a digitális bölcsészet egyik ága: a digitális kutatási módszereket kifejezetten a történeti kutatással kapcsolja össze.
2. Nevezzen meg két hazai digitális bölcsészeti műhelyt!
Válasz megjelenítése
Az OSZK digitális bölcsészeti platformja (dHUpla); a DigiPhil (MTA Irodalomtudományi Intézet). Emellett említhető a Digitális Bölcsészet folyóirat is.
3. Igaz-e, hogy a digitális történettudomány kizárólag technikai eszközök használatát jelenti?
Válasz megjelenítése
Nem. Az eszközhasználat mellett új kutatási kérdéseket, új módszertani megközelítéseket és a hozzájuk tartozó kritikai reflexiót (eszközkritika) is magában foglalja.
4. Mi az Europeana?
Válasz megjelenítése
Az Európai Unió digitális platformja a kulturális örökség megőrzésére; több, a történeti kutatás számára is hasznos gyűjteménnyel rendelkezik.
5. Miért nem helyettesítik a digitális eszközök a történészi kritikai gondolkodást?
Válasz megjelenítése
Mert az automatizált elemzések eredményei maguk is értékelést igényelnek: a digitalizálás minősége, az adatbázis tartalmi lefedettsége és a szerkesztői döntések mind befolyásolják, hogy mit találunk. Ezért a forráskritika mellett eszközkritikára is szükség van.
Összefoglalás
A fejezet két fogalmat különített el: a digitális bölcsészet a digitális eszközök használatát jelenti a bölcsészettudományokban általában, a digitális történettudomány pedig ennek a történeti kutatásra szakosodott ága. Mellettük áll a digitális kulturális örökség fogalma, amelynek két meghatározó platformja az Europeana és a Hungaricana. Végigvettük, hogy a kutatás négy szakaszában (forrásgyűjtés, elemzés, publikálás, ismeretterjesztés) milyen eszköztípusok jönnek szóba, majd megfogalmaztuk a legfontosabb módszertani tanulságot: a digitális eszközök nem váltják ki a forráskritikát, hanem kiegészítik – ez az eszközkritika.
Az itt bevezetett fogalmakat a könyv további részeiben végig használni fogjuk. A következő rész a szakirodalom feltárásának eszközeivel foglalkozik.
Kulcsfogalmak
digitális bölcsészet – Interdiszciplináris terület, amely a digitális eszközök és technikák használatát jelenti a bölcsészettudományi kutatásokban.
digitális kulturális örökség – A kulturális örökség digitális formában megőrzött és hozzáférhetővé tett része, illetve az ezt célzó tevékenység.
digitális történettudomány – A digitális bölcsészet történeti kutatásra szakosodott ága; eredményei többek között digitális archívumok, adatvizualizációk, interaktív térképek.
eszközkritika – Annak módszeres vizsgálata, hogy egy digitális eszköz felépítése és tartalmi lefedettsége miként befolyásolja a kutatás eredményét.
georeferálás – Digitalizált térkép pontjainak valós koordináta-rendszerhez rendelése (részletesen lásd a Budapest Időgép fejezetben).
hálózatelemzés – Kapcsolatok rendszerének (személyek, intézmények, szövegek közötti kötések) kvantitatív vizsgálata.
szövegbányászat – Nagy szövegmennyiségből automatizált módszerekkel mintázatok, összefüggések kinyerése.
Felhasznált és ajánlott irodalom
Ajánlott irodalom
- Maróthy Szilvia: Digitális bölcsészet. A szövegtől az adatig. (Betekintés) Budapest, Akadémiai Kiadó, 2020. – magyar nyelvű bevezetés a területbe; szabadon olvasható: https://mersz.hu/marothy-a-szovegtol-az-adatig
- Digitális Bölcsészet (folyóirat) – https://ojs.elte.hu/digitalisbolcseszet/index
Linkek és eszközök
- dHUpla – Digitális Bölcsészeti Platform (OSZK) – https://dhupla.hu/ – elérve: 2026. 08. 20.
- DigiPhil – https://digiphil.hu/ – elérve: 2026. 08. 20.
- Europeana – https://www.europeana.eu/hu – elérve: 2026. 08. 20.
- Hungaricana Közgyűjteményi Portál – https://www.hungaricana.hu/hu/ – elérve: 2026. 08. 20.
- Budapest Időgép – https://www.hungaricana.hu/hu/budapest-idogep/ – elérve: 2026. 08. 20.
- Budapest Főváros Levéltára – https://bparchiv.hu/ – elérve: 2026. 08. 20.
Digitalizálás és optikai karakterfelismerés (OCR)
| Szerző(k) | Selmeczi Péter |
| Becsült feldolgozási idő | 90 perc |
| Előfeltétel | Mi a forrás? |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszköz alapadatai
Ez a fejezet fogalmi: az optikai karakterfelismerés működéséről és korlátairól szól. Egyetlen konkrét eszközt említ többször – ennek adatai:
| Eszköz neve | Transkribus |
| URL | https://www.transkribus.org/ |
| Üzemeltető | READ-COOP SCE (európai szövetkezet) |
| Hozzáférés | Havonta 50 ingyenes kredit bankkártya nélkül; azon felül kreditalapú, illetve előfizetéses |
| Regisztráció | Szükséges |
| Tartalomtípus | Kézírásos és nyomtatott történeti szövegek gépi olvasása (HTR és OCR), elrendezés- és táblázatfelismerés, közös szerkesztés, exportálás |
| Nyelvek | 100-nál több nyelv, több történeti írásrendszer (kurrent, Sütterlin, francia kurzív) |
| Fontos korlát | A kézírásfelismerés eredménye nem biztos átirat, hanem valószínűségi becslés – a szöveget ellenőrizni kell |
A felület saját ismertetője alapján, elérve: 2026. 08. 22.
Miről szól ez a fejezet?
A fejezetben bemutatjuk, hogy a digitalizáció milyen perspektívákat nyit meg a történészek előtt. Megismerheti, hogy mit jelent az optikai karakterfelismerés (OCR) technológiája, és hogy ez mennyiben hat ki a források feldolgozására és értelmezésére. Külön figyelmet fordítunk arra, hol hibázik az OCR – mert ezt kell tudnia ahhoz, hogy kritikusan használja a digitalizált szöveget.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- megkülönbözteti a digitalizált és a born-digital forrást, és példát hoz mindkettőre a saját szakterületéről;
- saját szavaival elmagyarázza az OCR-folyamat három fő lépését;
- felismeri egy digitalizált oldalon azokat a tulajdonságokat, amelyek OCR-hibát valószínűsítenek (bélyegző, rossz kontraszt, képbe ágyazott szöveg, kézírás);
- kiválasztja a megfelelő digitalizálási beállításokat (felbontás, szín, fájlformátum) egy adott forrástípushoz;
- helyesen jár el, ha egy digitalizált forrásból szó szerint idéz.
Bevezetés
A digitalizáció korunk egyik legátfogóbb társadalmi és technológiai folyamata, amely alapvetően formálja át a valósághoz és az információhoz való viszonyunkat, valamint a történészek által használt forrástípusok jellegét. A 20. század közepétől megkezdődő számítástechnikai forradalommal lehetővé vált az analóg jelek gépek által feldolgozható, bináris kódokká való átalakítása; a mikroprocesszorok fejlődése és az internet globális elterjedése pedig példátlan sebességgel gyorsította fel az adatok rögzítését, továbbítását és megosztását.
A történettudomány számára ez a paradigmaváltás egyszerre jelent komoly kihívást és soha nem látott lehetőségeket. Egyrészt maguk a források keletkezési módja és anyaghordozói változnak meg. Egészen a közelmúltig döntően papíralapú dokumentumok (levéltári iratok, személyes naplók, levelek, kéziratok) őrizték, hordozták magukban az emberi emlékezet nyomait – ezek azonban sérülékenyek, tartós megőrzésük különös figyelmet kíván. Ma már azonban az adatok jórészt „born-digital” (más néven e-born), vagyis eleve digitálisan létrejött formátumban keletkeznek. E-mailek, közösségimédia-interakciók, SMS-ek és hatalmas kormányzati adatbázisok válnak a közeljövő kutatásainak elsődleges forrásbázisává. Ezek értelmezéséhez új kutatási eszközökre, elméleti keretekre és kutatási módszertanokra is szükség van.
Emellett hatalmas lehetőséget hordoz magában az, hogy az analóg dokumentumokat – kéziratokat, nyomtatott szövegeket, statisztikákat – ma már képesek vagyunk digitális kódokká alakítani. Ezt nevezzük általánosságban optikai karakterfelismerésnek (OCR). Ez nem csak azt teszi lehetővé, hogy például egy-egy nyomtatott könyv tartalmát digitalizáljuk, és ezáltal kíméljük az eredeti, fizikai példányt. Ennél többről van szó: a bennük lévő adatok feldolgozása is soha nem látott méretekben valósítható meg.
Mélyebben Az analóg elődök
Fontos megjegyezni, hogy a papíralapú iratok megóvása és tartalmuk tartós megőrzése érdekében korábban is kidolgoztak már eljárásokat a különböző iratőrzők, levéltárak és közgyűjtemények, hogy ezekről úgynevezett biztonsági másolatokat készítsenek. A 20. század első felében a fényképezés mellett hasonlóan analóg technológiát jelentett a mikrofilmezés.
Az OCR-technológia lehetővé teszi, hogy évszázados vámnaplókból, népszámlálási ívekből vagy hajónaplókból is kinyerjék a történészek az adatokat, és táblázatokba rendezve statisztikai elemzéseket, gazdaságtörténeti modelleket készítsenek belőlük. Ehhez régen manuálisan, a forrásokat szóról szóra elolvasva volt csak lehetőség, de ennek időigénye és az emberi tényező behatárolta a feldolgozható iratok mennyiségét. Ma azonban azáltal, hogy gépi kereséseket (akár konkrét kulcsszavakra) tudunk végezni a digitalizált, olvashatóvá tett iratokon, millió oldalnyi szöveget tudunk átfésülni másodpercek alatt. Ezáltal olyan adattömegeket tudunk létrehozni és kezelni, ami a korábbiaknál szélesebb körű feltárást, váratlan összefüggések és találatok felfedezését is magával hozhatja. A forrásokra immár mint egy nagy adathalmazra (big data) tekinthetünk.
Mélyebben A Velencei Időgép
Az ilyen big data-kutatások egyik szemléletes példája a Venice Time Machine (Velencei Időgép) projekt, amely az École Polytechnique Fédérale de Lausanne (EPFL) vezetésével indult. Célja, hogy fejlett OCR- és HTR-algoritmusok segítségével digitalizálja és feldolgozza a Velencei Állami Levéltár (Archivio di Stato di Venezia) több mint ezer évnyi adminisztratív iratanyagát. Így rekonstruálhatóvá válhat a város társadalmi és gazdasági hálózatának alakulása több évszázados időintervallumban.
Bemutató videó a projektről: https://www.youtube.com/watch?v=7wJ8frgSn44 (elérve: 2026. 08. 06.)
1. Mi az optikai karakterfelismerés (OCR)?
Az OCR az angol Optical Character Recognition kifejezés rövidítése, ami magyarul optikai karakterfelismerést jelent. Ez olyan technológia, amely a különböző típusú dokumentumokat – például beszkennelt papírokat, PDF-fájlokat vagy digitális fényképezőgéppel készített képeket – szerkeszthető és kereshető szöveges adatokká alakít át.
Amikor például lefotóz egy kinyomtatott levelet, a telefonja vagy a számítógépe csak egy képpontokból álló fotót lát. Az OCR-szoftver feladata, hogy ezt a képet elemezze, felismerje rajta a betűket, számokat és szimbólumokat, végül pedig ezeket olyan kódsorokká alakítsa, amelyek a különböző szövegszerkesztő programok számára olvasható, szerkeszthető szöveget adnak.
Definíció Fogalom: optikai karakterfelismerés (OCR)
Technológia, amely a különböző típusú dokumentumokat – beszkennelt papírokat, PDF-fájlokat, digitális fényképeket – szerkeszthető és kereshető szöveges adatokká alakít át.
Definíció Fogalom: PDF
A Portable Document Format (PDF) az Adobe Systems által kifejlesztett, dokumentumok tárolására alkalmas fájlformátum. A PDF alkalmas szöveget, ábrát és képeket tartalmazó dokumentum leírására eszköz- és felbontásfüggetlen formában.
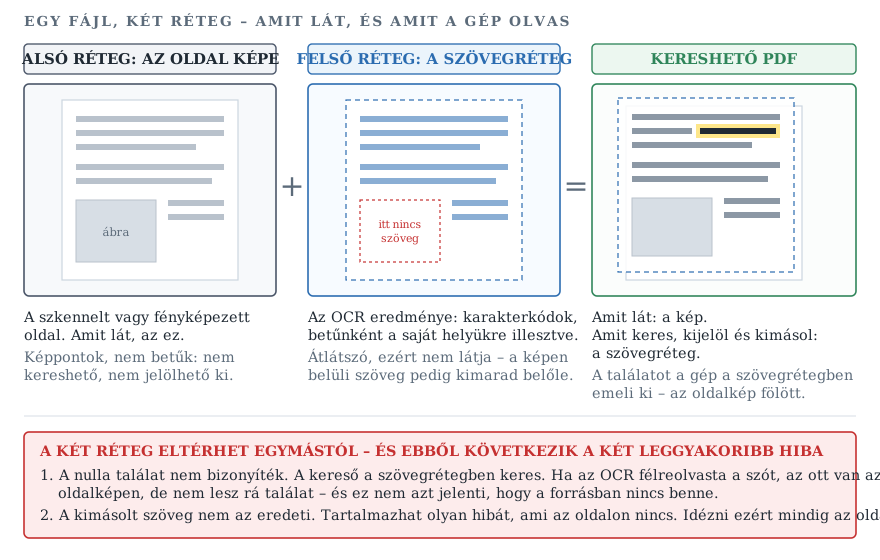
Amikor egy szkennelt oldalt OCR-rel dolgoznak fel, és az eredményt PDF-be mentik, kétrétegű (más néven kereshető) PDF keletkezik. A két réteg nem ugyanaz, és nem is mindig egyezik – ennek a különbségnek a felismerése az egész fejezet legfontosabb gyakorlati tanulsága.
1.1 Az OCR-folyamat lépései
A folyamat – habár a modern rendszerek ma már gyakran mesterséges intelligenciát használnak – alapvetően három lépésből áll:
- Kép-előfeldolgozás. A szoftver megtisztítja a képet (például kiegyenesíti az elferdült szöveget, vagy eltávolítja a szöveget érintő fizikai szennyeződést), hogy a betűk minél élesebbek legyenek.
- Karakterek azonosítása. A program megvizsgálja a formákat és a vonalakat. A régebbi rendszerek a betűk formáját hasonlították össze egy meglévő adatbázissal (mintaillesztés); a mai fejlettebb szoftverek a betűk jellemző vonásait elemzik (például, hogy az „A” betű két ferde és egy vízszintes vonalból áll).
- Szöveggé alakítás. A felismert formákat a számítógép számára is érthető, szerkeszthető karakterkódokká (pl. Unicode) alakítja. Ekkor jön létre az a szöveg, amelyet már másolni vagy módosítani lehet.
Az OCR-technológia segítségével egy beszkennelt, papíralapú szerződés is szerkeszthetővé válik (pl. Microsoft Wordben), és a PDF-dokumentumok is kereshetővé válnak szövegként. Emellett más területeken is mindennapi használatú technológiáról beszélhetünk: a közúti kamerákban ma már sok helyen rendszámtábla-felismerő szoftverek működnek, de ide sorolhatók a modern képi fordítóprogramok is.
Definíció Fogalom: kétrétegű PDF
Olyan PDF-fájl, amely tartalmazza a dokumentum grafikai megjelenését (első réteg) és a szövegként azonosítható második réteget is. A kettő nem azonos: amit lát, az a kép; amit a kereső megtalál, az az OCR-szöveg.
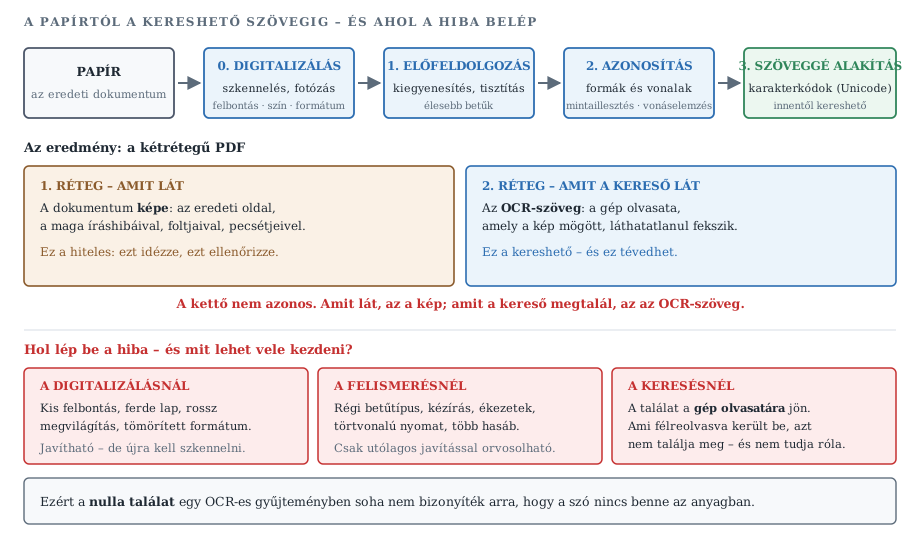
2. Digitalizálás: hogyan készül a jó kiindulási kép?
Az OCR eredménye csak annyira jó, amennyire a kiindulási kép. A digitalizálás során a dokumentumokat olyan formában rögzítjük, amely lehetővé teszi azok további feldolgozását, kereshetőségét és megőrzését.
2.1 Felbontás
- Legalább 300 dpi (pont per inch) szükséges ahhoz, hogy az apró részletek is jól láthatók legyenek.
- Kéziratos dokumentumok esetén ajánlott a 600 dpi vagy még nagyobb felbontás.
- A magas felbontás biztosítja a dokumentum hiteles megjelenítését, és segíti az OCR-folyamatot, különösen ha a szöveg apró vagy elmosódott.
2.2 Szín
Színes szkennelés akkor indokolt, ha az eredeti dokumentum megjelenésének hiteles visszaadása fontos. Különösen lényeges pecsétek, aláírások és kéziratok esetében, ahol a szín eltérése információvesztést eredményezhet. Tipikus esetek: kézírásos dokumentumok; eredeti pecséteket vagy aláírásokat tartalmazó anyagok; képeslapok, festmények, díszes dokumentumok.
Fekete-fehér szkennelés egyszerű szöveges dokumentumokhoz alkalmas, ahol a szín nem hordoz jelentős információt. Előnye a kisebb fájlméret; hátránya, hogy a színinformáció elveszik (például a piros aláhúzások).
2.3 Fájlformátum
| Cél | Formátum | Jellemző |
|---|---|---|
| Fakszimile, sok képdokumentum | JPEG | Tömörített, jó minőségű; veszteséges tömörítés |
| Fakszimile, minőség elsődleges | PNG | Veszteségmentes; nagyobb fájlméret |
| Archiválás, kereshetőség | PDF/A | Archiválásra optimalizált; tartalmazhat OCR-szövegréteget |
| Levéltári mesterpéldány | TIFF | Veszteségmentes, nagy felbontás; nagy fájlméret |
Tipp Saját kutatáshoz készített felvételeknél is érdemes ezt a logikát követni: készítsen egy mesterpéldányt (nagy felbontású, veszteségmentes), és abból származtasson munkapéldányt. Ha később kiderül, hogy egy részlet fontos, a mesterpéldányhoz visszanyúlhat – egy tömörített JPEG-ből az elveszett részlet nem állítható vissza.
3. Az OCR típusai
Egyszerű OCR – Nyomtatott könyvek, újságok, tiszta gépelt szövegek. Gyors és pontos, ha a szöveg jól olvasható; komplex elrendezéseknél (oszlopok, táblázatok) pontatlan.
Többnyelvű OCR – Több nyelven íródott dokumentumok, ami történeti forrásoknál gyakori. Előnye, hogy egy dokumentumon belül több nyelvet felismer; hátránya, hogy az eltérő betűkészletek (pl. cirill és latin) miatt a pontosság csökkenhet.
Kézírásfelismerő OCR (HTR) – Régi kéziratok, naplók, levelek. A kézírás változatossága miatt a pontosság alacsony; speciális szoftver szükséges (pl. Transkribus).
Strukturált OCR – Táblázatok, űrlapok pontos adatkinyerése. Megőrzi a szöveg szerkezetét és elrendezését, de az összetett formázás problémás lehet (például összekeverednek az oszlopok).
Figyelem A digitalizált adat és az eredeti forrás sohasem lehet teljesen azonos.
Az OCR által kinyert, szövegként értelmezett adatállomány másolása és megfelelő (de)kódolása függ az eredeti dokumentum fizikai állapotától; a rajta lévő szövegek, számok, szimbólumok írásmódjától; az írást rögzítő technológia (nyomtató, toll, tinta) típusától és minőségétől.
Nyers OCR-szöveget soha ne idézzen közvetlenül – az mindig manuális feldolgozást, korrektúrát kíván. Az idézetet mindig ellenőrizze az oldalképen.
Egy OCR-program mindig előre meghatározott jelkészlettel dolgozik, ez általában állítható is (például a Transkribus alkalmazásban). Fontos, hogy mindig a megfelelő jelkészlet alapján próbáljunk szövegeket beolvasni – ellenkező esetben nincs garancia arra, hogy a program megfelelően fogja felismerni és „átírni” a jeleket.
Mélyebben Videó a folyamatról
Az alábbi felvétel egy hordozható szkenner működését és a valós idejű optikai karakterfelismerés folyamatát mutatja be.
1. videó: Hordozható szkenner és valós idejű OCR. Forrás: Wikimedia Commons, elérve: 2026. 08. 06.
4. Kihívások és megoldások
Régi, kopott szövegek. Az OCR pontossága csökken, ha a betűk elhalványultak vagy elmosódtak. Megoldás: előfeldolgozás (kontrasztjavítás, élesítés); speciális szoftver, amely képes a régi dokumentumok kezelésére.
Kézírásos dokumentumok. Az OCR gyakran hibásan értelmezi a kézírásos szövegeket. Megoldás: manuális átirat készítése; kézírásfelismerő szoftver alkalmazása (pl. Transkribus); tanítóadatok használata az algoritmus fejlesztéséhez.
Elmosódott szöveg. A betűk összefolynak, nehezen olvashatók. Megoldás: a felbontás növelése (600 dpi); zajszűrés és élesítés képszerkesztő szoftverrel.
Esettanulmány
Esettanulmány Félreismert karakterek
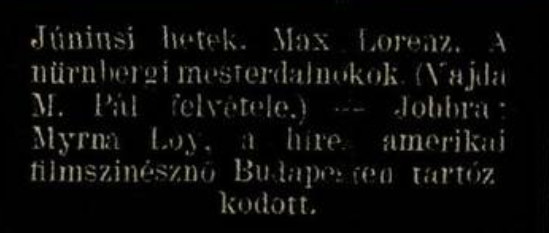
Az OCR-programok sokszor hibáznak, amikor analóg jelekből digitálisan szerkeszthető szöveget hoznak létre. Ennek oka lehet maga a program mögött működő algoritmus (elavultsága); az eredeti dokumentumon lévő hibák, sérülések, fizikai szennyeződések; vagy – szkennelt dokumentum esetén – a felvétel minősége. De maga a szöveg is számít: milyen betűtípussal írták, milyen a szedése, tipográfiája. Egy vers vagy egy grafikán lévő, nem vízszintesen szedett szöveget is nehezebben értelmeznek a szövegfelismerők.
A tévesztések oka lehet, hogy a betűk túl közel vannak egymáshoz, és
a program egyetlen karakternek nézi őket (az „r” és „n” betűkből
ilyenkor gyakran „m” lesz); de ugyanígy, ha egy betű vonala megszakad
(például kopott nyomtatás miatt), a szoftver több karakterként ismeri
fel azt. Ugyancsak gyakori, hogy az OCR-programok eltévesztenek
karaktereket („o” helyett 0 számjegy), vagy lehagynak
ékezeteket.
A nyomtatott szövegek többsége bizonyos elfogadott, szabványos betűtípust használ; a kézírásos szövegek felismerése azonban még nehezebb, hiszen az íráskép egyénenként változik, és rengeteg tényező befolyásolja.
Az alábbi három példa három különböző hibaforrást mutat be.

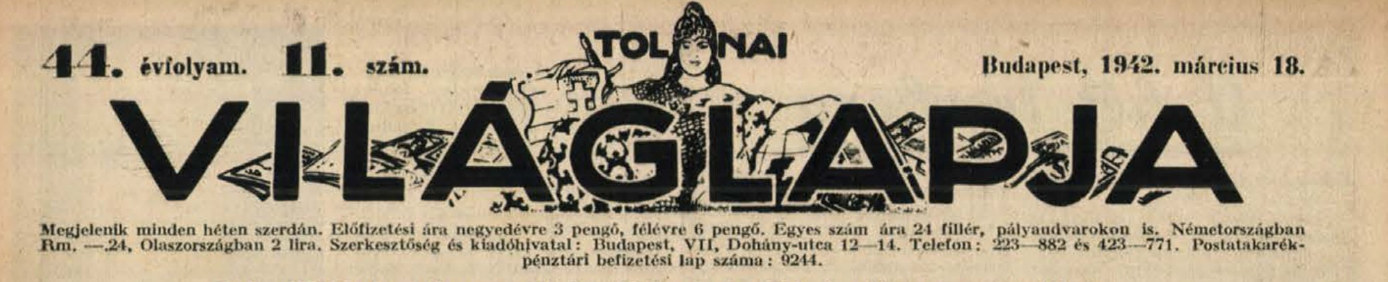
Mit tanulunk ebből? Ha egy digitalizált sajtóadatbázisban nem találja meg azt, amiről tudja, hogy szerepel a lapban, a hiba jó eséllyel nem az Ön keresésében van, hanem a szövegrétegben. Ilyenkor: próbáljon rövidebb, ékezet nélküli töredéket keresni; használjon csonkolást; végül pedig böngésszen, ne keressen – lapozza végig az adott lapszámot.
Gyakorlati feladat
Feladat 1. feladat – OCR-hibák felderítése
Válasszon ki egy digitalizált magyar hírlapot egy szabadon választott évből (pl. az Arcanum Digitális Tudománytár szabadon elérhető részéből vagy a Hungaricanáról).
Keressen rá egy olyan szóra, amelyről biztosan tudja, hogy szerepel a kiválasztott oldalon (mert látja az oldalképen).
Ha a keresés nem hozza a találatot, próbálja meg: rövidebb töredékkel; ékezetek nélkül; csonkolással.
Írja le, mi lehetett a hiba oka az oldalkép alapján (bélyegző? rossz kontraszt? képbe ágyazott szöveg? töredezett betű?).
Írja le, hogyan idézne szó szerint egy mondatot erről az oldalról: honnan veszi a szöveget, és mit ellenőriz?
Elvárt formátum: kb. 250 szavas szöveg, egy képernyőképpel az oldalképről.
Feladat 2. feladat – Digitalizálási terv
Tegyük fel, hogy egy családi hagyatékot digitalizál: 40 gépelt levél, 12 kézzel írt napló-oldal és 8 fénykép (pecséttel, aláírásokkal).
Készítsen digitalizálási tervet: mindhárom anyagtípushoz adja meg a felbontást, a színbeállítást és a fájlformátumot, és indokolja a döntést egy-egy mondattal. Jelölje meg, mely anyagoknál számít gyenge OCR-eredményre, és mit tenne helyette.
Elvárt formátum: háromsoros táblázat + indoklás.
Önellenőrző kérdések
1. Mi az OCR-technológia lényege?
Válasz megjelenítése
Különböző típusú dokumentumokat – beszkennelt papírokat, PDF-fájlokat, digitális fényképeket – szerkeszthető és kereshető szöveges adatokká alakít át.
2. Milyen részekből áll az OCR folyamata?
Válasz megjelenítése
Kép-előfeldolgozás; karakterek azonosítása; szöveggé alakítás.
3. Mi befolyásolja az OCR-folyamat eredményét? (Több válasz is lehetséges.)
Válasz megjelenítése
Az OCR-program mögött működő algoritmus és annak beállításai; az eredeti dokumentum fizikai állapota, a rajta lévő hibák, sérülések, szennyeződések; a szkennelés minősége; a szöveg betűtípusa, szedése, tipográfiája; kézírás esetén az íráskép egyéni jellegzetességei.
4. Milyen fájlformátumban érdemes elmenteni egy történelmi dokumentumot, ha könnyen kereshető szövegként szeretnénk használni?
Válasz megjelenítése
OCR-szövegréteget tartalmazó PDF-ben (archiválási célra PDF/A-ban). A JPG és a PNG csak képet tárol, szövegréteget nem.
5. Mit tesz, ha szó szerint szeretne idézni egy digitalizált forrásból?
Válasz megjelenítése
Az idézetet nem a nyers OCR-szövegből veszi át, hanem az oldalképen ellenőrzi és onnan írja át. A hivatkozásban az eredeti forrás adatait adja meg, kiegészítve azzal, hogy a digitalizált példányt hol érte el.
Összefoglalás
A digitalizáció korunk egyik legátfogóbb társadalmi és technológiai folyamata, amely jelentős kihívásokat és egyben lehetőségeket is teremt a történészek számára. A jövő történészeinek forrásai már jórészt born-digital, vagyis eleve digitálisan létrejött adatok és dokumentumok lesznek; a technológia emellett ma már lehetővé teszi, hogy a korábban jórészt papíralapon létrejött iratokat is digitalizáljuk, tartalmukat a számítógép számára is olvashatóvá, tömegesen feldolgozhatóvá tegyük. Ennek egyik eszköze az OCR-technológia.
A fejezet legfontosabb gyakorlati tanulsága azonban a hibákról szól: az OCR-szöveg nem azonos a forrás szövegével. Ha ezt tudja, akkor a kereséseit is másképp tervezi, és az idézeteit is másképp ellenőrzi – ez a különbség a digitális eszközök naiv és kritikus használata között.
Kulcsfogalmak
born-digital forrás – Olyan forrás, amely eleve digitális formában jött létre, és nem volt korábbi analóg verziója.
HTR (kézírásfelismerés) – Kifejezetten kézírásos szövegek gépi felismerésére szolgáló technológia (pl. Transkribus).
kétrétegű PDF – Olyan PDF-fájl, amely a dokumentum grafikai megjelenítése mellett egy szövegként azonosítható réteget is tartalmaz.
optikai karakterfelismerés (OCR) – Technológia, amely a beszkennelt papírokat, PDF-fájlokat vagy digitális fényképeket szerkeszthető és kereshető szöveges adatokká alakítja át.
PDF/A – Archiválási célra optimalizált PDF-formátum, amely a hosszú távú olvashatóságot biztosítja, és tartalmazhat OCR-szövegréteget.
felbontás (dpi) – A digitalizált kép részletgazdagságának mértéke; szöveghez legalább 300 dpi, kézirathoz 600 dpi ajánlott.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Schantz, H. F.: The History of OCR: Optical Character Recognition. Recognition Technologies Users Association, 1982.
- Wang, Junmiao: A Study of The OCR Development History and Directions of Development. Highlights in Science, Engineering and Technology 72. 409–415. https://www.researchgate.net/publication/377803605_A_Study_of_The_OCR_Development_History_and_Directions_of_Development
- Ring Orsolya: Történeti források kiadása a digitális világban – lehetőségek és gyakorlat. Magyar Tudomány 186. (2025) 10. sz. 2039–2050. https://www.akjournals.com/view/journals/2065/186/10/article-p2039.xml
Linkek és eszközök
- Transkribus (kézírásfelismerés) – https://www.transkribus.org/ – elérve: 2026. 08. 20.
- Venice Time Machine – bemutató videó – https://www.youtube.com/watch?v=7wJ8frgSn44 – elérve: 2026. 08. 06.
- Hordozható szkenner és OCR (videó, Wikimedia Commons) – https://commons.wikimedia.org/wiki/File:Portable_scanner_and_OCR_(video).webm – elérve: 2026. 08. 06.
- Arcanum Digitális Tudománytár – https://adt.arcanum.com/hu/ – elérve: 2026. 08. 20.
Könyvtári keresőfelületek: katalógusok és közös keresők
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 90 perc |
| Előfeltétel | Hogyan épül fel egy történeti kutatás? |
| Folytatás | Cikkszintű és nemzetközi keresés |
| Verzió / dátum | v0.1 / 2026. augusztus |
Miről szól ez a fejezet?
A kutatás második lépése – a kutatási kérdés megfogalmazása után – a szakirodalom feltárása. Ez a fejezet azokat a felületeket mutatja be, amelyek a kiadvány egészéről tudnak: megvan-e egy könyv, hol van meg, és kikölcsönözhető-e. Három nagy felületet mutat be közelről – a nemzeti könyvtár Széchényi Hídját, az ELTEfindet és az EDIT repozitóriumot –, mert ezek logikája a többi magyar könyvtári felületre is átvihető.
A cikkekre irányuló és a nemzetközi keresés a következő fejezetben következik: Cikkszintű és nemzetközi keresés.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- megkülönbözteti a könyvtári katalógust, a repozitóriumot és a közös keresőt (discovery), és megnevezi, melyiket milyen kérdéshez érdemes választani;
- önállóan lefuttat egy keresést az ELTE könyvtári katalógusában, és megállapítja, hogy egy kötet kölcsönözhető-e vagy csak helyben olvasható;
- tudatosan választ mezőt: megkülönbözteti a szabad szavas, a pontos kifejezéses és a tárgyszavas keresést, és megindokolja, mikor melyik való;
- alkalmazza a könyvtári keresők operátorait (csonkolás, elmosódó keresés, tartomány, logikai operátorok);
- megnevezi a nemzeti könyvtár gyűjteményeit, és megmondja, melyikben milyen típusú forrás található.
Bevezetés
A kutatásmódszertan egyik alapvető eleme a tudományos források hatékony felkutatása, rendszerezése és felhasználása. A történeti kutatás során számos olyan online eszköz áll rendelkezésre, amelyek segítenek a releváns szakirodalom és források elérésében, valamint a megfelelő hivatkozások kezelésében.
Három eszköztípust érdemes megkülönböztetni, mert más-más kérdésre adnak választ:
- a könyvtári katalógus arra válaszol, hogy hol van meg fizikailag egy mű, és kölcsönözhető-e;
- a repozitórium arra, hogy elérhető-e teljes szöveggel egy publikáció;
- a tudományos keresőmotor arra, hogy létezik-e egyáltalán irodalom egy témában, és ki idézte.
Jó kutatói gyakorlat mindhármat használni, mert egyikük sem teljes. Ez a fejezet az első kettőt tárgyalja ebben a sorrendben; a harmadikkal, a tudományos keresőmotorokkal a Cikkszintű és nemzetközi keresés fejezet foglalkozik.
1. Könyvtári keresőfelületek
A könyvtári keresőfelületek elengedhetetlen eszközök a történészhallgatók számára, mivel segítségükkel gyorsan és hatékonyan megtalálhatók a releváns nyomtatott és digitális források.
2.1 Országos Széchényi Könyvtár: a Széchényi Híd
Az eszköz alapadatai
| Eszköz neve | Széchényi Híd (az OSZK közös keresőfelülete) |
| URL | https://szechenyihid.oszk.hu/ |
| Üzemeltető | Országos Széchényi Könyvtár |
| Hozzáférés | Ingyenes, regisztráció nélkül kereshető |
| Regisztráció | Csak a kényelmi funkciókhoz (mentett listák, keresési előzmények). Nem azonos a könyvtári beiratkozással. |
| Tartalomtípus | Könyv, időszaki kiadvány, cikk, kézirat, kotta, térkép, plakát, kisnyomtatvány, fénykép, hangfelvétel, ex libris, metszet |
| Időkörök | A középkori kódexektől napjainkig |
| Méret | 14 gyűjtemény, összesen több mint 4 millió rekord (2026. 07.) |
Az Országos Széchényi Könyvtár Magyarország nemzeti könyvtára. Ez nem rangsor kérdése: a nemzeti könyvtárnak törvényben rögzített feladata, hogy a hungarikát – a Magyarországon megjelent, a magyar nyelvű és a magyar vonatkozású kiadványokat – teljességre törekedve gyűjtse és megőrizze.
Definíció Fogalom: kötelespéldány
Jogszabályi kötelezettség, amelynek alapján a kiadóknak minden Magyarországon megjelent kiadványból ingyenes példányt kell beszolgáltatniuk – ezek egyike a nemzeti könyvtárba kerül.
Miért fontos ez a történésznek? Mert ebből következik, hogy az OSZK katalógusa nem válogatás, hanem – elvben – teljes lista. Ha egy magyar kiadványt itt sem talál meg, akkor jó eséllyel valóban nem létezik olyan címen. Ez az egyetlen olyan magyar katalógus, amelynél a nulla találat tényleg érv.
2.1.1 Mi van a Széchényi Híd mögött?
Az OSZK 2026 nyarán indította el a Széchényi Hidat, amely egyetlen keresőmezőből teszi kereshetővé a katalógusait és a digitális tartalomszolgáltatásait. Korábban ezek külön felületek voltak, és a felhasználóknak előre kellett tudniuk, melyikben érdemes keresniük – épp ezt a döntéskényszert szünteti meg a Híd.
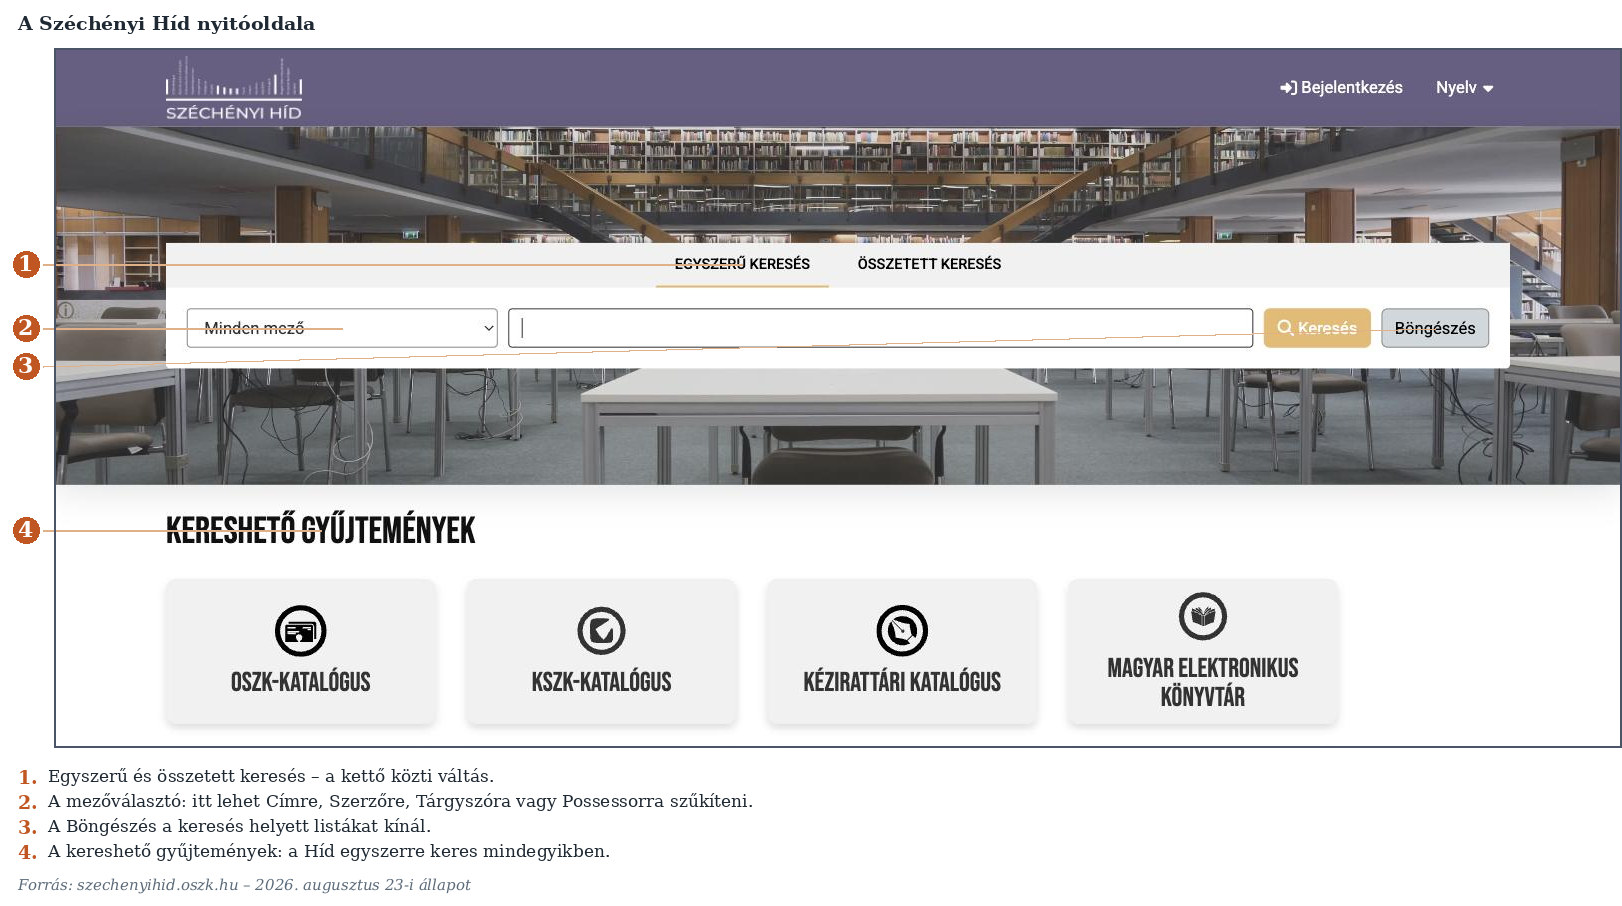
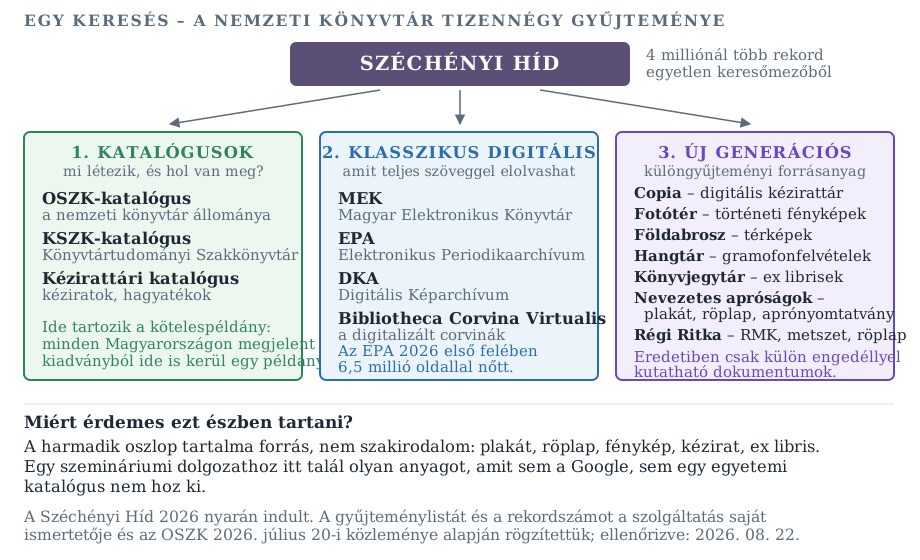
Tipp A harmadik oszlop a legfontosabb egy történésznek. A Copia, a Fotótér, a Földabrosz, a Hangtár, a Könyvjegytár, a Nevezetes apróságok és a Régi Ritka nem szakirodalmat, hanem forrást ad közre: kéziratot, fényképet, térképet, plakátot, röplapot, aprónyomtatványt, hangfelvételt.
Ezek jórészt olyan dokumentumok, amelyeket eredetiben csak külön kutatási engedéllyel lehetne kézbe venni.
Mélyebben Mit jelent a 2026-os tartalombővítés?
Az OSZK közleménye szerint a könyvtár 2026 nyaráig 15 millió oldalnyi új digitális tartalmat tett elérhetővé. A történész számára ebből három tétel számít igazán:
- az EPA közel 6,5 millió oldallal bővült: több mint hétszáz periodikacím, közel félmillió lapszám – a 19. század közepétől az 1950-es évek elejéig terjedő helyi sajtó Erdélyből, a Felvidékről, a Délvidékről, Kárpátaljáról és több vármegyéből, teljes szöveggel kutathatóan;
- ugyanitt vált elérhetővé a Magyar Távirati Iroda 1945–1987 közötti híranyaga, önmagában több mint másfél millió oldal;
- a MEK-be bekerült Szabó Károly Régi Magyar Könyvtár-bibliográfiája alapján az 1531 és 1711 között megjelent magyar nyelvű művek közel 1300 tétele.
A helyi sajtó teljes szövegű kereshetősége módszertani fordulat: eddig ehhez az anyaghoz mikrofilmolvasó gépek kellettek. Ez ugyanakkor új forráskritikai kötelezettséget is jelent – a teljes szövegű keresés OCR-en alapul, amelynek hibáiról a Digitalizálás és OCR fejezet szól.
2.1.2 A keresőmezők – és egy különleges
A Híd mezőválasztója hét lehetőséget kínál: Minden mező, Cím, Szerző, Tárgyszó, Jelzet, ISBN/ISSN – és Possessor. Az összetett keresésben ehhez jön még a Kiadó és a Sorozat.
Definíció Fogalom: possessor (birtokosbejegyzés)
Egy régi könyv vagy kézirat korábbi tulajdonosa, akit rendszerint a kötetbe írt tulajdonosi bejegyzés, ex libris vagy szuperexlibris azonosít. A katalogizálók ezt külön mezőben rögzítik.
Mire jó? Arra, hogy ne a tartalom, hanem a könyv sorsa felől lehessen kérdezni: mi volt egy főúri könyvtárban, mit olvasott egy adott család, hogyan szóródott szét egy gyűjtemény. Ez a könyvtörténet és az olvasmánytörténet alapkérdése.
Esettanulmány Keresés tulajdonosra
A Apponyi keresőszó a Possessor mezőben
2026. augusztus 22-én 14 találatot adott. Köztük:
„Jani Panonii (Pannonii) episcopi quinquecclesiensis (Pécs) de vita et laudibus epistola Baptistae Guarini Veronensis. Ferrariae 1467.” — Poss.: Apponyi gyűjtemény, kézirat
Vagyis: egyetlen mezőváltással előhívható, mi került a nemzeti könyvtárba gróf Apponyi Sándor gyűjteményéből. Ugyanez a keresés semmit nem adna a Minden mező beállításban értelmezhető formában, mert ott a szó szerzőként és címként is találatot hozna.
2.1.3 A tárgyszó, amely hidat épít
Ugyanazt a keresést háromféleképpen is le lehet futtatni, és a három eredmény egészen mást mutat. Az alábbi próbát a Széchényi Hídon és – összevetésül – az EDIT repozitóriumban is elvégeztük; az EDIT-ről a 2.3.6. alfejezetben lesz szó részletesen.
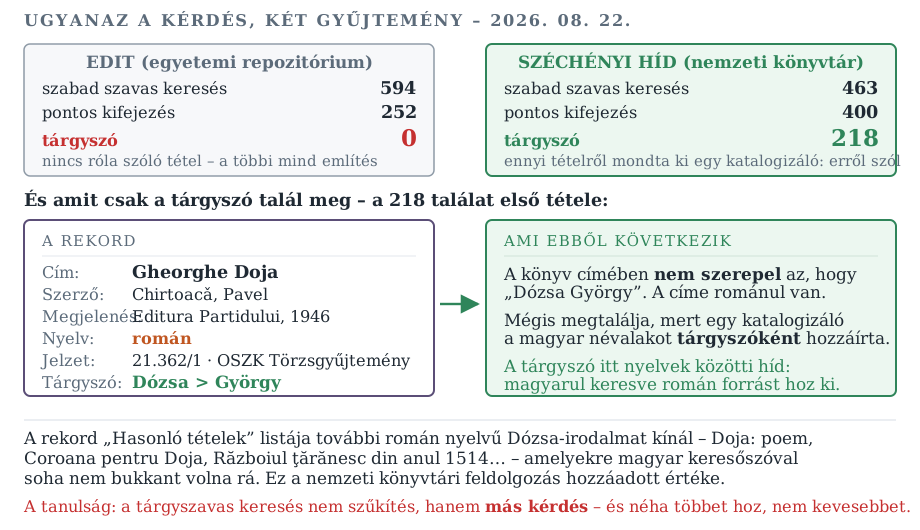
Esettanulmány Egy román nyelvű könyv, amelyet magyarul keresve talál meg
| Ahogy kerestem | EDIT | Széchényi Híd |
|---|---|---|
Dózsa György (minden mező) |
594 | 463 |
"Dózsa György" (pontos kifejezés) |
252 | 400 |
Tárgyszó = "Dózsa György" |
0 | 218 |
A nemzeti könyvtárban tehát 218 olyan tétel van, amelyről egy katalogizáló kimondta: ez Dózsa Györgyről szól. A találati lista első tétele pedig ez:
Gheorghe Doja / Chirtoacǎ, Pavel. [s.l.] : Editura Partidului, 1946. 20 p. Nyelv: román. Sorozat: Luptǎtori pentru libertatea poporului Român. Jelzet: 21.362/1, OSZK Törzsgyűjtemény. Tárgyszó: Dózsa > György
Álljunk meg itt egy pillanatra. Ennek a könyvnek a címében nem szerepel az, hogy „Dózsa György” – a címe románul van. Szabad szavas kereséssel, magyar keresőszóval soha nem került volna elő. Azért találjuk meg mégis, mert egy könyvtáros a feldolgozáskor hozzáírta a magyar névalakot mint tárgyszót.
A tárgyszó itt tehát nem szűkítő, hanem híd két nyelv között.
És ez még nem minden. A rekord „Hasonló tételek” listája további román nyelvű Dózsa-irodalmat kínál: Doja : poem (Székely János), Coroana pentru Doja (Ardeleanu Aurel Gheorghe), Războiul ţărănesc din anul 1514 de sub conducerea lui Gheorghe Doja (Pascu Ştefan). Egy magyar szakirodalmi keresés ezt a réteget teljesen elveszítené – pedig egy Dózsa-dolgozatban a román recepció önálló kérdés.
Figyelem A tárgyszó nem varázsszó. Ugyanaz a példa mutatja a korlátját is: az EDIT-ben nulla találat jött, mert ott senki nem adott ilyen tárgyszót. A tárgyszó emberi munka eredménye, és csak ott van, ahol elvégezték. Minél nagyobb és régebbi egy katalógus, annál megbízhatóbb; egy frissen épített repozitóriumban gyakran hiányzik.
2.1.4 Gyakorlás: melyik OSZK-gyűjteményben keresne?
Hat kutatási helyzet. A Híd egyszerre keres mindenben – de érdemes tudni, hogy melyik gyűjteményből jön a válasz, mert a Tartalomszolgáltatás fazettával egyből oda lehet szűkíteni.
Feladat Melyik OSZK-gyűjteményben keresne?
Döntse el minden helyzetről, melyik gyűjtemény adja a választ: OSZK-katalógus, EPA, Copia, Régi Ritka, Nevezetes apróságok vagy Fotótér / Digitális Képarchívum.
| # | A kutatási helyzet |
|---|---|
| 1 | Egy 1908-as kolozsvári napilap cikke egy helyi eseményről. |
| 2 | Egy 1650-es évekbeli magyar nyelvű nyomtatvány szövege. |
| 3 | Egy 19. századi író levelezése kéziratban. |
| 4 | Az 1956-os forradalom röplapjai és falragaszai. |
| 5 | Egy település utcaképe korabeli fényképen, az 1930-as évekből. |
| 6 | Megjelent-e valaha Magyarországon egy adott címmel könyv? |
2.1.5 A többi OSZK-adatbázis
A Híd nem fed le mindent. Ezek külön felületen érhetők el:
| Adatbázis | Mit tartalmaz? | URL |
|---|---|---|
| NEKTÁR | az OSZK központi online katalógusa (az OSZK, a Könyvtártudományi Szakkönyvtár és az MNM Könyvtára állománya) | https://nektar.oszk.hu/ |
| MNB | Magyar Nemzeti Bibliográfia – a hungarikát leíró nemzeti bibliográfiák közös felülete | https://mnb.oszk.hu/ |
| HUMANUS | humán tudományi cikkbibliográfia | https://humanus.oszk.hu/ |
| dHUpla | digitális bölcsészeti publikálási környezet szöveges források közreadására | – |
Tipp A HUMANUS a MATARKA testvérfelülete: szintén cikkszintű, de humán tudományi tanulmányokra fókuszál, és könyvfejezeteket is feldolgoz – ami a MATARKA vakfoltja. Ha egy témára a MATARKA keveset ad, érdemes itt is megnézni.
2.1.6 Amit érdemes tudni a felület használatáról
A Híd ugyanazon a keresőmotoron alapul, mint az ELTEfind – a két felület súgója az
operátorokról szó szerint azonos. Amit a 2.3-as
alfejezetben megtanul (*, ?, ~,
[… TO …],
AND/OR/NOT), az itt ugyanúgy
működik. Ez általánosítható tapasztalat: a magyar könyvtári
felületek nagy része ugyanarra a szoftvercsaládra épül.
A találati listát bal oldali fazettákkal lehet szűkíteni: Tartalomszolgáltatás (melyik gyűjteményből jött), Dokumentumtípus, Részgyűjtemény, Lelőhely, Szerző, Nyelv és Megjelenés éve.
Figyelem A felület legveszélyesebb tulajdonsága: a szűrők megmaradnak. A szolgáltatás saját ismertetője mondja ki: ha a szűrőket nem törli, és a logóra kattintva visszatér a kezdőoldalra, a szűrők érvényben maradnak, és az új keresés is csak azon a leszűkített halmazon fut.
A gyakorlati következmény: fél órával később nulla találatot kap valamire, ami biztosan létezik – mert egy régen elfelejtett „kézirat” szűrő még mindig aktív. Új keresés előtt mindig nézze meg a találati lista fölötti szűrősávot, és használja a „Szűrők törlése” gombot.
Tipp Három funkció, amit érdemes kihasználni:
- Permalink. Minden tételnek van állandó hivatkozása – ezt tegye a jegyzetébe, ne a böngésző címsorából másolt URL-t, mert az a keresési munkamenethez kötődik.
- Exportálás. A tételek és a mentett listák több formátumba exportálhatók, és a rendszer Zotero-kompatibilis (lásd a Zotero fejezetet).
- Keresési előzmények. Bejelentkezve visszanézhető, milyen kifejezéssel és milyen szűrőkkel keresett, és hány találatot kapott. A keresések elmenthetők és újrafuttathatók – ez a kutatás megismételhetőségének eszköze.
Figyelem A regisztráció nem beiratkozás. A Széchényi Hídon létrehozott fiók a kényelmi funkciókhoz kell, és teljesen független az OSZK olvasói nyilvántartásától. Ha eredeti dokumentumot szeretne kézbe venni, be kell iratkoznia – ez személyesen intézhető a Budavári Palota F épületében.
2.2 Fővárosi Szabó Ervin Könyvtár (FSZEK)
A Fővárosi Szabó Ervin Könyvtár Budapest legnagyobb közkönyvtári hálózata. Történészhallgatóként két okból érdemes ismernie: van benne olyan anyag, ami egyetemi könyvtárban nincs, és a Budapest Gyűjtemény miatt a fővárostörténeti témák megkerülhetetlen kiindulópontja.
Az eszköz alapadatai
| Eszköz neve | FSZEK Online (a hálózat közös katalógusa) |
| URL | https://fszekonline.fszek.hu/ |
| Üzemeltető | Fővárosi Szabó Ervin Könyvtár |
| Hozzáférés | Keresés regisztráció nélkül; kölcsönzéshez és a távoli adatbázis-eléréshez beiratkozás kell |
| Tartalomtípus | Könyv, folyóirat, hangzó és zenei anyag, helyismereti dokumentumok |
| Keresési szempontok | Szerző, cím, tárgyszó, kiadó, tárgykör, adathordozó, szereplő |
Amit a katalógus tud. A FSZEK Online a hálózat összes tagkönyvtárának állományát egyben keresi. A találati lista bal oldalán álló szűkítők (személy, dokumentumtípus, forrás, elektronikus hozzáférés, könyvtár, kiadó) mindegyike mellett ott a találatszám – ez a szűkítés a leggyakrabban kihagyott lépés.
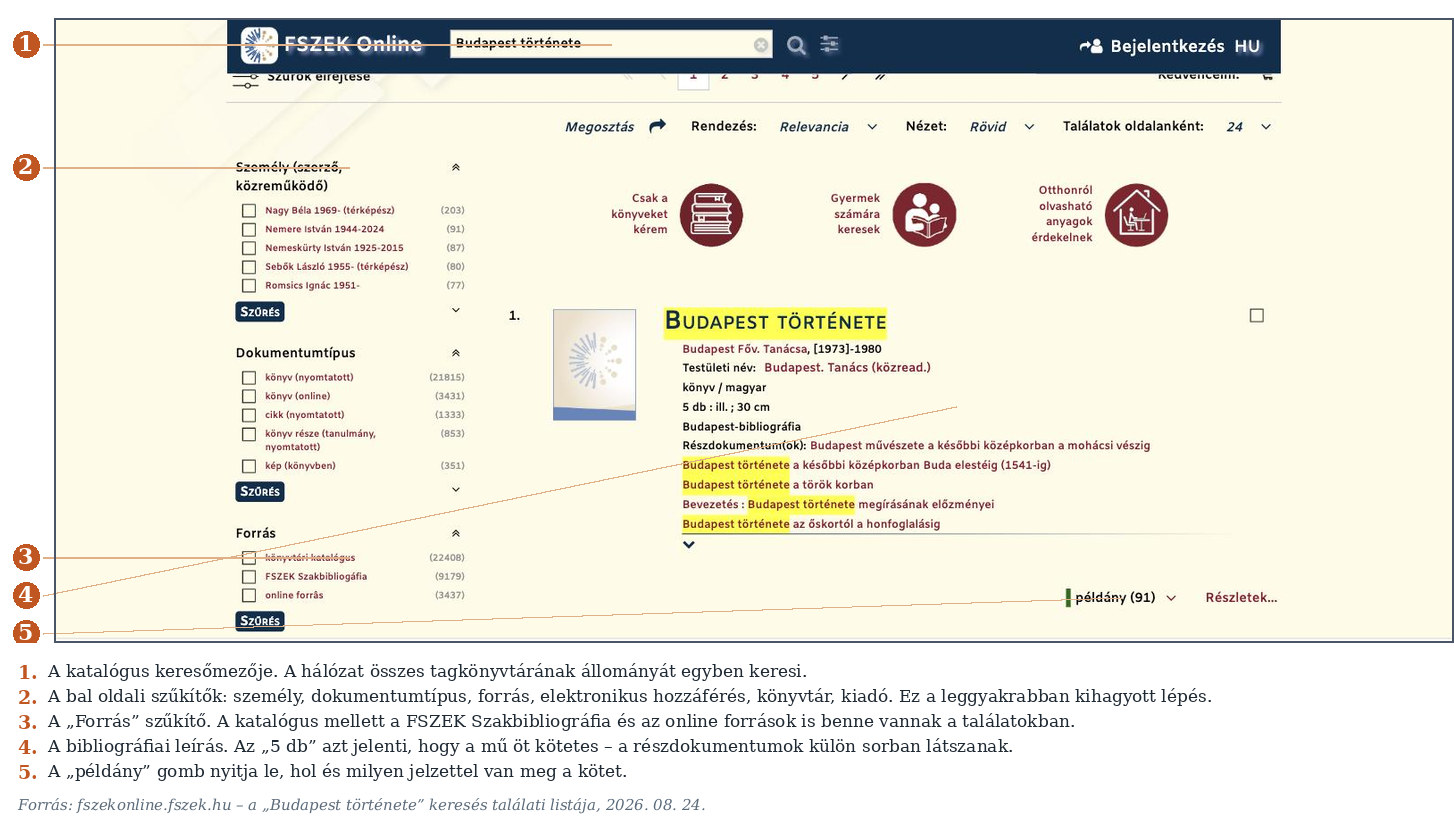
A példányadatok. Minden találatnál lenyitható a példánylista, és abban ott áll, hogy melyik tagkönyvtárban, melyik szinten vagy raktárban, milyen jelzettel és milyen státusszal (kölcsönözhető, helyben olvasható, kikölcsönzött) van meg a kötet. Ezt érdemes megnézni, mielőtt elindul: egy többkötetes műnél gyakran csak néhány kötet van kint a polcon, a többi raktári kérést igényel.
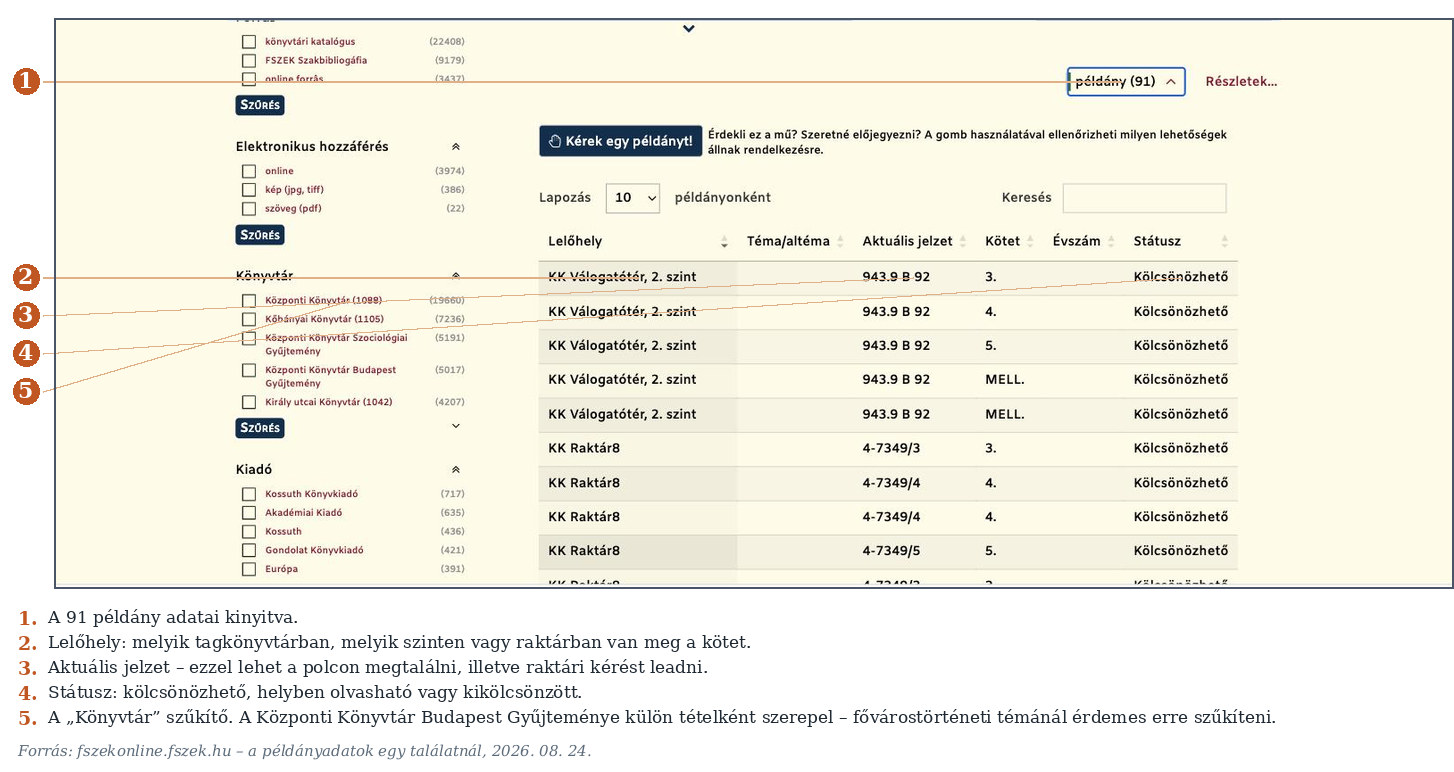
A könyvtár emellett az EBSCO Discovery Service (EDS) felületét is szolgáltatja, amely a katalóguson túl az előfizetett adatbázisokat is egy kérdéssel szólítja meg – ugyanaz a discovery-logika, mint az ELTEfind esetében.
A különgyűjtemények. A történeti kutatás szempontjából az egyik legfontosabb a Budapest Gyűjtemény (https://fszek.hu/budapest): a főváros történetére vonatkozó könyvek, folyóiratok, térképek, metszetek és aprónyomtatványok gyűjteménye. Emellett külön gyűjtemény foglalkozik a szociológiával (https://fszek.hu/sociology) – ez a 20. századi társadalomtörténeti témáknál hasznos –, valamint a zenei anyaggal (https://fszek.hu/music).
Tipp Mikor menjen ide az egyetemi könyvtár helyett?
Ha a témája Budapesthez kötődik (városrészek, intézmények, közlekedés, lakásviszonyok, helyi sajtó), a Budapest Gyűjtemény olyan aprónyomtatványokat és helyismereti anyagot őriz, amely az egyetemi katalógusban nem szerepel. Fordítva is igaz: szakmonográfiákat és külföldi szakirodalmat elsősorban az ELTEfind-ben keressen.
2.3 ELTE Egyetemi Könyvtár és Levéltár: az ELTEfind
Az ELTE Egyetemi Könyvtár az ország egyik legrégebbi és legnagyobb egyetemi könyvtára; állományát az egyetem közös keresőfelületén, az ELTEfind-en lehet elérni. Ez a felület a hallgatók legelső és legtöbbet használt kutatási eszköze, ezért érdemes közelebbről megnézni – nem azért, mert bonyolult, hanem mert a látszólag egyszerű keresőmező mögött három különböző adatbázis van, és a legtöbb sikertelen keresés ebből a félreértésből fakad.
Az eszköz alapadatai
| Eszköz neve | ELTEfind (az ELTE közös keresőfelülete) |
| URL | https://opac.elte.hu/ |
| Üzemeltető | ELTE Egyetemi Könyvtári Szolgálat |
| Hozzáférés | Ingyenes, regisztráció nélkül kereshető |
| Regisztráció | ELTE-s azonosítóval: kölcsönzés hosszabbítása, előjegyzés, raktári kérés, beszerzési javaslat |
| Tartalomtípus | Könyv, folyóirat, folyóiratcikk, kézirat, kisnyomtatvány, disszertáció, szakdolgozat, térkép, e-könyv |
| Időkörök | Ősnyomtatványoktól napjainkig |
| Méret | 41 lelőhely állománya + az EDIT repozitórium + az előfizetett adatbázisok |
Definíció Fogalom: közös kereső (discovery)
Olyan keresőfelület, amely több, egymástól független adatbázist szólít meg egyetlen űrlapról. Nem egyetlen nagy adatbázisról van szó: a felület a kérdést továbbítja, majd a válaszokat egységes formában jeleníti meg. Az ELTEfind az egyetem könyvtári rekordjait, az EDIT repozitórium tételeit és az előfizetett adatbázisokat fogja össze így.
2.3.1 Három fül, három adatbázis
A keresőmező fölött három fül van, és ez a legfontosabb tudnivaló az egész felületről: a fülek nem nézetek ugyanazon a találathalmazon, hanem külön adatbázisok. Amit az egyikben nem talál meg, azt a másikban még megtalálhatja.
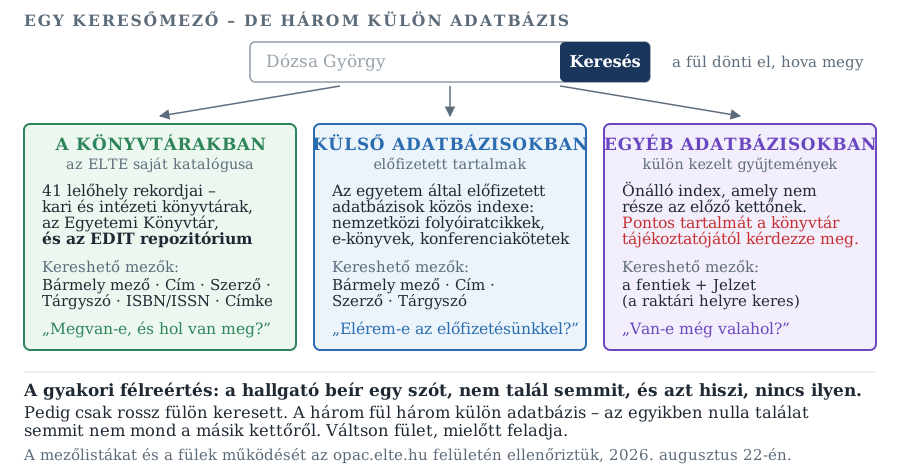
Az is látszik az ábrán, hogy a kereshető mezők fülenként eltérnek. A saját katalógusban tárgyszóra és ISBN-re is kereshet, a külső adatbázisokban csak négy mező áll rendelkezésre. Ennek egyszerű oka van: a külső index nem az ELTE-é, tehát csak azt tudja, amit a szolgáltató átad belőle.
Figyelem A nulla találat nem bizonyíték. Ha egy fülön nem jön ki semmi, az arról a fülről szól, nem a világról. Váltson fület, mielőtt azt a következtetést vonja le, hogy „ez nincs meg sehol”.
Ugyanez fordítva is igaz: ha a Külső adatbázisokban fülön talál egy tanulmányt, az nem jelenti azt, hogy a könyvtárban is megvan – az egy előfizetett online tartalom, amelyhez egyetemi belépés kell.
2.3.2 Mit tud, amit a Google nem?
Egy katalógus nem attól hasznos, hogy sok találatot ad, hanem attól, hogy megmondja, hol van a kötet, és kikölcsönözhető-e. Emellett három olyan keresési lehetősége van, amelyet érdemes külön kiemelni, mert a hallgatók szinte soha nem használják őket.
| Mező | Mit csinál? | Mikor való? |
|---|---|---|
| Tárgyszó | nem a szövegben keres, hanem abban, amit a katalogizáló írt be témaként | ha a témáról szóló műveket keres, nem a szót említőket |
| Tartalomjegyzék | a kötet tartalomjegyzékében keres | tanulmánykötetek egy-egy fejezetének megtalálására |
| Jelzet | a raktári jelre keres | ha a polcon egymás mellett álló műveket akarja átnézni |
Tipp A Tartalomjegyzék mező a felület legalulértékeltebb funkciója. Egy tanulmánykötet katalógusrekordjában a kötet címe szerepel – a benne lévő húsz tanulmányé nem. Ha viszont a könyvtár feldolgozta a tartalomjegyzéket, akkor erre a mezőre keresve kötetben elrejtett fejezeteket talál meg. Ez félúton van a katalógus és a MATARKA között: nem cikkszintű index, de belelát a kötetbe.
2.3.3 Az összetett keresés
Az Összetett (Search/Advanced) űrlapon
a keresés több sorból épül fel, és a sorok ÉS / VAGY / ÉS
NEM viszonyba állíthatók egymással. A keresőmezők száma nincs
korlátozva, és több keresőcsoport is felvehető: a
csoportokon belüli és a csoportok közötti viszony külön állítható.
A felület saját súgója egy jó példát ad arra, mire kell ez. „Kína
vagy India történetéről szóló könyvek” esetén egyetlen
sorba írva mindhárom szót csak azokat kapná meg, amelyek
mindkét országról szólnak. A megoldás: az első
csoportba India és Kína vagy
viszonyban, a második csoportba történet, a csoportok
között pedig „minden csoport”.
Négy szűkítő is rendelkezésre áll, és ezek mutatják meg igazán, hogy ez egy történészeknek való katalógus:
| Szűkítő | Mit kínál? | Miért érdekes? |
|---|---|---|
| Nyelv | kb. 100 nyelv | van benne akkád, sumér, kopt, óegyiptomi, ógörög, egyházi szláv, óangol, ófelnémet – ez egy ókortudományi és medievisztikai gyűjtemény lenyomata |
| Dokumentumtípus | 18 típus | kézirat, kisnyomtatvány, oklevél, disszertáció, folyóiratcikk, térkép – nem csak könyv |
| Különgyűjtemény | 17 gyűjtemény | ősnyomtatvány, antikva, kódex, Céhlevél gyűjtemény, Hevenesi, Kaprinai, Pray, Rariora Hungarica, Régi Magyar Könyvtár, Szekfű Gyula hagyatéka |
| Lelőhely | 41 hely | a kari és intézeti könyvtáraktól az EDIT repozitóriumig |
Mélyebben Egy hiba a szűkítőlistában – és mit tanulhatunk belőle
A Különgyűjtemény legördülő listájában a gyűjteménynevek között ott áll ez a tétel is:
[Paris] : Éditions des Quatre jeudis, 1958-1959 ; Strasbourg : Éditions Européa, 1960-1961 ; Paris : G.-P. Maisonneuve et Larose, 1962-1970
Ez nyilvánvalóan nem gyűjteménynév, hanem egy kiadási adat, amely rossz mezőbe került a katalogizálás során. Egyetlen elgépelt rekord, és a felület azonnal felkínálja szűkítési lehetőségként.
Miért érdemes ezt megnézni? Mert megmutatja, hogyan működik egy fazetta: a felület nem előre megírt listát mutat, hanem összegyűjti, milyen értékek szerepelnek abban a mezőben az adatbázisban. Ha egy érték rossz helyre kerül, az nem elrejtőzik, hanem kiül a felületre. Ugyanezt a jelenséget látta az AdatbázisokOnline helynévállapotainál is.
A tanulság a kutatásra nézve: a szűkítők nem hatóságok. Egy 0 találat jelentheti azt, hogy nincs ilyen – és azt is, hogy másik mezőbe írták be.
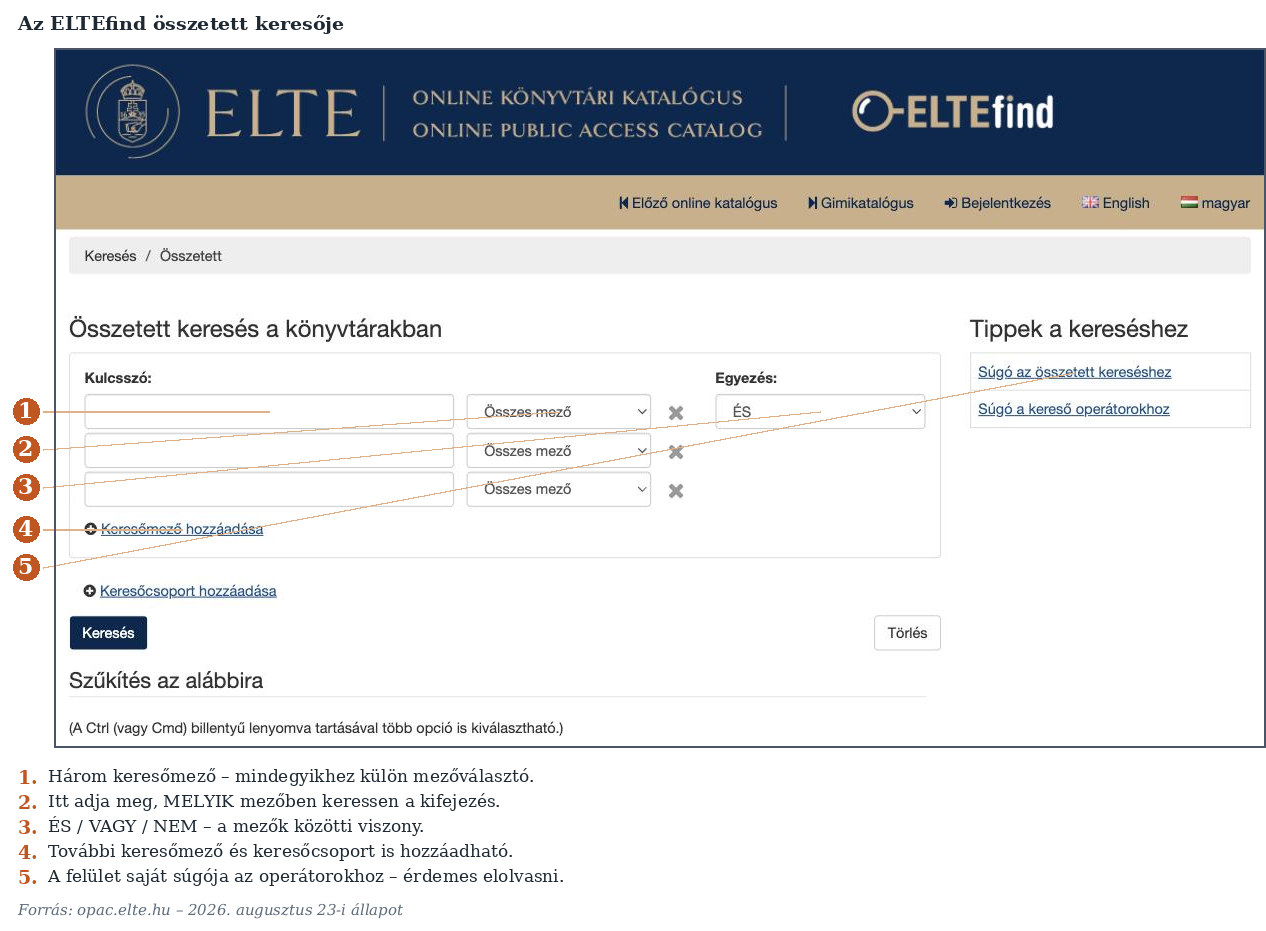
2.3.4 Operátorok: amivel a keresés élesíthető
A felület a súgójában közli a használható operátorokat. Ezek nem az ELTEfind sajátjai: a legtöbb könyvtári és tudományos keresőben ugyanígy működnek, tehát amit itt megtanul, azt máshol is használni fogja.
| Jel | Mit csinál? | Példa | Mikor való? |
|---|---|---|---|
* |
nulla vagy több karaktert helyettesít | kult* → kultúra, kultúrák, kulturális |
ragozott alakok együtt |
? |
egyetlen karaktert helyettesít | sz?n → szán, szén, szín |
bizonytalan betű |
"…" |
pontos kifejezés | "magyaros verselés" |
ha a szavaknak együtt kell állniuk |
~ |
elmosódó (fuzzy) keresés | Tchaikovsky~ |
eltérő névátírásokra |
"…"~N |
közelítő keresés: a szavak legfeljebb N szó távolságra | "magyaros verselés"~3 |
ha köztük más is állhat |
[… TO …] |
tartomány | [1902 TO 1914] |
évkörre szűkítés |
AND OR NOT |
logikai operátorok, csupa nagybetűvel | magyaros NOT verselés |
kizárás, alternatívák |
+ - |
kötelező, illetve tiltott szó | +filoxéra borászat |
egy szó mindenképp kelljen |
Tipp A ~ a történész
leghasznosabb eszköze a régi neveknél. Egy 19. századi szerző
neve leírható két-három írásmóddal is (Tchaikovsky,
Csajkovszkij, Tschaikowsky), és a katalógusban
nem feltétlenül az szerepel, amit Ön beír. A Csajkovszkij~
alakra keresve a rendszer a hasonló írásmódokat is behozza. A hasonlóság
szigora 0 és 1 között állítható: Csajkovszkij~0.8
szigorúbb, kevesebb, de pontosabb találatot ad.
A NOT önmagában nem működik. Kell elé
egy állító tag: a NOT magyaros üres eredményt ad, a
verselés NOT magyaros viszont működik.
2.3.5 Egy név, három keresési mód
Az alábbi próbakeresés az EDIT-ben készült – ez ugyanaz a tételkör, amely az ELTEfind első fülén is bent van, és a tanulság minden katalógusra áll.
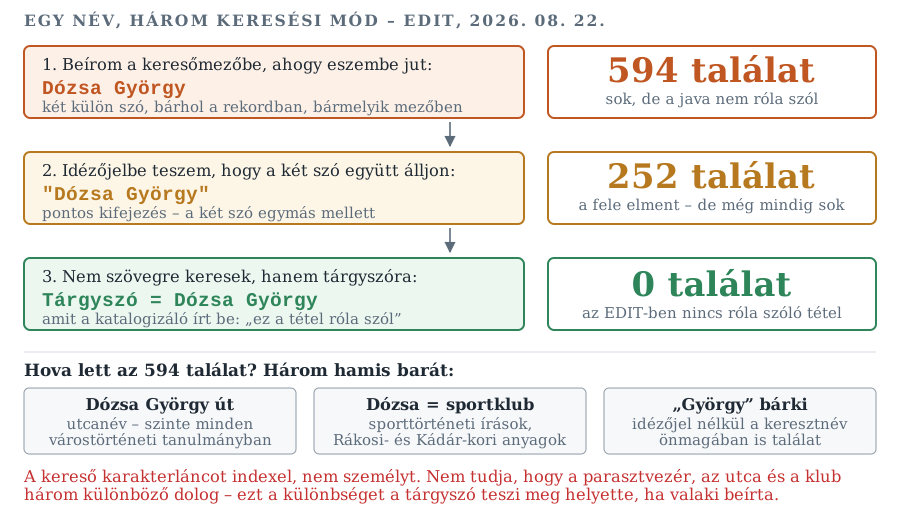
Esettanulmány 594 – 252 – 0
A Dózsa György keresés az EDIT-ben 2026. augusztus 22-én
a következőt adta:
| Ahogy kerestem | Találat |
|---|---|
Dózsa György (szabadon, minden mezőben) |
594 |
"Dózsa György" (idézőjelben, pontos kifejezésként) |
252 |
Tárgyszó = Dózsa György |
0 |
Az első szám a legrosszabb. Idézőjel nélkül a
rendszer két külön szót keres, és a György önmagában is
találat: minden György nevű szerző, szereplő és címszereplő bekerül.
A második szám már kifejezésre szűkít – és mégis félrevezető. A találati lista élén ilyen tételek állnak: Az új gazdaság térnyerése Budapest városközpontjában, Mezőváros és szecesszió, Fejezetek a magyar testnevelés történetéből. Egyik sem Dózsa Györgyről szól. A Dózsa György út és a Dózsa nevű sportegyesületek miatt kerültek be.
A harmadik szám a legőszintébb: nulla. Az EDIT-ben egyetlen tétel sincs, amelynél a katalogizáló azt a tárgyszót adta volna, hogy a mű Dózsa Györgyről szól. Vagyis: a 594 találat mind mellékes említés.
Miért fontos ez? Mert a nulla itt hasznos válasz. Öt perc alatt kiderült, hogy ebben a gyűjteményben nincs mit keresni a témában, és tovább lehet lépni egy másik felületre. Aki csak az 594-et látja, az órákat tölt el egy üres lelőhely átlapozásával.
Mélyebben Karakterlánc vagy személy?
A keresőmotor Dózsa György esetén
karakterláncot keres. Nem tudja, hogy a parasztvezér, a
róla elnevezett utca és a róla elnevezett sportklub három különböző
dolog – csak azt látja, hogy ugyanaz a tizenkét karakter.
Ezt a különbséget a könyvtári világban a besorolási adat (authority record) teszi meg: egy azonosítóval ellátott tétel, amely rögzíti, hogy ez a Dózsa György az 1470 körül született parasztvezér, és felsorolja a névváltozatait. A tárgyszó és a szerzőnév ilyen ellenőrzött mezők – ezért ad más eredményt a rájuk irányuló keresés, mint a szabad szöveges.
Ugyanez a gondolat tér vissza az ORCID és DOI fejezetben (a kutatók és a publikációk azonosítói), és ez az alapja annak, amit az adatbázisokról szóló fejezet entitásnak nevez.
2.3.6 Az EDIT: az ELTE saját repozitóriuma
Az EDIT (ELTE Digitális Intézményi Tudástár) az egyetemen keletkezett és az egyetem által digitalizált dokumentumok tárhelye. Nem különálló világ: rekordjai az ELTEfind első fülén is megjelennek – a Lelőhely szűkítőben önálló lelőhelyként szerepel.
Az eszköz alapadatai
| Eszköz neve | EDIT – ELTE Digitális Intézményi Tudástár |
| URL | https://edit.elte.hu/ |
| Üzemeltető | ELTE Egyetemi Könyvtár és Levéltár |
| Hozzáférés | Ingyenes; a tételek túlnyomó része nyilvános |
| Regisztráció | Csak feltöltéshez és egyes zárt tételekhez |
| Tartalomtípus | Publikációk, disszertációk, egyetemi kiadványok, oklevelek, kéziratok, kisnyomtatványok, metszetek, fényképek, videók |
| Időkörök | Középkori oklevelektől napjainkig |
| Méret | 10 kategória, kb. 76 500 tétel (2026. 08.) |
Tíz kategóriából áll; a tételszámok 2026. augusztus 22-én a következők voltak:
| Kategória | Tétel |
|---|---|
| Muzeális gyűjtemények, E-könyvtár | 31 113 |
| ELTE Folyóiratok, kiadványok | 20 608 |
| Publikációk | 16 886 |
| Disszertációk (ELTE PHD) | 5 052 |
| Egyetemi Fotótár | 900 |
| Oktatási anyagok | 778 |
| Könyvtári és levéltári dokumentumtár | 598 |
| Szabadalmak, pályázati termékek | 392 |
| Videotár | 171 |
| Kutatástámogatás | 96 |
Mélyebben Egy gyűjtemény arca a böngészőlistáiban
Az EDIT nyitóoldalán ott a szerzők és a tárgyszavak gyakorisági listája. A leggyakoribb „szerzők” 2026 augusztusában ezek voltak:
Mátyás (Magyarország: király ; 1443–1490) I. – 393 · Lipót (Magyarország: király, 1640–1705) I. – 303 · Zsigmond (Magyarország: király, Luxemburgi, 1368–1437) – 271
A leggyakoribb tárgyszavak pedig: Kaprinai (7614), 19. sz. (6622), portré (6196), kisnyomtatvány (5180), doktori disszertáció (3442).
Ez első ránézésre furcsa: miért középkori és kora újkori uralkodók az egyetemi repozitórium leggyakoribb „szerzői”? Azért, mert a legnagyobb kategória a muzeális gyűjtemény: oklevelek, kéziratok, kisnyomtatványok, metszetek. Egy oklevél „szerzője” a kiállító uralkodó.
A tanulság módszertani. A böngészőlisták nem a gyűjtemény fontossági sorrendjét mutatják, hanem azt, mit digitalizáltak eddig. Aki ebből arra következtetne, hogy az ELTE-n Mátyás király a legkutatottabb téma, az a digitalizálási döntéseket olvasná tudománytörténetnek. Ugyanez a csapda a Fortepan és az Arcanum statisztikáinál is.
Tipp Az EDIT-ben a Tárgyszó szerinti szűkítés külön menüpont („Témakör szerinti keresés”), és a találati lista oldalán is ott van fazettaként. Ha egy szabad szavas keresés használhatatlanul sok találatot ad, ez az első lépés a szűkítéshez – ahogy azt a fenti esettanulmány is mutatja.
2.3.7 Böngészés és a bejelentkezés
A keresésen kívül betűrendes böngészés is van: témakör, szerző és cím szerint. Ez akkor hasznos, amikor még nem tudja, milyen szóra kellene keresnie – a lista megmutatja, milyen tárgyszavak léteznek egyáltalán.
Bejelentkezés után a felület a kutatás adminisztratív részét is kezeli: kölcsönzés hosszabbítása, előjegyzés, raktári kérés és beszerzési javaslat. A találatok menthetők, exportálhatók, címkézhetők és megoszthatók; az exportált hivatkozás közvetlenül betölthető a Zotero programba.
Tipp Ha áll a katalógus. Az online felületek időnként hibáznak – ennek az alfejezetnek a próbakeresései is elmaradtak egy adatbázishiba miatt. Ilyenkor nem kell leállni a kutatással:
- Nézze meg ugyanazt a MOKKA vagy a WorldCat felületén – a bibliográfiai adat ugyanaz, csak a példányadat nem.
- Az ELTE digitális anyagához használja közvetlenül az EDIT-et.
- Jegyezze fel, mikor és mit nem sikerült lefuttatni. Ha a szakdolgozata egy keresés eredményére hivatkozik, a keresés dátuma a hivatkozás része.
2.3.8 Gyakorlás: élesítse a keresést!
Nyolc keresési helyzet. Mindegyiknél egy fogás segít – döntse el, melyik.
Feladat Élesítse a keresést!
Döntse el minden helyzetről, melyik fogás segít: csonkolás
(*), elmosódó keresés
(~), pontos kifejezés (idézőjel),
évkör-tartomány, kizárás (NOT vagy
-), mezőváltás (Tárgyszó vagy
Tartalomjegyzék) vagy fülváltás (másik adatbázis).
Indokolja egy mondatban.
| # | A keresési helyzet |
|---|---|
| 1 | A kultúra, kultúrák és kulturális alakok mind érdeklik. |
| 2 | Egy 19. századi szerző nevét többféle írásmóddal is átírhatták. |
| 3 | Csak az első világháború előtti bő évtized kiadványai kellenek. |
| 4 | Két szónak egymás mellett kell állnia. |
| 5 | A névre rengeteg sporttörténeti találat jön, azok nem kellenek. |
| 6 | Nem az érdekli, hol említik a témát, hanem az, hogy melyik mű szól róla. |
| 7 | Egy tanulmánykötetben sejt egy fejezetet, de a kötet címe mást mond. |
| 8 | Az első fülön nulla találat jött, pedig biztos, hogy van előfizetett tanulmány. |
2.4 ELTE BTK Kari Könyvtár és Szekfű Gyula Könyvtár
Az ELTE BTK Könyvtára és a Szekfű Gyula Könyvtár kifejezetten a bölcsészhallgatók és a történeti kutatások számára fontos gyűjteményeket tartalmaz.
- a bölcsészettudományok teljes spektrumát lefedő szakirodalom;
- elektronikus és nyomtatott források egyaránt elérhetők;
- hozzáférés az egyetemi könyvtári adatbázisokhoz.
- a Történeti Intézet könyvtára, a történész hallgatók és kutatók egyik legfontosabb forrásbázisa;
- szakkönyvek, monográfiák, folyóiratok és egyéb történeti források;
- az állomány kereshető az ELTE Központi Könyvtár katalógusán keresztül.
Tipp A katalógustalálatnál mindig nézze meg a példányadatokat: a jelzetet, a lelőhelyet és a státuszt. Ebből derül ki, hogy a kötet kölcsönözhető-e vagy csak helyben olvasható – ez a szemináriumi munka tervezésénél gyakran fontosabb, mint maga a találat.
2.5 További fontos magyar és nemzetközi keresőfelületek
(A magyar folyóiratcikkek kereséséről külön alfejezet szól: lásd MATARKA.)
2. Online repozitóriumok
Definíció Fogalom: online repozitórium
Olyan digitális archívum, amely tudományos publikációkat, kutatási anyagokat és forrásokat tesz szabadon vagy korlátozott hozzáféréssel elérhetővé. Lehet egyetemi adatbázis, nemzeti könyvtári gyűjtemény vagy tematikus történeti repozitórium.
Történészek számára fontos repozitóriumok és gyűjtemények:
- Hungaricana – magyar történeti források és digitalizált levéltári anyagok;
- Europeana – az európai kulturális örökség digitális archívuma;
- MTMT (Magyar Tudományos Művek Tára) – magyar kutatók publikációs adatbázisa (lásd az MTMT fejezetet);
- REAL, Google Scholar, CORE, JSTOR – nemzetközi és hazai tanulmányok keresésére.
A repozitóriumokról részletesebben a Repozitóriumok fejezet szól.
Esettanulmány
Esettanulmány Egy tétel útja a katalógustól a polcig
Tegyük fel, hogy egy szemináriumi dolgozathoz szüksége van Hegyi Dolores Polis és vallás. Bevezetés a görög vallástörténetbe (Budapest, 2002) című kötetére.
Első lépés: létezik-e egyáltalán? A Széchényi Hídon a kötelespéldány-rendszer miatt szinte biztosan megvan – és ha ott sincs meg, akkor komoly az esély rá, hogy a cím vagy az évszám téves.
Második lépés: hol férek hozzá? Az ELTEfinden rákeres a címre. A találat példányadataiból derül ki, hogy a Szekfű Gyula Könyvtárban megvan-e, és kölcsönözhető-e vagy csak helyben olvasható. Ha csak helyben olvasható, a munkatervét ehhez kell igazítania.
Harmadik lépés: mi van körülötte? Nyissa meg a kötet tárgyszavait, és kattintson rájuk. Ez a katalógus legalulértékeltebb funkciója: a tárgyszó elvezet azokhoz a művekhez, amelyekről egy könyvtáros kimondta, hogy ugyanarról szólnak – akkor is, ha a címükben egészen más szerepel.
Negyedik lépés: rögzítés. A tételt azonnal mentse el a Zoteróba a katalógusból származó pontos bibliográfiai adatokkal. A katalógusból importált rekord megbízhatóbb, mint bármelyik webes forrásból származó.
A tanulság: egyetlen felület nem elég önmagában. A nemzeti könyvtár arról ad választ, hogy létezik-e; az egyetemi katalógus arról, hogy hozzáférek-e; a tárgyszó pedig arról, hogy mi tartozik még ide.
Gyakorlati feladatok
Feladat 1. feladat – Könyvtári keresés
Nézzen utána, hogy elérhetők-e az alábbi művek a Szekfű Gyula Könyvtárban. Ha igen, azt is írja oda, hogy az adott kötet kölcsönözhető-e vagy csak helyben olvasható.
- Hegyi Dolores: Polis és vallás. Bevezetés a görög vallástörténetbe. Budapest, 2002.
- Kerényi Károly: Görög mitológia. Budapest, 1977.
- Buxton, Richard: A görög mitológia világa. Budapest, 2004.
- Sarkady János (szerk.): Görög vallás. Görög istenek. Budapest, 1974.
- Ogden, Daniel: A Companion to Greek Religion. Blackwell, 2007.
Elvárt formátum: ötsoros táblázat (tétel – megvan-e – kölcsönözhető/helyben).
Feladat 2. feladat – Három keresés, három szám (20 perc)
Válasszon egy személyt vagy témát a saját érdeklődéséből, és futtassa le ugyanazt a keresőszót a Széchényi Hídon háromféleképpen:
- szabadon, minden mezőben;
- idézőjelben, pontos kifejezésként;
- a Tárgyszó mezőben.
Jegyezze fel a három találatszámot, és egy-egy mondatban indokolja a különbséget. Nézze meg a harmadik keresés első öt találatát: van-e köztük olyan, amelyre a szabad szavas keresés nem vezetett volna rá?
Feladat 3. feladat – Bibliográfia összeállítása
Állítson össze egy három tételből álló bibliográfiát a „Török világ Magyarországon” című témához, pontos bibliográfiai adatokkal. Az egyes tételek mellett adja meg azt is, hogy elérhetők-e teljes szöveggel online, illetve megtalálhatók-e a Szekfű Gyula Könyvtárban.
Elvárt formátum: háromtételes irodalomjegyzék Korall-stílusban, tételenként egy megjegyzéssorral.
Önellenőrző kérdések
1. Mi a különbség a könyvtári katalógus és a repozitórium között?
Válasz megjelenítése
A katalógus arról ad információt, hogy egy mű fizikailag hol érhető el és kölcsönözhető-e; a repozitórium a publikációk teljes szövegét teszi elérhetővé digitálisan.
2. Mit jelent, hogy a Széchényi Híd és az ELTEfind „közös kereső”?
Válasz megjelenítése
Hogy több, egymástól független adatbázist szólítanak meg egyetlen űrlapról: a kérdést továbbítják, majd a válaszokat egységes formában jelenítik meg. Nem egyetlen nagy adatbázisról van szó – ezért fordulhat elő, hogy az egyik fülön nulla találat jön, a másikon pedig nem.
3. Miért mondható, hogy a nemzeti könyvtárban a nulla találat is érv?
Válasz megjelenítése
A kötelespéldány-rendszer miatt minden Magyarországon megjelent kiadványból kerül példány a nemzeti könyvtárba, tehát a katalógusa nem válogatás, hanem – elvben – teljes lista. Ha egy magyar kiadvány ott sincs meg, jó eséllyel nem létezik olyan címen. Más katalógusoknál a nulla találat csak az adott gyűjteményről szól.
4. Mit ad a tárgyszavas keresés, amit a szabad szavas nem?
Válasz megjelenítése
Azt, amiről egy katalogizáló kimondta, hogy a mű arról szól – nem csupán azt, hogy a szó előfordul benne. Ellenőrzött mező, ezért nyelvtől és címadástól függetlenül működik: idegen nyelvű címmel megjelent művet is megtalál a magyar névalakkal.
5. Mire való a „Tartalomjegyzék” mező az összetett keresésben?
Válasz megjelenítése
Tanulmánykötetekben elrejtett fejezetek megtalálására: a kötet tartalomjegyzékében keres. Félúton van a katalógus és a cikkszintű index között – nem cikkszintű, de belelát a kötetbe.
Összefoglalás
A kiadványszintű keresésnek három alapfelülete van, és mindhárom más kérdésre válaszol. A nemzeti könyvtár (Széchényi Híd) arról, hogy létezik-e egy magyar kiadvány – a kötelespéldány miatt itt a nulla találat is érv. Az egyetemi katalógus (ELTEfind) arról, hogy hozzáférek-e, és a példányadatokból az is kiderül, kölcsönözhető-e. A repozitórium (EDIT, REAL) arról, hogy elérhető-e teljes szöveggel.
Két fogás, amely mindhárom felületen működik. Az egyik a mezőválasztás: a tárgyszavas keresés mást ad, mint a szabad szavas – nem szűkítést, hanem más kérdést. A másik az operátorok ismerete: a csonkolás, az elmosódó keresés és a tartomány ugyanúgy működik a magyar könyvtári felületek nagy részén, mert közös szoftvercsaládra épülnek.
A cikkekre irányuló keresés más eszközöket kíván – erről szól a következő fejezet: Cikkszintű és nemzetközi keresés.
Kulcsfogalmak
könyvtári katalógus – Egy vagy több könyvtár állományának nyilvántartása; arról ad választ, hogy egy mű fizikailag hol érhető el és kölcsönözhető-e.
közös kereső (discovery) – Olyan keresőfelület, amely több független adatbázist szólít meg egyetlen űrlapról, és a válaszokat egységes formában jeleníti meg.
kötelespéldány – Jogszabályi kötelezettség, amelynek alapján minden Magyarországon megjelent kiadványból ingyenes példányt kell beszolgáltatni; ezért teljes a nemzeti könyvtár katalógusa.
tárgyszó – Ellenőrzött mező, amely azt rögzíti, miről szól a mű – szemben a szabad szavas kereséssel, amely csak a szó előfordulását keresi.
possessor – Egy régi könyv vagy kézirat korábbi tulajdonosa; a nemzeti könyvtár katalógusában önálló keresőmező.
online repozitórium – Digitális archívum, amely tudományos publikációkat és forrásokat tesz szabadon vagy korlátozott hozzáféréssel elérhetővé.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Széchényi Híd – az OSZK közös keresőfelülete: „Ismertetés” és „Segítség a kereséshez” oldal. https://szechenyihid.oszk.hu/ (elérve: 2026. 08. 22.)
- Országos Széchényi Könyvtár: Katalógusok, adatbázisok. https://www.oszk.hu/ (elérve: 2026. 08. 22.)
- Az OSZK 2026. július 20-i közleménye a 15 millió oldalnyi tartalombővítésről.
- ELTEfind – az ELTE közös keresőfelülete és súgóoldalai. https://opac.elte.hu/ (elérve: 2026. 08. 22.)
- EDIT – ELTE Digitális Intézményi Tudástár. https://edit.elte.hu/ (elérve: 2026. 08. 22.)
Linkek és eszközök
- OSZK – https://www.oszk.hu – elérve: 2026. 08. 20.
- FSZEK – https://www.fszek.hu – elérve: 2026. 08. 20.
- ELTE Egyetemi Könyvtár katalógusa – https://opac.elte.hu/ – elérve: 2026. 08. 20.
- ELTE BTK Kari Könyvtár – https://konyvtar.btk.elte.hu/ – elérve: 2026. 08. 20.
- Szekfű Gyula Könyvtár – https://konyvtar.btk.elte.hu/szekfu-gyula-konyvtar – elérve: 2026. 08. 20.
- MOKKA – https://mokka.hu/ – elérve: 2026. 08. 20.
- WorldCat – https://search.worldcat.org/ – elérve: 2026. 08. 20.
- Google Scholar – https://scholar.google.hu/ – elérve: 2026. 08. 20.
- JSTOR – https://www.jstor.org/ – elérve: 2026. 08. 20.
- JSTOR súgó (angol) – https://guides.jstor.org/c.php?g=1227490&p=9885780 – elérve: 2026. 08. 20.
- EBSCO – https://www.ebsco.com/ – elérve: 2026. 08. 20.
- ProQuest – https://www.proquest.com/ – elérve: 2026. 08. 20.
Cikkszintű és nemzetközi keresés
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 60 perc |
| Előfeltétel | Könyvtári keresőfelületek |
| Verzió / dátum | v0.1 / 2026. augusztus |
Miről szól ez a fejezet?
Az előző fejezet felületei egy dolgot nem tudnak: a folyóiratszámok belsejébe nézni. A katalógus megmondja, hogy a Századok megvan a könyvtárban, de nem azt, hogy melyik évfolyamában van cikk a témájáról.
Ez a fejezet erről szól: a cikkszintű kereséséről magyar folyóiratokban (MATARKA), valamint a nemzetközi tudományos keresésről (Google Scholar, JSTOR). A záró gyakorló pedig azt teszi próbára, hogy egy adott kutatási helyzetben melyik felületen érdemes kezdeni.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- megkülönbözteti a kiadványszintű, a cikkszintű és a teljes szövegű keresést, és megmondja, melyik kérdéshez melyik való;
- a MATARKA-ban cikkszintű keresést futtat, évkörre és szakterületre szűkít, és megtalálja a teljes szöveghez vezető linket;
- megnevezi a MATARKA vakfoltját, és megmondja, mivel pótolható;
- a Google Scholarban megkeresi egy tanulmány szabadon elérhető változatát, és kiexportálja a hivatkozását;
- a JSTOR-ban intézményi belépéssel összetett keresést futtat, és felismeri, mely tartalmakhoz van tényleges hozzáférése;
- egy megadott kutatási helyzethez kiválasztja a megfelelő keresőfelületet, és megindokolja a választását.
1. MATARKA: cikkszintű keresés a magyar folyóiratokban
Az eszköz alapadatai
| Eszköz neve | MATARKA – Magyar folyóiratok tartalomjegyzékeinek kereshető adatbázisa |
| URL | https://matarka.hu/ |
| Üzemeltető | Miskolci Egyetem Könyvtár, Levéltár, Múzeum |
| Hozzáférés | Ingyenes, regisztráció nélkül |
| Regisztráció | Nem szükséges |
| Tartalomtípus | Folyóiratcikkek bibliográfiai adatai (szerző, cím, rovat, oldalszám); a cikkek kb. 30%-ánál link a teljes szöveghez |
| Időkörök | 1800-tól napjainkig |
| Méret | Több mint 2,5 millió cikk, 1800 fölötti folyóirat (2026. 08.) |
Az eddigi keresőfelületek egy dolgot nem tudnak: a folyóiratszámok belsejébe nézni. A katalógus megmondja, hogy a Századok megvan a könyvtárban, de nem azt, hogy melyik évfolyamában van cikk a témájáról. Erre való a MATARKA.
1.1 Mi ez, és ki csinálja?
Definíció Fogalom: MATARKA
MAgyar folyóiratok TARtalomjegyzékeinek Kereshető Adatbázisa. 2002 óta működik, a Miskolci Egyetem Könyvtár, Levéltár, Múzeum fejleszti és üzemelteti. Túlnyomórészt Magyarországon megjelenő tudományos és szakmai folyóiratok tartalomjegyzékét teszi kereshetővé – bárki számára térítésmentesen.
A számok 2026 augusztusában: több mint 2,5 millió feldolgozott cikk, 1800 fölötti folyóirat, és a cikkek nagyjából 30%-ánál el is lehet jutni a teljes szöveghez.
Mélyebben Ki írja bele az adatokat?
Ez nem mellékes kérdés, mert megmagyarázza a gyűjtemény egyenetlenségeit. Az adatbázis háromféleképpen gyarapszik:
- Kézi bevitel, a lapszámok kézbevételével – ezt a MATARKA-t építő több mint 50 könyvtár munkatársai végzik. A könyvtárak maguk döntik el, mely folyóiratokat dolgozzák fel.
- Szerkesztőségek és önkéntesek küldik be a tartalomjegyzéket konvertálható formátumban.
- Gépi adatátvétel az Elektronikus Periodika Archívumból (EPA), az Akadémiai Kiadótól és folyóirat-honlapokról.
Az első pont a lényeg. A lefedettség nem központi döntés eredménye, hanem ötven könyvtár egyenkénti választásáé. Ebből következik, hogy egy folyóirat lehet évtizedekre visszamenőleg feldolgozva, egy másik csak néhány évfolyamig – és ez nem a folyóirat fontosságáról szól.
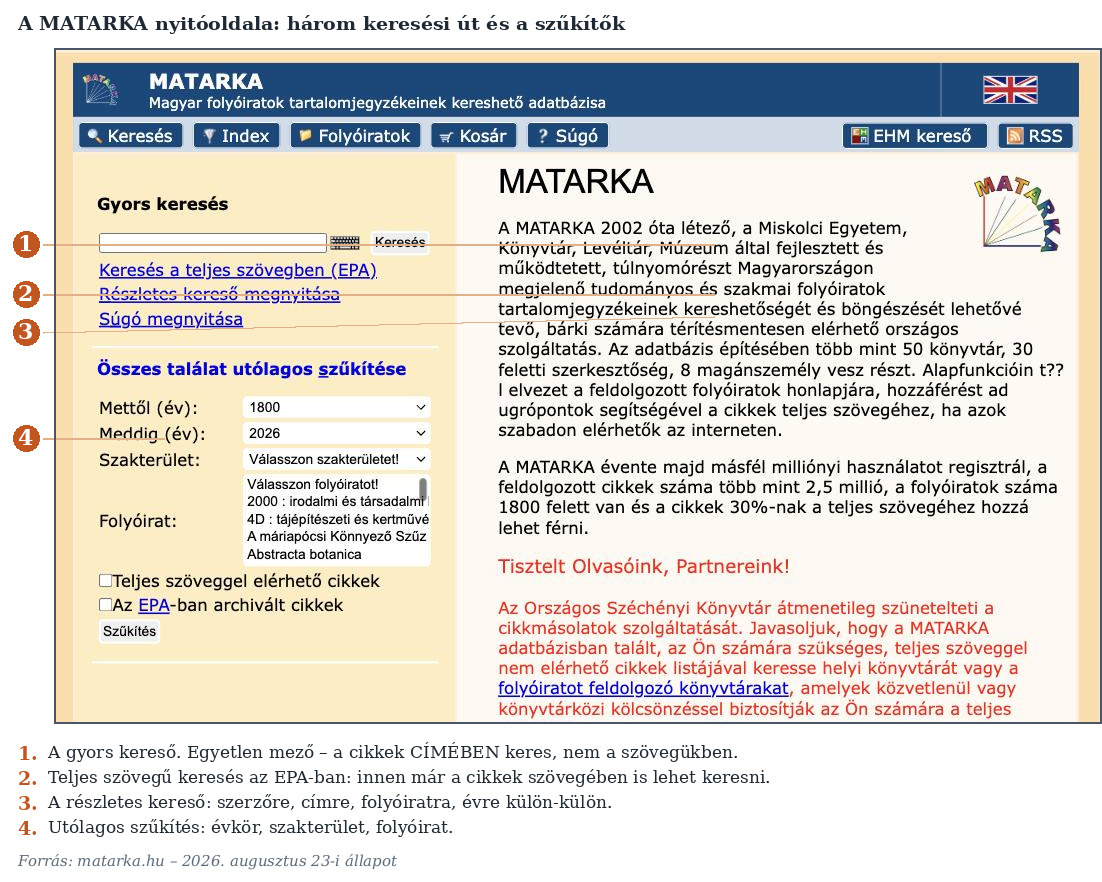
1.2 Mit indexel – és mit nem?
Ez az alfejezet legfontosabb kérdése, mert ebből következik minden más.
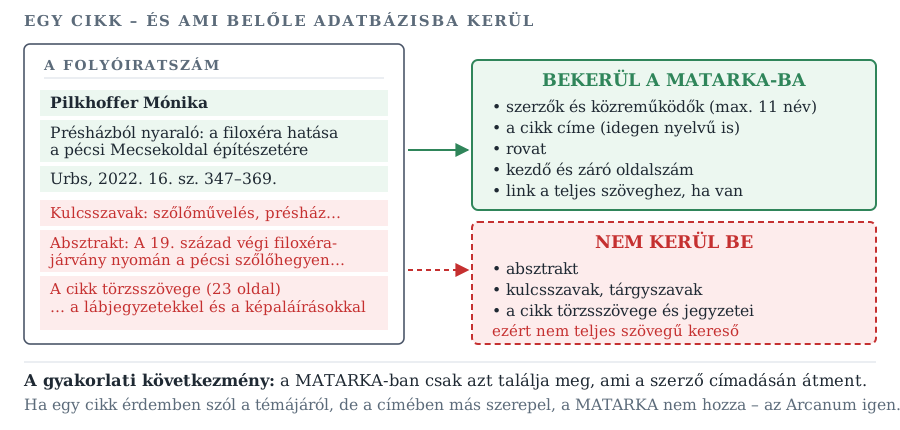
Figyelem A MATARKA nem teljes szövegű kereső. A tartalomjegyzéket dolgozza fel: szerzőt, címet, rovatot, oldalszámot – és semmi mást. Az absztrakt, a kulcsszavak és a cikk szövege nincs benne.
A gyakorlati következmény egy mondatban: ha egy cikk a témájáról szól, de a címében nem szerepel a keresőszava, a MATARKA felületén nem találja meg – az Arcanumon viszont igen. A kettő nem egymás alternatívája: a MATARKA a címadás emberi szűrésére épül, az Arcanum a teljes szövegre. Ilyenkor tehát az Arcanum Újságok teljes szövegű keresőjéhez érdemes fordulni – és fordítva is: ha az Arcanum sok ezer találatot ad, a MATARKA szűkebb listája mondja meg, mely írások szólnak tényleg a témáról.
1.3 A három szint
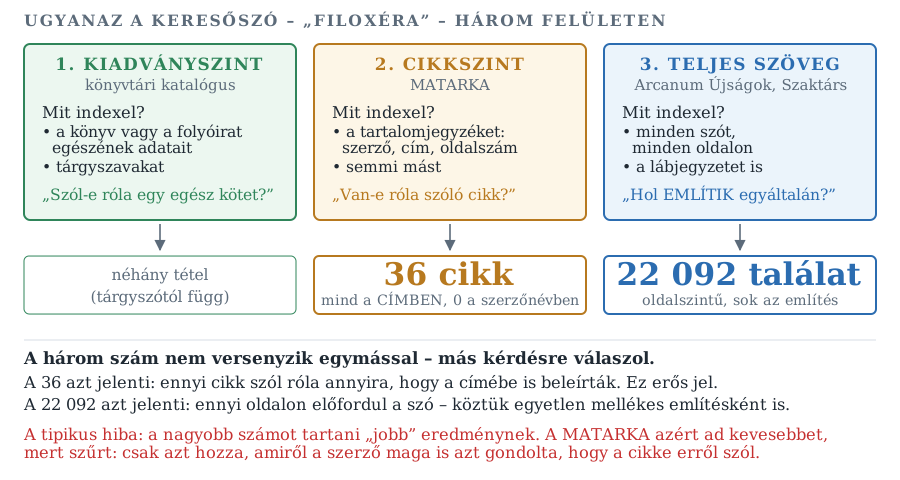
Esettanulmány Egy szó, három adatbázis
A filoxéra keresőszó 2026. augusztus 21-én a következőt
adta:
| Felület | Találat | Mit jelent? |
|---|---|---|
| MATARKA | 36 cikk | ennyi cikk címében szerepel a szó |
| Arcanum Újságok | 22 092 | ennyi oldalon előfordul a szó |
A MATARKA a találatokat rögtön szét is bontja aszerint, melyik mezőben van az egyezés – és ez a bontás önmagában tanulságos volt:
- szerzők nevében: 0 cikk
- cikkek címében: 36 cikk
A felület tehát maga mondja meg, mit indexel: szerzőt és címet. Semmi mást nem tudott volna felajánlani.
Miért nem a nagyobb szám a jobb? Mert a 22 092 túlnyomó része olyan oldal, ahol a filoxéra egyetlen mellékes említés – egy borászati hirdetés, egy megyegyűlési tudósítás féltmondata. A 36 viszont mind olyan írás, amelyről a szerző maga is azt gondolta, hogy erről szól, mert beleírta a címbe. A címbe kerülés egy emberi szűrés eredménye, és ez a MATARKA legnagyobb értéke.
Egy találat, amit érdemes megnézni. A 36 között ott van ez:
Pilkhoffer Mónika: Présházból nyaraló : a filoxéra hatása a pécsi Mecsekoldal építészetére. Urbs : magyar várostörténeti évkönyv, 2022. 16. sz. 347–369.
Ez a tétel jól mutatja, mire jó a cikkszintű keresés. Egy szőlészeti járvány és egy város építészettörténete – ezt az összefüggést tárgyszóra keresve aligha találná meg, mert egyik tárgyszó alá sem tartozik rendesen. A cím viszont mindkettőt tartalmazza, tehát a MATARKA megtalálja.
1.4 Egy találat felépítése
Egy MATARKA-tétel a következőket adja meg:
| Mező | Példa |
|---|---|
| Szerzők | Silling István |
| Cím | Adalék a bácskai szőlőkről és borokról a filoxéra előtti korból |
| Folyóirat, év, évfolyam, szám, oldal | Létünk, 2025. (5. évf.) 1. sz. 43–58. old. |
| Teljes szöveg | link, ha van – és annak megnevezése, hol van |
Tipp A „Teljes szöveg” sor megmondja, hol él a cikk: Elektronikus Periodika Archívum, Hungaricana, a folyóirat saját honlapja. Ez a MATARKA másik nagy haszna: nemcsak megtalálja a cikket, hanem elvezet hozzá.
Ha nincs link, a tétel akkor is teljes értékű bibliográfiai adat – ennyi kell ahhoz, hogy a cikket könyvtárban kikérje vagy könyvtárközi kölcsönzéssel megrendelje.
1.5 Szűkítés és böngészés
A találatok utólag szűkíthetők évkör (1800-tól napjainkig), szakterület (a Történelem önálló kategória) és konkrét folyóirat szerint. Két jelölővel tovább szűrhet: csak a teljes szöveggel elérhető cikkekre, illetve csak az EPA-ban archiváltakra.
A keresésen kívül két böngészési mód van: az Index (szerzők és címszavak betűrendes listája) és a Folyóiratok menüpont, ahol egy adott folyóirat lapszámait lehet végigjárni.
Tipp A folyóiratszám végigböngészése alulértékelt módszer. Ha talált egy releváns cikket, nyissa meg annak a lapszámnak a teljes tartalomjegyzékét. A tematikus számokban a szomszédos cikkek gyakran ugyanarról szólnak – ezeket egyetlen kereséssel sem találná meg, mert más szavakkal írták a címüket.
2. Google Scholar
A Google Scholar ingyenes keresőmotor, amely tudományos cikkek, tanulmányok, könyvek, konferencia-előadások és egyéb tudományos források között segít keresni. Regisztrált kutatók létrehozhatnak saját profilt, amelyen publikációikat megjeleníthetik, de az oldalon nem lehet közvetlenül dokumentumokat feltölteni vagy közvetlen kapcsolatot építeni más kutatókkal. Teljesen ingyenes, és széles körű, multidiszciplináris keresést tesz lehetővé.
A Google Scholar alkalmas:
- Hivatkozások keresésére. Minden cikkhez automatikusan generál egy Cite (idézet) gombot, amely különböző formátumokban (pl. APA, MLA, Chicago) adja meg a megfelelő hivatkozást. Ez gyorsítja a dolgozatok forrásainak kezelését.
- Az idézetek számának megjelenítésére. Megmutatja, hogy egy adott cikket hányszor idéztek más kutatók, ami segíthet megítélni egy cikk tudományos jelentőségét.
- Értesítések küldésére. Beállíthatunk értesítéseket kulcsszavakra, szerzőkre vagy konkrét cikkekre, így értesítést kapunk, ha új publikációk jelennek meg a témában.
- Elérhető verziók követésére. Ha egy fizetős folyóiratban megjelenő cikkre kattintunk, a Google Scholar gyakran kínál All versions lehetőséget, ahol megtalálhatjuk az ingyenesen elérhető változatokat is (pl. preprint vagy egyetemi repozitóriumokban őrzött verzió).
- Saját profil létrehozására. Ennek segítségével automatikusan követhető, hogy hányan idézik a saját munkánkat.
Tipp Az All versions (Minden változat) link a Google Scholar egyik legértékesebb, de legkevésbé ismert funkciója. Ha egy cikk a kiadói oldalon fizetős, gyakran ugyanaz a szöveg szabadon elérhető egy egyetemi repozitóriumban – ezt a linket itt találja meg.
Figyelem A Google Scholar által generált hivatkozás nem felel meg automatikusan a magyar történeti folyóiratok által alkalmazott hivatkozási rendszereknek, és gyakran hibás: az ékezetes karakterek sérülhetnek, a szerzők vezeték- és keresztneve felcserélődhet, a magyar folyóiratadatok hiányosak lehetnek. A generált hivatkozást mindig ellenőrizze és javítsa.
3. JSTOR
A JSTOR az ITHAKA nevű non-profit szervezet által létrehozott és fenntartott archívum, amely tudományos folyóiratokhoz (kisebb részben könyvekhez és forrásanyagokhoz) kínál széles körű hozzáférést. Számos tudományterületre kiterjed, tehát multidiszciplináris adatbázisról beszélhetünk. Retrospektív, azaz a tartalmak némi késéssel kerülnek fel az adatbázisba: a folyóiratok legfrissebb 2–5 évfolyama nem érhető el benne.
A JSTOR-on lévő dokumentumok közötti kereséshez nem szükséges regisztráció, a szövegek tényleges eléréséhez ugyanakkor regisztrálni, illetve belépni kell az oldalra. Ez az ELTE beiratkozott hallgatói számára a Log in through your institution lehetőségen keresztül lehetséges, de az oldal felajánlja, hogy akár az egyetemi e-mail-címével saját profilt is létrehozzon.
A keresőfelület a Google keresőjéhez hasonló, de az egyszerű keresőszavas keresés mellett összetett keresésre is lehetőség van. Kiválasztható, hogy milyen szövegtípusban keressen a rendszer (Item Type). Ötféle lehetőség van: Articles (szakcikkek), Reviews (recenziók), Books (könyvek), Research Reports (kutatási jelentések) és Miscellaneous (egyéb, pl. közlemények, szerkesztői levelek).
Figyelem A JSTOR alapbeállítása félrevezető lehet. Az adatbázis alapértelmezetten csak abban a részlegben keres, amelyet a felhasználó intézménye biztosít (Content I can access). Az intézmények ugyanis évente fizetnek elő a nyilvánosan elérhető adatbázisokra, és a JSTOR esetében is előfizetői csomagokról beszélhetünk (alapgyűjtemény és kiegészítő csomagok).
Az All Content beállítással (Select an access type → All content) a teljes adatbázisban kereshetünk, ugyanakkor csak azokhoz a tételekhez lesz korlátlan hozzáférésünk (pl. teljes letöltés valamely fájlformátumban), amelyekre az intézményének előfizetése van.
Ha tehát „nincs találat”, először ellenőrizze, hogy nem a hozzáférési szűrő korlátoz-e.
Az adatbázis használatához angol nyelvű videós segítség érhető el: https://guides.jstor.org/c.php?g=1227490&p=9885780
Tipp A katalógus nem minden. Az eddigiek metaadatra keresnek: címre, szerzőre, tárgyszóra. Van azonban két olyan magyar felület, amely a könyvek és a folyóiratok teljes szövegében keres, és ezért egészen más találatokat ad: a Szaktárs és az Arcanum Újságok. Érdemes mindkettőt használni – a kettő nem helyettesíti, hanem kiegészíti egymást.
4. Hivatkozáskezelés
A források áttekinthetősége és a tudományos hivatkozások pontos megadása elengedhetetlen egy jól strukturált történeti munka elkészítéséhez. A hivatkozáskezelő szoftverek segítenek a bibliográfiák létrehozásában és az idézések rendszerezésében. Népszerű eszközök:
- Zotero – ingyenes és könnyen használható, böngészőbe integrálható hivatkozáskezelő;
- Mendeley – tudományos közösségi platformmal egybekötött referencia-menedzser;
- EndNote – professzionális kutatóknak szánt eszköz.
A kurzus keretében a Zoteróval ismerkedünk meg részletesen – lásd a Zotero fejezetet.
Gyakorlás: melyik felületen keresne?
Az eddig megismert felületek nem versenytársak: más-más részletességi szinten dolgoznak. Nyolc kutatási helyzet – döntse el mindegyikről, hol kezdene.
Feladat Melyik felületen keresne?
Döntse el minden helyzetről, hol kezdene: könyvtári katalógus, MATARKA, teljes szövegű kereső (Arcanum, Szaktárs) vagy nemzetközi adatbázis. Indokolja egy mondatban.
| # | A kutatási helyzet |
|---|---|
| 1 | Tudni szeretné, van-e a könyvtárban a kezében lévő hivatkozás szerinti kötet. |
| 2 | Egy szűk témáról szeretné tudni, írtak-e róla magyar folyóiratcikket az elmúlt húsz évben. |
| 3 | Egy 1875-ös újságcikkre lenne szüksége egy helyi eseményről. |
| 4 | Van egy szerzőneve, és szeretné tudni, mit publikált magyar folyóiratokban. |
| 5 | Egy monográfia 214. oldalán említett adatra emlékszik, de nem tudja, melyik könyvben olvasta. |
| 6 | Meg szeretné nézni, mi jelent meg egy folyóirat adott tematikus számában. |
| 7 | Egy tanulmány érdemben szól a témájáról, de a címében más szerepel. |
| 8 | Külföldi szerző angol nyelvű tanulmányát keresi nemzetközi folyóiratban. |
Esettanulmány
Esettanulmány Ugyanaz a kérdés, négy felület, négy szám
Egy hallgató témája a 19. század végi filoxéravész. Nézzük meg, mit mond ugyanarra a szóra a négy felület – a számok 2026. augusztus 21–22-i próbakeresésekből valók.
| Felület | Találat | Mit jelent? |
|---|---|---|
| MATARKA | 36 cikk | ennyi cikk címében szerepel a szó |
| Arcanum Újságok | 22 092 | ennyi oldalon fordul elő |
| Széchényi Híd (tárgyszó) | – | ennyi tételről mondta ki egy katalogizáló, hogy erről szól |
| Google Scholar | – | nemzetközi kitekintés, idézettséggel |
A négy szám nem versenyzik. A 36 azt jelenti, hogy ennyi cikk szól róla annyira, hogy a szerző a címébe is beleírta – ez erős jel. A 22 092 azt, hogy ennyi oldalon előfordul a szó, köztük egyetlen mellékes említésként is.
A tipikus hallgatói hiba a nagyobb számot tartani jobb eredménynek. Pedig a MATARKA azért ad kevesebbet, mert szűrt: emberi címadáson ment át.
A gyakorlati sorrend. Kezdje a cikkszintű indexszel, mert az adja a legsűrűbb, legrelevánsabb halmazt. Ha kevés jön, menjen a teljes szövegűre – de akkor számoljon azzal, hogy a találatok nagy részét el kell dobnia. A nemzetközi felületeket akkor nyissa meg, ha a téma túlmutat a magyar szakirodalmon.
(A táblázat két sorát a záró gyakorlatban Ön tölti ki.)
Gyakorlati feladatok
Feladat 1. feladat – Folyóiratok
Különböző történettudományi folyóiratok internetes oldalán nézzen utána az alábbiaknak:
Mely évben jelent meg a Századok 156. évfolyamának 5. száma?
Ebben a számban milyen nagyobb egységekbe rendezve találhatók az írások?
Mely évben jelent meg az Aetas folyóirat 32. évfolyama?
Ezen évfolyam 3. számának mi volt a fő témája?
Ebben a számban milyen négy nagy tematikus blokkban jelentek meg az írások?
Mi volt a témája a Korall folyóirat 63. számának, és mely évben jelent meg?
Ki írt ebben a számban könyvismertetést Simon Attila egy könyvéről, és melyik volt ez a könyv (pontos bibliográfiai adatokkal)?
Feladat 2. feladat – Négy felület, négy szám (30 perc)
Válasszon egy keresőszót a saját témájából, és futtassa le a MATARKA, az Arcanum Újságok, a Széchényi Híd tárgyszó mezője és a Google Scholar felületén.
- Jegyezze fel mind a négy találatszámot.
- Írja le egy-egy mondatban, mit mér az adott szám.
- Melyik halmazból indulna el, és miért? Melyiket hagyná utolsónak?
Feladat 3. feladat – A vakfolt (20 perc)
Keressen a MATARKA-ban egy Önt érdeklő témára, majd ugyanerre a témára az Arcanum Újságok teljes szövegű keresésével.
- Talált-e olyan tanulmányt a teljes szövegű keresésben, amelyet a MATARKA nem hozott?
- Ha igen, nézze meg a címét: miért maradt ki? (Nem szerepel benne a keresőszó? Más szóval írták körül?)
- Mit tanult ebből arról, hogy mikor nem elég a cikkszintű index?
Önellenőrző kérdések
1. Mit indexel a MATARKA, és mit nem?
Válasz megjelenítése
A folyóiratok tartalomjegyzékét dolgozza fel: szerzőt, címet, rovatot, oldalszámot. Az absztrakt, a kulcsszavak és a cikk szövege nincs benne. Ezért csak azt találja meg, ami a szerző címadásán átment.
2. Mi a JSTOR alapbeállításának buktatója?
Válasz megjelenítése
Alapértelmezetten csak az intézményi előfizetés által lefedett tartalomban keres (Content I can access). Az All Content beállítással szélesebb körben kereshetünk, de teljes hozzáférésünk továbbra is csak az előfizetett tételekhez lesz.
3. Miért érdemes megnézni a Google Scholar All versions linkjét?
Válasz megjelenítése
Mert egy fizetős kiadói változat mellett gyakran létezik szabadon elérhető verzió is (preprint vagy repozitóriumi példány), amit ez a link mutat meg.
4. Igaz-e, hogy a Google Scholarban csak bibliográfiai hivatkozásokat lehet találni, a tanulmányok szövegéhez innen nem lehet eljutni?
Válasz megjelenítése
Nem igaz. A találatokból sok esetben közvetlenül eljutunk a teljes szöveghez, különösen az All versions linken keresztül elérhető repozitóriumi példányokhoz.
5. Melyik keresőfelületen található meg egyszerre több magyar könyvtár állománya?
Válasz megjelenítése
A MOKKA (Magyar Országos Közös Katalógus) felületén.
Összefoglalás
A cikkszintű keresés azt tudja, amit a katalógus nem: belelát a folyóiratszámba. A MATARKA a magyar folyóiratok tartalomjegyzékét teszi kereshetővé – szerzőt, címet, oldalszámot, semmi mást. Ez egyszerre az erőssége és a korlátja: amit talál, azt egy emberi címadás hitelesíti; amit nem talál, az lehet, hogy csak más szóval szerepel a címben.
A Google Scholar a nemzetközi kitekintést és az idézettségi kontextust adja, a JSTOR az előfizetett nemzetközi folyóiratanyagot – utóbbinál érdemes figyelni az alapbeállításra, mert alapértelmezetten csak a hozzáférhető tartalomban keres.
A vezérfonal, amelyet érdemes megjegyezni: a katalógus a kötetet ismeri, a MATARKA a cikk címét, a teljes szövegű kereső minden szót.
Kulcsfogalmak
cikkszintű index – Olyan adatbázis, amely nem a kiadvány egészét, hanem az egyes cikkeket írja le; a MATARKA a folyóiratok tartalomjegyzékéből építi.
MATARKA – Magyar folyóiratok tartalomjegyzékeinek kereshető adatbázisa; a Miskolci Egyetem Könyvtár, Levéltár, Múzeum üzemelteti, ingyenes.
tudományos keresőmotor – Olyan kereső, amely tudományos publikációk között keres, és rendszerint idézettségi adatokat is közöl (például Google Scholar).
idézettség – Annak mérőszáma, hányszor hivatkoztak egy műre; a téma feltárásában a hivatkozó munkák gyakran fontosabbak, mint a kiindulási mű.
intézményi hozzáférés – Az egyetem előfizetése révén elérhető tartalom; belépés nélkül ugyanaz a felület mást mutat.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- MATARKA – Magyar folyóiratok tartalomjegyzékeinek kereshető adatbázisa: a szolgáltatás saját ismertetője és keresési súgója. https://matarka.hu/ (elérve: 2026. 08. 21.)
- Google Scholar. https://scholar.google.com/ (elérve: 2026. 08. 21.)
- JSTOR. https://www.jstor.org/ (elérve: 2026. 08. 21.)
Linkek és eszközök
| Név | URL | Mire jó? |
|---|---|---|
| MATARKA | https://matarka.hu/ | magyar folyóiratcikkek cikkszintű keresése |
| HUMANUS | https://humanus.oszk.hu/ | humán tudományi cikkbibliográfia, könyvfejezetekkel |
| Google Scholar | https://scholar.google.hu/ | nemzetközi tudományos keresés, idézettség |
| JSTOR | https://www.jstor.org/ | előfizetett nemzetközi folyóiratanyag |
| EBSCO | https://www.ebsco.com/ | nemzetközi adatbázis-szolgáltató |
| ProQuest | https://www.proquest.com/ | nemzetközi adatbázis-szolgáltató |
Magyar Tudományos Művek Tára (MTMT)
| Szerző(k) | Selmeczi Péter |
| Becsült feldolgozási idő | 45 perc |
| Előfeltétel | Szakirodalomkeresés |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszköz alapadatai
| Eszköz neve | Magyar Tudományos Művek Tára (MTMT) |
| URL | https://mtmt.hu/ |
| Üzemeltető | Magyar Tudományos Akadémia Könyvtár és Információs Központ (MTA KIK) |
| Hozzáférés | Ingyenes. Az adatbázisban szereplő rekordok kereséséhez, táblázatos összefoglalók eléréséhez regisztráció nem szükséges. |
| Regisztráció | Csak a kutatói felhasználói felület eléréséhez, új adatok beviteléhez szükséges. |
| Tartalomtípus | Szakirodalmi és tudományos ismeretterjesztő művek leíró adatai; szerzőik azonosító-, idézettségi és publikációs adatai |
| Időkörök | Kb. a 20. század második felétől napjainkig |
Miről szól ez a fejezet?
Ebben a fejezetben a Magyar Tudományos Művek Tára (MTMT) nevű online bibliográfiai adatbázisról lesz szó. Bemutatjuk, milyen funkciókkal rendelkezik, és hogy mennyiben segíti egy kutatói életpálya állomásainak és termékeinek nyilvántartását, illetve karbantartását.
Az MTMT nem önmagában áll: a szerzői és a dokumentumazonosítókkal együtt alkot rendszert. Ennek áttekintése az ORCID és DOI fejezet 1. ábráján található.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- önállóan futtasson egyszerű és részletes kereséseket az MTMT-ben;
- önállóan elérje az adott tudományos művek leíró adatait;
- önállóan kezelje a kapott bibliográfiai listákat, és ezeket különböző formákban lementse és exportálja;
- önállóan elérje a kiválasztott szerző publikációs tevékenységéhez tartozó összefoglalókat (táblázat, diagram);
- önállóan bibliográfiát hozzon létre egy szabadon választott kutatási témához, az adatbázis rekordjai alapján.
Bevezetés
Akár egy szemináriumi dolgozathoz, akár egy rövidebb, szóbeli prezentáció elkészítéséhez érdemes előzetesen körbejárnunk, hogy az adott témának milyen elérhető forrásai, szakirodalma van. Régen gyakran elég volt ehhez besétálni a legközelebbi könyvtárba, végigpillantva a polcokon sorakozó könyveken – ma azonban, ahogyan folyamatosak az új tudományos eredmények, a tájékozódás is egyre nehezebb a gyarapodó tudásanyagban. Így szükségszerű a vonatkozó munkák szabványosított nyilvántartása (katalógusok), listázása (bibliográfiák), kereshetővé és széles körben elérhetővé tétele (modern adatbázisok, online repozitóriumok) – ezekről a korábbi fejezetekben bővebben is volt már szó.
A tudományos műveket leíró és elérhetővé tevő adatbázisok tematikailag, területi (nemzetközi vagy egy adott ország tudományos műveire fókuszáló) és nyelvi szempontokból is kategorizálhatók. Az itt bemutatásra kerülő MTMT kifejezetten a Magyarországon megjelenő tudományos művekre fókuszál, így ha egy-egy téma magyar szakirodalmát szeretnénk összegyűjteni, fontos kiindulópontként szolgálhat – érdemes hát megismerni.
1. Mi az MTMT?
A Magyar Tudományos Művek Tára (MTMT) a hazai tudományos közleményeket és idézéseiket nyilvántartó bibliográfiai adatbázis (https://mtmt.hu/). 2009-ben hozták létre; az ELTE 2010-ben az elsők között, alapító intézményként csatlakozott hozzá. Az adatbázisban minden magyar kutatónak kötelessége rögzíteni tudományos publikációinak bibliográfiai adatait a Magyar Tudományos Akadémiáról szóló 1994. évi XL. törvény 19/A. §-a szerint.
Az MTMT fő célja a hazai tudományos publikációk és idézetek hiteles, országos és teljes körű gyűjteményének, valamint nemzeti bibliográfiai adatbázisának létrehozása és fenntartása, hogy hiteles információt szolgáltasson az egyéni és intézményi tudományos teljesítményről.
A kutatók és oktatók számára az MTMT-ben való regisztráció számos előnnyel jár, mivel egy országosan egységes rendszerről beszélhetünk, amely alkalmas személyes tudományos bibliográfia építésére és karbantartására; segíti pályázatok, tudományos jelentések elkészítését és értékelését (a legtöbb tudományos pályázathoz elvárás is a kutató MTMT-elérésének csatolása); a publikációs lista és az értékelő táblázatok pedig nyilvánosan és szabadon elérhetők. Lehetőség van a szerző publikációs listájára mutató link másolására más oldalakra; de tudománymetriai szempontból talán a legfontosabb az, hogy az MTMT révén a kutató egységes formában tudja nyilvántartani munkáinak idézettségét, az adatok pedig széles körben ismert import-export formátumokban őrződnek.
Az MTMT működésének intézményi és jogi hátteréről, az adatbázisban szereplő adatok ellenőrzéséről, hitelességéről és az adatszolgáltatás felelősségéről bővebben az MTMT bemutatkozó oldalán olvashat.
Definíció Fogalom: bibliográfia
Egy adott témához köthető szakszerű irodalomjegyzék.
Definíció Fogalom: online repozitórium
Olyan digitális archívum, amely tudományos publikációkat, kutatási anyagokat és forrásokat tesz szabadon vagy korlátozott hozzáféréssel elérhetővé. Lehet egyetemi adatbázis, nemzeti könyvtári gyűjtemény vagy tematikus történeti repozitórium.
Definíció Fogalom: tudománymetria
A tudománymetria kvantitatív módszerek segítségével méri és elemzi a kutatók, tudományos intézmények és tudományos kiadványok tevékenységét. Célja, hogy a tudományos teljesítményt objektív mutatókkal (például publikációk és hivatkozások számával) jellemezze, amelyek jelzik egy kutató vagy kutatócsoport hatását a kutatói közösség számára.
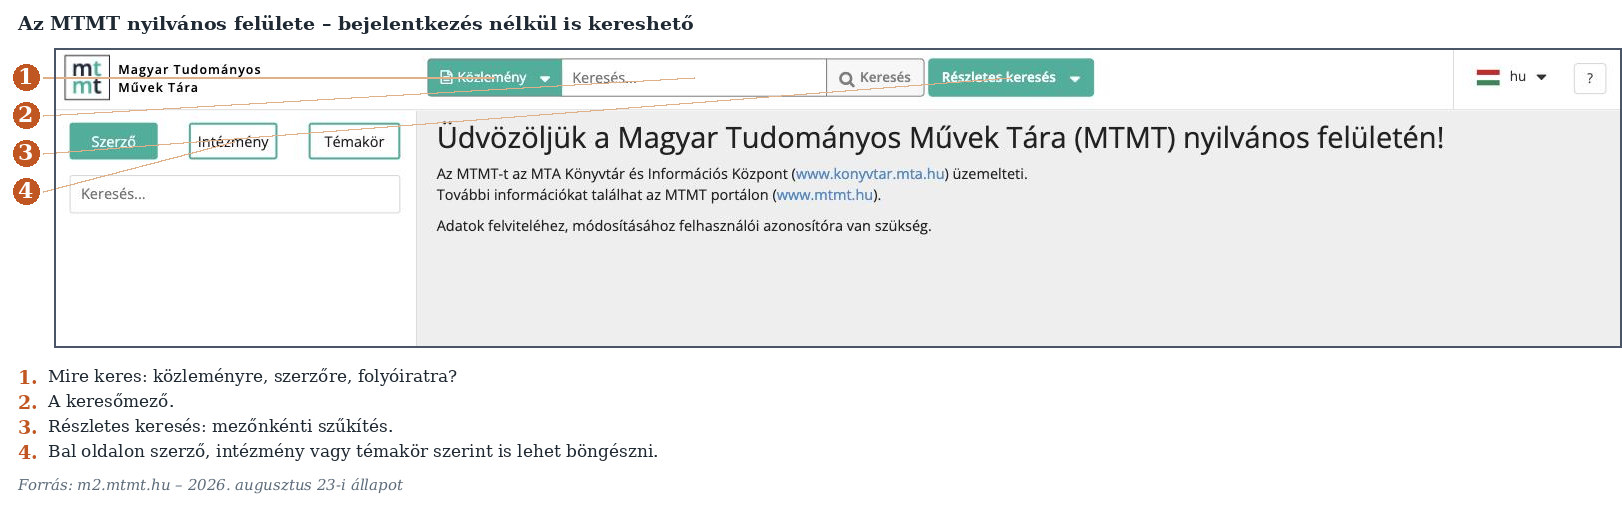
2. A felület felépítése
Az MTMT oldala bárki számára elérhető, azonban mivel több funkcióval is rendelkezik, ezen funkciók felhasználói köre egyes esetekben korlátozott. Az adatbázis állományában bárki szabadon kereshet, azonban újabb rekordokat csak regisztrált felhasználók adhatnak hozzá az online gyűjteményhez. Jelen fejezetben ez utóbbival nem foglalkozunk: kizárólag azt tekintjük át, hogyan lehet keresni az adatbázisban, és a kiadott találatokkal mit kezdhetünk a későbbiekben (importálási lehetőségek).
A nyitóoldalon találjuk a különböző funkciókra mutató gombokat, az aktuális híreket, illetve az oldal üzemeltetéséhez kapcsolódó, különböző címszavak alatt futó linkeket (lásd az MTMT logó melletti, legfelső sávot).
Nekünk most a Nyilvános keresőfelületre (https://m2.mtmt.hu/gui2/) lesz szükségünk, erre kattintsunk rá.
3. Keresés és böngészés
A nyilvános keresőfelületre jutva a bal oldalon és fent is egy keresősávot láthatunk, ahol beállíthatjuk, hogy pontosan milyen adatra szeretnénk rákeresni: szerző, intézmény, témakör; a fenti sávban pedig akár közleményre (annak címére) is.
3.1 Egyszerű keresés
Ha a felső sávban a Közleményeket állítjuk be keresési feltételként, akkor a beírt keresőkifejezésre olyan listát fogunk kapni, amely minden olyan tételt tartalmaz, amelynek valamelyik adatmezejében (szerző, cím stb.) az adott kifejezés szerepel. Például ha a „Selmeczi György” kifejezésre keresünk így rá, akkor a találatok között lesznek olyanok, amelyeknek az egyik szerzőjét hívják így, míg más találatoknál a cím mezőben szerepel ez a kifejezés (például a zeneszerző Selmeczi György által írt egyik darabot valaki előadta, és mint művészeti-tudományos produktumot felvitte az adatbázisba a saját nevével).
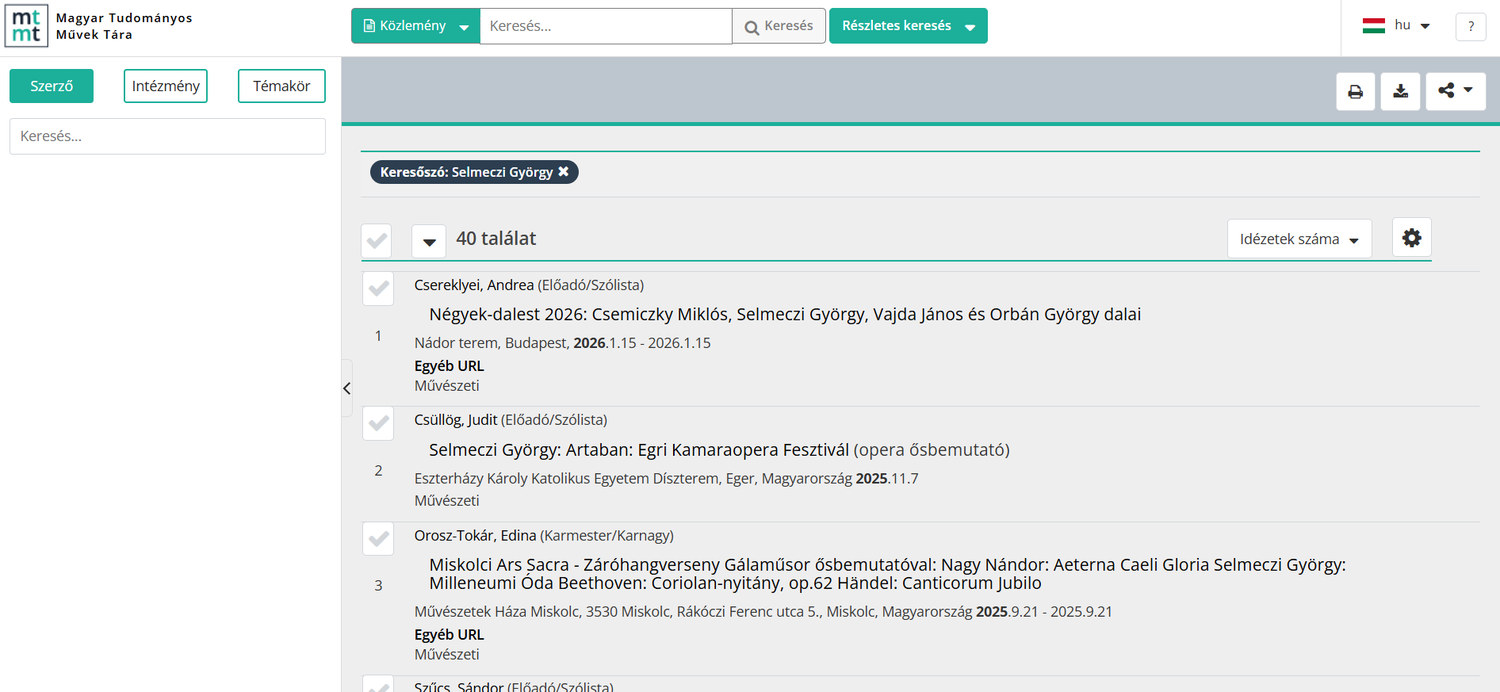
Ha kifejezetten valakinek a műveire vagyunk kíváncsiak, akkor beállíthatjuk, hogy Szerzőre keressünk. Ha beírjuk, hogy „Fazekas István”, akkor az oldal nem műveket listáz ki automatikusan, hanem azokat a szerzői rekordokat, amelyekben a „Fazekas” és az „István” kifejezés szerepel. A különböző szerzőknél zárójelben fel vannak tüntetve azok a tudományterületek, tudományágak, amelyekben publikálnak. Ez az egyes hasonló vagy azonos nevű névalakok megkülönböztetését célozza. Hasonlóan működik a másik két kereséstípus, az Intézmény (intézményhez rendelt publikációk) és a Témakör (témakörökhöz rendelt publikációk) is.
Tipp Az MTMT-ben a korábban tanult, kereséseknél gyakran használható vezérlőjelek vagy vezérlőkarakterek – mint az idézőjel („ ”), a kérdőjel (?) és a csillag (*) – nem használhatók.
3.2 Szűrők és összetett keresés
Lehetőség van részletes keresésre is az adatbázisban, amelyhez a fenti részletes keresősablon használható. Itt több paraméter állítható be, többek között a dokumentum típusa, besorolása (műfaja) és a megjelenés éve. Ez mind lehetőséget ad arra, hogy különböző paraméterek szerint szűkített találati listát kapjunk az MTMT-be feltöltött publikációkból.
Például ha arra vagyunk kíváncsiak, hogy a trianoni békeszerződés centenáriumi évétől (2020) kezdve milyen, kifejezetten tudományos munkák jelentek meg a témában, amelyeknek Ablonczy Balázs a szerzője, akkor érdemes bizonyos szűkítőket beállítanunk. A Részletes keresésre kattintva, a lenyílt keresőablakban állítsuk be a Típusnál az „összes típust”, a Jellegnél a „tudományost”, a Keresőszó mezőbe a „Trianon” kifejezést, a Szerző mezőbe az „Ablonczy Balázs” nevet, majd állítsuk be, hogy a Kezdő év a 2020 legyen; a Záró év mezőt hagyjuk üresen.
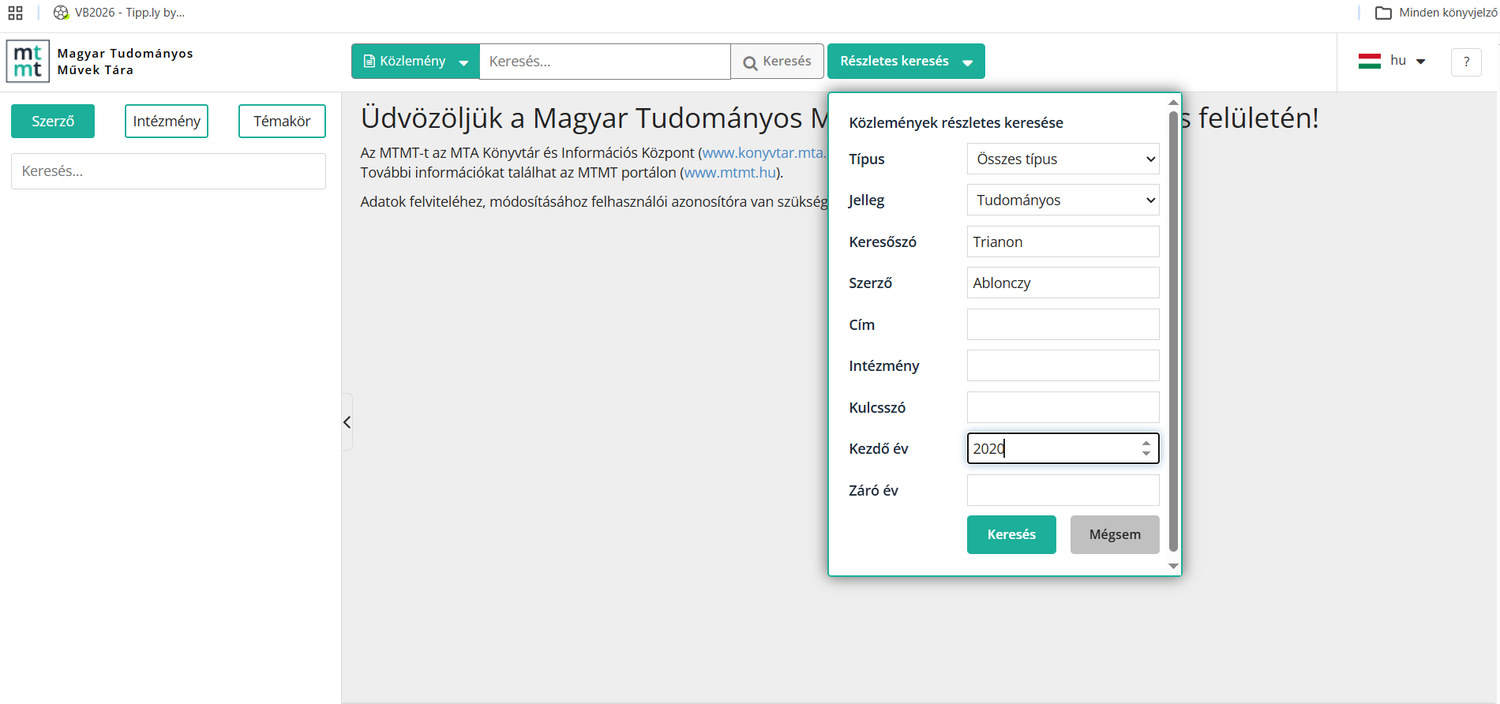
Így megkapjuk, hogy hány olyan kiadvány jelent meg 2020-tól napjainkig, amelynek egyik szerzője Ablonczy Balázs, és valamely mezőjében tartalmazza a „Trianon” kifejezést.
Tipp Bármilyen adatbázisban, bármilyen témában is keresünk, mindig futtassuk le a kereséseinket több keresőkifejezéssel is, több szó- és szövegvariánssal, különböző szűrők beállításával. Ezáltal is növelhetjük az esélyeinket, hogy minél több használható találatot kapjunk.
Jelen esetben például a „Trianon” címszóra kerestünk rá, így azokat a találatokat kaptuk, amelyek valamelyik adatmezejében szerepel ez a szó – de magával a történelmi eseménnyel kapcsolatban olyan találatok is relevánsak lehetnek, amelyek (akár a címükben) expliciten a békeszerződésre és annak helyszínére nem utalnak. Hasznos lehet az MTMT részletes keresőfunkciójában a Kulcsszó mező is, amellyel azokat a találatokat is megkapjuk, ahol az adott tételnél a „Trianon” szó lett megadva kulcskifejezésként.
4. A találatok kezelése
4.1 A találatok további szűrése és sorrendjének beállítása
A találatokat tartalmazó listát tovább pontosíthatjuk, illetve a találatokat rendezhetjük. Erre szolgál például a fogaskerék ikon, amellyel egy további szűrőablakhoz juthatunk el. Itt lehetőségünk van a kapott találatokat további szempontok (például dokumentumtípus) szerint pontosítani; de a találatok sorrendjét is beállíthatjuk a megjelenés éve szerint növekvővé vagy csökkenővé, vagy akár aszerint, hogy előrébb legyenek azok a művek, amelyeknek Ablonczy az egyedüli szerzője (értsd: nem társszerzőként jegyzi).
Ha beállítjuk például, hogy a „Nyilvános idézők összesen” legyen a rendezési feltétel, csökkenő sorrenddel, akkor megkapjuk, hogy Ablonczynak eddig az Ismeretlen Trianon című könyve a legtöbbet idézett munkája a témából. (Ez is releváns szempont lehet, ha fel akarjuk tárni, mely munkák tekinthetők az adott téma fontosabb vagy éppen átfogó irodalmának.)
4.2 A találatok részletességének beállítása
Visszatérve a listára, beállíthatjuk, hogy a kapott találatoknak mennyire legyen részletes a leírása, és az alapadatokon felül mennyire kapjunk képet a mű idézettségéről. Az Idézések megjelenítési módjainál például beállíthatjuk, hogy az egyes tételek leírása milyen részletes legyen; megjelenjenek-e azok a rekordok is, amelyek az adott publikációt idézik, és ha igen, milyen részletes adatsorral.
Ha például a Röviden opciót választjuk, és megnézzük Ablonczy Balázs Ismeretlen Trianon című könyvének rekordját, akkor láthatjuk, hogy hányan idézték különböző paramétereknek megfelelően a munkáját saját tudományos publikációikban, és ezek megjelennek a vonatkozó MTMT-linkkel a tételnél.
A Teljes nézetnél ugyanakkor már azt is láthatjuk, hogy az adott publikációban Ablonczy művére hányadik oldalon, hányadik lábjegyzetben hivatkoztak, illetve hogy Ablonczy művének melyik részére (egészére, adott fejezetére, konkrét oldalszámra stb.) hivatkozott a szerző.
4.3 A találatok exportálási lehetőségei
Kaptunk tehát egy listát, amelyet többféleképpen rendezhetünk és szűrhetünk tovább – de mit tudunk ezzel kezdeni? Egyfelől, ha a szürke sávon lévő nyomtató ikonra kattintunk, akkor lehetőségünk van arra, hogy a listát kinyomtassuk (illetve nyomtatási nézetben lássuk), vagy elmentsük PDF formátumban.
Másfelől lehetőségünk van arra, hogy más formátumban mentsük el, vagy tegyük olvashatóvá-kezelhetővé az adott listát. Erre szolgál a nyomtató ikontól jobbra látható Importálás gomb. Ez egy olyan oldalra visz minket, ahol láthatjuk a találatokat, és kiválaszthatunk különböző megjelenési opciókat. (Itt már nem folytathatunk le kereséseket, csak a meglévő listát szűrhetjük, rendezhetjük, megjelenését állíthatjuk be.)
Itt megváltoztathatjuk a megjelenítés módját, így például az alap HTML helyett lehet XML vagy akár JSON is. Ezek azért lehetnek fontosak, mert más platformok eltérő kódolású adattömeget tudnak kezelni, vagy kezelésére vannak optimalizálva.
A listát exportálni is tudjuk több formátumban, de talán a legkézenfekvőbb irodalomjegyzékként, amire az MTMT lehetőséget biztosít. A Lista exportálása lehetőségnél válasszuk ki az irodalomjegyzéket, amelyre rákattintva lehetőségünk van, hogy néhány nemzetközileg használt stílus (pl. APA, Chicago, Harvard) valamelyikébe tegyük a listánkban szereplő műveket. (Fontos, hogy az idézettségi mutatókat ez figyelmen kívül hagyja, hiszen egy szakirodalom végén lévő bibliográfiába sem kerülnek bele; nem képezik a szabványos könyvészeti leírás részét.) Ezt is nyomtathatjuk, elmenthetjük PDF-ként, vagy egyszerűen másolhatjuk.
Figyelem Az MTMT által exportált irodalomjegyzék nemzetközi stílusokat (APA, Chicago, Harvard) kínál. A magyar történettudományi dolgozatokban használt hivatkozási rend ezektől eltér. Az exportált listát tehát kiindulópontnak használja, de a végleges irodalomjegyzéket a szakdolgozati vagy folyóirati előírás szerint alakítsa át.
5. Szerzői adatlapok és táblázatok
Az MTMT-ben nemcsak szakirodalmi listákat tudunk megtekinteni, hanem egyes szerzők és intézmények publikációs adatait is. Hogy ezt lássuk, az MTMT-ben egyszerű kereséssel írjuk be Juhász Balázs nevét mint személyt, és válasszuk ki a találatok közül a történészt.
A nevére kattintva megkapjuk azt a listát, amelyben a publikációit láthatjuk. De a Listák fül mellett van két másik is, amely funkciókkal bír. Az egyik az Adatlap: erre kattintva összefoglaló adatokat láthatunk Juhász Balázs tevékenységéről – a különböző intézményi affiliációit, a rá vonatkozó nemzetközi azonosítókat, illetve diagramokat arról, hogy az évek során hogyan oszlott meg a munkássága és a műveinek idézettsége.
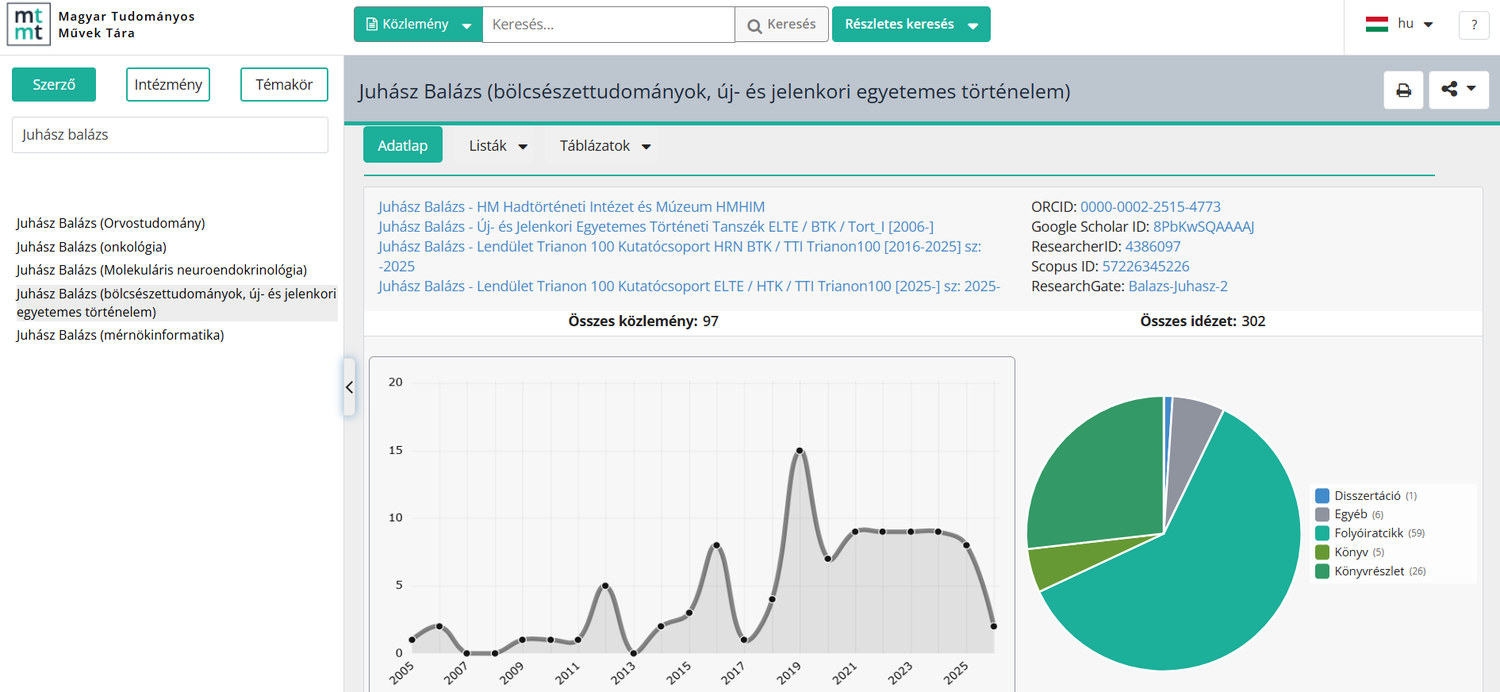
A Táblázatok menüpontra kattintva kétféle táblázatot érhetünk el. Az Általános összefoglaló táblázatot automatikusan generálja a rendszer a szerző publikációs listája alapján; itt a különböző publikációk típusok szerint listázódnak, feltüntetve a darabszámokat és az idézetek számát. Ennek párja a Szakterületi táblázat, amely az MTA vonatkozó tudományos bizottságának értékelési szempontjait is figyelembe veszi.
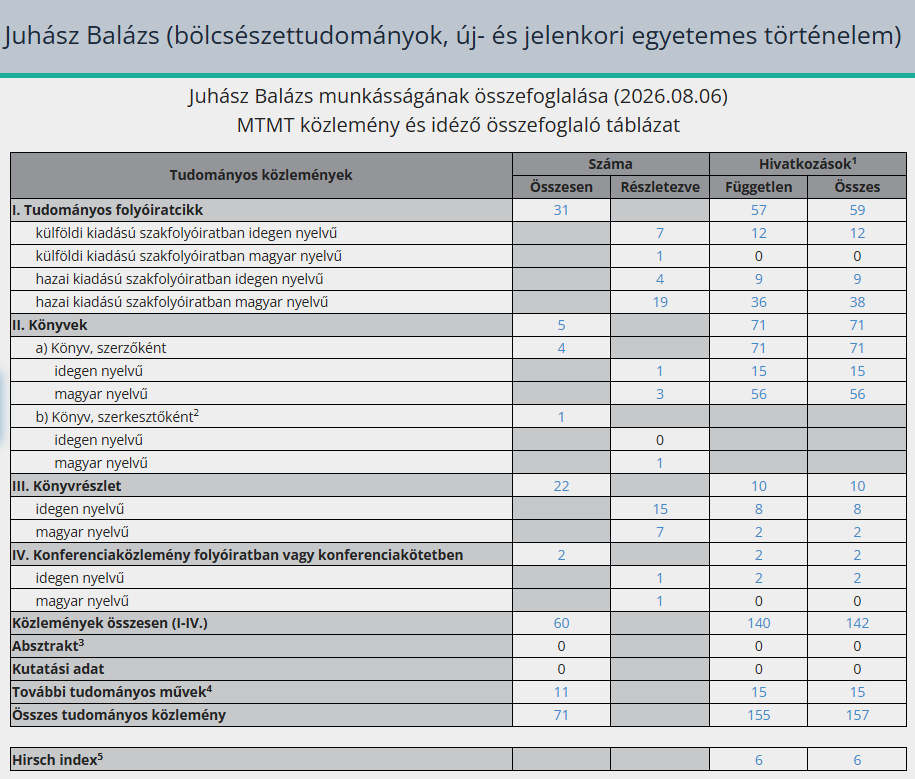
Gyakorlati feladat
Feladat 1. feladat – Egy életmű feltérképezése
Az MTMT adatbázisában lefuttatott keresések segítségével elemezze Körmendi Tamás munkásságát az alábbi szempontok szerint.
Keressen rá a kutató nevére egyszerű kereséssel. Mely tudományterületen alkot?
A Listák nézetet használva szűrjön tovább: csak azok a találatok érdekeljenek, amelyek 2010 és 2025 között keletkeztek.
Rendezze úgy a találatokat, hogy az idézettség legyen a mérvadó rendezési szempont, és a lista tetejére a legidézettebb mű kerüljön.
A listát mentse le PDF-ként.
Váltson adatlapnézetre, és ez alapján válaszoljon: melyik évben jelentette meg eddig a legtöbb tudományos művét (közleményét) Körmendi?
Milyen típusú közleményből van a legtöbb a munkásságában, a kördiagramban szereplő adatokból kiindulva?
Mely évben vagy években volt a legtöbb független idézettsége a közleményeinek, 2026-ig bezárólag?
Elvárt formátum: a kérdésekre adott válaszok szöveges formában, valamint a vonatkozó bibliográfiai listát tartalmazó PDF csatolása.
Önellenőrző kérdések
1. Mi a Magyar Tudományos Művek Tára (MTMT) a saját definíciója szerint?
Válasz megjelenítése
A hazai tudományos közleményeket és idézéseiket nyilvántartó bibliográfiai adatbázis.
2. A nyilvános keresőfunkcióhoz szükséges-e regisztráció az oldalon?
Válasz megjelenítése
Nem. Regisztráció csak a kutatói felhasználói felület eléréséhez és új adatok beviteléhez szükséges.
3. Mit kezdhetek a keresés útján kapott bibliográfiai listával?
Válasz megjelenítése
Lehetőség van kinyomtatni vagy PDF-ként menteni, illetve más formátumokká is konvertálható (irodalomjegyzék, XML, JSON stb.), így a kapott bibliográfiai lista tartalma más alkalmazásokba is importálható.
4. Milyen információkat kaphatunk meg, ha megtekintjük valakinek a szerzői adatlapját?
Válasz megjelenítése
Nevet, tudományterületet, intézményi affiliációt, személyi azonosítókat, az összes közlemény és idézettség számát, illetve ezek évek szerinti lebontását diagramokon; a közlemények típusait kördiagramon.
5. Használhatók-e az MTMT keresőjében a csonkoló és helyettesítő karakterek (*, ?, idézőjel)?
Válasz megjelenítése
Nem, az MTMT keresője ezeket nem támogatja. Több szóvariánssal érdemes dolgozni helyettük.
Összefoglalás
A Magyar Tudományos Művek Tára (MTMT) a hazai tudományos közleményeket és idézéseiket nyilvántartó bibliográfiai adatbázis, amelynek keresőfunkciója bárki számára korlátlanul elérhető. Különböző kulcsszavakra kaphatunk itt megfelelő bibliográfiai listákat, amelyeket további szempontok szerint (megjelenés éve, idézettség stb.) tudunk rendezni és szűkíteni; a találatként kapott listákat pedig különböző formátumokban menteni (pl. PDF), vagy más platformok számára kompatibilis formátumúvá alakítani (pl. XML, JSON). Emellett az oldal arra is használható, hogy egyes szerzők munkásságának statisztikáit lássuk diagramok vagy táblázatok formájában.
Ne feledje azonban, hogy az MTMT csak azt tartalmazza, amit a kutatók és az intézmények felvittek bele – tehát a magyar szakirodalom feltárásához fontos, de nem kizárólagos eszköz. Használja együtt a könyvtári katalógusokkal és a nemzetközi keresőkkel.
Kulcsfogalmak
bibliográfia – Egy adott témához köthető szakszerű irodalomjegyzék.
idézettség – Annak mutatója, hogy egy publikációra hány másik tudományos munka hivatkozik.
online repozitórium – Digitális archívum, amely tudományos publikációkat és kutatási anyagokat tesz szabadon vagy korlátozott hozzáféréssel elérhetővé.
publikációs lista – Egy szerző műveinek rendezett jegyzéke, az MTMT-ben automatikusan generált és karbantartott formában.
tudománymetria – Kvantitatív módszerekkel méri és elemzi kutatók, intézmények és kiadványok tudományos tevékenységét.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Holl András: MTMT – a National CRIS System in Hungary. Procedia Computer Science 249. (2024) 37–39. https://real.mtak.hu/209961/
- Kovács Zoltán – Nagy Andrea Magda: Gaál Zoltán publikációs munkásságának bibliometriai elemzése. Vezetéstudomány 56. (2025) 4. sz. 57–73. https://real.mtak.hu/217774/
- 1994. évi XL. törvény a Magyar Tudományos Akadémiáról, 19/A. §.
Linkek és eszközök
- MTMT főoldal – https://mtmt.hu/ – elérve: 2026. 08. 06.
- MTMT nyilvános keresőfelület – https://m2.mtmt.hu/gui2/ – elérve: 2026. 08. 06.
- Az MTMT bemutatkozása – https://mtmt.hu/bemutatkozas/ – elérve: 2026. 08. 06.
Repozitóriumok és nyílt hozzáférés
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 30 perc |
| Előfeltétel | Szakirodalomkeresés |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszköz alapadatai
| Eszköz neve | REAL – a Magyar Tudományos Akadémia Repozitóriuma |
| URL | https://real.mtak.hu/ |
| Üzemeltető | MTA Könyvtár és Információs Központ (MTA KIK) |
| Hozzáférés | Ingyenes, regisztráció nélkül kereshető és olvasható |
| Regisztráció | Csak feltöltéshez (szerzőknek, intézményi munkatársaknak) |
| Tartalomtípus | Tanulmányok, könyvfejezetek, disszertációk, akadémiai kiadványok teljes szöveggel |
| Időkörök | Túlnyomórészt a 20. század második felétől napjainkig |
| Almodulok | REAL-d (disszertációk), REAL-PhD, REAL-EOD (digitalizált régi könyvek), REAL-J (folyóiratok) |
Miről szól ez a fejezet?
Az előző fejezetben megkülönböztettük a katalógust, a repozitóriumot és a tudományos keresőmotort. Ez a fejezet a középső elemmel foglalkozik: mi az a repozitórium, milyen magyar repozitóriumok léteznek, és mit jelent a nyílt hozzáférés (Open Access), amelynek a repozitóriumok a legfontosabb infrastruktúrái.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- meghatározza a repozitórium fogalmát, és megkülönbözteti a tudományos közösségi hálóktól;
- megnevezi a REAL fenntartóját, és önállóan megkeres benne egy tanulmányt;
- elmagyarázza, mit jelent az OAI-PMH protokoll a repozitóriumok átjárhatósága szempontjából;
- saját szavaival meghatározza az Open Access fogalmát.
Bevezetés
Tegyük fel, hogy egy szakirodalmi hivatkozásban rábukkan egy tanulmányra, amely pontosan a témájáról szól. A folyóirat honlapján megtalálja – de fizetőfal mögött. Hol találhatja meg mégis a teljes szöveget?
A válasz általában a repozitórium. A tudományos élet jelentős része ugyanis kettős úton jelenik meg: a folyóirat kiadói felületén és – gyakran némi késleltetéssel – egy non-profit repozitóriumban, ahonnan szabadon letölthető. Ha ismeri ezt a második utat, sokkal több szöveghez fér hozzá, mint aki csak a kiadói oldalakon keres.
Ez a fejezet ezt a második utat mutatja be: mi a repozitórium, mi különbözteti meg a hozzá felületesen hasonló kereskedelmi platformoktól, és mit jelent az a fogalom, amely az egészet összefogja – a nyílt hozzáférés.
1. Mi a repozitórium?
Definíció Fogalom: online repozitórium
Olyan digitális archívum, amely tudományos publikációkat, kutatási anyagokat és forrásokat tesz szabadon vagy korlátozott hozzáféréssel elérhetővé. Lehet egyetemi adatbázis, nemzeti könyvtári gyűjtemény vagy tematikus történeti repozitórium.
A repozitóriumot három tulajdonság különbözteti meg a hozzá felületesen hasonló tudományos közösségi hálóktól (Academia.edu, ResearchGate – lásd az Academia.edu és ResearchGate fejezetet):
- Non-profit jelleg és stabil intézményi háttér. A repozitóriumok mögött jellemzően állami, egyetemi vagy kutatóintézeti finanszírozás és szerverek állnak, gyakran jogszabályi kerettel; így a hosszú távú megőrzés garantált.
- Nyílt szabványok szerinti adatrögzítés. Az adatok gépi úton is kinyerhetők és más rendszerekbe áttölthetők – ezt a repozitóriumoknál jellemzően az OAI-PMH protokoll biztosítja.
- Open Access. A tartalom regisztráció és fizetés nélkül olvasható.
2. REAL – az MTA Könyvtárának repozitóriuma
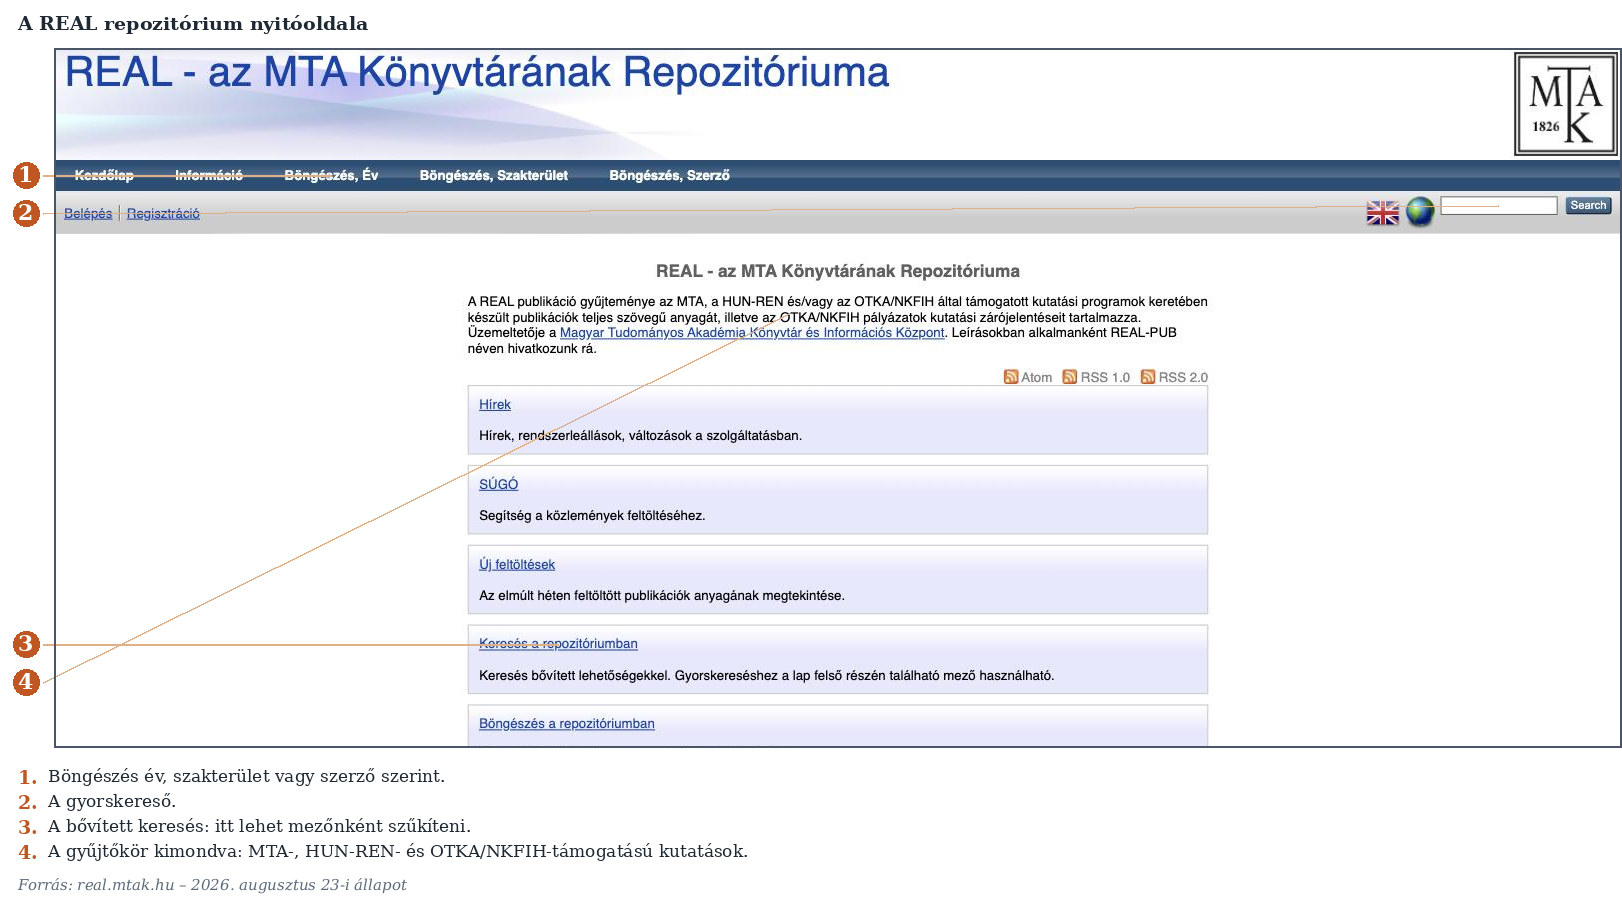
A Magyar Tudományos Akadémia Repozitóriuma (REAL) több gyűjteményből álló digitális könyvtári rendszer, amelyet a Magyar Tudományos Akadémia Könyvtár és Információs Központ (MTA KIK) tart fenn. A REAL-ban saját webes felületen lehet keresni, de a benne elhelyezett tanulmányok az OAI-PMH protokoll segítségével további hazai, európai vagy globális szakmai keresőrendszereken, továbbá az MTMT-n keresztül is elérhetők.
Elérhetőség: https://konyvtar.mta.hu/index.php?name=v_5_5
Definíció Fogalom: OAI-PMH
Az Open Archives Initiative Protocol for Metadata Harvesting nyílt szabvány, amellyel a repozitóriumok metaadatai gépi úton begyűjthetők és más keresőrendszerekbe áttölthetők. Ennek köszönhető, hogy egy REAL-ban elhelyezett tanulmány más felületekről is megtalálható.
Tipp A REAL a gyakorlatban a leggyorsabb
út egy magyar tanulmány teljes szövegéhez. Ha egy hivatkozásban
real.mtak.hu/… szerepel, az szinte biztosan szabadon
letölthető PDF. Ha az MTMT-ben talál egy tételt,
mindig nézze meg, van-e hozzá REAL-link.
2.1 Mit tartalmaz a REAL?
A repozitórium az MTA, a HUN-REN, illetve az OTKA/NKFIH által támogatott kutatások teljes szövegű publikációit gyűjti. Ez a finanszírozási kötés magyarázza a gyűjtemény összetételét: ami közpénzből támogatott kutatásból született, annak elvben itt a helye – ami magánkiadói projektből, annak nem feltétlenül.
Figyelem A REAL nem teljes. Attól, hogy egy magyar tanulmány nincs benne, még létezhet – csak nem tartozott a fenti körbe, vagy a szerző nem töltötte fel. A nulla találat itt tehát nem érv, szemben a nemzeti könyvtár katalógusával.
3. Nyílt hozzáférés (Open Access)
Definíció Fogalom: Open Access (nyílt hozzáférés)
A tudományos eredmények és publikációk ingyenes, akadálymentes online elérhetősége. Bárki szabadon olvashatja, letöltheti, másolhatja és felhasználhatja a cikkeket pénzügyi vagy jogi korlátok nélkül, ha feltünteti a forrást. Az Open Access-típusú publikálásnak több formája, „útja” lehetséges.
Az Open Access-publikálás formáiról részletes magyar nyelvű összefoglalók érhetők el:
- NKFIH Open Access Tudástár – https://nkfih.gov.hu/hivatalrol/open-acces-tudastar/open-access-tudastar
- Open Science – publikálási modellek – https://openscience.hu/modellek/
- MTA KIK Open Access oldal – https://openaccess.mtak.hu/
3.1 Az Open Access útjai
A szakirodalom többféle „utat” különböztet meg aszerint, ki teszi szabadon elérhetővé a publikációt, és mikor. A történészhallgatónak a két leggyakoribb formát érdemes ismernie:
- arany út (gold) – a tanulmány már a kiadónál is szabadon elérhető; gyakran a szerző vagy az intézménye fizet érte;
- zöld út (green) – a tanulmány a kiadónál fizetős, de a szerző elhelyezi egy repozitóriumban, például a REAL-ban.
Figyelem A zöld úton elhelyezett példány rendszerint nem azonos a kiadói változattal. Legtöbbször az elfogadott szerzői kézirat kerül a repozitóriumba: tartalmilag azonos, de nem tördelt, és az oldalszámozása eltérhet.
A gyakorlati következmény: ha a repozitóriumi PDF-ből idéz, ellenőrizze, hogy az oldalszám a kiadói vagy a kéziratos változaté – és a hivatkozásban jelezze, melyiket használta.
3.2 Intézményi és szakterületi repozitórium
Két típust érdemes megkülönböztetni, mert máshogy kell keresni bennük:
| Típus | Mi köti össze a tartalmát? | Példa |
|---|---|---|
| intézményi | egy intézmény munkatársainak és hallgatóinak munkái | EDIT – ELTE |
| szakterületi / támogatói | egy tudományterület vagy egy finanszírozó köre | REAL – MTA, HUN-REN, OTKA/NKFIH |
Tipp Ha egy szerzőt keres, az intézményi repozitóriumnál kezdje: ott van a munkahelye szerinti teljes életműve. Ha egy témát, akkor a szakterületinél – vagy inkább az MTMT-nél, amely mindkettőre rálát, és a repozitóriumi linkeket is közli.
Esettanulmány
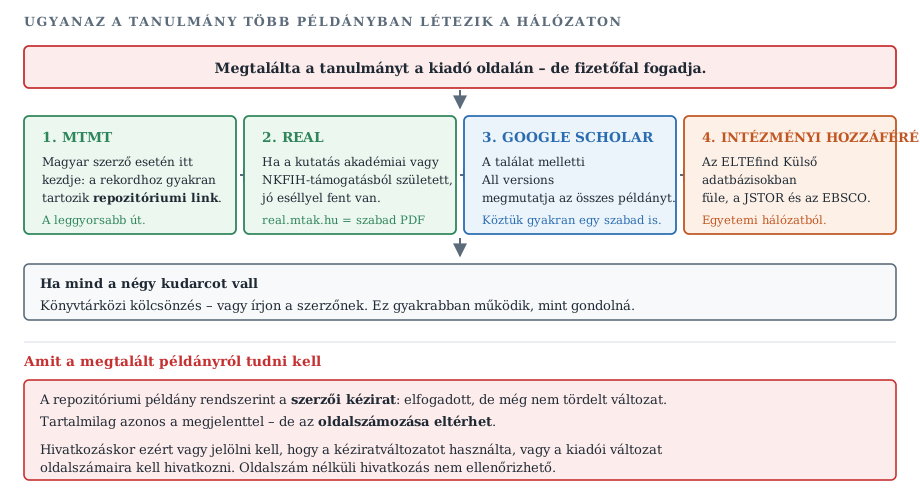
Esettanulmány Hogyan jut hozzá egy fizetős tanulmányhoz – legálisan
Tegyük fel, hogy egy hivatkozásjegyzékben talál egy tanulmányt, de a kiadó oldalán fizetőfal fogadja. Négy lépés, amelyek nagy eséllyel megoldják.
1. lépés – MTMT. Ha magyar szerzőről van szó, keresse ki a tételt az MTMT-ben. A rekordhoz gyakran tartozik repozitóriumi link – ez a leggyorsabb út.
2. lépés – REAL. Ha a kutatás akadémiai vagy
NKFIH-támogatásból született, jó eséllyel fent van a REAL-ban. Ha egy
hivatkozásban real.mtak.hu/… szerepel, az szinte biztosan
szabadon letölthető PDF.
3. lépés – Google Scholar. A találat melletti All versions link megmutatja, hány változat ismert – köztük gyakran egy szabadon elérhető, repozitóriumi példány. Ez a Cikkszintű és nemzetközi keresés fejezet egyik fogása.
4. lépés – intézményi hozzáférés. Ha egyik sem vezetett eredményre, még mindig ott az egyetemi előfizetés: az ELTEfind Külső adatbázisokban füle, illetve a JSTOR és az EBSCO.
Ha mind a négy kudarcot vall, marad a könyvtárközi kölcsönzés vagy a szerző megkeresése – utóbbi gyakran működik: a szerzők többsége szívesen küldi el a saját tanulmányát.
Amit ebből érdemes megjegyezni: ugyanaz a tanulmány több példányban létezik a hálózaton, különböző jogi státusszal. A repozitóriumi példány rendszerint a szerzői kézirat (elfogadott, de nem tördelt változat) – tartalmilag azonos, de az oldalszámozása eltérhet a kiadói változattól. Hivatkozáskor ezt jelölni kell, vagy a kiadói változat oldalszámait kell használni.
Gyakorlati feladat
Feladat 1. feladat – Teljes szöveg megkeresése a REAL-ban
Keressen az MTMT-ben egy szabadon választott magyar történeti témájú tanulmányt, amely 2015 után jelent meg.
Nézze meg, van-e hozzá REAL-link. Ha nincs, keresse meg a tanulmányt közvetlenül a REAL felületén is.
Töltse le a teljes szöveget, és rögzítse a tételt a Zoteróban.
Írja le egy bekezdésben, milyen különbséget tapasztalt az MTMT-ben és a REAL-ban található adatok között (mi az, ami csak az egyikben szerepel).
Elvárt formátum: egy bekezdésnyi szöveg + a Zotero-tétel képernyőképe.
Önellenőrző kérdések
1. Mi a REAL, és ki tartja fenn?
Válasz megjelenítése
A Magyar Tudományos Akadémia Repozitóriuma: több gyűjteményből álló digitális könyvtári rendszer, amelyet az MTA Könyvtár és Információs Központ (MTA KIK) tart fenn.
2. Mit tesz lehetővé az OAI-PMH protokoll?
Válasz megjelenítése
Azt, hogy a repozitóriumban elhelyezett tanulmányok metaadatai gépi úton begyűjthetők legyenek, így a tételek más hazai, európai vagy globális keresőrendszereken, illetve az MTMT-n keresztül is elérhetővé válnak.
3. Mi különbözteti meg a repozitóriumot a tudományos közösségi hálótól?
Válasz megjelenítése
A non-profit jelleg és a stabil intézményi háttér (garantált hosszú távú megőrzés), a nyílt szabványok szerinti adatrögzítés (átjárhatóság), valamint az, hogy a tartalom regisztráció nélkül elérhető (Open Access).
Összefoglalás
A repozitórium olyan digitális archívum, amely tudományos publikációkat tesz elérhetővé; a magyar történeti kutatás szempontjából a legfontosabb ilyen gyűjtemény a REAL. A repozitóriumok legfőbb erénye a stabil intézményi háttér, a nyílt szabványokon (OAI-PMH) alapuló átjárhatóság és az Open Access. Ezekben a tulajdonságokban különböznek élesen a következő fejezetben tárgyalt tudományos közösségi hálóktól.
Kulcsfogalmak
OAI-PMH – Nyílt szabvány, amely a repozitóriumok metaadatainak gépi begyűjtését és más rendszerekbe való áttöltését teszi lehetővé.
Open Access (nyílt hozzáférés) – A tudományos publikációk ingyenes, akadálymentes online elérhetősége.
online repozitórium – Digitális archívum, amely tudományos publikációkat és kutatási anyagokat tesz szabadon vagy korlátozott hozzáféréssel elérhetővé.
Felhasznált és ajánlott irodalom
Ajánlott irodalom
- Bemutatkoznak az Akadémiai Könyvtár repozitóriumai. Ujkor.hu – https://ujkor.hu/content/bemutatkoznak-az-akademiai-konyvtar-repozitoriumai
Linkek és eszközök
- REAL (MTA Repozitórium) – https://konyvtar.mta.hu/index.php?name=v_5_5 – elérve: 2026. 08. 20.
- MTA KIK Open Access – https://openaccess.mtak.hu/ – elérve: 2026. 08. 20.
- NKFIH Open Access Tudástár – https://nkfih.gov.hu/hivatalrol/open-acces-tudastar/open-access-tudastar – elérve: 2026. 08. 20.
- Open Science – publikálási modellek – https://openscience.hu/modellek/ – elérve: 2026. 08. 20.
Academia.edu és ResearchGate
| Szerző(k) | Selmeczi Péter |
| Becsült feldolgozási idő | 30 perc |
| Előfeltétel | Repozitóriumok és nyílt hozzáférés |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszközök alapadatai
| Eszköz neve | Academia.edu |
| URL | https://www.academia.edu/ |
| Üzemeltető | Academia, Inc. |
| Hozzáférés | Korlátozott: a rekordok kereséséhez regisztráció szükséges; egyes szolgáltatásokhoz további előfizetés kell. |
| Regisztráció | A felhasználói felület eléréséhez, új adatok beviteléhez szükséges. |
| Tartalomtípus | Szakirodalmi és tudományos ismeretterjesztő művek; szerzőik azonosító-, idézettségi és publikációs adatai |
| Időkörök | Folyamatos |
| Eszköz neve | ResearchGate |
| URL | https://www.researchgate.net/ |
| Üzemeltető | ResearchGate GmbH |
| Hozzáférés | Korlátozott: a rekordok kereséséhez regisztráció szükséges. |
| Regisztráció | A felhasználói felület eléréséhez, új adatok beviteléhez szükséges. |
| Tartalomtípus | Szakirodalmi és tudományos ismeretterjesztő művek; szerzőik azonosító-, idézettségi és publikációs adatai |
| Időkörök | Folyamatos |
Miről szól ez a fejezet?
A fejezetben arról lesz szó, hogy miért hasznosak az olyan oldalak, mint az Academia.edu és a ResearchGate, ugyanakkor miért tekinthetők ezek inkább egyfajta „tudományos közösségi hálónak”, mintsem valódi online repozitóriumoknak. Mi a szerepük a tudományos életben?
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- megkülönbözteti az Academia.edu és a ResearchGate funkcióit, és megnevezi a köztük lévő legfontosabb eltérést (prémium szolgáltatások);
- önállóan lefuttat egy keresést mindkét felületen, és felismeri, hogy a találati lista mit tartalmaz és mit nem;
- négy szempont (fenntartói jelleg, hosszú távú megőrzés, átjárhatóság, Open Access) mentén megindokolja, miért nem tekinthetők ezek valódi repozitóriumnak;
- egy konkrét tanulmány esetében a kiadó szabályzata alapján eldönti, hogy melyik változata (elfogadott szerzői kézirat vagy kiadói változat) tölthető fel jogszerűen ezekre a platformokra, és megnevezi a fájlfeltöltésnél biztonságosabb megoldást.
Bevezetés
Az előző fejezetekben már beszéltünk arról, hogy a mai világban egyre fontosabb, hogy valaki ne „csak” publikálja a művét valamely tudományos platformon (legyen szó akár nyomtatott, akár digitális folyóiratokról), hanem törekednie kell arra, hogy munkája minél láthatóbb legyen mások számára is (lásd az adatbázisok és a repozitóriumok szerepét). Az új kutatási eredmények így könnyebben tudnak utat találni maguknak a közönség felé, újabb feltárásokat is ösztönözve.
Ma már kiveszőben van az a sokáig hagyományosnak vett tudósattitűd, hogy a kutatók egyfajta „elefántcsonttoronyban alkotó, magányos alakok”, és előtérbe kerülnek az olyan követelmények, mint a hasonló szakterületen dolgozó tudósok kooperációja vagy a kutatócsoportok szervezése. Számos olyan kutatási téma van, amely felkínálja, sőt megköveteli az interdiszciplináris megközelítést – egy freskó ugyanúgy forrásul szolgálhat egy történész és egy művészettörténész számára, de mindkettőnek saját kutatási módszertana van, és kérdésfelvetéseik is eltérnek.
Ezek nem teljesen új keletű dolgok: a tudósoknak megvoltak a maguk csatornái az egymás közti párbeszédre eddig is – folyóiratok hasábjain, konferenciák és szimpóziumok folyosóin. Azonban az online térben létrejövő közösségi hálózatok nagy löketet adtak ennek: megkönnyítik és felgyorsítják a kutatások megosztását és az ezek mentén létrejövő diskurzusok kialakulását. Az ilyen közösségi hálózatok közé tartozik az Academia.edu és a ResearchGate is.
1. Az Academia.edu
Az Academia.edu tudományos közösségi platform, ahol kutatók, egyetemi hallgatók és szakemberek oszthatják meg kutatásaikat, publikációikat és más tudományos munkáikat. Olyasmi, mint egy „LinkedIn a tudósoknak”: célja, hogy a világ minden tájáról összekösse az azonos területen dolgozó embereket, és megkönnyítse a tudományos publikációkhoz való hozzáférést. Emellett segíthet abban is, hogy a kutatások nagyobb közönséghez jussanak el.
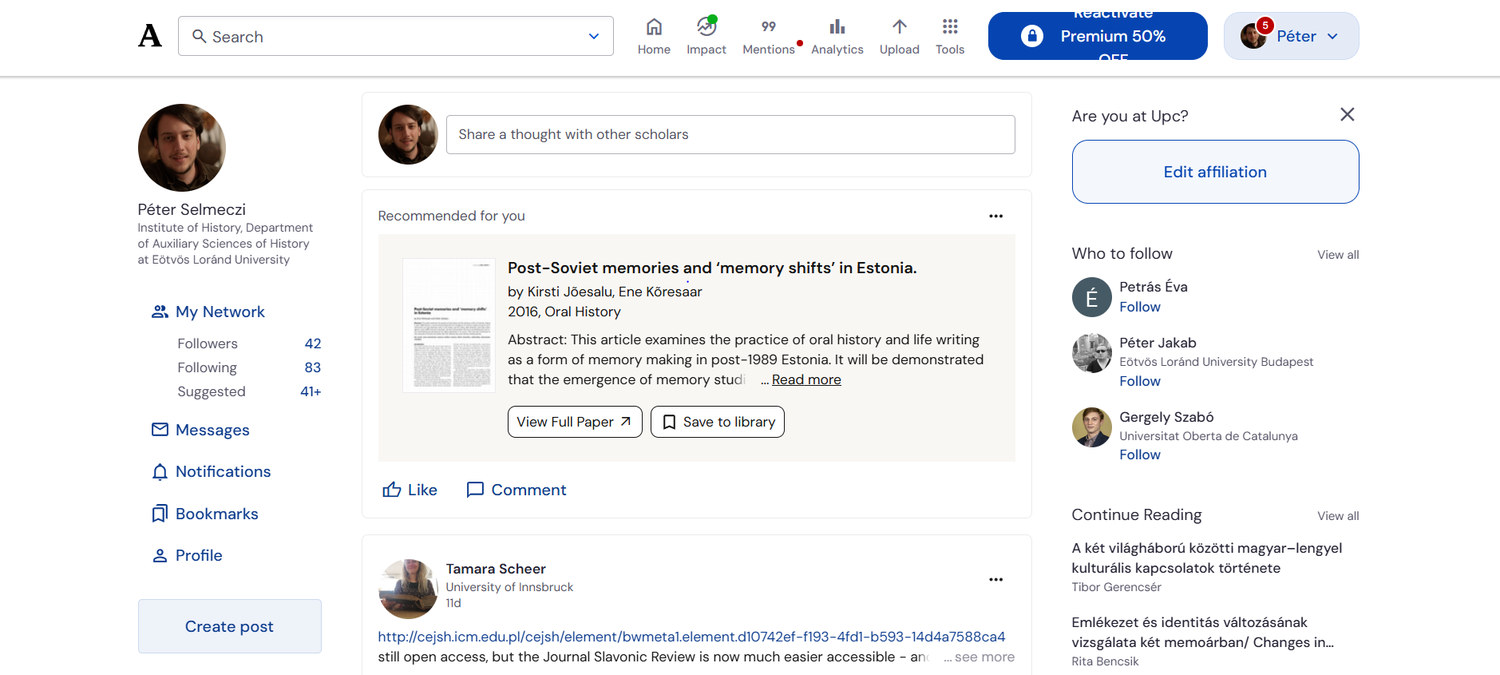
A felület használatához regisztrálni kell, ez azonban teljes mértékben ingyenes. Bárki feltöltheti kutatásait és hozzáférhet mások munkáihoz. Vannak azonban prémium funkciók, amelyekért fizetni kell. Ilyen például:
- részletes statisztikák elérése arról, hogy kik olvassák a munkáit;
- annak megismerése, hogy a mások által feltöltött publikációkban valóban hivatkoznak-e valamelyik írására;
- hatékonyabb keresési lehetőségek.
Ez utóbbi azért is lehet fontos, mert alapesetben kizárólag a feltöltött dokumentumok címében (illetve a felhasználói profilok közt) talált egyezéseket mutatja eredményként az oldal; a törzsszövegben talált egyezésekről csak egy számértéket ad, a konkrét fájlokat csupán előfizetés megléte ellenében teszi láthatóvá.
Példa Lássunk egy konkrét arányt: a „hadifoglyok” kifejezésre 23 találat érkezett a címben való előfordulásra, míg az algoritmus 1609 olyan dokumentumot jelzett találatként, amelynek a törzsszövegében legalább egyszer előfordul ugyanez a kifejezés (2026. augusztus 12-i állapot). A törzsszöveges találatok listája ingyenes fiókkal nem nyitható meg.
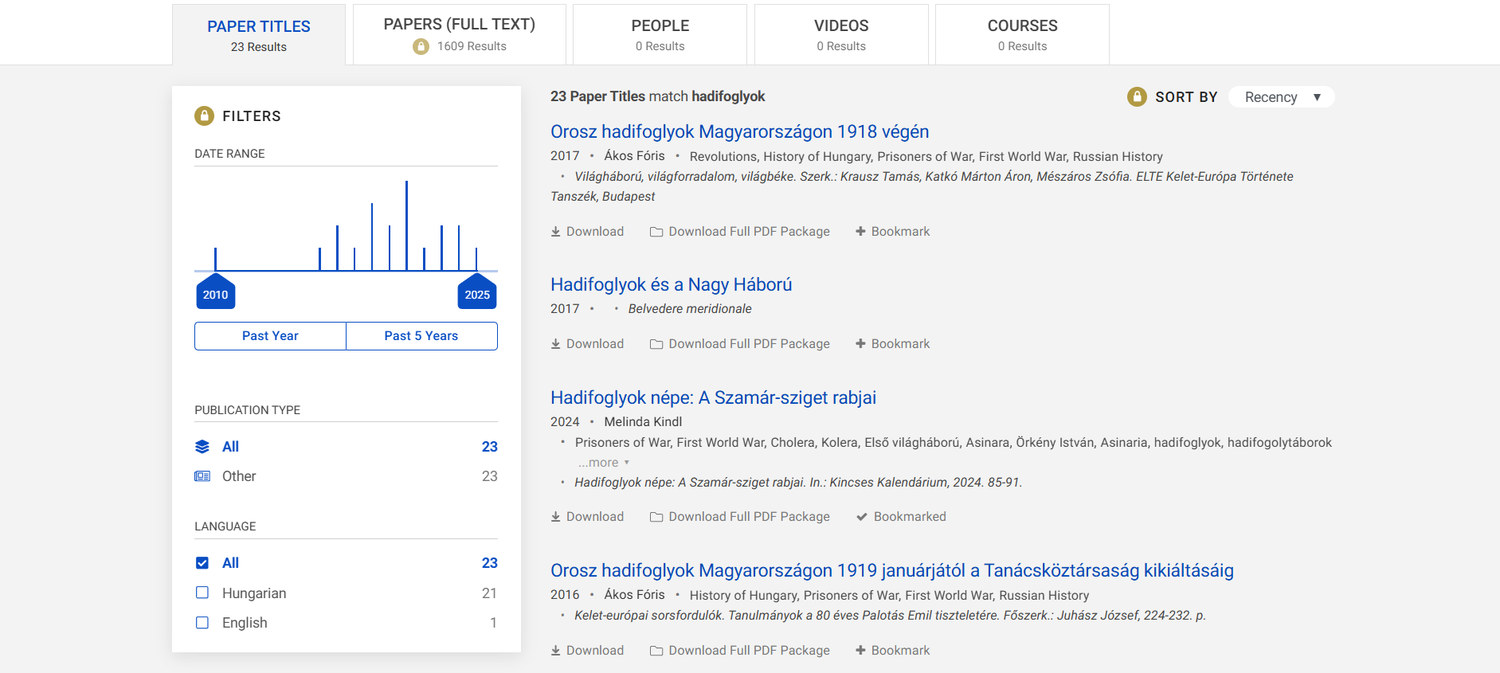
Mélyebben Az Academia.edu nem egyetemi
vagy felsőoktatási intézmény, ezért a jelenlegi szabályok szerint nem
lenne jogosult az .edu domainvégződésre. Az Academia.edu
nevet azonban 1999-ben regisztrálták – még azelőtt, hogy az
.edu domainneveket kizárólag akkreditált oktatási
intézmények igényelhették volna.
2. A ResearchGate
A ResearchGate az előbbihez hasonló tudományos közösségi platform, ahol kutatók megoszthatják publikációikat, kérdéseket tehetnek fel egymásnak és kollégákkal léphetnek kapcsolatba. Ez a platform is lehetővé teszi, hogy követni lehessen más tudósok munkáját, valamint hogy szakmai eszmecserét folytassanak egymással.
Alapvetően ingyenes: a kutatók ingyenesen feltölthetik publikációikat, hozzáférhetnek mások munkáihoz, és használhatják az oldal által kínált funkciók legtöbbjét. Az oldal nem rendelkezik olyan fizetős prémium szolgáltatásokkal, mint az Academia.edu, így általában minden felhasználó számára az összes alapvető funkció nyitottnak számít.
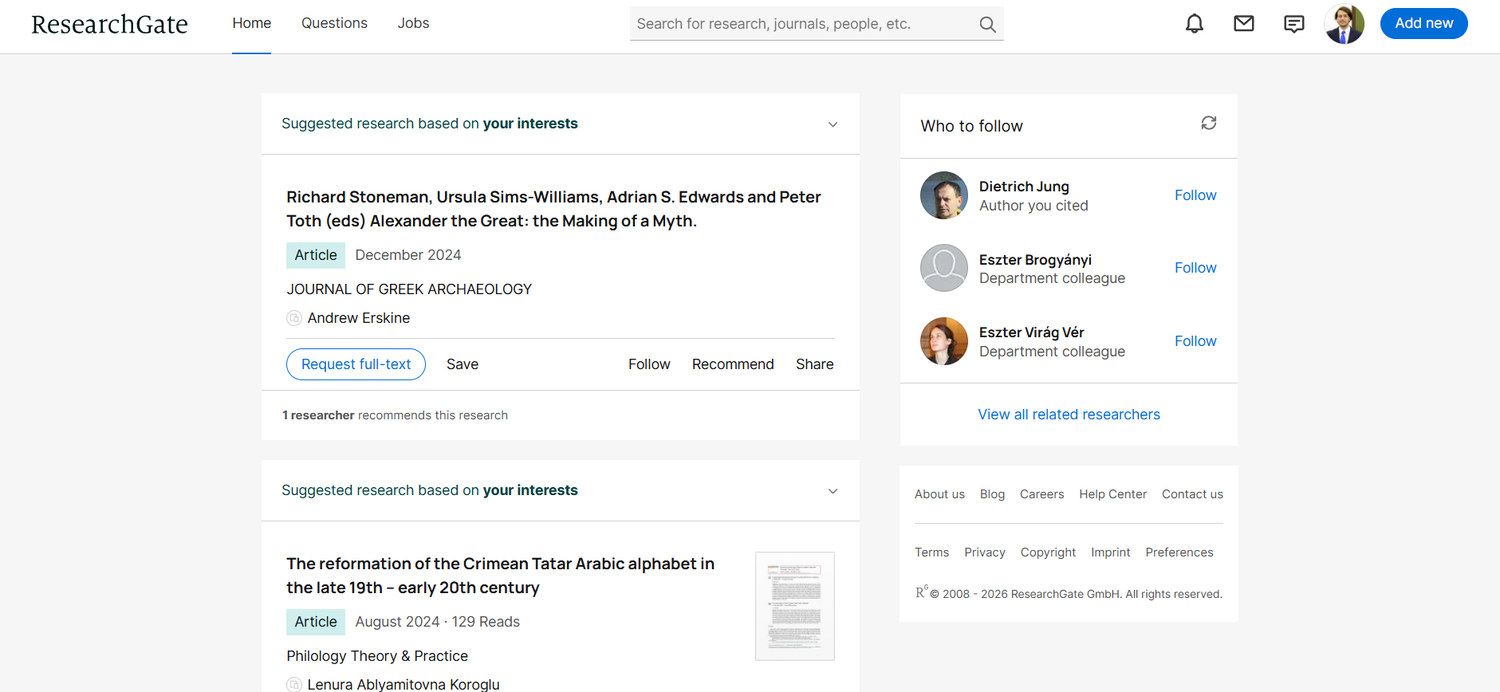
3. Tekinthető-e online repozitóriumnak az Academia.edu?
Az Academia.edu és a hozzá hasonló oldalak sok hasonló funkcióval bírnak, mint az online repozitóriumok (például fájlok érhetők el rajtuk keresztül, teljes terjedelemben), ugyanakkor a tudományos közösség és a könyvtárosok inkább „akadémiai közösségi hálózatként” (academic social network) definiálják az oldalt, és élesen megkülönböztetik a hivatalos repozitóriumoktól. A megkülönböztetés legfontosabb oka, hogy az ilyen oldalak üzleti céljai és működési elvei teljesen mások, mint a nyílt tudományt támogató rendszereké.
A cél. A repozitóriumok a tudományos eredmények nyílt és ingyenes terjesztése, valamint archiválása miatt jöttek létre; a közösségi hálók elsőrendű feladata a kapcsolatépítés és a profitszerzés (adatok értékesítése, elérési szintek – lásd a prémiumszolgáltatásokat – pénzösszeghez kötése).
A hosszú távú megőrzés. A valódi repozitóriumok mögött garantált a hosszú távú megőrzés (gyakran állami, egyetemi vagy kutatóintézeti finanszírozással és szerverekkel, akár külön jogszabályokkal övezve), míg az Academia.edu esetében, mint magáncégnél, erre nincs garancia. A cég bármikor megszűnhet, megváltoztathatja az üzleti modelljét, vagy törölheti a fájlokat.
Az átjárhatóság. A repozitóriumoknál előfeltétel, hogy az adatok rögzítésénél nyílt szabványokat (pl. OAI-PMH) használjanak; az Academia.edu esetében ez más gyűjtemények felé zárt: az adatokat nem lehet szabványos gépi úton (API-n keresztül) kinyerni a könyvtárak számára.
Az Open Access-megfelelés. Az egyik legfontosabb különbséget mégis talán az jelenti, hogy az Academia.edu – mivel a rajta lévő tartalmak eléréséért regisztrációt kér – valójában nem felel meg az Open Access előírásainak.
Figyelem Szerzői jogi buktató
A legtöbb nagy tudományos kiadó (pl. Elsevier, Springer, Wiley) szerződése megengedi, hogy a kutató a cikkének egy bizonyos verzióját feltöltse a saját egyetemének intézményi repozitóriumába. Azt viszont kifejezetten tiltják, hogy azt kereskedelmi oldalakra – mint az Academia.edu – is feltöltsék. Emiatt az Academia.edu-n nagyon gyakoriak a kiadók általi tömeges tartalomtörlési felszólítások („takedown notices”). 2013 végén például a világ legnagyobb tudományos kiadója, az Elsevier a Digital Millennium Copyright Act (DMCA) alapján több ezer felszólítást küldött az Academia.edu-nak, hogy azonnal töröljék a platformról a kutatók által feltöltött, szerzői jogvédelem alatt álló cikkeket.
Tipp Mi a helyes sorrend?
A tudományos konszenzust nagyjából úgy lehetne összefoglalni, hogy a publikációkat először egy valódi, non-profit repozitóriumba kell feltölteni. Minden folyóiratnak, tudományos publikálási fórumnak megvannak az előre lefektetett szabályzatai arról, hogy az eredeti megjelenést követően mennyi idővel lehet az adott tanulmányt szabadon elérhetővé tenni (lásd az Open Access utakat). Az Academia.edu-n vagy a közösségi médiában csak ezután, a kitételeket figyelembe véve érdemes megosztani a munkánkat – de fájl feltöltése helyett biztonságosabb csak a hivatalos repozitóriumi linket közzétenni.
Mélyebben A vita
Sasvári Péter és Urbanovics Anna (NKE) megjegyzik, hogy az egyetemi repozitóriumok nyíltsága és átjárhatósága is „kétes” abban az értelemben, hogy általában intézményi e-mail-címhez (tehát intézményi státuszhoz) van kötve a tartalmukhoz való hozzáférés.
A témáról elsősorban az angolszász irodalomban írnak. Katie Fortney és Justin Gonder járták körbe, hogy mi a különbség a nyílt repozitóriumok és az Academia.edu-hoz hasonló közösségi hálók felépítése és működése között (lásd a felhasznált irodalmat). Sarah Bond a Forbes hasábjain írt cikket arról, hogy az Academia.edu egy időben tervezte: egyes kutatók plusz pénzösszegekért cserébe „előkelőbb helyet” vásárolhassanak maguknak az algoritmus találatai között. Ezt végül a széles körű tiltakozás megakadályozta, de ehelyett került bevezetésre az oldalon – prémiumszolgáltatásként – az egyes publikációk és kutatói profilok közösségi elérésének fejlettebb adatelemzése.
Definíció Fogalom: tudományos közösségi háló (academic social network)
Kereskedelmi alapon működő online platform, amelynek elsődleges célja a kutatók közötti kapcsolatépítés és a publikációk megosztása. Fájlokat tesz elérhetővé, de nem garantál hosszú távú megőrzést, nem használ nyílt átjárhatósági szabványokat, és a hozzáférést regisztrációhoz (esetenként előfizetéshez) köti – ezért nem tekinthető repozitóriumnak.
Definíció Fogalom: Open Access (nyílt hozzáférés)
A tudományos eredmények és publikációk ingyenes, akadálymentes online elérhetősége. Bárki szabadon olvashatja, letöltheti, másolhatja és felhasználhatja a cikkeket pénzügyi vagy jogi korlátok nélkül, ha feltünteti a forrást.
Gyakorlati feladat
Feladat 1. feladat – Ugyanaz a keresés három felületen
Válasszon egy szűk történeti témát (2–3 szavas keresőkifejezés).
Futtassa le ugyanazt a keresést az MTMT-ben, a REAL-ban és az Academia.edu-n.
Jegyezze fel felületenként: hány találatot kapott, hány esetben jutott el ténylegesen a teljes szöveghez, és milyen metaadatok álltak rendelkezésre.
Egy bekezdésben indokolja, melyik felületet ajánlaná egy elsőéves hallgatónak elsőként, és miért.
Elvárt formátum: háromsoros táblázat + egy bekezdésnyi indoklás.
Önellenőrző kérdések
1. Mire szolgál az Academia.edu?
Válasz megjelenítése
Tudományos közösségi platform, ahol kutatók, egyetemi hallgatók és szakemberek megoszthatják kutatásaikat, publikációikat és más tudományos munkáikat.
2. Szabadon hozzáférhető, nonprofit oldalról van szó?
Válasz megjelenítése
Nem: magánvállalkozás áll mögötte, az oldal tartalmainak eléréséhez regisztrálni kell, és több funkció kizárólag prémium előfizetéssel használható.
3. Miért nem tekintik online repozitóriumnak az Academia.edu és a ResearchGate oldalakat?
Válasz megjelenítése
Mert nem felelnek meg a repozitóriumok követelményeinek: nincs korlátlan hozzáférés, nincs stabil intézményi háttér és garantált hosszú távú megőrzés, nem nyílt szabványok szerint rögzítik az adatokat, és nem teljesítik az Open Access feltételeit.
4. Mi a fő különbség az Academia.edu és a ResearchGate között?
Válasz megjelenítése
A ResearchGate nem rendelkezik olyan fizetős prémium szolgáltatásokkal, mint az Academia.edu, így minden alapvető funkciója minden felhasználó számára nyitva áll.
5. Mi a helyes sorrend egy saját publikáció megosztásánál?
Válasz megjelenítése
Először egy valódi, non-profit repozitóriumba kell feltölteni, a folyóirat szabályzatában megadott várakozási idő figyelembevételével. Ezután a közösségi hálókon célszerű nem a fájlt, hanem a hivatalos repozitóriumi linket megosztani.
Összefoglalás
A fejezetben arról volt szó, hogy miért fontos az Academia.edu és a hozzá hasonló tudományos közösségi hálók működése: megkönnyítik és felgyorsítják a kutatások megosztását, valamint az ezek mentén létrejövő diskurzusok kialakulását. Tisztáztuk ugyanakkor, hogy ezek nem tekinthetők nyilvános online repozitóriumoknak, hiszen a repozitóriumok követelményeinek (non-profit jelleg, stabil intézményi háttér, az adatállomány tartós megőrzésének garantálása, az adatok rögzítése nyílt szabványok alapján, Open Access) nem felelnek meg; szerepük pedig a tudományos közösségen belül is vitákkal övezett.
Hallgatóként a gyakorlati tanulság kettős: ezeken az oldalakon érdemes keresni, mert néha innen jutunk el olyan szöveghez, ami máshol nem érhető el – de a hivatkozásban mindig az eredeti megjelenési helyet kell megadni, nem a közösségi háló linkjét.
Kulcsfogalmak
academic social network (tudományos közösségi háló) – Kereskedelmi online platform kutatók kapcsolatépítésére és publikációmegosztásra; nem repozitórium.
Open Access (nyílt hozzáférés) – A tudományos publikációk ingyenes, akadálymentes online elérhetősége.
online repozitórium – Non-profit, intézményi hátterű digitális archívum, amely nyílt szabványok szerint teszi elérhetővé a tudományos publikációkat.
takedown notice – Szerzői jogi jogosult által küldött felszólítás jogsértő tartalom eltávolítására.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Fortney, Katie – Gonder, Justin: A social networking site is not an open access repository. https://osc.universityofcalifornia.edu/2015/12/a-social-networking-site-is-not-an-open-access-repository/ (elérve: 2026. 08. 13.)
- Fitzpatrick, Kathleen: Academia, Not Edu. https://kfitz.info/academia-not-edu/ (elérve: 2026. 08. 13.)
- Bond, Sarah: Dear Scholars, Delete Your Account At Academia.Edu. Forbes, 2017. jan. 23. https://www.forbes.com/sites/drsarahbond/2017/01/23/dear-scholars-delete-your-account-at-academia-edu/ (elérve: 2026. 08. 13.)
- Ruff, Corinne: Scholars Criticize Academia.edu Proposal to Charge Authors for Recommendations. The Chronicle of Higher Education. https://www.chronicle.com/article/scholars-criticize-academia-edu-proposal-to-charge-authors-for-recommendations/ (elérve: 2026. 08. 13.)
- Sasvári Péter – Urbanovics Anna: A tudományos publikálás alapjai. Budapest, 2019.
Linkek és eszközök
- Academia.edu – https://www.academia.edu/ – elérve: 2026. 08. 12.
- ResearchGate – https://www.researchgate.net/ – elérve: 2026. 08. 12.
- NKFIH Open Access Tudástár – https://nkfih.gov.hu/hivatalrol/open-acces-tudastar/open-access-tudastar – elérve: 2026. 08. 20.
- Open Science – publikálási modellek – https://openscience.hu/modellek/ – elérve: 2026. 08. 20.
Szerzői és dokumentumazonosítók: ORCID és DOI
| Szerző(k) | Selmeczi Péter |
| Becsült feldolgozási idő | 30 perc |
| Előfeltétel | Repozitóriumok és nyílt hozzáférés, MTMT |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszközök alapadatai
| Eszköz neve | ORCID (Open Researcher and Contributor ID) |
| URL | https://orcid.org/ |
| Üzemeltető | ORCID (nonprofit szervezet) |
| Hozzáférés | Ingyenes; a nyilvános profilok regisztráció nélkül böngészhetők |
| Regisztráció | Saját azonosító igényléséhez és a profil szerkesztéséhez szükséges |
| Tartalomtípus | Kutatói azonosítók és a hozzájuk kapcsolt publikációs, intézményi és pályafutási adatok |
| Időkörök | 2012-től folyamatosan |
| Eszköz neve | DOI (Digital Object Identifier) |
| URL | https://www.doi.org/ |
| Üzemeltető | International DOI Foundation; a kiosztást regisztrációs ügynökségek (pl. Crossref, DataCite) végzik |
| Hozzáférés | Ingyenes: bármely DOI feloldható a doi.org címen |
| Regisztráció | A kutatónak nem kell regisztrálnia; DOI-t a kiadó vagy az adattár igényel |
| Tartalomtípus | Digitális objektumok – tanulmányok, kötetek, adatsorok, ábrák – állandó azonosítói |
| Időkörök | 2000-től folyamatosan |
Miről szól ez a fejezet?
A fejezetben – visszautalva olyan fogalmakra, mint a repozitóriumok – arról lesz szó, hogy a nemzetközi publikációs térben milyen szerzői és dokumentumazonosítók vannak, amelyek segítik az egyes tudományos teljesítmények könnyebb elérését és a tudományos eredmények láthatóságának növelését, valamint hogy milyen előnyeik vannak ezeknek.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- megkülönbözteti a szerzői azonosítót a dokumentumazonosítótól, és mindkettőre példát hoz;
- az ORCID felületén megtalál egy adott kutatót, és eldönti, hogy a találati listából melyik rekord tartozik hozzá;
- egy DOI-azonosítóból önállóan eljut a hivatkozott tanulmányhoz;
- megindokolja, miért marad használható egy DOI akkor is, ha a folyóirat weboldala megváltozik;
- összekapcsolja egy szerző MTMT-adatlapját és ORCID-azonosítóját.
Bevezetés
„Publish or perish”, avagy aki nem publikál, nem is létezik – szokta volt mondani a művelt angolszász. A mai világban azonban nem elég, ha valaki publikálja az adott művét valamely tudományos platformon (legyen az papíralapú, például egy nyomtatott folyóirat, vagy digitális formátumú): ezt úgy kell megtennie, hogy minél láthatóbb legyen mások számára is. A publikációkat, eredményeket oly módon kell közzétenni, hogy ezáltal a szerzők széles körben ismertté váljanak, a publikáció elérhető legyen, a kutatás hatása növekedjen (idézettség), és hogy a kutató eredményei beépülhessenek a tudományos életbe, új eredmények születéséhez járuljanak hozzá.
A láthatóság növelése érdekében a kutatónak és munkáinak ott kell lenniük a különböző repozitóriumokban; meg kell választania, hogy milyen jellegű folyóiratban szeretne publikálni; szerzői azonosítót kell létrehoznia; illetve szintén a munkáinak minél szélesebb körű elérését szolgálja az, ha Open Access módon publikálja azokat.
A következő ábra azt foglalja össze, hogy a három rendszer – az ORCID, a DOI és az MTMT – melyik kérdésre válaszol, és hogyan kapcsolódnak egymáshoz.
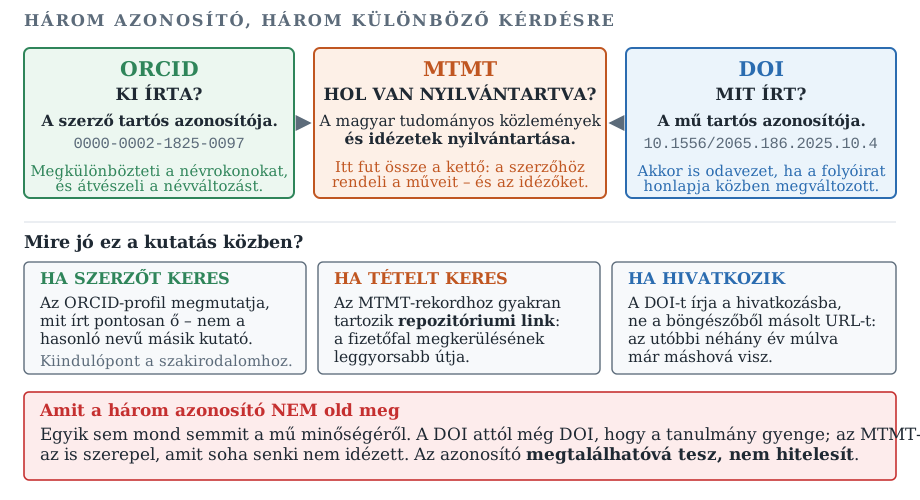
Definíció Fogalom: online repozitórium
Olyan digitális archívum, amely tudományos publikációkat, kutatási anyagokat és forrásokat tesz szabadon vagy korlátozott hozzáféréssel elérhetővé. Lehet egyetemi adatbázis, nemzeti könyvtári gyűjtemény vagy tematikus történeti repozitórium.
A szerzői azonosítók célja, hogy a szerzők egyértelműen azonosíthatók legyenek, és a szerző és publikációi összekapcsolhatók legyenek. Használatuk előnyei, hogy a gyakori nevek megkülönböztethetők; összeköthetők a különböző névalakok és névváltozások; és kiküszöbölhetők az intézményváltás okozta azonosítási problémák. Két típust különböztethetünk meg: szabadon regisztrálható és adatbázishoz kötött azonosítókat.
1. Szerzői azonosító – az ORCID
A szerzői azonosítók közül az egyik legismertebb, legelterjedtebb az Open Researcher and Contributor ID, röviden ORCID (https://orcid.org/). Az ORCID non-profit független szervezet, amely egy 16 karakterből álló azonosítót biztosít, amellyel a kutatók egyértelműen megkülönböztethetik magukat egymástól; továbbá megoldást kínál a kutatási eredmények és tevékenységek egyéni azonosítókhoz történő összerendelésére is. Az ORCID számos rendszerbe integrált, amelyeket elsősorban kiadók, támogatók, intézmények és egyéb kutatással kapcsolatos szolgáltatások használnak (például a magyar MTMT-vel is összekapcsolható).
Ilyen azonosító létrehozására, igénylésére bárki számára lehetőség van az ORCID oldalán való regisztrációval. Ezzel létrejön egy alkotói profil, nyilvánosan elérhető publikációs listával (amely részben automatikusan is frissül), illetve a létrejövő ORCID-azonosító feltüntethető a saját publikációkon.
Hogy mindennek hasznosságát megértsük, menjünk fel az ORCID főoldalára, és futtassunk le egy egyszerű keresést a „Juhász Balázs” keresőszóval. Láthatjuk, hogy mintegy 1914 találatot jelez a kereső (2026. augusztus 12-i állapot). Ez a találati lista minden olyan szerzői rekordot magába foglal, amely tartalmazza valamelyiket a „Balázs” és a „Juhász” szavak közül – első helyen azokat a találatokat feltüntetve, amelyeknek mindkét szó részét képezi.
Láthatjuk, hogy több azonos nevű embert is találtunk, akiknél bár az intézményi affiliáció is fel van tüntetve a név mellett, ez sem garantálja, hogy világosan megállapítsuk, melyik személy az, akinek adataira, publikációira kíváncsiak vagyunk. (Egy szervezeti egységben több hasonló nevű ember is dolgozhat vagy dolgozhatott, akár eltérő időben.) Ezen a listán azonban látható, hogy minden rekordnál van egy olyan adatelem, amely nem ismétlődik, és egyértelműen egy személyhez köthető: ez az ORCID iD. Ez minden kétséget kizáróan azonosítja a keresett szerzőt. Egy kutató neve ugyanis változhat az évek során (például házasságkötés útján felveszi a házastársa nevét), az ORCID-kódja azonban ekkor is változatlan marad, végigkíséri a kutatót az egész életpályáján.
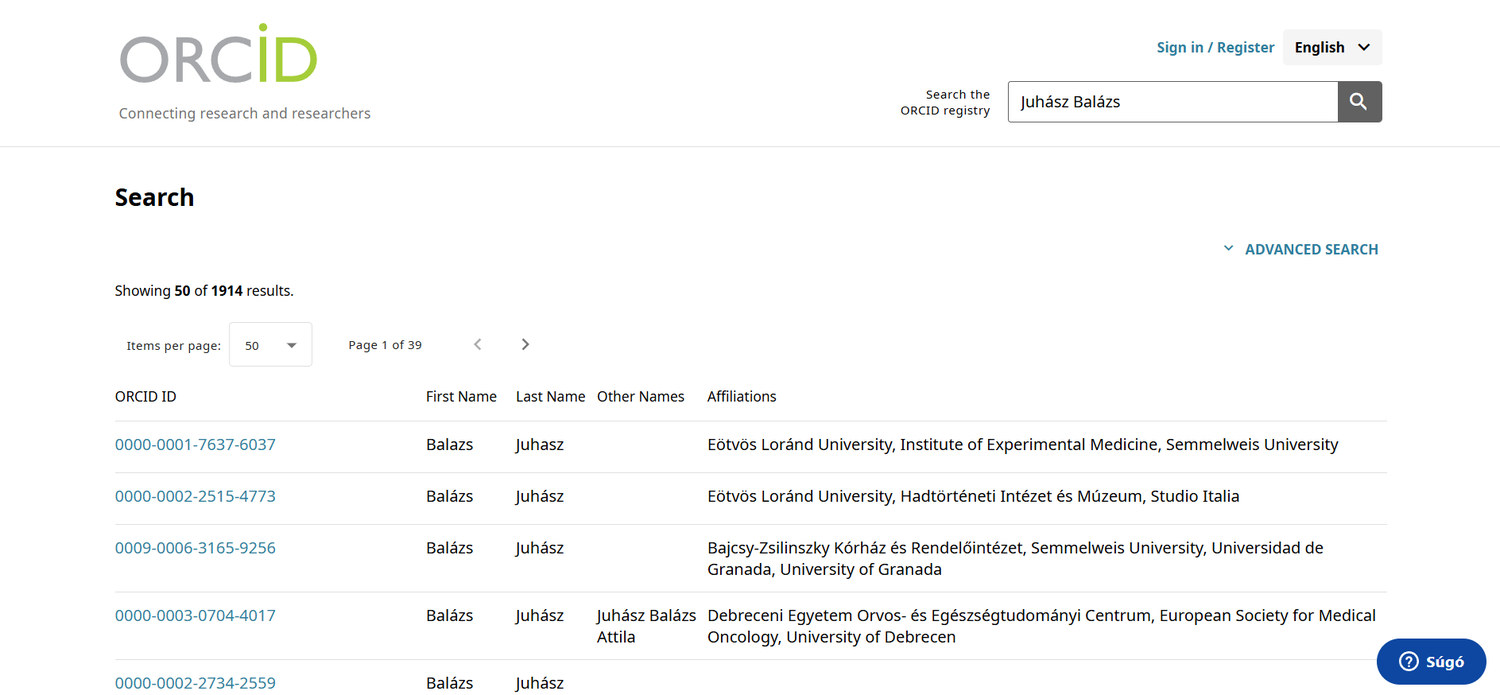
Az ORCID oldalán az azonosítóhoz tartozó személyes adatok is megtekinthetők: a munkahelyek, a tanulmányokkal kapcsolatos adatok, illetve a szerzőhöz tartozó bibliográfiai lista is. Más típusú szerzői azonosítók is feltüntetésre kerülhetnek (pl. Scopus Author ID).
2. Dokumentumazonosító – a DOI
Nemcsak a szerzőknek, hanem a dokumentumoknak is lehetnek egyedi azonosítói. A nyomtatásban megjelenő dokumentumoknál például ilyen az ISBN-szám; az online elérhető dokumentumok egyértelmű azonosítását pedig a DOI (Digital Object Identifier, https://www.doi.org/) jelenti.
A DOI egyedi alfanumerikus karakterlánc, amely biztosítja az online
megjelenő közlemények egyértelmű azonosítását és hosszú távú elérését.
Mindig a 10. karaktersorozattal kezdődik, majd a pont után
számjegyek azonosítják a szervezetet, kiadót vagy folyóiratot. A
szuffixet, vagyis az utótagot a szerkesztőségnek (a
rendszerhez csatlakozó szervezetnek) kell összeállítania, saját
hatáskörben meghatározott séma szerint. Bővebb tájékoztató angolul: https://www.doi.org/the-identifier/what-is-a-doi/
Definíció Fogalom: ISBN
Az ISBN (International Standard Book Number, azaz Nemzetközi Szabványos Könyvazonosító) egyedi, 13 számjegyű (2007 előtt 10 jegyű) numerikus kód, amely a könyvek és egyéb önálló kiadványok pontos azonosítására szolgál világszerte. Hazai alkalmazásához az OSZK útmutatója ad eligazítást.
Egy-egy tanulmány elérési, hozzáférési linkje gyakran sérülhet abban az esetben, ha egy tudományos folyóirat weboldala megújul, vagy a cikk átkerül egy másik szerverre. Ilyenkor a hagyományos webes linkek (URL-ek) gyakran eltörnek (ez az úgynevezett „404-es hiba”). A DOI fontos előnye, hogy olyan állandó linket jelent, amely mögött egy központi adatbázis folyamatosan frissíti, hogy éppen hol található meg az adott cikk az interneten. Ha rákattint egy DOI-ra, mindig a cikk aktuális, hivatalos oldalára jut.
Tipp Ha elakad
Mind az ORCID-, mind a DOI-azonosítók kapcsán készített részletes segédleteket az MTA KIK. Ezek itt érhetők el: https://openaccess.mtak.hu/orcid-2/ és https://openaccess.mtak.hu/doi/
Esettanulmány
Esettanulmány Adatbázisok tartalmának összekötése az azonosítók segítségével
Az előzőekben tárgyalt nemzetközi azonosítók célja a szerzők és a tudományos munkák egyértelmű azonosítása, valamint az egymással való összekapcsolás lehetővé tétele. Hogy ez a gyakorlatban hogyan néz ki, Kiss Farkas Gábor irodalomtörténész (neolatinista) egyik tanulmányán keresztül mutatjuk be.
Keressük fel az ORCID honlapját (https://orcid.org/), és írjuk be a keresőbe Kiss Farkas
Gábor nevét. A találati listán több azonos vagy hasonló nevű személy
rekordja is megjelenhet, így használjuk a fejünket: az ELTE egyik
oktatóját keressük. Ha megtaláltuk a keresett személyt, az ORCID-ra
rákattintva a szerző adatlapjára érkezünk. Látjuk listázva a vonatkozó
publikációit, köztük például a Neolatin irodalom, szerecsenek és a
Tátra-hegymászás története című munkáját is. Itt fel van tüntetve
magának az írásműnek az azonosítója is
(10.14232/antikren.2025.15.135-146). Ha rákattintunk, el is
érjük a tanulmányt.
A tanulmány leírásánál (https://ojs.bibl.u-szeged.hu/index.php/antikrene/article/view/46444) szintén megtaláljuk a szerző ORCID-ját. Ez is mutatja, hogy az azonosítók össze vannak kötve egymással: a tanulmánytól a szerzőhöz, a szerzőtől a tanulmányhoz is el tudunk jutni rajtuk keresztül.
Eddig könnyű a dolog – de mi a helyzet akkor, ha a tanulmány DOI-azonosítóját egy nyomtatott kiadványban vagy egy másik tanulmány lábjegyzetében találtuk meg?
Kézenfekvőnek tűnik, hogy ha a tanulmány címe is fel van tüntetve abban a lábjegyzetben, akkor azt írjuk be valamelyik szakirodalmi keresőbe. Ez azonban nem mindig hozza meg a kívánt eredményt: több írásműnek is hasonló lehet a címe, de egy szerzőnek is lehet több hasonló vagy közel azonos című munkája. A DOI-azonosítót beírhatjuk az internetes keresőmezőbe is – jó eséllyel megtaláljuk a kívánt írásművet, de nem garantált, hogy az első helyen fogja kiadni a kereső.
A leghatékonyabb, ha a DOI oldalán keresztül próbáljuk elérni az adott írásművet. A DOI főoldalának (https://www.doi.org/) aljára görgetve találunk egy keresőmezőt, amelybe kifejezetten DOI-azonosítókat lehet bemásolni. Tegyük ezt meg: ezen keresztül is az adott tanulmányhoz jutunk, fölösleges keresőkörök nélkül.
Gyakorlati feladat
Feladat 1. feladat – Azonosítók használata a gyakorlatban
A feladat az, hogy az eddig megismert azonosítók használatát, felismerését gyakoroljuk. Korábbi fejezetben már vettük az MTMT adatbázisának használatát, így a feladat kiindulópontját is ez jelenti.
Keressen rá az MTMT-ben Schweininger Péter nevére.
Nézze meg a szerzői adatlapot. Az ORCID mellett milyen személyi azonosítók vannak feltüntetve?
Kattintson rá Schweininger ORCID-azonosítójára. Hány munkáját találja meg itt listázva (darabszám)?
Keresse meg a Sváb világok. Migráció és mentalitás Száron, 1729–1848 c. publikációját. Kattintson rá az itt található DOI-kódra. Hová, milyen repozitóriumba érkezett?
Milyen jellegű dokumentumról van szó?
Nyissa meg a DOI honlapját. A főoldal alján lévő keresőmezőbe másolja be az előbb megtalált DOI-kódot. Sikeresen eljut ezen az úton is az írásműhöz?
Elvárt formátum: a kérdésekre adott válaszok szöveges formában.
Önellenőrző kérdések
1. Mire szolgál az ORCID?
Válasz megjelenítése
A szerzők egyedi azonosítását teszi lehetővé: 16 karakterből álló, tartós azonosító, amely a névváltozásoktól és az intézményváltástól függetlenül végigkíséri a kutatót.
2. Mire szolgál a DOI?
Válasz megjelenítése
Egy konkrét, online megjelent digitális objektum (tanulmány, könyv, adat) egyedi azonosítására és hosszú távú elérhetőségének biztosítására.
3. Kaphat-e DOI-azonosítót egy kizárólag nyomtatásban megjelent kiadvány?
Válasz megjelenítése
Nem: a DOI digitális objektumok azonosítására szolgál. Nyomtatott kiadványoknál az ISBN tölti be ezt a szerepet.
4. Összeköthető-e valakinek az MTMT-adatlapja és az ORCID-azonosítója?
Válasz megjelenítése
Igen: ha valaki rendelkezik ORCID-dal, azt a saját MTMT-felületén is feltüntetheti, a kettő összekapcsolható.
5. Miért nem törik el egy DOI-hivatkozás, ha a folyóirat weboldala megújul?
Válasz megjelenítése
Mert a DOI mögött központi adatbázis áll, amely folyamatosan frissíti, hogy az adott cikk éppen hol található meg az interneten; a DOI így állandó hivatkozás marad.
Összefoglalás
A fejezetben arról volt szó, miért fontosak az adott szerzők, illetve az online elérhető dokumentumok egységes azonosítását szolgáló kódok. A DOI digitális objektumok (cikk, könyv, adat, szoftver) egyedi azonosítását teszi lehetővé; előnye, hogy a dokumentum akkor is megtalálható és hivatkozható marad, ha az eredeti weboldal linkje megváltozik. Az ORCID személyeket (kutatót, alkotót) azonosít egyedi módon, amely alapján egy publikáció szerzője akkor is egyértelműen beazonosítható, ha megváltozott a neve vagy az affiliációja az évek során. Ezek az azonosítók lehetővé teszik a publikációk könnyebb összekötését szerzőikkel, illetve megtalálásukat az egyes adatbázisokban (pl. MTMT).
Kulcsfogalmak
DOI (Digital Object Identifier) – Digitális objektumazonosító: egyedi hivatkozás, amely információkat tartalmaz egy objektumról (pl. online dokumentumról vagy adatkészletről) és annak eléréséről. Biztosítja az online megjelenő közlemények egyértelmű azonosítását és hosszú távú elérhetőségét.
ISBN – Nemzetközi Szabványos Könyvazonosító: 13 (2007 előtt 10) számjegyű kód könyvek és önálló kiadványok azonosítására.
ORCID (Open Researcher and Contributor ID) – Ingyenesen létrehozható, egyedi és tartós, 16 karakterből álló kutatói azonosító. Egyértelműen összekapcsolja a kutatót tudományos munkásságával, függetlenül attól, hogy a neve milyen formában jelenik meg, vagy hogy pályafutása során mely intézményben, országban vagy tudományterületen dolgozik.
szuffix (DOI-utótag) – A DOI pont utáni része, amelyet a kiadó vagy szerkesztőség állít össze saját séma szerint.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Az ORCID leírása az MTA KIK Open Access oldalán. https://openaccess.mtak.hu/orcid-2/ (elérve: 2026. 08. 12.)
- A DOI leírása az MTA KIK Open Access oldalán. https://openaccess.mtak.hu/doi/ (elérve: 2026. 08. 12.)
- Markó-Markechné Zelei Edit (ELTE BTK Bölcsészettudományi Kari Könyvtár) prezentációja az ORCID-ról. https://konyvtar.btk.elte.hu/dstore/document/9662/ORCID.pdf (elérve: 2026. 08. 12.)
- Bilicsi Erika: DOI regisztráció a Magyar Tudományos Akadémia Könyvtár és Információs Központban. A szolgáltatás első évének tapasztalatai. In: Networkshop 2015, Sárospatak, 2015. március 31. – április 2. https://web.archive.org/web/20170103235838/http://real.mtak.hu/44021/ (elérve: 2026. 08. 12.)
Linkek és eszközök
- ORCID – https://orcid.org/ – elérve: 2026. 08. 12.
- DOI – https://www.doi.org/ – elérve: 2026. 08. 12.
- Mi az a DOI? (angol) – https://www.doi.org/the-identifier/what-is-a-doi/ – elérve: 2026. 08. 12.
- OSZK ISBN-útmutató – https://oszk.hu/sites/default/files/ISBN-utmutato-%2020121220.pdf – elérve: 2026. 08. 20.
Szaktárs: magyar szakkönyvek egy felületen
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 60 perc |
| Előfeltétel | Szakirodalomkeresés |
| Ajánlott utána | Mi a forrás? – a forrás és a szakirodalom megkülönböztetéséhez |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszköz alapadatai
| Eszköz neve | Szaktárs |
| URL | https://szaktars.hu/ |
| Üzemeltető | Arcanum Adatbázis Kiadó (a Szakkiadók Társulása – SZAKTÁRS – portálja) |
| Hozzáférés | A keresés szabad, az olvasás előfizetéses. Négy szint: szabad keresés · intézményi előfizetés · egyéni előfizetés az „előfizethető” jelölésű kiadóknál · open access kötetek |
| Regisztráció | Az intézményi hozzáférés Shibboleth-belépéssel (ELTE-s azonosítóval) működik |
| Tartalomtípus | Magyar tudományos és szakkönyvkiadók köteteinek teljes szövege |
| Időkörök | Túlnyomórészt a 20–21. századi könyvtermés |
| Fontos korlát | A talált szövegrész származhat a törzsszövegből, de a bibliográfiából vagy a jegyzetből is – ezt a találati listán ellenőrizni kell |
Miről szól ez a fejezet?
A Szakirodalomkeresés fejezetben katalógusokat és tudományos keresőfelületeket néztünk: ezek megmondják, hogy létezik-e egy könyv, és hol érhető el. Ez a fejezet egy másik típusú felületről szól, amely egészen mást tud: a Szaktárs nem a könyvek adatait, hanem a teljes szövegüket kereshetővé teszi.
A különbség nem apró. Egy katalógusban akkor talál rá egy monográfiára, ha a címe vagy a tárgyszavai illenek a kérdéséhez. A Szaktárs viszont megtalálja azt a könyvet is, amelynek a 214. oldalán, egyetlen bekezdésben szerepel az a személy vagy település, aki vagy amely Önt érdekli – és amelynek a címéből erre soha nem következtetett volna.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- megkülönböztesse a katalógusban végzett metaadat-keresést a Szaktárs teljes szövegű keresésétől, és megmondja, melyik kérdéshez melyik való;
- eligazodjon a hozzáférési szintek között (szabad keresés, intézményi előfizetés, egyéni előfizetés, open access);
- összeállítson egy pontos keresőkérdést a felület operátoraival: csonkolással, AND/OR/NOT kapcsolattal és távolsági operátorral;
- keresőkifejezéssel kezelje a helyesírási változatokat és az OCR-hibákat;
- helyesen olvassa a találati listát: felismerje, ha egy találat nem a törzsszövegből, hanem a bibliográfiából vagy a jegyzetből származik;
- szabályosan hivatkozzon egy Szaktárson elért könyvre.
Bevezetés
Definíció Fogalom: Szaktárs
A Szakkiadók Társulása (SZAKTÁRS) adatbázisportál, amelyet az Arcanum Adatbázis Kiadó üzemeltet. Célja, hogy a legfontosabb magyar szakkönyvkiadók műveit egy közös felületen, egységesen és teljes szövegében kereshetően tegye elérhetővé – a legrégebbi és a legfrissebb kiadványokat egyaránt.
A Szaktárs egy nagyobb rendszer része. Az Arcanum négy portálja együtt fedi le a magyar digitalizált szöveganyag jelentős részét, és mindegyik másra való:
| Felület | Mit tartalmaz? |
|---|---|
| Szaktárs | szakkönyvkiadók könyvei |
| Arcanum Újságok (ADT) | periodikumok: napilapok, hetilapok, tudományos folyóiratok |
| Arcanum Kézikönyvtár | lexikonok, szótárak, alapművek |
| Hungaricana | közgyűjtemények anyaga és publikációi |
Tipp Ha nem találja, amit keres, gyakran nem a keresőkérdéssel van baj, hanem a felülettel: rossz helyen keres. Monográfiához Szaktárs, folyóiratcikkhez ADT, levéltári irathoz Hungaricana. A négy felület részletes összevetését lásd Az Arcanum adatbázisai fejezetben.
1. Mit tartalmaz?
A portálhoz csatlakozott kiadók száma folyamatosan nő; 2026 augusztusában huszonkilenc kiadó szerepelt rajta. Történész szempontból a legfontosabbak között van az Osiris, a Balassi, a Gondolat, a Napvilág, a Kronosz, a Századvég, az Akadémiai Digitális Archívum, a Martin Opitz, valamint a Szegedi Tudományegyetem kiadványai.
Egy-egy kiadó saját aloldalt kap, ahol a művek kategóriák szerint is böngészhetők. A Kronosz Kiadó oldalán például 2026 augusztusában 296 kötet szerepelt, ezen belül 132 a „Történelem – Magyar”, 30 az „Életrajz – Levelezés – Napló” és 27 a „Történelem” kategóriában.
Figyelem A Szaktárs nem teljes, és nem is akar az lenni. Csak a csatlakozott kiadók művei vannak benne. Ha egy szerző könyve nem szerepel, abból nem következik, hogy nem létezik – csak annyi, hogy a kiadója nem tagja a társulásnak. A negatív találat itt soha nem bizonyíték.
2. Hozzáférés
A hozzáférésnek négy szintje van, és érdemes tudni, melyiken áll:
| Szint | Mit jelent? |
|---|---|
| Keresés | mindenki számára szabad, regisztráció nélkül |
| Tartalom megjelenítése | intézményi előfizetés szükséges |
| „Előfizethető” jelölésű kiadók | egyéni, magánelőfizetés is köthető rájuk |
| Open access | szabadon olvasható, előfizetés nélkül is |
Az előfizető felsőoktatási intézmények hallgatói Shibboleth-rendszeren keresztül otthonról is hozzáférnek. Egyes kiadók egyes köteteit külön „Open access” jelöléssel is közzéteszik – ezeket a portál külön menüpontban gyűjti.
Tipp A „keresés szabad, olvasás előfizetéses” modellnek van egy kutatásmódszertani haszna: előfizetés nélkül is meg tudja állapítani, hogy egy könyv releváns-e a témájához. A találati lista megmutatja a könyv címét és az oldalszámot; ezután már célzottan kikérheti a kötetet könyvtárból.
3. Keresés
A kereső szabad szavas keresést végez a könyvek tartalmában – a metaadatoktól függetlenül, a teljes digitális szövegállományban.
3.1 Hogyan rangsorol?
A találatok relevancia szerint rendeződnek. Az algoritmus öt szempontot vesz figyelembe: milyen gyakran szerepelnek a keresett szavak az adott oldalon; milyen hosszú az oldal tartalma; milyen közel állnak egymáshoz a keresett kifejezések; pontosan abban a formában fordulnak-e elő, ahogy beírtuk; és melyik mezőben van a találat – a címben, a szerzőnél vagy a tartalomjegyzékben talált egyezés előrébb sorolódik.
3.2 Csonkolás
| Jel | Mit helyettesít? |
|---|---|
* |
tetszőleges számú karaktert |
? |
0 vagy 1 karaktert |
! |
pontosan 1 karaktert |
3.3 Operátorok
| Operátor | Mit csinál? |
|---|---|
AND |
mindkét kifejezést tartalmazó oldalak |
OR |
legalább az egyiket tartalmazó oldalak |
NOT |
csak a bal oldalit tartalmazó oldalak |
nW |
az adott szavak n szó távolságban, megadott
sorrendben |
nN |
az adott szavak n szó távolságban, tetszőleges
sorrendben |
Kifejezésre idézőjellel kereshet: a "petőfi sándor" és a
petőfi 0W sándor ugyanazt adja. Ha maximálisan pontos
egyezés kell, az ESZO pontos indexben kereshet:
ESZO=("petőfi sándor debrecenben").
Példa Mire jó a távolsági operátor?
A magyar 3W múzeum kifejezés olyan oldalakat ad, ahol a
két szó legfeljebb három szó távolságban, ebben a sorrendben szerepel.
Találatok lesznek: Magyar Nemzeti Múzeum, Magyar
Természettudományi Múzeum, Magyar Királyi Hadtörténelmi
Múzeum, magyar állami tulajdonú múzeumok.
Ez az az eset, amikor egyetlen keresés helyettesít tíz különbözőt: nem kell előre tudnia, pontosan hogy hívták az intézményt.
3.4 A történész két legfontosabb keresési eszköze
Az alábbi kettő az, ami a gyakorlatban a legtöbbet számít, mert a források és a régi szakirodalom helyesírása ingadozik, az OCR pedig hibázik.
Tipp a) Helyesírási változatok egyetlen kereséssel.
s!ket– megtalálja a süket és a siket alakot iss!ket*– ezen felül a süketnéma, siketnéma, süketfajd alakokat isc?igány– megtalálja a cigány és a czigány alakot is
b) Téves találatok kizárása.
Üllő NOT (Üllői 0W út)– az Üllőre keresést megtisztítja az Üllői úttólbor NOT ESZO=(bőr*)– a rövid magánhangzós alakot védi a hosszútól
Mélyebben Miért kell a csonkolás az OCR miatt?
A Szaktárs szövege optikai karakterfelismeréssel készült (lásd a Digitalizálás és OCR fejezetet). Az OCR a régi tipográfiánál és a rossz nyomatnál hibázik: az ő betűből ó, az é-ből e lehet. Ha a keresett szó egyetlen betűje hibásan ismerődött fel, a pontos keresés nem találja meg az oldalt – és Ön azt fogja hinni, hogy nincs róla szó.
A csonkolókarakterek ezt kerülik meg: a
Pet!fi* 0W Sándor* akkor is talál, ha a Petőfi
második magánhangzóját az OCR elrontotta. Ez nem trükk, hanem a
digitalizált szövegkorpuszokkal való munka alapkészsége.
4. A találati lista olvasása
A Szaktárs találatai oldalszintűek: egy találat nem egy könyv, hanem egy könyv egy oldala. A lista minden tételnél megadja a kötet szerzőjét, címét, megjelenési helyét és évét, a fejezet címét és az oldalszámot, alatta pedig egy szövegkörnyezeti részletet, amelyben a keresett kifejezés kiemelve látszik.
A találatok szűkíthetők: Miben keresi? (melyik kiadó vagy gyűjtemény), Év, Illusztráció, Kategória.
Figyelem Olvassa el a szövegkörnyezetet, mielőtt megnyitja a találatot.
A teljes szövegű keresés nem tesz különbséget aközött, hogy a
keresett név a törzsszövegben, egy
lábjegyzetben vagy a bibliográfiában
szerepel. Egy próbakeresésben – Kronosz Kiadó,
"Dózsa György" – a 193 találat nagy része egyetlen
monográfia bibliográfiájának oldalairól származott, ahol a név tucatszor
előfordul tételcímekben. Ezek formailag tökéletes találatok, de
tartalmilag semmit nem mondanak Dózsáról.
A szövegkörnyezet ránézésre elárulja, melyikről van szó: a bibliográfiai oldalakon nevek és évszámok sorjáznak összefüggő mondatok nélkül.
Mélyebben Egy OCR-nyom a találati listában
Ugyanebben a próbakeresésben több találat szövegkörnyezete így
kezdődött: Dózsa György Kultusz és történelem. Ez az oldal
élőfeje (a lapszélen ismétlődő könyvcím), amelyet a
nyomda ritkított betűkkel szedett, az OCR pedig betűnként,
elválasztójelekkel ismert fel.
Két tanulság adódik belőle. Egyrészt: a ritkított szedésű szöveg
gyakran kereshetetlen marad, mert a keresőnek D ó z s a nem
azonos a Dózsa alakkal. Másrészt: az élőfej minden oldalon
szerepel, tehát a rá illeszkedő találatok nem a tartalomról
szólnak – csak arról, hogy a könyv címében ott a név.
5. Az olvasófelület
Egy találatot megnyitva a könyv beszkennelt oldalképe jelenik meg. A bal oldali panelnek három füle van: oldalképek (miniatűrök a lapozáshoz), könyvjelzők, és a könyvön belüli találatok listája – ez utóbbi végig látható marad, tehát a keresés eredményei között a köteten belül is lépkedhet.
A felső eszköztáron lapozás és oldalszám-beírás, nagyítás, egy- vagy kétoldalas elrendezés és forgatás található.
Tipp A böngésző címsora
hivatkozható. Az olvasófelület URL-je tartalmazza a kötet
azonosítóját, a lapszámot (pg=) és a keresőkérdést
(query=). Ha egy konkrét oldalra akar visszatérni vagy azt
megosztani egy szemináriumon, elég a címsort kimásolni.
6. Hogyan hivatkozzon rá?
Figyelem A forrás a nyomtatott könyv, nem a Szaktárs.
Ez ugyanaz a szabály, amelyet a Mi a forrás? fejezet a remediációról mond: a Szaktárs közvetítő réteg, nem maga a mű. A hivatkozás ezért a nyomtatott kötet adatait tartalmazza – szerző, cím, megjelenési hely, év, oldalszám –, és ehhez teszi hozzá az elérés útját.
Rossz: Szaktárs, C. Tóth Norbert: Dózsa György, 79. o.
Jó: C. Tóth Norbert: Dózsa György. Kultusz és történelem. Pécs, Kronosz Kiadó, 2024. 79. Elérhető: Szaktárs, https://www.szaktars.hu/ (elérve: 2026. 08. 21.)
Az oldalszám itt kivételesen problémamentes: mivel az olvasófelület a beszkennelt oldalképet mutatja, a látott oldalszám a nyomtatott kötet oldalszáma. (Ez nem magától értetődő – az e-könyveknél és a folyamatos szövegű digitális kiadásoknál éppen ez szokott hiányozni.)
Esettanulmány
Esettanulmány Amit a katalógus nem mond meg
Tegyük fel, hogy a filoxérajárvány társadalmi következményeit kutatja egy konkrét borvidéken, és összegyűjtötte a témába vágó monográfiákat a könyvtári katalógusból. A katalógus a címek és a tárgyszavak alapján dolgozik: azokat a könyveket adja, amelyek a filoxéráról szólnak.
A Szaktárs viszont más kérdést enged feltenni: mely könyvek említik a filoxérát – akkor is, ha egészen másról szólnak? Egy agrártörténeti monográfia, egy megyei helytörténet, egy családtörténeti kötet vagy egy borászati szakkönyv néhány oldala pontosan az Ön kérdéséhez adhat adatot, miközben egyik sem szerepelne a tárgyszavas találati listán.
A módszertani különbség: a katalógus a könyv egészének témájára kérdez, a teljes szövegű kereső a könyv bármelyik oldalára. A kettő nem helyettesíti, hanem kiegészíti egymást – és a szakirodalom feltárása akkor teljes, ha mindkettőt elvégezte.
Amire figyelnie kell: ez a keresés sok fals találatot is hoz (bibliográfiák, lábjegyzetek, névazonosságok), és rendszertelen – nem tudja megmondani, hány releváns könyv maradt ki, mert a nem csatlakozott kiadók művei eleve nincsenek benne. A teljes szövegű keresés tehát kiegészítő eszköz, nem a szisztematikus irodalomkutatás helyettesítője.
Gyakorlati feladatok
Feladat 1. feladat – Két keresés összevetése (30 perc)
Válasszon egy szűk témát (egy település, egy intézmény vagy egy személy a 19–20. századból).
- Keressen rá egy könyvtári katalógusban (lásd a Szakirodalomkeresés fejezetet), és jegyezze fel, hány releváns tételt talált.
- Keressen rá a Szaktárson, és jegyezze fel, hány kötetet ad (nem oldalt – a listát olvasva számolja meg a különböző köteteket).
- Van-e olyan kötet a Szaktárs listáján, amely a katalógusban nem jött elő? Miért nem?
- Fordítva: van-e olyan a katalógusban, ami a Szaktárson nincs? Mi lehet az oka?
Az eredményt egy oldalban foglalja össze.
Feladat 2. feladat – Keresőkérdés élesítése (20 perc)
Az alábbi három feladathoz írjon egy-egy keresőkérdést a fejezetben tanult operátorokkal. A megoldást indokolja.
- Olyan oldalak, ahol együtt szerepel két történelmi szereplő neve, legfeljebb tíz szó távolságban, tetszőleges sorrendben.
- Egy településnév, amelynek régies és mai írásmódja is előfordulhat.
- Egy gyakori szó, amelyre keresve sok fals találatot kap egy hasonló, de más jelentésű szó miatt – szűrje ki.
Feladat 3. feladat – Találatkritika (25 perc)
Futtasson egy keresést egy személynévre valamelyik történelmi kiadó anyagában, és nézze meg az első húsz találatot. Osztályozza őket három csoportba:
- a törzsszövegben, érdemben szól róla;
- csak említi (lábjegyzet, felsorolás);
- bibliográfiai tétel vagy élőfej – tartalmilag üres találat.
Adja meg a három csoport arányát, és írjon két mondatot arról, mit tanult ebből a teljes szövegű keresés természetéről.
Önellenőrző kérdések
1. Mi a különbség a katalógusban és a Szaktárson végzett keresés között?
Válasz megjelenítése
A katalógus a metaadatokra keres: címre, szerzőre, tárgyszóra – vagyis arra, miről szól a könyv egésze. A Szaktárs a könyvek teljes szövegében keres, tehát megtalálja azokat a köteteket is, amelyek másról szólnak, de egy-egy oldalukon említik a keresett dolgot.
2. Mit jelent, hogy a keresés szabad, de a tartalom előfizetéses?
Válasz megjelenítése
Bárki kereshet és láthatja a találati listát – a kötet adatait, az oldalszámot és a szövegkörnyezetet –, de a teljes oldal megjelenítéséhez intézményi előfizetés kell. Kutatásmódszertani haszna: előfizetés nélkül is eldönthető, hogy egy könyv releváns-e, és utána célzottan kikérhető könyvtárból.
3. Mire jó az s!ket alakú keresés?
Válasz megjelenítése
A felkiáltójel pontosan egy karaktert helyettesít, így egyetlen kereséssel megtalálja a helyesírási változatokat (süket/siket) – és azokat az eseteket is, ahol az OCR egyetlen betűt rosszul ismert fel. A régi szövegek ingadozó helyesírása és az OCR-hibák miatt ez a digitalizált korpuszokkal való munka alapkészsége.
4. Miért nem bizonyíték a negatív találat?
Válasz megjelenítése
Mert a Szaktárs csak a csatlakozott kiadók műveit tartalmazza. Ha valamire nincs találat, az jelentheti azt is, hogy a kérdéses kötet kiadója nem tagja a társulásnak. A hiány tehát a gyűjtemény határáról szól, nem a szakirodalomról.
5. Honnan látszik, hogy egy találat a bibliográfiából származik?
Válasz megjelenítése
A szövegkörnyezetből: a bibliográfiai oldalakon nevek, címtöredékek és évszámok sorjáznak összefüggő mondatok nélkül, és a fejezetcím is „Bibliográfia”. Ezek formailag jó, tartalmilag üres találatok.
6. Hogyan hivatkozik egy Szaktárson olvasott könyvre?
Válasz megjelenítése
A nyomtatott kötet adataival: szerző, cím, megjelenési hely, kiadó, év, oldalszám – és ehhez jelzi az elérés útját (Szaktárs, URL, elérés dátuma). A Szaktárs közvetítő réteg, nem maga a mű.
7. Miért nem okoz gondot itt az oldalszám, szemben sok e-könyvvel?
Válasz megjelenítése
Mert az olvasófelület a beszkennelt oldalképet mutatja, tehát a látott oldalszám a nyomtatott kötet oldalszáma. A folyamatos szövegű digitális kiadásokban ez a rögzített oldalszám hiányzik, ezért ott nehezebb pontosan hivatkozni.
Összefoglalás
A Szaktárs magyar szakkönyvkiadók műveit teszi teljes szövegében kereshetővé. Az ereje abban van, amit a katalógus nem tud: megtalálja azt a kötetet is, amelyik egyetlen oldalán említi a keresett dolgot. A gyengesége ugyanebből következik: sok a formailag jó, tartalmilag üres találat, és a gyűjtemény nem teljes – csak a csatlakozott kiadókat fedi le.
Két készség tartozik hozzá. Az egyik a keresőkérdés
megfogalmazása: csonkolással kezelni a helyesírási változatokat
és az OCR-hibákat, távolsági operátorral megfogni a változó nevű
intézményeket, NOT-tal kizárni a fals találatokat. A másik
a találatkritika: minden találatnál eldönteni, hogy a
törzsszövegből, egy lábjegyzetből vagy egy bibliográfiából
származik-e.
A kettő közül a második a fontosabb. Keresni könnyű; megítélni, hogy mit találtunk, nehéz.
Kulcsfogalmak
csonkolás – Keresési technika, amelyben
karakterhelyettesítő jelekkel (*, ?,
!) egyszerre több szóalakra keresünk; a helyesírási
változatok és az OCR-hibák kezelésének fő eszköze.
oldalszintű találat – Olyan keresési eredmény, amely nem egy dokumentumot, hanem egy dokumentum egy konkrét oldalát azonosítja.
Shibboleth – Intézményi azonosítási rendszer, amely lehetővé teszi, hogy az előfizető intézmény hallgatói otthonról is elérjék az előfizetett adatbázisokat.
Szaktárs – A Szakkiadók Társulása adatbázisportálja: magyar szakkönyvkiadók műveinek közös, teljes szövegben kereshető felülete.
távolsági operátor – Keresési operátor
(nW, nN), amely megadott szótávolságon belül,
kötött vagy szabad sorrendben keresi a kifejezéseket.
teljes szövegű keresés – A dokumentum teljes szövegében végzett keresés, a metaadatoktól (cím, szerző, tárgyszó) függetlenül.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Szaktárs – a portál saját ismertetője és „Felhasználói útmutató a kereséshez” című súgóoldala. https://www.szaktars.hu/felhasznaloi-utmutato/ – elérve: 2026. 08. 21.
- A fejezetben szereplő találati példák a szerkesztő próbakereséseiből
származnak (Kronosz Kiadó,
"Dózsa György", 2026. 08. 21.).
Ajánlott irodalom
- Ring Orsolya: Történeti források kiadása a digitális világban – lehetőségek és gyakorlat. Magyar Tudomány 186. (2025) 10. sz. 2039–2050. https://www.akjournals.com/view/journals/2065/186/10/article-p2039.xml
Linkek és eszközök
- Szaktárs – https://www.szaktars.hu/ – elérve: 2026. 08. 21.
- Szaktárs – felhasználói útmutató a kereséshez – https://www.szaktars.hu/felhasznaloi-utmutato/ – elérve: 2026. 08. 21.
- Szaktárs – Open access tartalmak – https://www.szaktars.hu/open-access/ – elérve: 2026. 08. 21.
- Szaktárs – kiadók listája – https://www.szaktars.hu/kiadok/ – elérve: 2026. 08. 21.
Az Arcanum tudományos gyűjteményei
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 60 perc |
| Előfeltétel | Szaktárs |
| Folytatás | Digitalizált sajtó és térkép: az Arcanum forrásgyűjteményei – a III. részben |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszköz alapadatai
Az Arcanum nem egyetlen felület, hanem öt szolgáltatás – az adatlap ezért a szolgáltatót és a közös jellemzőket rögzíti, a felületek megoszlását pedig az 1. ábra mutatja.
| Eszköz neve | Az Arcanum felületei (Arcanum Digitális Tudománytár, Arcanum Újságok, Kézikönyvtár, Arcanum Térképek, Hungaricana) |
| URL | https://www.arcanum.com/hu/ · https://adt.arcanum.com/ · https://maps.arcanum.com/ |
| Üzemeltető | Arcanum Adatbázis Kiadó (1989 óta működik) |
| Hozzáférés | A keresés díjtalan, a teljes megjelenítés előfizetéses. Intézményi (ELTE-s) és egyéni előfizetés is köthető; a Hungaricana szabadon hozzáférhető |
| Regisztráció | Az előfizetéshez kötött tartalmakhoz szükséges |
| Tartalomtípus | Folyóiratok, napilapok, könyvek, lexikonok, kézikönyvek, térképek – teljes szöveggel |
| Időkörök | A 18. századtól napjainkig; a sajtóanyag súlypontja a 19–20. század |
| Fontos korlát | A szöveg jelentős része OCR-rel készült, nem korrektúrázott – ezért kell csonkolással keresni (lásd OCR) |
Miről szól ez a fejezet?
Az Arcanum Adatbázis Kiadó 1989 óta működik, és mára a magyar digitalizált szöveganyag legnagyobb szolgáltatója. Öt felületet üzemeltet, és a történészhallgatók tipikus hibája, hogy mindegyiken ugyanazt keresik – vagy azt hiszik, hogy egy felület mindent tartalmaz.
Ez a fejezet azt mutatja meg, mit tud az Arcanum szakirodalmi eszközként: hol találja meg a kézikönyveket és lexikonokat, hogyan keres tudományos folyóiratcikkre, és milyen keresőnyelvvel dolgozik a rendszer. A korabeli sajtó és a történeti térképek – vagyis az Arcanum forrásként való használata – a III. részben, az Arcanum forrásgyűjteményei fejezetben következik.
A Szaktárs (könyvek) és a Hungaricana (közgyűjtemények) szintén önálló fejezetet kapott.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- egy konkrét kutatási kérdéshez kiválassza a megfelelő Arcanum-felületet, és indokolja a választást;
- megkülönböztesse a korrektúrázott és az OCR-rel készült szöveget, és megmondja, ez hogyan hat a keresés megbízhatóságára;
- megnevezze a Kézikönyvtár legfontosabb történészi segédműveit, és megmondja, melyik kérdéshez melyiket nyitná meg;
- eldöntse egy Arcanum-találatról, hogy az adott kutatási kérdéshez forrás vagy szakirodalom;
- alkalmazza az Arcanum keresőnyelvét: a csonkolást, a logikai és a távolsági operátorokat.
Bevezetés
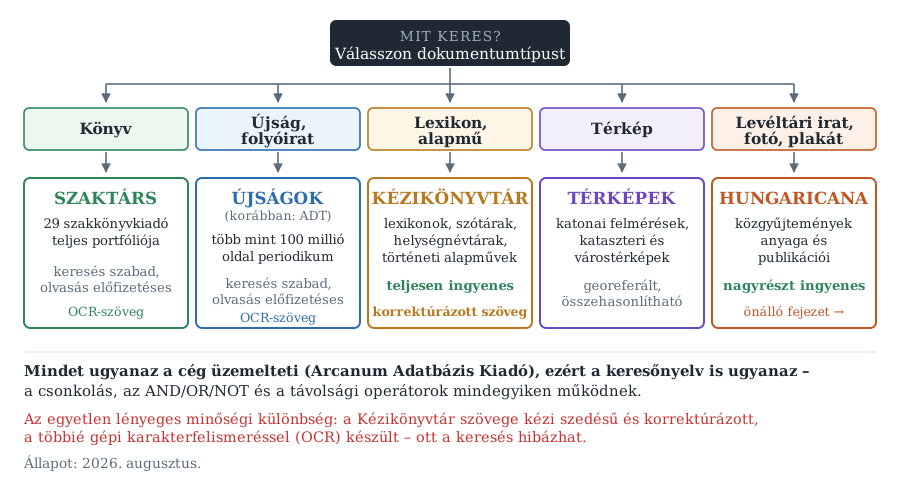
Tipp Az ábra legfontosabb sora a piros. A Kézikönyvtár szövege kézi szedésű és korrektúrázott: ha ott valamire nincs találat, az elég erős jel arra, hogy tényleg nincs benne. A többi felület szövege OCR-rel készült: ott a negatív találat sokkal gyengébb bizonyíték, mert a keresés a felismerési hibákon elcsúszhat.
1. Arcanum Kézikönyvtár
Definíció Fogalom: Arcanum Kézikönyvtár
Az Arcanum korábbi CD- és DVD-ROM-kiadványaiból létrehozott, ingyenes online gyűjtemény: lexikonok, szótárak, helységnévtárak, szépirodalmi életművek és történeti alapművek. Ezek az anyagok kézi szedéssel készültek és korrektúrázottak – nem OCR-rel.
Történész szempontból ez a legjobb ár-érték arányú felület a magyar interneten: ingyenes, és éppen azokat a segédkönyveket tartalmazza, amelyeket a kutatás minden fázisában használni kell. Néhány, amit érdemes ismerni:
- A Pallas nagy lexikona – a 19. század végi tudásállapot tükre; egyszerre segédeszköz és korabeli forrás;
- Szinnyei József: Magyar írók élete és munkái és a Magyar életrajzi lexikon – életrajzi alapadatok;
- Nagy Iván: Magyarország családai és Kempelen Béla: Magyar nemes családok – családtörténet;
- Borovszky Samu: Magyarország vármegyéi és városai, Csánki Dezső: Magyarország történelmi földrajza a Hunyadiak korában – hely- és birtoktörténet;
- Fényes Elek: Magyarország geográfiai szótára, Vályi András: Magyarország leírása – 18–19. századi országleírások;
- helységnévtárak: az 1913-as helységnévtár, a második és a harmadik katonai felmérés helységnevei, Gyalay Mihály igazgatástörténeti helységnév-lexikona;
- Turul 1883–1950 – a genealógiai és heraldikai szakfolyóirat teljes évfolyamai;
- Magyar Történeti Életrajzok, A magyar nemzet története, Az Osztrák-Magyar Monarchia írásban és képben.
Tipp A helységnévtárak a leggyakrabban alulhasznált eszközök. Ha egy forrásban olyan településnév szerepel, amelyet a mai térképen nem talál, szinte biztosan ezekben van a válasz: a település nevet változtatott, egyesült, vagy a határváltozások után másik országhoz került. Enélkül a földrajzi adat értelmezhetetlen – és a térképes vizualizáció is hibás lesz.
Figyelem A lexikon kettős természetű. A Pallas nagy lexikona segédeszközként harmadlagos forrás: gyors tájékozódásra jó, hivatkozni nem illik rá (lásd Mi a forrás?). De ha a kutatási kérdése a századforduló gondolkodására vonatkozik, elsődleges forrás lesz belőle – mert megmutatja, mit tudott és hogyan gondolkodott a korszak művelt közönsége. Ugyanaz a szócikk, két különböző szerep.
2. Tudományos folyóiratok a periodika-adatbázisban
Az Arcanum Újságok (korábbi nevén Arcanum Digitális Tudománytár, ADT) nemcsak napilapokat és képes magazinokat tartalmaz, hanem tudományos folyóiratok teljes évfolyamait is: a Századok, az Agrártörténeti Szemle és sok más szakfolyóirat évtizedeit. Szakirodalom-kereséskor ez a felület tehát ugyanolyan fontos, mint a MATARKA vagy a Szaktárs – csak mást tud.
| Felület | Mit talál meg? |
|---|---|
| MATARKA | azt a cikket, amelynek a címében szerepel a szó |
| Szaktárs | azt a könyvet, amelynek a szövegében szerepel |
| Arcanum Újságok | azt a folyóiratcikket, amelynek a szövegében – vagy akár a lábjegyzetében – szerepel |
Tipp A lábjegyzet-keresés az Arcanum egyik legkevésbé ismert lehetősége. A részletes keresésben külön mezőként szerepel a Lábjegyzet. Ezzel arra lehet rákeresni, hogy kit hivatkoztak – vagyis a magyar szakirodalom hivatkozási hálózatába lehet belelátni ott is, ahol nincs adatbázisszintű idézettségi mutató.
Ez a MTMT idézettségi adatainak kézi, de sokszor gazdagabb kiegészítése: a régi évfolyamok hivatkozásai ugyanis nem kerültek be a modern adatbázisokba.
A részletes keresés összes mezőjét – köztük a tulajdonnév-indexeket – az Arcanum forrásgyűjteményei fejezet mutatja be, mert ott válnak igazán fontossá.
3. Ami mindegyik felületen közös: a keresőnyelv
Mivel mindegyik felületet ugyanaz a cég fejleszti, a keresőnyelv is azonos. A Szaktárs fejezetben részletesen tárgyalt eszközök itt is működnek:
- csonkolás:
*(tetszőleges számú karakter),?(0 vagy 1),!(pontosan 1); - operátorok:
AND,OR,NOT; - távolsági operátorok:
nW(kötött sorrend),nN(szabad sorrend); - kifejezés: idézőjel vagy
0W.
Aki egy felületen megtanulja, mind az ötön tudja használni.
Mélyebben Miért különösen fontos a csonkolás a sajtóanyagban?
Három ok is van rá, és mind a háromra ugyanaz a megoldás.
- Az OCR hibázik. A 19. századi újságpapír megsárgul, a nyomás egyenetlen, a betűk összefolynak. Egy-egy karakter félreolvasása elég ahhoz, hogy a szó ne legyen megtalálható.
- A helyesírás változott. A czigány, a cz-vel írt szavak, a hosszú és rövid magánhangzók ingadozása mind a 19. századi szövegek jellemzője.
- A magyar toldalékol. A
filoxéranem találja meg afiloxérát,filoxérának,filoxérávalalakokat – afiloxér*viszont igen.
A harmadik a leggyakoribb hiba, és a legkönnyebben orvosolható: magyar szövegben csonkolással keressen, ne pontos alakra.
4. Forrás vagy szakirodalom? – a gyűjtemény kettőssége
Figyelem Az Arcanum Újságok egyetlen felületen kínálja a Századok és a Népszabadság évfolyamait. Az egyik tudományos folyóirat, a másik napilap – de a kereső mindkettőt ugyanúgy adja vissza, és a találati listán semmi nem figyelmezteti rá, hogy más típusú dokumentumot lát.
A besorolás – ahogy a Mi a forrás? fejezetben láttuk – a kutatási kérdésen múlik. Egy 1985-ös Agrártörténeti Szemle-tanulmány a filoxéráról szakirodalom; ugyanaz a tanulmány forrás, ha az 1980-as évek magyar agrártörténet-írását kutatja. Egy 1875-ös napilap tudósítása a filoxéráról forrás; de ha a lap szerkesztői gyakorlatát kutatja, akkor a vizsgálat tárgya.
A gyakorlati szabály: minden ADT-találatnál tegye fel a kérdést, mielőtt felhasználja – és a hivatkozásban is ennek megfelelően kezelje.
Tipp Épp ezért oszlik az Arcanum anyaga két fejezetre ebben a könyvben. Amit itt olvasott – a Kézikönyvtár, a folyóiratcikkek és a keresőnyelv –, az a szakirodalom felkutatását szolgálja. A korabeli sajtó és a történeti térképek használatáról, valamint a hozzájuk tartozó forráskritikáról a III. részben, az Arcanum forrásgyűjteményei fejezetben lesz szó.
Esettanulmány
Esettanulmány Egy helységnév, amit a mai térképen nem talál
Tegyük fel, hogy egy 1873-as vármegyei iratban a Petenye településnév szerepel, de a mai térképen nincs ilyen. Mit tegyen?
1. lépés – ne a keresőmotorral kezdje. Egy általános webes keresés vagy semmit nem ad, vagy találomra összekevert helyneveket. A kérdés nem az, hogy „hol van Petenye”, hanem az, hogy mikor és milyen néven létezett.
2. lépés – helységnévtár. A Kézikönyvtár helységnévtárai pontosan erre valók: az 1913-as helységnévtár, a katonai felmérések helységnevei és Gyalay Mihály igazgatástörténeti helységnév-lexikona egymás után megmutatják, hogy egy település mikor milyen néven, melyik vármegyében szerepelt.
3. lépés – az eredmény értelmezése. Egy magyar település neve a 19–20. században többször is változhatott: névmagyarosítás, községegyesítés, majd a határváltozások után idegen nyelvű hivatalos név. Ugyanaz a hely tehát négy-öt néven is szerepelhet a forrásokban.
4. lépés – ellenőrzés térképen. A megtalált nevet érdemes az Arcanum Térképeken is megnézni: a katonai felmérések georeferált lapjain a történelmi név rákereshető, és a mai térképre fektetve azonnal látszik, hol volt.
Miért fontos ez? Mert enélkül a földrajzi adat értelmezhetetlen. Ha egy adatbázisba vagy térképes ábrába a forrásban talált nevet változtatás nélkül viszi be, a vizualizáció is hibás lesz – és a hiba nem fog látszani rajta. Ugyanezt a jelenséget mutatja az AdatbázisokOnline fejezet helynévállapotokról szóló része is.
Gyakorlati feladatok
Feladat 1. feladat – Felületválasztás (15 perc)
Az alábbi öt kutatási feladathoz nevezze meg, melyik Arcanum-felületen kezdene, és indokolja egy mondatban.
- Meg kell tudnia, mikor és milyen néven létezett egy ma már nem létező falu.
- Egy 1907-es sztrájkról korabeli tudósítást keres.
- Egy 2015-ös monográfia állítását szeretné ellenőrizni.
- Egy 18. századi birtok pontos elhelyezkedését keresi.
- Egy 19. századi író életrajzi adatait keresi.
Feladat 2. feladat – Csonkolás a gyakorlatban (20 perc)
Válasszon egy magyar közszót vagy településnevet, amely a témájához tartozik.
- Keressen rá pontos alakban az Arcanum Újságokban, és jegyezze fel a találatszámot.
- Keressen rá csonkolva (
*), és jegyezze fel a találatszámot. - Mekkora a különbség? Nézze meg tíz találat szövegkörnyezetét a csonkolt keresésből: hány olyan van köztük, amelyet a pontos keresés kihagyott volna, és miért (toldalék? helyesírás? OCR-hiba?).
Feladat 3. feladat – Lexikon mint forrás (írásbeli, fél oldal)
Keressen ki egy szócikket a Pallas nagy lexikonából egy olyan témában, amelyet ismer. Írja le, (a) mit használna belőle segédeszközként, és (b) mit mondana el ugyanez a szócikk forrásként a századforduló gondolkodásáról.
Önellenőrző kérdések
1. Mi a legfontosabb minőségi különbség a Kézikönyvtár és a többi Arcanum-felület szövege között?
Válasz megjelenítése
A Kézikönyvtár anyaga kézi szedéssel készült és korrektúrázott, a többi felületé optikai karakterfelismeréssel. Ezért a Kézikönyvtárban a negatív találat erős jel arra, hogy tényleg nincs benne az adott kifejezés; az OCR-es felületeken a negatív találat sokkal gyengébb bizonyíték.
2. Melyik Kézikönyvtár-műhöz nyúlna, ha egy 19. századi szerző életrajzi adataira van szüksége – és melyikhez, ha egy eltűnt település nevét keresi?
Válasz megjelenítése
Életrajzi adathoz Szinnyei József Magyar írók élete és munkái vagy a Magyar életrajzi lexikon; eltűnt településhez a helységnévtárak – az 1913-as helységnévtár, a katonai felmérések helységnevei vagy Gyalay Mihály igazgatástörténeti helységnév-lexikona.
3. Mit talál meg az Arcanum Újságok lábjegyzet-keresése, amit a MATARKA és a Szaktárs nem?
Válasz megjelenítése
Azt, hogy kit hivatkoztak egy folyóiratcikkben. A MATARKA a cikkek címét indexeli, a Szaktárs könyvek szövegében keres; a lábjegyzet-mezővel viszont a magyar szakirodalom hivatkozási hálózatába lehet belelátni – különösen a régi évfolyamokban, amelyek nem kerültek be a modern idézettségi adatbázisokba.
4. Miért kell magyar szövegben csonkolással keresni?
Válasz megjelenítése
Három ok miatt: a magyar toldalékoló nyelv (a „filoxéra” nem találja meg a „filoxérát”), a régi szövegek ingadozó helyesírása, és az OCR felismerési hibái. Mindháromra ugyanaz a megoldás: a csonkolókarakter.
5. Ugyanaz a felület egyszerre kínál napilapot és tudományos folyóiratot. Miért probléma ez, és mi a megoldás?
Válasz megjelenítése
Mert a találati lista nem különbözteti meg őket, holott az egyik jellemzően forrás, a másik szakirodalom – és a kettőhöz más kritikai eszközök kellenek. A megoldás nem a felületen van: minden találatnál a kutatónak kell eldöntenie a saját kérdése alapján, milyen szerepben használja a dokumentumot.
Összefoglalás
Az Arcanum öt felülete együtt a magyar digitalizált szöveganyag gerincét adja, és mindegyik más dokumentumtípusra való: könyvre a Szaktárs, periodikumra az Újságok, segédkönyvre a Kézikönyvtár, térképre a Térképek, levéltári és múzeumi anyagra a Hungaricana. A keresőnyelv mind az ötön azonos, tehát egyszer kell megtanulni.
Szakirodalmi eszközként két dolog számít igazán. A Kézikönyvtár ingyenes és korrektúrázott: itt a negatív találat erős jel, és itt vannak azok a segédművek – életrajzi lexikonok, helységnévtárak, országleírások –, amelyekre a kutatás minden fázisában szükség van. Az Arcanum Újságok pedig nemcsak sajtót, hanem tudományos folyóiratokat is tartalmaz, méghozzá a lábjegyzeteikkel együtt kereshetően.
Egy technikai és egy módszertani tanulság. A technikai: magyar szövegben csonkolással keressen – a toldalékolás, a régi helyesírás és az OCR mind ezt kívánja. A módszertani: az a felület, amely egyszerre kínál napilapot és szakfolyóiratot, nem dönti el Ön helyett, hogy forrást vagy szakirodalmat talált. Ez a döntés a kutatási kérdésből következik, és a kutatóé marad – erről szól a következő rész Arcanum forrásgyűjteményei fejezete.
Kulcsfogalmak
Arcanum Kézikönyvtár – Az Arcanum ingyenes online gyűjteménye lexikonokból, szótárakból, helységnévtárakból és történeti alapművekből; szövege kézi szedésű és korrektúrázott.
Arcanum Újságok (ADT) – Magyarország legnagyobb digitális periodika-adatbázisa; a keresés díjtalan, a megjelenítés előfizetéses. Napilapok mellett tudományos folyóiratokat is tartalmaz.
korrektúrázott szöveg – Kézi szedéssel vagy utólagos emberi javítással készült digitális szöveg, szemben az OCR nyers kimenetével; itt a negatív találat erős bizonyíték.
csonkolás – Keresési fogás, amellyel a szótő után
tetszőleges karakterek állhatnak (*); magyar szövegben a
toldalékolás miatt szinte mindig szükséges.
távolsági operátor – Olyan keresőoperátor, amely két
szó közötti legnagyobb távolságot szabja meg (nW kötött,
nN szabad sorrenddel).
helységnévtár – Segédkönyv, amely rögzíti, hogy egy település mikor milyen néven és melyik közigazgatási egységben szerepelt; nélküle a történeti földrajzi adat értelmezhetetlen.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Az Arcanum Adatbázis Kiadó portáljainak saját ismertetői és súgóoldalai (arcanum.com, adt.arcanum.com, maps.arcanum.com), valamint a szerkesztő próbakeresései – elérve: 2026. 08. 21.
Ajánlott irodalom
- Ring Orsolya: Történeti források kiadása a digitális világban – lehetőségek és gyakorlat. Magyar Tudomány 186. (2025) 10. sz. 2039–2050. https://www.akjournals.com/view/journals/2065/186/10/article-p2039.xml
Linkek és eszközök
- Arcanum – https://www.arcanum.com/hu/ – elérve: 2026. 08. 21.
- Arcanum Újságok (ADT) – https://adt.arcanum.com/hu/ – elérve: 2026. 08. 21.
- Arcanum Kézikönyvtár – https://www.arcanum.com/hu/online-kiadvanyok/ – elérve: 2026. 08. 21.
- Arcanum Térképek – https://maps.arcanum.com/hu/ – elérve: 2026. 08. 21.
- Szaktárs – https://www.szaktars.hu/ – elérve: 2026. 08. 21.
- Hungaricana – https://hungaricana.hu/hu/ – elérve: 2026. 08. 21.
Hivatkozáskezelés: a Zotero
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 90 perc |
| Előfeltétel | Szakirodalomkeresés |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszköz alapadatai
| Eszköz neve | Zotero |
| URL | https://www.zotero.org/ |
| Üzemeltető | Corporation for Digital Scholarship |
| Hozzáférés | Ingyenes, nyílt forráskódú; asztali alkalmazás + böngészőbővítmény |
| Regisztráció | Nem kötelező, de a szinkronizáláshoz és a csoportkönyvtárakhoz szükséges |
| Tartalomtípus | Bibliográfiai adatok, csatolt fájlok (PDF, kép, hang), jegyzetek |
| Ingyenes tárhely | 300 MB online tárhely a szinkronizáláshoz |
Miről szól ez a fejezet?
Ebben a fejezetben a Zotero hivatkozáskezelő programmal ismerkedünk meg: telepítjük, létrehozzuk a könyvtárunkat, bibliográfiai adatokat viszünk be manuálisan és automatikusan, végül a szövegszerkesztőben lábjegyzetet és irodalomjegyzéket készítünk vele. A cél az, hogy a félév további részében – és a szakdolgozatában – ne kézzel gépelje be a hivatkozásait.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- önállóan telepíti a Zotero asztali alkalmazást, a böngészőbővítményt és a szövegszerkesztő-bővítményt, és beállítja a szinkronizálást;
- gyűjteményeket és algyűjteményeket hoz létre, és ezekbe rendezi a bibliográfiai tételeket;
- bibliográfiai adatokat rögzít háromféle módon: manuálisan, ISBN vagy DOI alapján, illetve böngészőből (Google Scholar) mentve;
- a szövegszerkesztőben lábjegyzetes hivatkozást szúr be, és automatikusan irodalomjegyzéket generál;
- felismeri és javítja a Google Scholarból importált tételek tipikus hibáit (ékezetek, vezeték- és keresztnév sorrendje, hiányzó adatok).
Bevezetés
Egy szemináriumi dolgozat húsz hivatkozásánál még elképzelhető, hogy kézzel gépeli be mindegyiket. Egy szakdolgozat kétszáz hivatkozásánál ez már nemcsak fárasztó, hanem hibaforrás is: elcsúszik a sorszámozás, kimarad egy tétel az irodalomjegyzékből, egy szerző neve háromféle alakban szerepel. A hivatkozáskezelő programok pontosan ezt a problémát oldják meg.
Mire használhatók a hivatkozáskezelők?
- Összegyűjthetjük velük a dokumentumok bibliográfiai adatait.
- Az összegyűjtött adatokat mappákba rendezhetjük és később visszakereshetjük.
- Az összegyűjtött adatokból bibliográfiát, irodalomjegyzéket készíthetünk.
- Tudományos munkánkban hivatkozásokat – szövegközi, lábjegyzet és végjegyzet formájában is – készíthetünk és menedzselhetünk velük.
- Csatolmányokat is tárolhatunk: szöveget, képet, videót stb.
Hivatkozáskezelő például az EndNote, a Zotero és a Mendeley. Ezek közül a kurzus keretében a Zotero használatával ismerkedünk meg.
Definíció Fogalom: hivatkozáskezelő rendszer
Olyan szoftver, amely a bibliográfiai adatok gyűjtésére, rendszerezésére és tárolására szolgál, és amely a szövegszerkesztővel együttműködve automatikusan generálja a szövegközi hivatkozásokat, a lábjegyzeteket és az irodalomjegyzéket a kiválasztott hivatkozási stílus szerint.
A Zotero ingyenes, böngészőfüggetlen, online és offline is használható hivatkozáskezelő, amely rendelkezik szövegszerkesztőbe és böngészőbe épülő bővítménnyel (plug-in). A Zotero 300 MB online tárhelyet biztosít az adatok több számítógép közötti szinkronizálásához.
Használatával egy kattintással elintézhető a különböző irodalmak bibliográfiai adatainak lementése, és egyszerűsödik a tanulmányok szerkesztésekor a hivatkozások kezelése. A program használatával nem nekünk kell bevinni az egyes hivatkozásokat; emellett a hivatkozások sorszámozása és az irodalomjegyzék összeállítása is automatikusan történik.
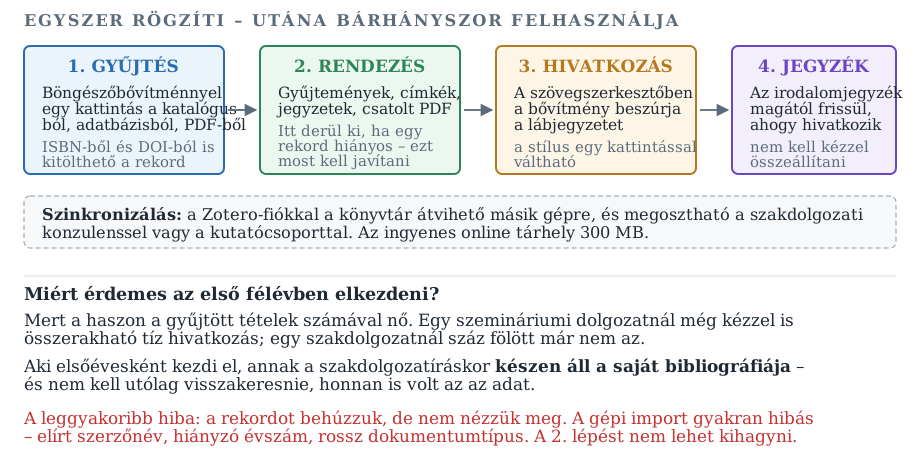
1. A Zotero letöltése és telepítése
A Zotero használatához egyrészt a számítógépünkre letöltött programra, másrészt a szövegszerkesztőbe és a böngészőbe beépülő bővítményekre van szükségünk. A letöltéshez látogassunk el a https://www.zotero.org/download/ oldalra.
A letöltőfelület felismeri a számítógépünk operációs rendszerét és a használt böngészőt is, így az ezekhez megfelelő bővítményeket ajánlja fel. Töltsük le mind a Windows- vagy macOS-változatot, mind a böngészőbővítményt.
1.1 A böngészőbővítmény letöltése
A böngészőbővítmény letöltésekor egy felugró ablakban engedélyeznünk kell annak telepítését. Kövessük a felugró ablakok utasításait, és adjuk hozzá a bővítményt.
A későbbiekben szükség esetén a böngésző „Kiegészítők” ikonjára kattintva kezelhetjük a letelepített bővítményt.
1.2 Online Zotero-fiók regisztrálása
A letöltés után célszerű egy online Zotero-fiókot is regisztrálnunk, mivel ez 300 MB ingyenes tárhelyet biztosít számunkra, így más számítógépről is elérhetjük az adatainkat. Az online felület emellett együttműködési lehetőséget is biztosít: ha többen közösen dolgozunk egy kutatáson, a hivatkozáslistát közösen is építhetjük és kezelhetjük.
Figyelem Fontos, hogy létező e-mail-címmel regisztráljunk, mert befejező lépésként az e-mail-fiókunkban meg kell erősítenünk a regisztrációnkat.
Ezt követően a zotero.org felületén belépve, majd a
menüsávban a Web Library menüpontra kattintva láthatjuk
a felhőbe szinkronizált mappáinkat.
1.3 A Zotero program telepítése
A Zotero programot a számítógépünkön a „Letöltések” között található setup fájlra kattintva és annak utasításait végrehajtva telepíthetjük. A beállítás során célszerű a „Standard” lehetőséget kiválasztani. Ezzel le is telepítettük a Zoterót a számítógépünkre.
1.4 A szövegszerkesztő-bővítmény telepítése
A Zotero bővítményt a szövegszerkesztőbe az alábbi módon telepíthetjük:
- A Zotero programon belül a Szerkesztés, majd a Beállítások menüpontra kattintunk.
- Ezután a Hivatkozás menüben a Szövegszerkesztők almenüben tudjuk kiválasztani, hogy mely szövegszerkesztőbe szeretnénk elvégezni a telepítést.
Tipp A telepítés során célszerű bepipálni „A klasszikus Add Citation ablak” jelölőnégyzetet, mert így a hivatkozások beszúrásakor egy felugró ablakból választhatjuk ki azokat – ez sokkal áttekinthetőbb, mint a gyorskeresős megoldás.
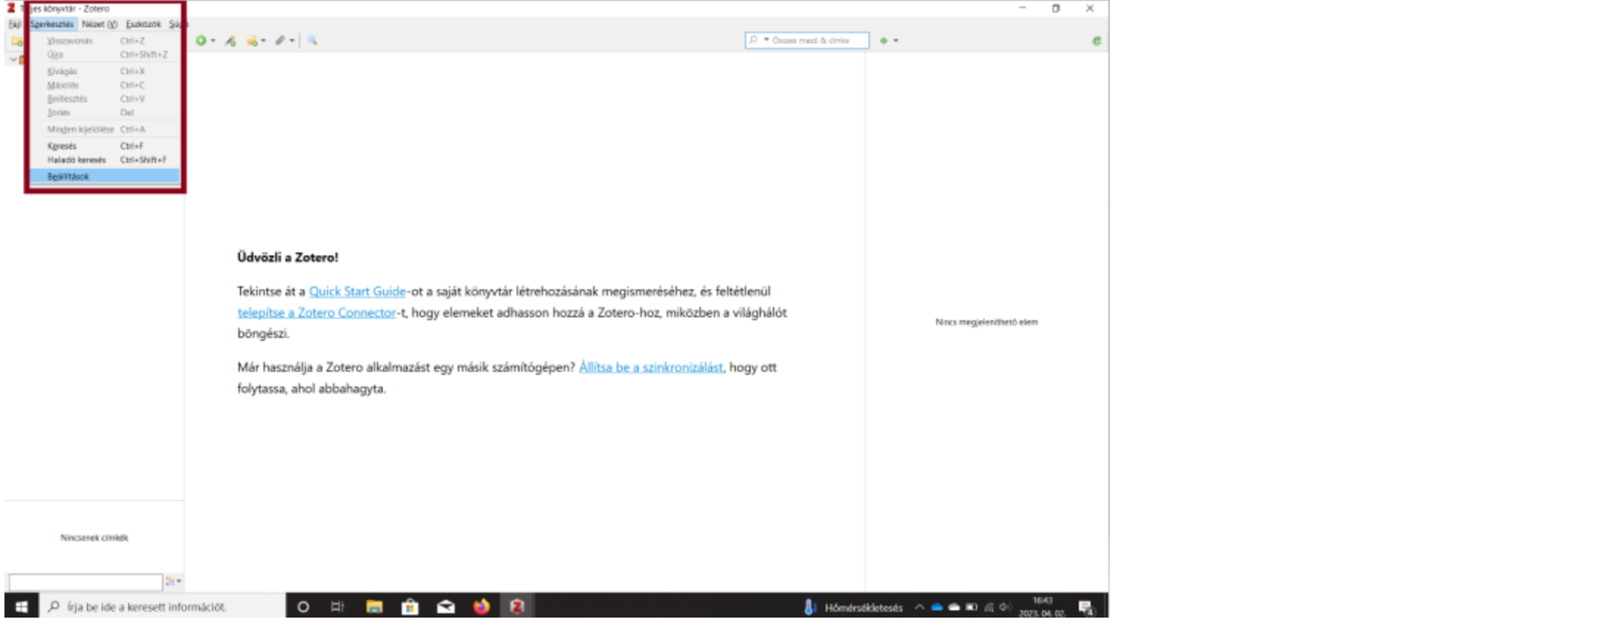
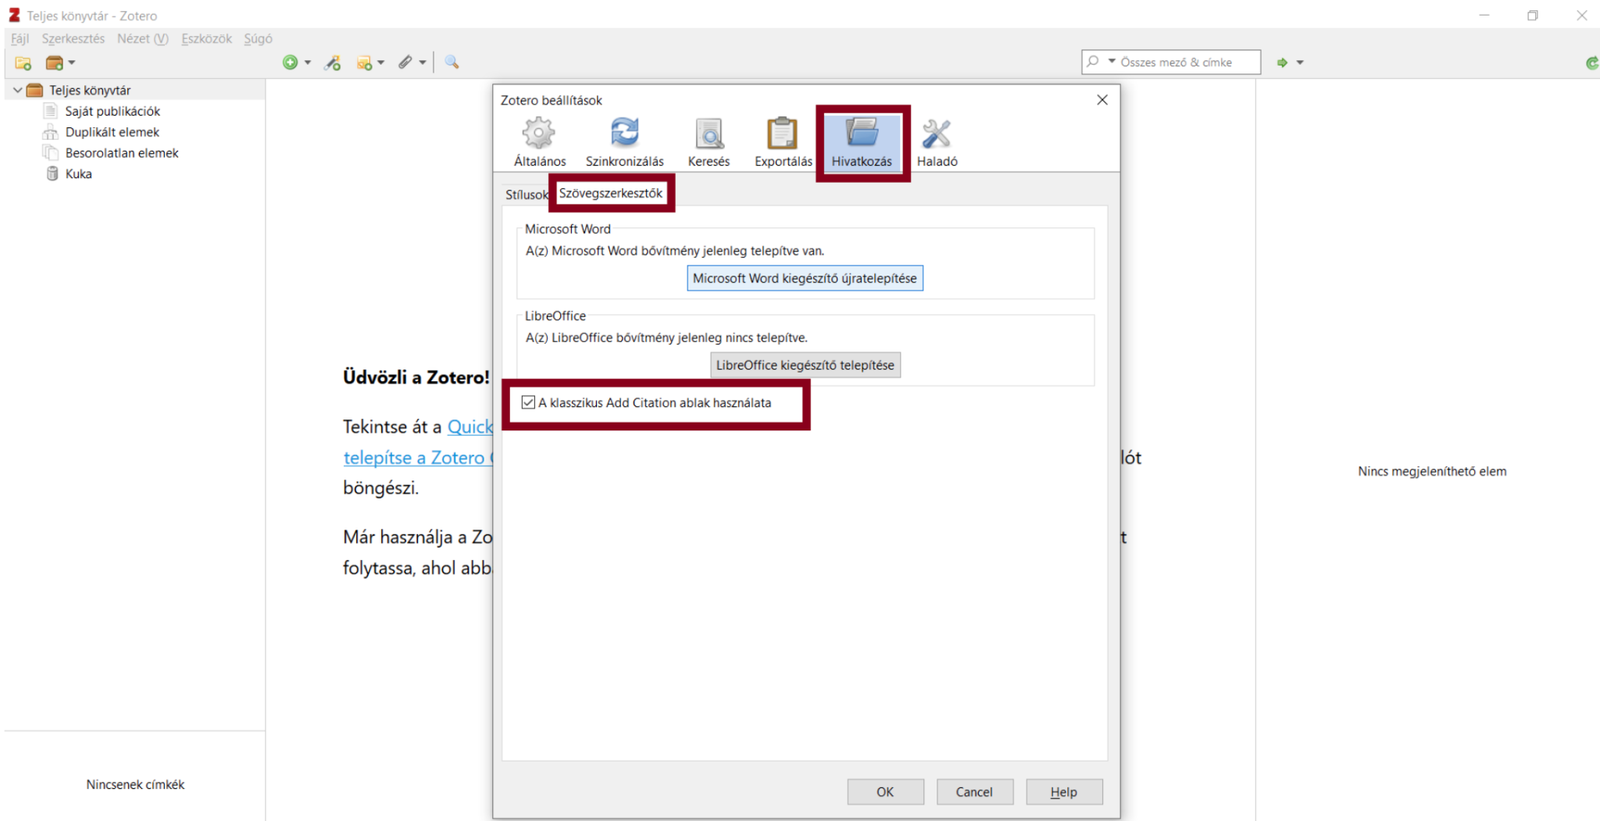
A telepítés után a szövegszerkesztőben önálló Zotero eszköztár jön létre.
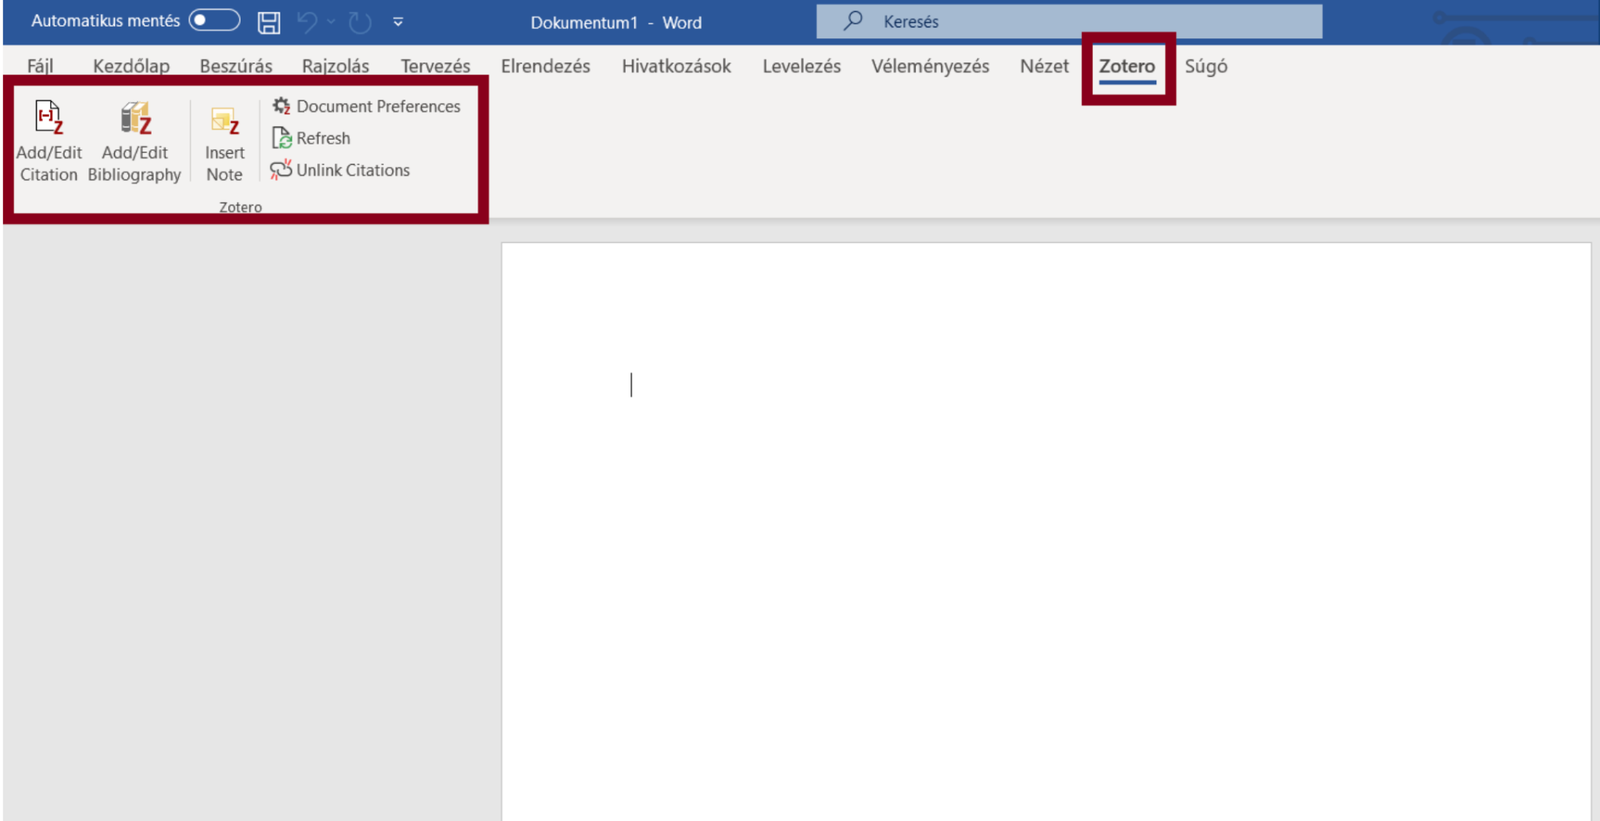
1.5 A szinkronizálás beállítása
Ahhoz, hogy a Zotero programban vagy az online felületen gyűjtött hivatkozásainkat több számítógépen vagy másokkal együttműködésben használhassuk, szükséges, hogy beállítsuk a szinkronizálást.
Ehhez nyissuk meg a Zotero programot, majd a Szerkesztés menü Beállítások almenüjében válasszuk a Szinkronizálás ikont. Adjuk meg az online regisztráció során használt felhasználónevünket és jelszavunkat, majd kattintsunk a szinkronizálás beállítására. Ezt követően a Zotero automatikusan szinkronizálja a könyvtárainkban történő változásokat.
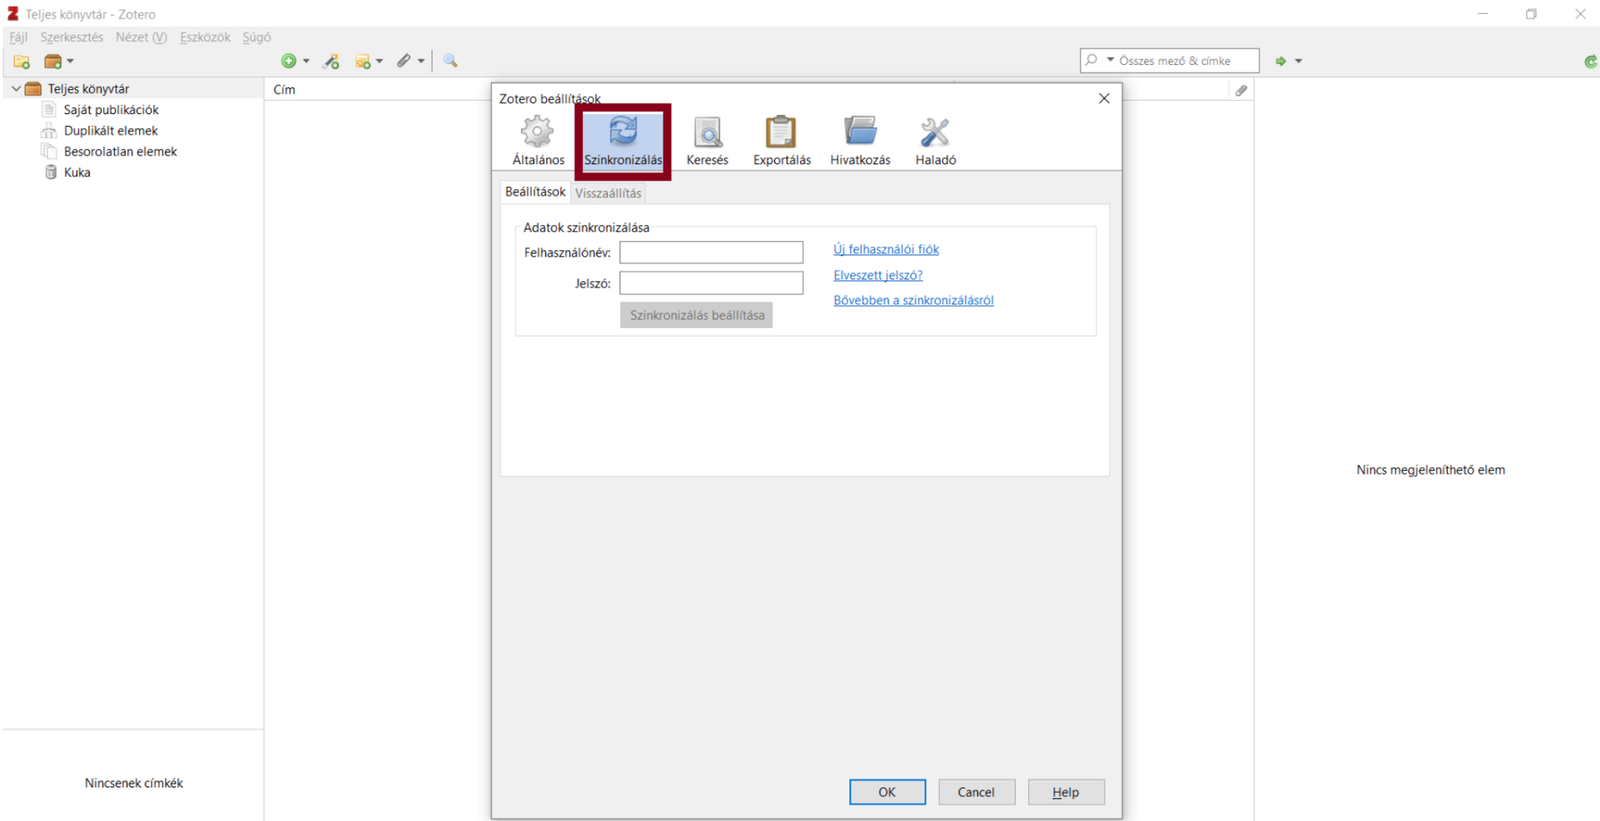
2. Bibliográfiai adatok elhelyezése a Zotero-könyvtárban
A Zotero-könyvtárunk felépítése hasonló a számítógép fájlkezelőjéhez. A könyvtáron belül létrehozhatunk gyűjteményeket és algyűjteményeket, amelyekben elhelyezhetjük a felhasznált irodalmak bibliográfiai adatait, de besorolás nélkül is felvehetünk elemeket, amelyeket majd később kategorizálunk.
Gyűjtemény létrehozásához kattintsunk a sárga mappa ikonra, majd nevezzük el a gyűjteményünket. Az egér jobb gombjával a gyűjtemény nevére kattintva létrehozhatunk algyűjteményt, átnevezhetjük, esetleg törölhetjük a gyűjteményünket.
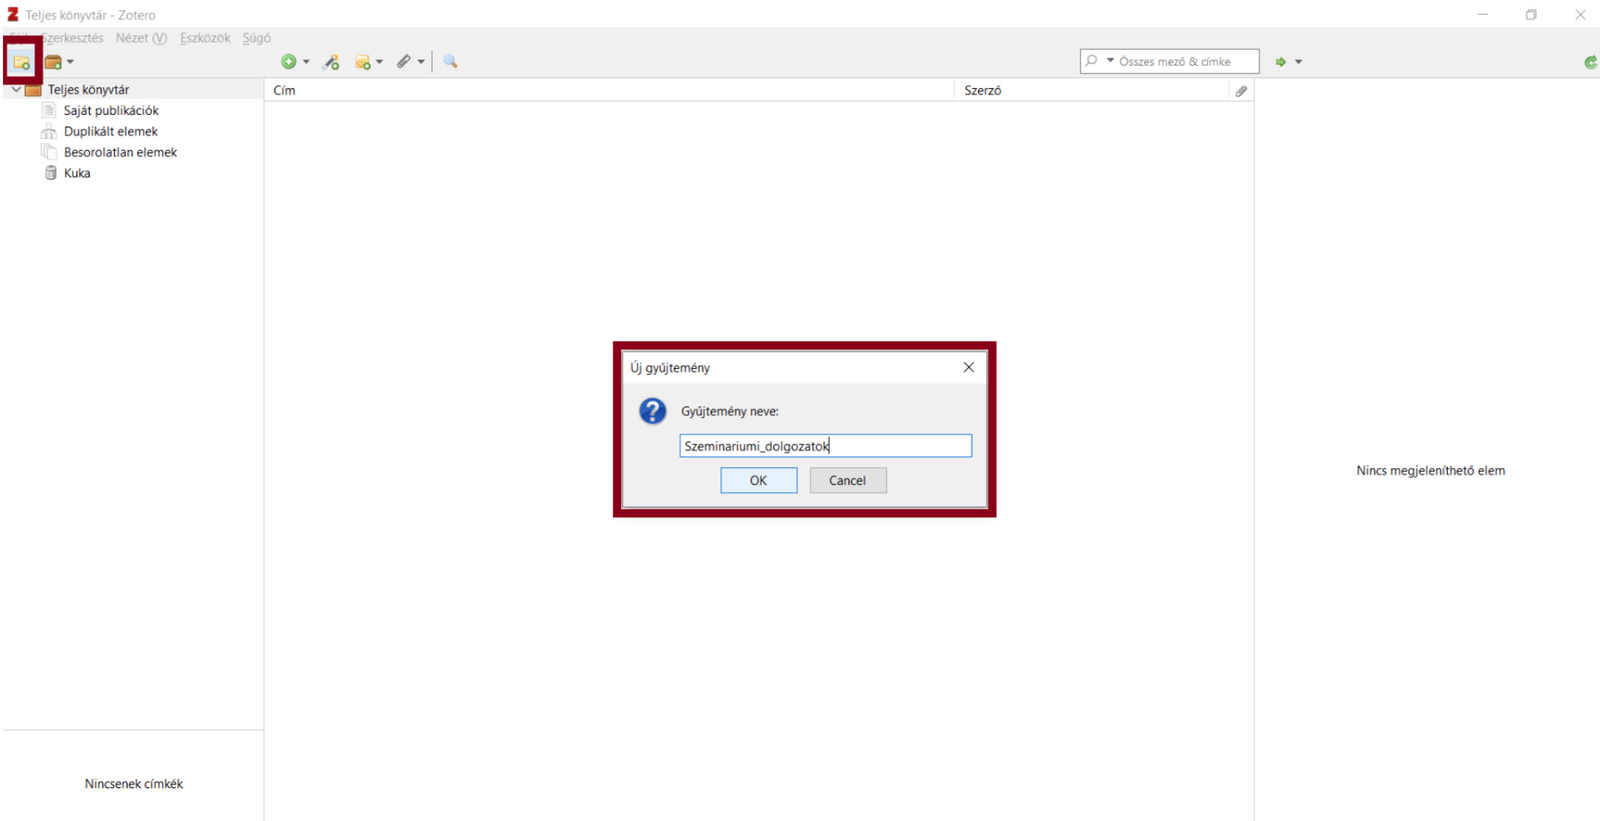
Definíció Fogalom: gyűjtemény (collection)
A Zoteróban tematikus mappa, amellyel a bibliográfiai tételek rendszerezhetők. Egy tétel több gyűjteményben is szerepelhet – a gyűjtemények nem másolatot, hanem hivatkozást tartalmaznak ugyanarra a tételre.
2.1 Manuális felvitel
A bibliográfiai adatok elhelyezésére több lehetőségünk is van. Egyrészt felvehetjük azokat manuálisan. Ebben az esetben azt a gyűjteményt kijelölve, ahová az elemet menteni szeretnénk, a felső menüsor Fájl menüjére kattintva, majd az Új elem almenüpontot választva megadhatjuk, hogy milyen típusú adatot (könyv, folyóiratcikk, tanulmánykötetben megjelent tanulmány stb.) szeretnénk rögzíteni.
Figyelem A típus kiválasztásánál járjunk el gondosan, mert a hivatkozások készítésénél a Zotero ezt az információt használja a hivatkozás egyes elemeinek megfelelő megjelenítéséhez. Ha egy tanulmánykötetben megjelent tanulmányt „könyvként” rögzít, a lábjegyzet formátuma hibás lesz.
A megjelenő adatlapon rögzíthetjük az adott könyv vagy tanulmány bibliográfiai adatait. Itt nem szükséges valamennyi mezőt kitölteni, csak azokat, amelyekre az általunk használt hivatkozási rendszerben szükség van. Az Info fül mellett található Jegyzetek fül pedig arra ad lehetőséget, hogy az adott művel kapcsolatosan saját jegyzeteket is elmentsünk magunknak.
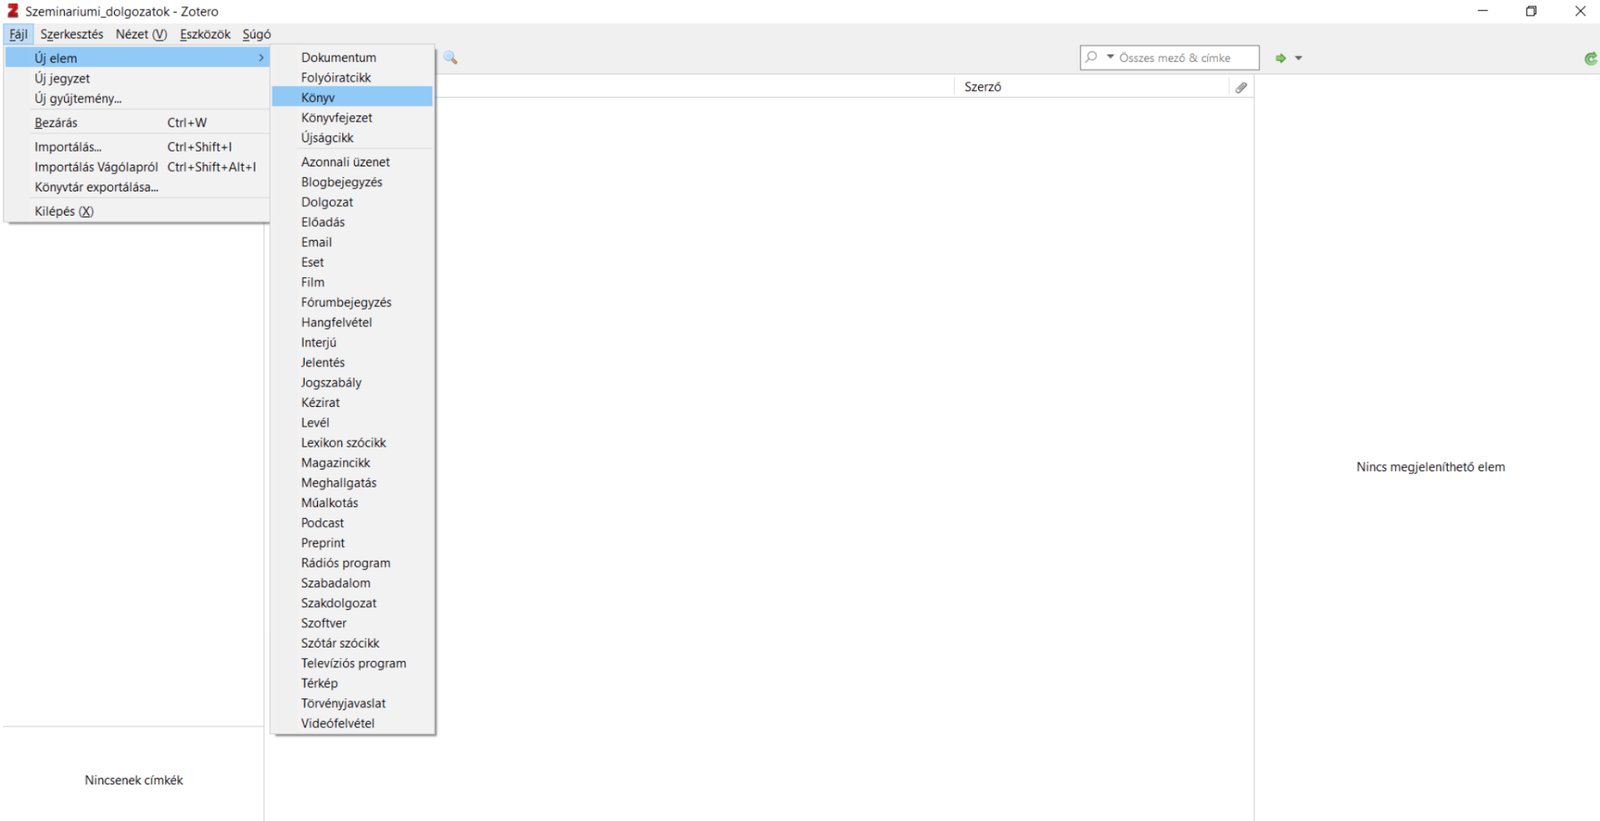
2.2 Felvitel ISBN vagy DOI alapján
A Zotero arra is lehetőséget biztosít, hogy amennyiben ismerjük egy könyv ISBN-számát vagy egy tanulmány DOI-azonosítóját, akkor internetkapcsolat mellett – arra rákeresve – annak adatai automatikusan bekerüljenek a gyűjteményünkbe. (Az ISBN-ről és a DOI-ról részletesen lásd a Szerzői és dokumentumazonosítók fejezetet.)
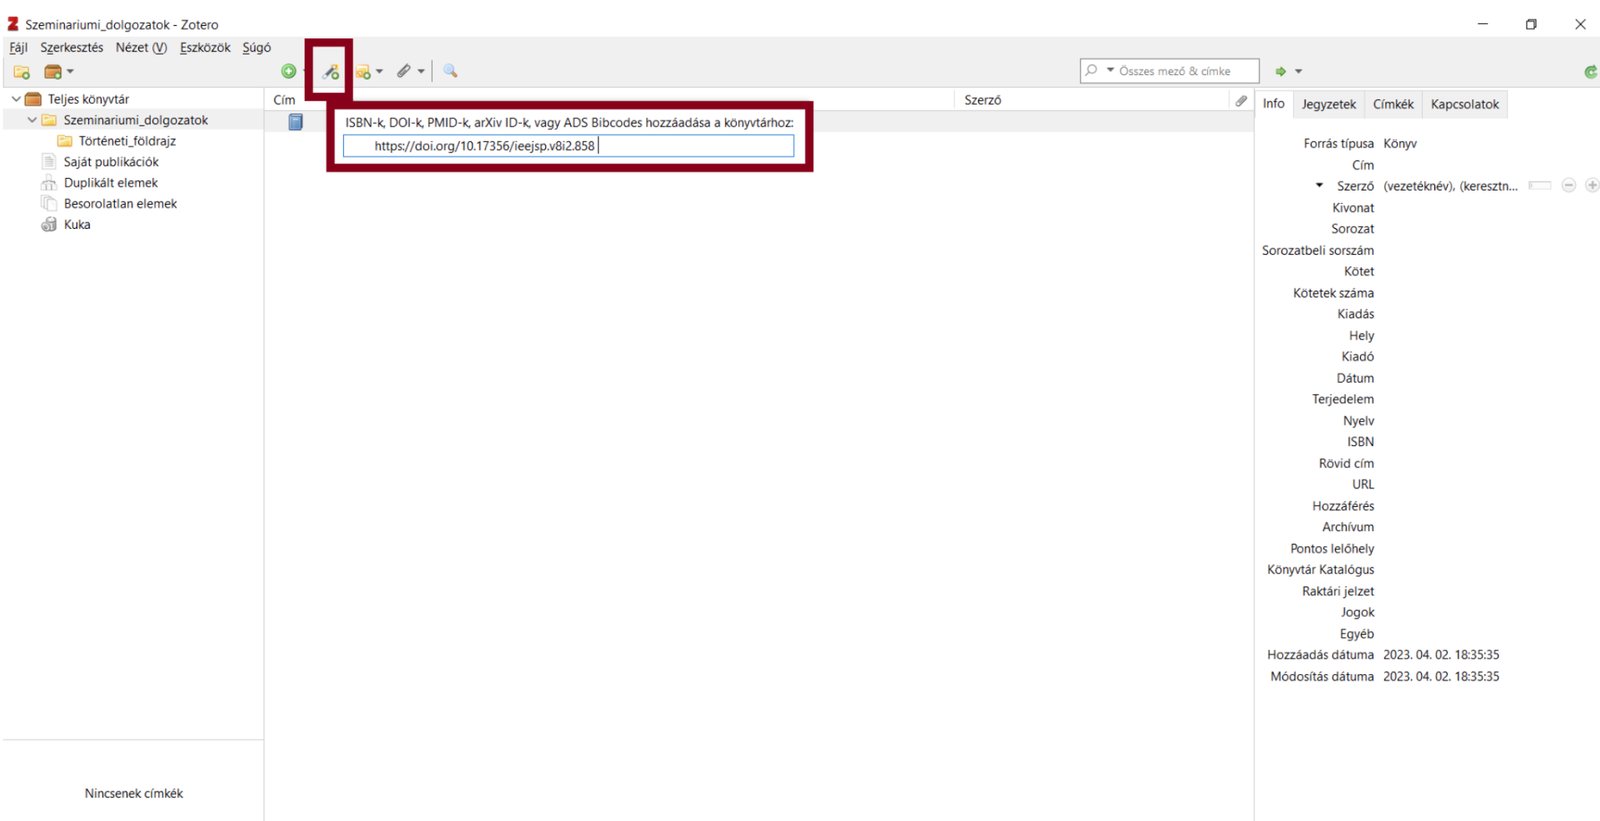
2.3 Import a Google Scholarból
A másik automatikus lehetőség, ha az adatokat a Google Scholar felületéről importáljuk a gyűjteményünkbe. Ehhez először indítsuk el a Zotero programot a számítógépen, majd a Google Scholar felületén írjuk be a keresett szerző nevét vagy a mű címét, és végezzük el a keresést.
Ezt követően kattintsunk a Save to Zotero ikonra, majd pipáljuk be azt a tételt, amelyet menteni szeretnénk, és kattintsunk az OK gombra. A felugró ablakban kiválaszthatjuk, melyik Zotero-mappába szeretnénk menteni az adott tételt.
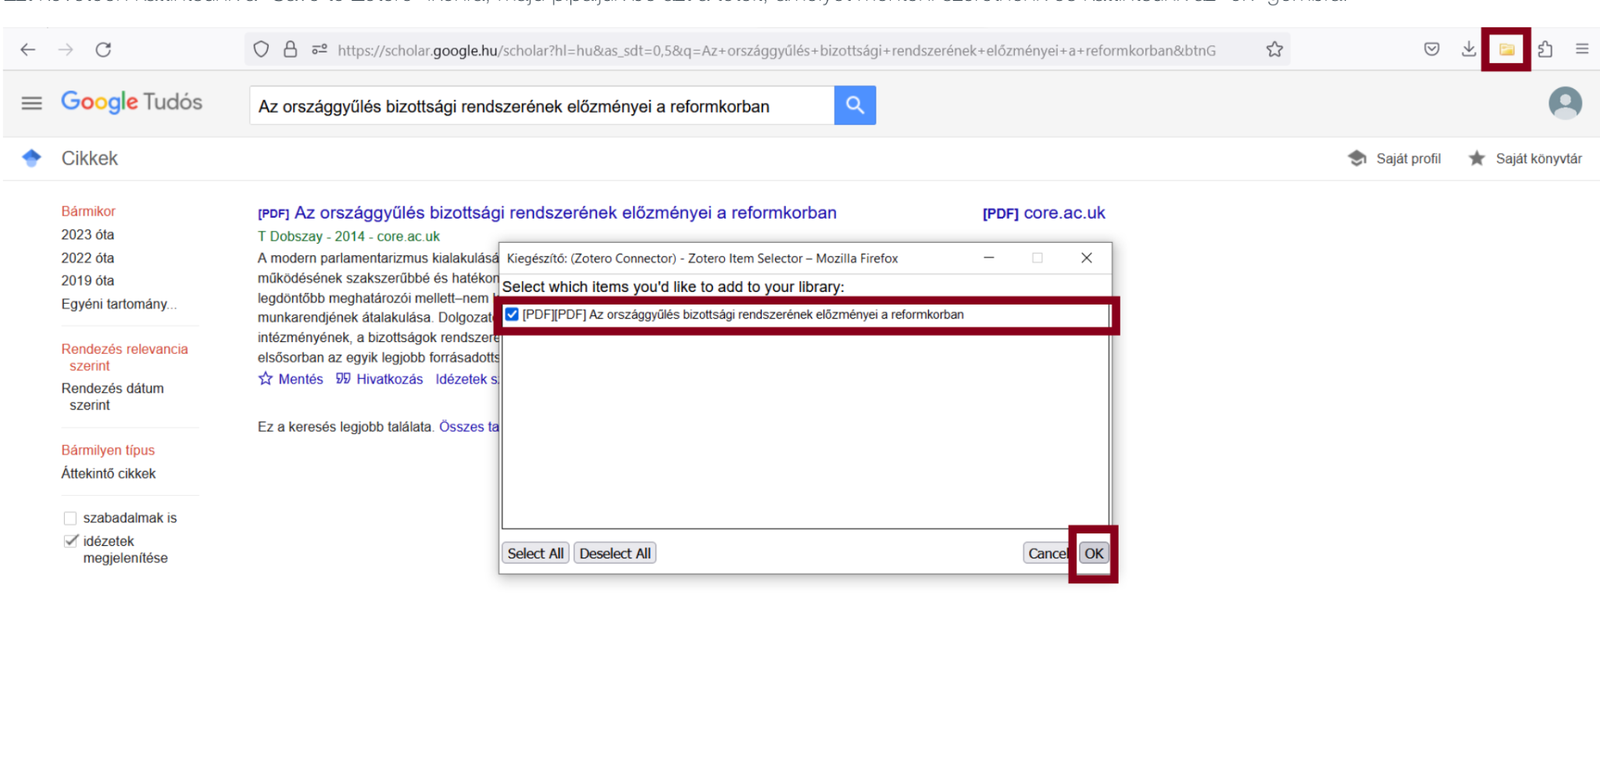
Figyelem Az importált adatokat mindig ellenőrizze!
A Zotero felületére visszatérve láthatjuk, hogy néhány ékezetes karakter hibásan importálódott – ezeket manuálisan javíthatjuk. Ugyanezt a javítást kell elvégeznünk, ha a szerzők nevei rossz vezetéknév/keresztnév sorrendben kerültek rögzítésre a Google Scholarban, és így rosszul importálódtak. Ezen felül szükség esetén az adatokat is kiegészíthetjük az adott elem információs lapján.
Ha a Google Scholar felületén linkelt PDF-tartalom is volt, az szintén bekerül a gyűjteményünkbe. Ezt a PDF-et a mű címére kattintva hívhatjuk elő, és külön lapfülön nyílik meg.
3. A Zotero használata szövegszerkesztőben
Dolgozat vagy publikáció készítése közben a szövegszerkesztő mellett nyissuk meg a Zotero programot is a számítógépünkön. Álljunk oda a kurzorral, ahol hivatkozást szeretnénk elhelyezni a szövegben. Ezt követően kattintsunk a Zotero menüre, majd az Add/Edit Citation almenüre.
A felugró ablakban adjuk meg a szükséges beállításokat: a hivatkozás stílusát, nyelvét, illetve azt, hogy a hivatkozásainkat automatikusan szeretnénk-e frissíteni. Emellett azt is állítsuk be, hogy lábjegyzeteket vagy végjegyzeteket szeretnénk-e használni. Ezt természetesen csak egy dokumentum első hivatkozásánál szükséges megtennünk; emellett fontos tudni, hogy ezek a beállítások később módosíthatók.
A leggyakrabban használt hivatkozási stílusokat alapértelmezetten megtaláljuk a Zotero stíluslistájában. Ha más stílust szeretnénk használni, a stílusok kezelése menüre kattintva további stílusokat importálhatunk. Arra is lehetőségünk van, hogy egy Zotero-stílusfájlt letöltve – például egy folyóirat honlapjáról – importáljuk azt.
Tipp A magyar történettudományi munkák nagyrészt lábjegyzetes hivatkozási módot (és nem szövegközi jegyzeteket) használnak a szövegben, teljes irodalomjegyzéket pedig a dolgozat, tanulmány vagy kötet végén tüntetik fel. A Zoteróban ezért mindenképpen a lábjegyzet opciót válassza. Az így kapott eredményt azután az előírt formátumra kell finomítani.
Miután ezeket az adatokat megadtuk, a felugró ablakba kezdjük el beírni a keresett hivatkozás adatait (például a szerző nevét), majd a felajánlott lehetőségekből válasszuk ki a megfelelő tételt. Miután ez megtörtént, arra is lehetőségünk van, hogy ugyanahhoz a jegyzethez több vagy később újabb hivatkozást helyezzünk el.
Ha a dolgozat végére értünk, és el szeretnénk készíteni annak hivatkozáslistáját, nincs más dolgunk, mint az Add/Edit Bibliography gombra kattintani, és a Zotero automatikusan létrehozza a beállított stílusú bibliográfiát.
Ha a létrehozott bibliográfiában vagy a hivatkozásokban kisebb módosításokat szeretnénk tenni, azt megtehetjük: kicserélhetünk írásjeleket, javíthatunk elírásokat.
Gyakorlati feladat
Feladat 1. feladat – Saját Zotero-könyvtár felépítése
Telepítse a Zoterót, a böngészőbővítményt és a szövegszerkesztő-bővítményt, és állítsa be a szinkronizálást.
Hozzon létre egy gyűjteményt a saját szemináriumi témájának nevével, és benne két algyűjteményt: „Források” és „Szakirodalom”.
Vigyen fel hat tételt, mindhárom módszerrel kettőt-kettőt: manuálisan; ISBN vagy DOI alapján; a Google Scholarból mentve.
Ellenőrizze és javítsa az importált tételek adatait (ékezetek, névsorrend, dokumentumtípus).
Egy üres dokumentumban szúrjon be három lábjegyzetes hivatkozást, majd generálja le az irodalomjegyzéket.
Elvárt formátum: a kész dokumentum (DOCX vagy PDF), valamint egy képernyőkép a Zotero-könyvtár szerkezetéről.
Feladat 2. feladat – Hibakeresés
Mentsen le a Google Scholarból egy magyar szerzőtől származó, ékezetes címmel rendelkező tanulmányt. Hasonlítsa össze a Zoteróba importált adatokat az eredeti megjelenés adataival (folyóirat honlapja vagy MTMT).
Készítsen táblázatot arról, mely mezőkben talált eltérést, és mi volt a hiba típusa (hiányzó adat, karakterhiba, rossz névsorrend, rossz dokumentumtípus).
Elvárt formátum: táblázat + két-három mondatos tanulság.
Önellenőrző kérdések
1. Mi a hivatkozáskezelő rendszer fő célja?
Válasz megjelenítése
A bibliográfiai adatok rendszerezése, valamint a hivatkozások és az irodalomjegyzék automatikus generálása a választott stílus szerint.
2. Igaz-e, hogy a Zotero csak online, internetkapcsolattal használható?
Válasz megjelenítése
Nem. A Zotero telepíthető asztali alkalmazás, offline is működik; az internetkapcsolat a szinkronizáláshoz, az ISBN/DOI alapú felvitelhez és a böngészőből mentéshez kell.
3. Hogyan lehet bibliográfiai adatokat gyűjteni a Zoteróba böngészés közben?
Válasz megjelenítése
A Zotero böngészőbővítményével (Zotero Connector): a találati oldalon a Save to Zotero ikonra kattintva, majd a menteni kívánt tételt kijelölve és a célgyűjteményt megadva.
4. Miért fontos a dokumentumtípus helyes megadása?
Válasz megjelenítése
Mert a Zotero ez alapján állítja össze a hivatkozás elemeit. Rossz típusnál (pl. tanulmánykötetbeli tanulmány „könyvként”) a lábjegyzet és az irodalomjegyzék formátuma is hibás lesz.
5. Mit érdemes ellenőrizni egy Google Scholarból importált tételnél?
Válasz megjelenítése
Az ékezetes karaktereket, a szerzők vezeték- és keresztnevének sorrendjét, a dokumentumtípust, valamint a hiányzó megjelenési adatokat (kiadó, hely, oldalszám).
Összefoglalás
Ebben a fejezetben telepítettük és beállítottuk a Zoterót, létrehoztuk a saját könyvtárszerkezetünket, és háromféle módon vittünk fel bibliográfiai adatokat: manuálisan, azonosító (ISBN, DOI) alapján, valamint böngészőből mentve. Láttuk, hogy az automatikus import kényelmes, de mindig ellenőrzést igényel. Végül a szövegszerkesztőben lábjegyzetes hivatkozásokat szúrtunk be, és automatikusan generáltunk irodalomjegyzéket.
A Zotero a kurzus egészében használható: minden további fejezetben, amikor egy adatbázisban találatot talál, azonnal rögzítse a tételt – így a félév végére készen áll egy karbantartott, saját bibliográfiája.
Kulcsfogalmak
algyűjtemény – Gyűjteményen belüli mappa a Zoteróban, a tételek finomabb tematikus bontására.
gyűjtemény (collection) – Tematikus mappa a Zoteróban a bibliográfiai tételek rendszerezésére.
hivatkozáskezelő rendszer – Szoftver, amely bibliográfiai adatokat gyűjt és rendszerez, és a szövegszerkesztővel együttműködve automatikusan generálja a hivatkozásokat és az irodalomjegyzéket.
hivatkozási stílus – Formai szabályrendszer, amely meghatározza a hivatkozások és az irodalomjegyzék felépítését (pl. Korall, APA, Chicago).
Zotero Connector – A Zotero böngészőbővítménye, amellyel egy kattintással menthetők a webes felületeken talált tételek bibliográfiai adatai.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Zotero – a program saját dokumentációja és súgója. https://www.zotero.org/support/ (elérve: 2026. 08. 20.)
Linkek és eszközök
- Zotero – https://www.zotero.org/ – elérve: 2026. 08. 20.
- Zotero letöltés – https://www.zotero.org/download/ – elérve: 2026. 08. 20.
- Google Scholar – https://scholar.google.hu/ – elérve: 2026. 08. 20.
Mi a forrás?
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 90 perc |
| Előfeltétel | Hogyan épül fel egy történeti kutatás?, Szakirodalomkeresés |
| Verzió / dátum | v0.1 / 2026. augusztus |
Miről szól ez a fejezet?
Ez a fejezet tisztázza a történeti kutatás egyik alapfogalmát: a forrás fogalmát. Megnézzük, mit ért a történész forráson, miben különbözik a forrás a szakirodalomtól, hogyan osztályozzuk a forrásokat, és mit jelent mindez a digitális korban, amikor a forrás többnyire egy közvetítő rétegen – egy digitalizált változaton vagy egy adatbázis-rekordon – keresztül kerül elénk. A fejezet anyaga a tankönyv további részeinek (forráskezelő eszközök, digitális adatbázisok, OCR, MI-eszközök) fogalmi alapját adja.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- meghatározza, mit ért a forrás fogalmán a történeti kutatás, és megkülönbözteti a forrást a feldolgozó szakirodalomtól;
- egy adott történeti dokumentumról eldönti, hogy elsődleges, másodlagos vagy harmadlagos forrásnak tekinthető-e a saját kutatási kérdése szempontjából, és érvel a besorolása mellett;
- felismeri a digitalizált és a born-digital források közötti különbségeket, és tudja, milyen kérdéseket kell feltennie egy digitális közvetítésű forrással szemben;
- a forráskritika alapfogalmait – külső kritika, belső kritika, autopszia, reprezentativitás – egy konkrét forrásra alkalmazva használja;
- elhelyezi a digitalizálási és OCR-folyamatot mint új forráskritikai szempontot a hagyományos forráskritika kontextusában.
Bevezetés
Képzelje el, hogy a következő helyzetben találja magát. Egy szemináriumi dolgozaton dolgozik az 1848-as forradalom vidéki visszhangjáról. A könyvtárban kezébe akad egy 1898-ban megjelent monográfia, amely részletesen tárgyalja az eseményeket; az interneten talál egy 2010-es szakcikket; a Hungaricanán előhúz egy 1848-as helyi újságcikket; egy másik adatbázisban talál egy korabeli rendelet betűhű átiratát; és találkozik egy 21. századi Wikipédia-szócikkel. Melyikre alapozhatja a dolgozatát? Mi közöttük a különbség? Mit jelent egyáltalán, hogy az egyik „elsődleges forrás”, a másik „szakirodalom”, a harmadik valami közöttes?
Ez a fejezet azt mutatja meg, hogyan gondolkodjon a forrásairól. Nem újdonságot tár fel – a forrás fogalma a történetírás 19. századi szakmává válása óta a központi módszertani kérdés. De a digitális korban a forrás fogalma új rétegekkel egészült ki: az eredeti dokumentum és Ön között egy közvetítő réteg (digitalizálás, OCR, adatbázis-szerkesztés) is áll, és ez a réteg új típusú forráskritikai kérdéseket vet fel.
A fejezet négy részre oszlik. Először a forrás fogalmát tisztázzuk, és elhatároljuk a szakirodalomtól. Másodszor a klasszikus tipológiát (elsődleges, másodlagos, harmadlagos forrás) tárgyaljuk, hangsúlyozva, hogy a besorolás kontextusfüggő. Harmadszor megnézzük, mit jelent mindez a digitális korban. Negyedszer a forráskritika alapfogalmait elevenítjük fel, és kibővítjük a digitális közvetítésre vonatkozó szempontokkal.
1. A forrás fogalmának meghatározása
A történeti kutatásban a forrás minden olyan dokumentum, tárgy vagy emlék, amely a múltról közvetlen vagy közvetett információt hordoz, és amelynek alapján a történész következtetéseket vonhat le.1 Ez a definíció szándékosan tág. Forrás lehet egy oklevél, egy levéltári akta, egy újságcikk, egy fénykép, egy közhasználati tárgy, egy épületmaradvány, egy szóbeli visszaemlékezés, egy hivatali napló, egy népdal – bármi, amit a múlt rajta hagyott a jelenen.
A fontos azonban nem a forrás formátuma vagy típusa, hanem a viszonya a kutatási kérdéshez. Egy forrás akkor forrás, ha a kérdéshez érdemi információt tartalmaz, és ha a történész képes ezt az információt kritikai eszközökkel kibontani. A fenti tárgyak közül egyik sem önmagában „forrás”: forrássá akkor válnak, amikor egy konkrét kérdéssel közeledünk hozzájuk. Egy 18. századi anyakönyvi bejegyzés forrás, ha demográfiai kérdést kutatunk; egy konkrét lakos életét vagy egy adott pap kéziratára jellemző jelölésrendszert is feltárhatunk belőle – más-más kérdés mellett ugyanaz a dokumentum más szerepet kap.
Ez a relacionális, kérdéshez kötött felfogás a modern történetírás egyik alapeszméje. A 19. században a források inkább a múlt „nyomaiként” jelentek meg, amelyeket a történész feltár és „beszéltet”; a 20. századtól, különösen a francia Annales-iskola hatására, a hangsúly egyre inkább arra terelődött, hogy a forrás nem önmagában „beszél”, hanem a történész kérdésén keresztül szólal meg. A két felfogás nem zárja ki egymást; a modern gyakorlatban együtt élnek.
Definíció Fogalom: forrás
A történeti kutatásban minden olyan dokumentum, tárgy vagy emlék, amely a múltról közvetlen vagy közvetett információt hordoz, és amelynek alapján a történész – kritikai eszközökkel – következtetéseket vonhat le a múltra vonatkozóan. A forrásként való azonosítás kérdésfüggő: ugyanaz a dokumentum más kutatási kérdésnél más szerepet kap.
1.1 Forrás és szakirodalom
A forrás fogalma akkor válik élesen elhatárolhatóvá, ha szembeállítjuk a szakirodalommal. A szakirodalom (vagy: feldolgozó irodalom) olyan írott munka, amelyet egy későbbi szerző készített arról, amit a forrásokban talált. A szakirodalom maga is forrás lehet, ha a kutatási kérdésünk éppen a szerző munkájára vagy a szerzőjét körülvevő tudományos kontextusra vonatkozik – de tipikusan nem így használjuk.
A megkülönböztetés gyakorlati jelentősége az, hogy a két típushoz másfajta kritikai eszközöket kell alkalmaznunk. A forrással szemben a fő kérdés: miről árulkodik az általa fennmaradt információ a múltról, és mi torzítja azt? A szakirodalommal szemben a fő kérdés: a szerző milyen forrásokra támaszkodott, milyen módszerrel dolgozott, hogyan értelmezte az anyagát, és mi a viszonyom az ő értelmezésével?
Egy konkrét példán szemléltetve: ha az 1848-as forradalomról ír dolgozatot, akkor egy 1898-as monográfia szakirodalom (egy korabeli történész feldolgozása). Egy 1848-ban megjelent korabeli újságcikk azonban forrás – a kortárs észlelés és közvélemény fennmaradt nyoma. Még akkor is, ha az újságcikk maga is interpretáció (a szerkesztő szemszöge), forrás abban az értelemben, hogy közvetlenül a vizsgált korból származik.
Figyelem Tipikus hiba: a határvonalak elmosása
Kezdő kutatóknál gyakori, hogy a szakirodalmat forrásként idézik („mert régi”, vagy „mert egy könyvben láttam”). Egy 1898-as monográfia nem azonos egy 1848-as oklevéllel csak azért, mert mindkettő „régi”. Ha a kérdés a 19. század végi történetírásra vonatkozik, akkor a monográfia is lehet forrás – de ez kivétel, és tudatos választás eredménye, nem a hivatkozás kényelmes rövidítése.
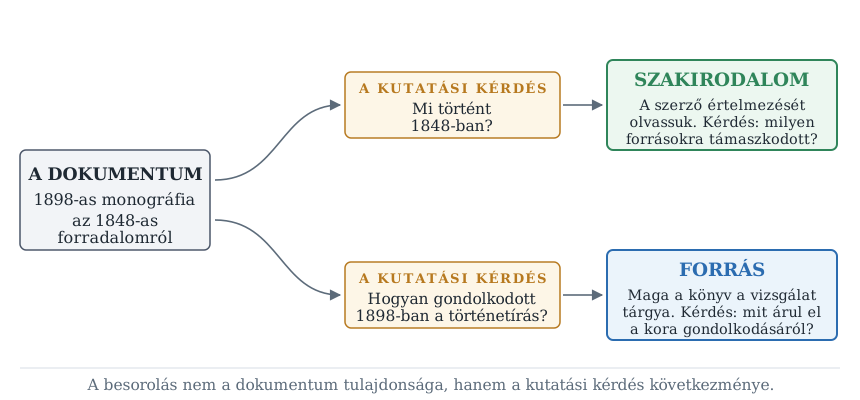
2. Források típusai: elsődleges, másodlagos, harmadlagos
A források klasszikus tipológiája három fokozatot különböztet meg attól függően, hogy a forrás milyen távolságra áll a vizsgált eseménytől vagy jelenségtől.2 A felosztás nem szabálykönyv, hanem orientáló keret, amely segít a forráskezelési stratégia kialakításában.
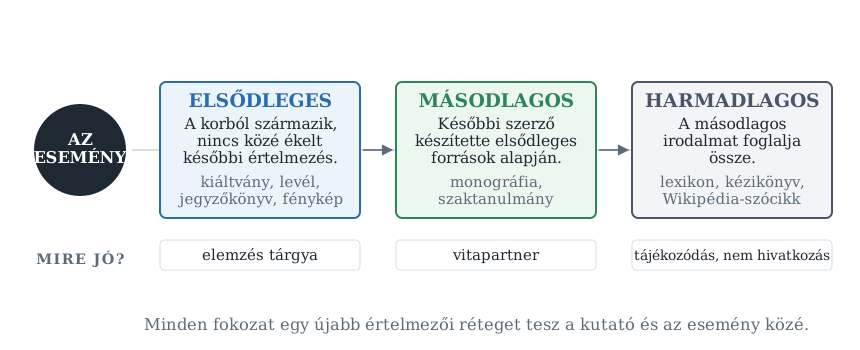
2.1 Elsődleges forrás
Elsődleges (vagy: primer) forrás az, amely közvetlenül a vizsgált korszakból vagy eseményből származik. Lehet az esemény szereplőjétől, résztvevőjétől vagy közvetlen szemtanújától; lehet a kor egy hivatalos vagy magántermészetű dokumentuma; lehet a kor tárgyi emléke. A lényeg, hogy nem rétegződik közé egy későbbi értelmezés.
Példák: egy 1848-as kiáltvány, egy korabeli újságcikk, egy levél, egy hivatali jegyzőkönyv, egy fénykép, egy hangfelvétel, egy közhasználati tárgy, egy régészeti lelet, egy korabeli térkép. A személyes visszaemlékezések (memoár, oral history) ugyancsak elsődleges források, de sajátos torzítással: az emlékezet nem rögzít hűen, hanem rekonstruál, és a leírás időpontja és az emlékezett esemény között hosszú idő telhet el.
2.2 Másodlagos forrás
Másodlagos (vagy: szekunder) forrás az, amelyet egy későbbi szerző készített az elsődleges források alapján. Tipikusan szakirodalom: monográfia, szaktanulmány, tankönyv. A másodlagos forrás már értelmezést is tartalmaz, ezért használata óvatosabb eljárást igényel, mint az elsődlegesé.
Példák: egy 1898-as történeti monográfia az 1848-as forradalomról; egy 2020-as szakcikk Mátyás király udvaráról; egy egyetemi jegyzet, amely egy témakör irodalmát foglalja össze.
2.3 Harmadlagos forrás
Harmadlagos (tercier) forrás az, amely a másodlagos irodalmat foglalja össze. Tipikusan kézikönyv, lexikon, Wikipédia-szócikk, oktatóanyag. Ezeket tájékozódásra használjuk, de tudományos hivatkozásként ritkán szerepelnek; az ezek által közvetített tudást vissza kell vezetnünk a másodlagos vagy elsődleges forrásig.
Példák: a Magyar Nagylexikon szócikkei, egy Wikipédia-szócikk, egy középiskolai tankönyv egy adott témáról, egy átfogó kézikönyv.
Példa Ugyanaz a dokumentum, más-más szerep
Egy 1898-ban megjelent történeti monográfia az 1848-as forradalomról másodlagos forrás, ha az 1848-as eseményeket kutatja: a szerző az elsődleges forrásokra támaszkodva értelmezett. Ugyanaz a monográfia azonban elsődleges forrás, ha a 19. század végi történetírást vagy az 1848-as emlékezetpolitikát kutatja – most maga a könyv lesz a vizsgálat tárgya. A forrástípus tehát mindig a kutatási kérdés függvénye, nem a dokumentum belső tulajdonsága.
Mélyebben A típushatárok elmosódása
A három kategória nem éles. Egy 19. század végi szöveggyűjtemény, amely középkori okleveleket közöl betűhű átiratban, egyszerre tartalmaz elsődleges anyagot (az átírt oklevelet) és másodlagos tevékenységet (a szerkesztői beavatkozást, a magyarázó jegyzeteket). Egy oral history interjú elsődleges forrás (közvetlenül az emlékezőtől), de a benne elmondottak más-más eseményekre vonatkozóan más-más fokú közvetlenséggel bírnak – saját élmény kontra hallott történet. A típushatárok elmosódása nem a tipológia gyengesége, hanem emlékeztető arra, hogy minden konkrét forrást konkrét kérdéssel kell szembesíteni.
3. A forrás a digitális korban
A 21. század történésze a forrásai túlnyomó többségét nem eredetiben, hanem digitális közvetítésen keresztül látja. Egy középkori oklevelet Hungaricana-rekordként, egy 19. századi újságcikket OCR-rel ellátott PDF-ben, egy 20. századi fényképet közösségimédia-megosztásban. Ez a helyzet két új kérdést vet fel: hogyan viszonyuljunk a digitalizált forráshoz, és hogyan a kifejezetten digitális (born-digital) forrásokhoz?
3.1 Digitalizált forrás: új forma, nem új forrás
A digitalizált forrás esetében a fontos megkülönböztetés a következő: az eredeti forrás (mondjuk egy 1873-as újságszám) létezik a maga anyagi valóságában – papírja, tintája, fizikai sérülései, gyűrődései. A digitalizált változat ennek egy szelete: a szöveg és a kép, optikai felvételen rögzítve, gyakran tovább feldolgozva (OCR-rel, metaadatozással, adatbázis-szerkesztéssel).
Ami eltűnik a digitalizálás során: az anyagi minőség, a papír színe és textúrája, a tinta árnyalata, a fizikai kontextus (hogy ez az újságpéldány hova volt összehajtva, kinek a könyvtárában volt). Ami megmarad: a szövegi tartalom és a vizuális szerkezet.
Ez egyrészt rendkívüli kényelmet ad: az otthoni íróasztal mellől hozzáférhet egy kassai folyóirathoz, amelyet különben csak Kassán lehetne kézbe vennie. Másrészt új kritikai kérdéseket vet fel: pontos-e a digitalizálás (nincs-e hiányos oldal)? Pontos-e az OCR (mit ír át, és mit ferdít)? Tényleg a teljes forrásanyag van-e benne, vagy szelektált? A digitalizált változat tehát nem helyettesíti az eredeti forrást – kiegészíti, és új típusú forráskritikát kíván.
3.2 Born-digital források
A born-digital források azok, amelyek soha nem léteztek analóg formában.3 Ide tartozik egy e-mail, egy közösségimédia-bejegyzés, egy digitális közigazgatási dokumentum, egy weboldal, egy elektronikus ügyirat. A born-digital forrásokról szóló forráskritikai diskurzus jelenleg formálódik; a hagyományos eszközök egy részét kell adaptálni, más részét pedig újat kidolgozni. Egy nyomtatott újságnál tudjuk, mi tartozik a forráshoz (a papír, a betűk); egy weboldalnál ez nem egyértelmű: a HTML-kód is, a megjelenített kép is, a beágyazott szkriptek is – és időben változnak.
Egy fontos szempont: a born-digital források törékenyek. Egy 19. századi újságpéldány két évszázad alatt anyagilag fennmaradhat; egy 2010-es közösségimédia-bejegyzés egyetlen szerverhiba vagy fióktörlés után megszűnik. A digitális forrásmegőrzés (digital preservation) önálló tudományterület, amely ezt a problémát célozza.
3.3 Remediáció: a közvetítés rétegei
A digitalizálás során egy közvetítési folyamat zajlik le: az eredeti közeg (pl. papír) átkerül egy másik közegbe (pl. képfájl, OCR-szöveg, adatbázis-rekord). Ezt a folyamatot a médiaelmélet remediációnak nevezi.4
A remediáció során minden közegnek nyoma marad: a digitalizált sajtóoldal nem „a sajtó”, hanem „a sajtó képfájlban + az OCR-szöveg + a Hungaricana-felület”. Mindhárom réteg hozzátehet és elvehet az eredeti forráshoz: a képfájl elveszti a tapintható minőséget, az OCR hibákat ad hozzá, a Hungaricana-felület új kontextust teremt (gyűjteményi besorolás, kereshetőség). A forráskritika ezért a digitális korban többrétegű: a forrásra és a közvetítő rétegekre egyaránt kérdezünk.
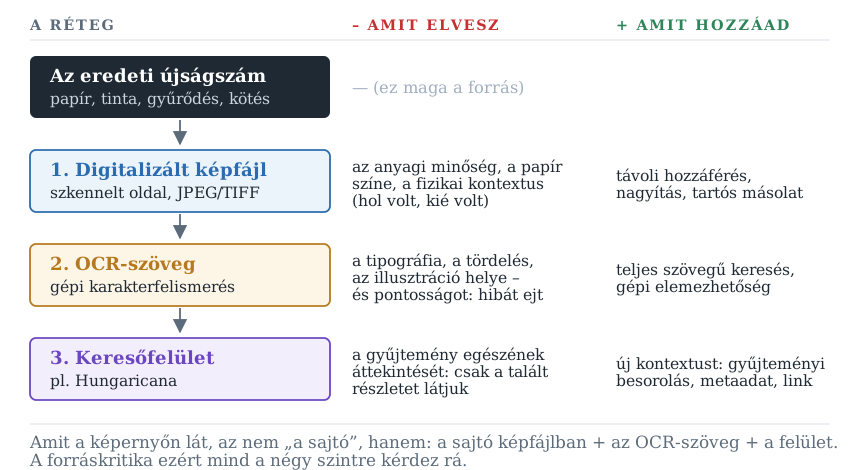
Az ábrát érdemes visszafelé is olvasni. Ha a Hungaricanán talál egy cikket, Ön a legalsó rétegnél kezd, és onnan kell visszakövetkeztetnie az eredetire. A kérdés minden szinten ugyanaz: mit nem látok innen?
Figyelem Tipikus hiba: a digitalizált változat mint új forrás
Ha egy Hungaricana-találatra hivatkozik, ne úgy idézze, mintha a Hungaricana lenne a forrás. A forrás továbbra is az eredeti újság, könyv vagy irat; a Hungaricana csak közvetítő. A helyes hivatkozás az eredeti forrás bibliográfiai adatait tartalmazza (folyóirat, dátum, oldalszám), és kiegészítésként jelzi, hogy digitalizált példányát a Hungaricanán érte el a megadott perzisztens linken.
4. Forráskritika
A forráskritika a történész munkájának alapja: nem hisszük el a forrásnak, kérdezünk tőle. A klasszikus forráskritika két nagy szempontot különböztet meg: a külső (formai) és a belső (tartalmi) kritikát.
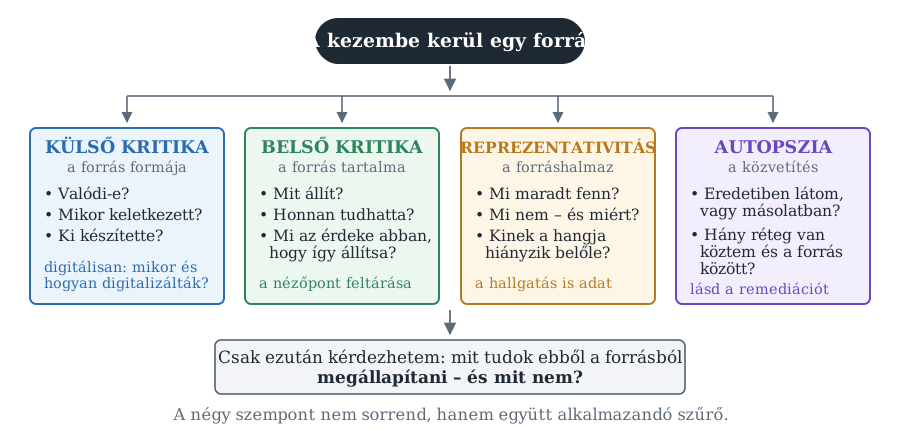
4.1 Külső kritika
A külső kritika azt vizsgálja, valódi-e a forrás, mikor keletkezett, ki készítette. Egy középkori oklevélnél ez fizikai-paleográfiai vizsgálatot jelent: a pergamen, a tinta, a kéz, a pecsét vizsgálatát. Egy 19. századi újságnál a kérdés ritkábban a valódiság, gyakrabban a datálás pontossága és a kiadás körülményei. A digitális korban a külső kritikához új szempontok társulnak: a digitalizálás dátuma, az OCR minősége, az adatbázis-szerkesztés módja.
4.2 Belső kritika
A belső kritika a tartalom hitelességét és megbízhatóságát vizsgálja. A fő kérdések: mit állít a forrás? Honnan tudhatta a szerző azt, amit állít? Mi az érdeke abban, hogy így állítsa? Milyen torzítást vihet bele a saját nézőpontja, vallási vagy politikai elkötelezettsége, érzelmi viszonya az eseményhez? A belső kritika a forrás „szubjektivitásának” feltárása.
4.3 Reprezentativitás
A források halmazának reprezentativitására is figyelnünk kell. Egy folyóiratcikk-halmazból csak azt látjuk, amit a folyóirat közölt; nem látjuk, mit nem közölt. Egy levéltári fond csak azokat az iratokat tartalmazza, amelyeket valamely intézmény keletkeztetett és megőrzött. A reprezentativitás kérdése: a fennmaradt forráshalmaz mit reprezentál, és mit hagy ki? Egy szegényebb társadalmi réteg hangja gyakran egyszerűen azért hiányzik, mert nem termeltek, vagy nem maradt fenn rájuk vonatkozó forrás.
4.4 Autopszia és közvetítés
Az autopszia elve azt mondja: lehetőleg eredetiben lássa a forrást, ne másolatban.5 A digitális korban ez nem mindig kivitelezhető: az eredetit őrző intézmény talán másik országban van, vagy a forrás nem hozzáférhető. Ilyenkor a digitalizált változatra kell hagyatkoznunk – de tudatosan, jelölve a hivatkozásban, hogy közvetítésen keresztül láttuk. Ha kritikus mondanivaló múlik egy szövegrészleten (például egy szó szerinti idézeten vagy egy paleográfiai részleten), akkor az eredeti dokumentumot kell ellenőrizni.
Definíció Fogalom: autopszia
A forráskritika elve, amely szerint a kutató lehetőleg eredetiben, és nem közvetítésen keresztül vizsgálja a forrást. A magyar és nemzetközi gyakorlatban a hivatkozás végén szokták jelölni, ha a kutató nem látta eredetiben a forrást.
Gyakorlás: forrás-e, és milyen?
Nyolc eset. A dokumentumok párban szerepelnek: ugyanaz a dokumentum kétszer, két különböző kutatási kérdéssel. Figyelje meg, mikor változik meg a helyes válasz.
Feladat Forrás-e, és milyen?
Döntse el minden sorról, hogy a megadott kutatási kérdés mellett elsődleges, másodlagos vagy harmadlagos forrásról van-e szó. Figyelje meg, hogy ugyanaz a dokumentum kétszer szerepel, más-más kérdéssel.
| # | A dokumentum | A kutatási kérdés |
|---|---|---|
| 1 | Kossuth 1848. július 11-i beszéde a Közlöny másnapi számában | Milyen érvekkel kérte a haderő megajánlását? |
| 2 | ugyanaz | Hogyan tudósított a Közlöny az országgyűlésről 1848 nyarán? |
| 3 | Horváth Mihály: Magyarország függetlenségi harczának története (1865) | Mi történt 1849 tavaszán a hadszíntéren? |
| 4 | ugyanaz | Hogyan formálta az emigráció 1848 emlékezetét az 1860-as években? |
| 5 | A Wikipédia „Magyar szabadságharc” szócikke | Mikor volt a világosi fegyverletétel? |
| 6 | ugyanaz | Hogyan alakult a szócikk szövege 2010 és 2024 között? |
| 7 | 2019-es szaktanulmány 1200 tanácsi jegyzőkönyv statisztikai feldolgozásával | Milyen ügytípusok kerültek a tanácsülések elé? |
| 8 | 1970-es évekbeli oral history interjú egy 1944-es eseményről | Mi történt a településen 1944 őszén? |
Esettanulmány
Esettanulmány A Tripartitum mint forrás
Werbőczy István 1517-ben kiadott munkája, a Tripartitum (Hármaskönyv) a magyar jogtörténet egyik központi dokumentuma. A modern kutató több formában is találkozhat vele: az 1517-es eredeti kiadás (egy-két fennmaradt példánnyal); 19. századi nyomtatott újrakiadások; modern, tudományos szövegkiadások; a Hungaricanán digitalizált változatok; szakirodalmi feldolgozások és lexikonszócikkek.
Tegyük fel, hogy a kérdésünk a 16. századi magyar jogi gondolkodás: ekkor az 1517-es eredeti kiadás elsődleges forrás, a 19. századi újrakiadás is „elsődleges-szerű” (mert a szöveghez férhetünk hozzá), a Hungaricana-rekord pedig egy közvetítő réteg. Ha viszont a kérdésünk a 19. század végi magyar jogtörténet recepciója, akkor a 19. századi újrakiadás vagy a vele kapcsolatos kommentárirodalom maga az elsődleges forrás – mert most a 19. század végi diskurzust vizsgáljuk.
Az esettanulmány tanulsága: ugyanaz a dokumentum a kutatási kérdéstől függően teljesen más szerepet kap. A forráskritika első lépése tehát nem a dokumentum, hanem a kérdés tisztázása. A digitális közvetítés ezt a műveletet egyszerre megkönnyíti (hozzáférhetővé tesz olyan forrásokat, amelyeket másképp nem érnénk el) és bonyolítja (egy újabb értelmezési réteget ad hozzá).
Reflexiós feladat
Feladat 1. feladat – Forrásportfólió
Válasszon ki egy lehetséges szakdolgozati témát, vagy ha még nincs, akkor egy konkrét történeti kérdést, ami érdekli. (Például: „Hogyan változott a kassai polgárság összetétele 1850–1890 között?” vagy „Hogyan reagált egy adott vidéki közösség egy adott eseményre?”)
Soroljon fel három különböző típusú forrást, amelyet a kérdés megválaszolásához használhatna. Mindegyik forrásnál:
Jelölje meg, elsődleges, másodlagos vagy harmadlagos forrásnak tekintené-e a saját kutatási kérdése szempontjából.
Érveljen egy mondatban a besorolás mellett.
Jegyezzen fel egy konkrét forráskritikai kérdést, amelyet az adott forrással szemben fel kell tennie (lehet külső vagy belső kritikai szempontból).
Ha a forráshoz csak digitális közvetítésen keresztül férne hozzá, írjon egy mondatban arról is, hogy ez milyen plusz kérdést vet fel.
Elvárt formátum: féloldalas (kb. 300 szavas) szöveges elemzés, strukturált felsorolásban a három forrás és a négy szempont.
Önellenőrző kérdések
1. Mi a fő különbség az elsődleges és a másodlagos forrás között?
Válasz megjelenítése
Az elsődleges forrás közvetlenül a vizsgált korszakból vagy eseményből származik, és nem rétegződik közé egy későbbi értelmezés. A másodlagos forrás egy későbbi szerző által, elsődleges források alapján készült feldolgozás, amely már értelmezést is tartalmaz.
2. Egy 19. századi újságcikket egy 1848-as eseményről elsődlegesnek vagy másodlagosnak tekintene? Indokoljon!
Válasz megjelenítése
Elsődleges forrásnak: maga az újságcikk a 19. századi diskurzus része, és bár interpretációt is tartalmaz, közvetlenül a kor terméke – nem rétegződik közé egy későbbi feldolgozás. A kortárs észlelés és a közvélemény fennmaradt nyoma.
3. Mit jelent a külső kritika és mit a belső kritika?
Válasz megjelenítése
A külső kritika a forrás formai és anyagi sajátosságait vizsgálja: valódi-e, mikor keletkezett, ki készítette. A belső kritika a tartalom hitelességét és megbízhatóságát vizsgálja: mit állít, honnan tudhatta, milyen érdek vagy nézőpont torzíthatja a beszámolóját.
4. Mi a born-digital forrás, és miért különbözik a digitalizált forrástól?
Válasz megjelenítése
A born-digital forrás már digitálisan jött létre, soha nem létezett analóg formában (pl. e-mail, közösségimédia-bejegyzés). A digitalizált forrás eredetileg analóg volt, és csak utólag került digitális formába. A különbség forráskritikai szempontból fontos: a born-digital forrásnál nincs „eredeti analóg változat”, amihez visszanyúlhatnánk.
5. Miért lehet probléma, ha egy idézetet csak a Hungaricana OCR-szövegéből vesz át?
Válasz megjelenítése
Az OCR algoritmikus átirat, hibákkal – a kép típusú forrásból automatikusan generált szöveg nem pontos. Egy szó szerinti idézet OCR-szövegből vétele esetén a hibák bekerülhetnek a saját dolgozatába, és a forrás eredeti szövege torzul. Az idézetet az oldalképen kell ellenőriznie.
Összefoglalás
Ebben a fejezetben megnéztük, mit ért a történeti kutatás a forrás fogalmán: minden olyan dokumentumot, tárgyat vagy emléket, amely a múltról közvetlen vagy közvetett információt hordoz, és amelynek alapján a történész – kritikai eszközökkel – következtetéseket vonhat le. Láttuk, hogy a forrásbesorolás (elsődleges, másodlagos, harmadlagos) nem a dokumentum belső tulajdonsága, hanem a kutatási kérdés függvénye: ugyanaz a dokumentum más kérdésnél más szerepet kap. Megvizsgáltuk, mit jelent a forrás fogalma a digitális korban – különbséget tettünk digitalizált és born-digital források között, és láttuk, hogy a digitalizálás új forráskritikai szempontokat (remediáció, OCR-hiba, adatbázis-szerkesztés) vezet be. Végül felelevenítettük a forráskritika alapfogalmait.
A tankönyv további részeiben a most tisztázott fogalmakra építünk: a következő fejezetekben konkrét digitális adatbázisok és eszközök kerülnek terítékre (Zotero, ELP, LIR, OCR-eszközök, Hungaricana), és minden egyes esetben vissza fogjuk látni a fenti kategóriákat – a forrás és a szakirodalom megkülönböztetését, az elsődleges/másodlagos felosztást, a remediáció kérdését és a forráskritikai szempontokat.
Kulcsfogalmak
autopszia – A forráskritika elve, amely szerint a kutató lehetőleg eredetiben, és nem közvetítésen keresztül vizsgálja a forrást.
belső kritika – A forráskritika része, amely a forrás tartalmi hitelességét és megbízhatóságát vizsgálja: mit állít, honnan tudhatta a szerző, milyen érdek vagy nézőpont torzíthatja.
born-digital forrás – Olyan forrás, amely már eleve digitális formában jött létre, és nem volt korábbi analóg verziója (pl. e-mail, közösségimédia-bejegyzés).
digitalizált forrás – Olyan forrás, amelyet eredetileg analóg formában (papíron, tárgyként) hoztak létre, és utólag digitalizáltak (szkennelés, OCR, metaadatozás).
elsődleges forrás – Olyan forrás, amely közvetlenül a vizsgált korszakból vagy eseményből származik, és nem rétegződik közé egy későbbi értelmezés.
forrás – Minden olyan dokumentum, tárgy vagy emlék, amely a múltról közvetlen vagy közvetett információt hordoz, és amelynek alapján a történész következtetéseket vonhat le. A forrásként való azonosítás kérdésfüggő.
forráskritika – Az a módszertani eljárás, amellyel a történész a forrásokhoz kapcsolódó kérdéseket szisztematikusan felteszi (mikor, ki, miért, mit állít, milyen torzítással).
harmadlagos forrás – Olyan forrás, amely a másodlagos irodalmat foglalja össze (kézikönyv, lexikon, Wikipédia-szócikk). Tudományos hivatkozásra ritkán használjuk.
külső kritika – A forráskritika része, amely a forrás formai és anyagi sajátosságait vizsgálja: valódi-e, mikor keletkezett, ki készítette.
másodlagos forrás – Olyan forrás, amelyet egy későbbi szerző készített az elsődleges források alapján, és amely már értelmezést is tartalmaz (monográfia, szakcikk, tankönyv).
remediáció – Az a folyamat, amelynek során egy közeg tartalma egy másik közegbe kerül át (pl. papír → digitális kép → OCR-szöveg), és amelynek során az eredeti és az új közeg sajátosságai egyaránt nyomot hagynak a forráson.
reprezentativitás – A forráskritika része, amely arra kérdez rá, hogy a fennmaradt forráshalmaz mit reprezentál a múltból, és mit hagy ki.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Kerepeszki Róbert – Schrek Katalin (szerk.): Bevezetés a történelemtudományba és a történelemkutatás módszereibe. Pécs, Kronosz, 2023.
- Bolter, Jay David – Grusin, Richard: Remediation: Understanding New Media. Cambridge, MA, MIT Press, 1999.
Ajánlott irodalom
- Romsics Ignác: A történész igazsága és a múlt megismerhetősége. Budapest, Osiris, 2018. (A forrás fogalmának fejezetei.)
- Owens, Trevor: The Theory and Craft of Digital Preservation. Baltimore, Johns Hopkins University Press, 2018. (Born-digital forrásokról.)
Linkek és eszközök
- ELTE BTK Digitális Bölcsészet Tanszék – https://elte-dh.hu/ – elérve: 2026. 08. 20.
- Digitális Bölcsészet folyóirat – https://ojs.elte.hu/digitalisbolcseszet/index – elérve: 2026. 08. 20.
- Hungaricana Közgyűjteményi Portál – https://www.hungaricana.hu/hu/ – elérve: 2026. 08. 20.
A magyar levéltári rendszer és a levéltári források
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 90 perc |
| Előfeltétel | Mi a forrás? |
| Verzió / dátum | v0.1 / 2026. augusztus |
Miről szól ez a fejezet?
Az eddigi fejezetek szakirodalmat kerestek: könyvet, tanulmányt, cikket. Ez a fejezet átvezet a forráshoz. Nem egy felületet mutat be, hanem azt a rendszert, amelyben a magyar levéltári források elhelyezkednek: hogyan kerül egy irat a levéltárba, milyen rendben őrzik, melyik levéltárban keresse, és mit kutathat belőle egyáltalán.
Erre azért van szükség, mert a következő két fejezet – az ELP és a LIR – keresőfelületeket mutat be, azok pedig ennek a rendszernek a logikáját képezik le. Aki nem tudja, mi a fond, annak a keresőfelület használhatatlan lesz.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- saját szavaival elmagyarázza, hogyan lesz egy hivatali iratból levéltári forrás, és megnevezi azt a lépést, ahol a forrásbázis határa eldől;
- megkülönbözteti a fond, állag, sorozat, tétel és darab szintjeit, és megmondja, mit tartalmaz egy levéltári jelzet;
- megfogalmazza a proveniencia elvét, és megindokolja, miért nem lehet levéltárban „témára” keresni úgy, mint egy könyvtári katalógusban;
- egy megadott kutatási témához megnevezi, melyik levéltárban kellene keresnie, és megindokolja a választását;
- eldönti egy iratról, hogy a 30 éves korlát és a védelmi idő alapján kutatható-e, és megnevezi a három kivételes utat;
- megnevezi azokat az online felületeket, amelyeken a magyar levéltári nyilvántartások és digitalizált anyagok kereshetők.
Bevezetés
Egy hallgató, aki először lép be egy levéltárba, rendszerint azt a kérdést hozza magával, amit a könyvtárban megtanult: „Van itt valami a témámról?“ Ez a kérdés a levéltárban nem célravezető – nem azért, mert a levéltáros nem segítőkész, hanem mert a levéltári anyag általában nem téma szerint van rendezve.
Figyelem A könyvtár és a levéltár között három lényegi különbség van:
| Könyvtár | Levéltár | |
|---|---|---|
| Mit őriz? | sokszorosított kiadványt: ugyanaz a kötet máshol is megvan | egyedi iratot: ha elpusztul, nincs másik példány |
| Hogyan rendezi? | téma és szerző szerint, szabadon átcsoportosítható | az iratképző szerv szerint, a keletkezés rendjét megőrizve |
| Mire keres? | a műre: cím, szerző, tárgyszó | a kontextusra: melyik hivatal, melyik ügy, melyik év |
A leggyakoribb kezdő hiba ebből fakad: a hallgató beírja a témáját a levéltári keresőbe, nulla találatot kap, és azt hiszi, nincs forrás. Pedig a forrás gyakran ott van – csak nem a téma nevén.
1. Hogyan lesz egy hivatali iratból történeti forrás?
Az iratok nem azért keletkeznek, hogy a történész olvassa őket. Egy adóügy, egy építési engedély, egy fegyelmi eljárás iratai azért jöttek létre, mert egy ügyet el kellett intézni. Az út a hivatali íróasztaltól a kutatóteremig hosszú, és több ponton emberi döntés szakítja meg.
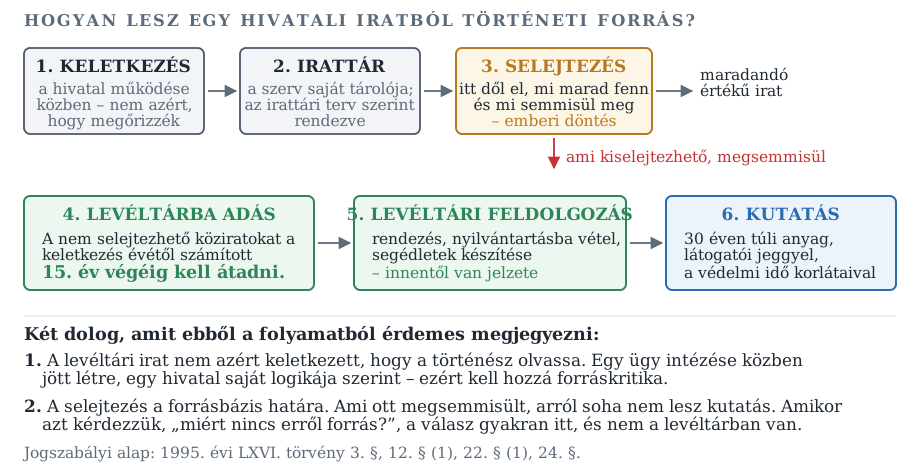
Definíció Négy fogalom a törvényből
- közirat: minden olyan irat, amely közfeladatot ellátó szerv irattári anyagába tartozik vagy tartozott – a keletkezés idejétől és az őrzés helyétől függetlenül (3. § d);
- irattári anyag: a szervnél maradó, tartalmuk miatt átmeneti vagy végleges megőrzést igénylő, szervesen összetartozó iratok összessége (3. § f);
- maradandó értékű irat: az az irat, amely a történelmi múlt kutatásához, a közfeladatok ellátásához vagy az állampolgári jogok érvényesítéséhez nélkülözhetetlen, más forrásból nem vagy csak részlegesen megismerhető adatot tartalmaz (3. § j);
- levéltári anyag: az irattári anyagnak, illetve a természetes személyek iratainak a levéltárban őrzött, maradandó értékű része (3. § k).
Forrás: 1995. évi LXVI. törvény a köziratokról, a közlevéltárakról és a magánlevéltári anyag védelméről.
A folyamat két pontja érdemel külön figyelmet.
A selejtezés. Nem minden irat marad fenn – és ez nem véletlen, hanem szabályozott döntés. Az irattári terv előre meghatározza, mely iratfajták selejtezhetők ki és mennyi idő után, illetve melyek nem selejtezhetők soha.
A levéltárba adás határideje. A nem selejtezhető köziratok teljes és lezárt évfolyamait a keletkezés naptári évétől számított tizenötödik év végéig kell az illetékes közlevéltárnak átadni (12. § (1)). Ez a határidő indokolt esetben meghosszabbítható.
Mélyebben A selejtezés mint forráskritikai kérdés
Amikor egy szakdolgozó azt tapasztalja, hogy „erről nincs forrás”, a válasz gyakran nem a levéltárban, hanem a selejtezésnél van. Ami ott megsemmisült, arról soha nem lesz kutatás.
Ez nem csupán technikai részlet, hanem historiográfiai kérdés: az, hogy egy korszakban mit ítéltek megőrzésre méltónak, maga is forrás – a korszak értékrendjéről szól. A hivatali működés apró, ismétlődő nyomai (segélykérelmek, panaszok, nyugták) rendszerint kiselejtezhetőnek minősülnek, miközben épp ezek mutatnák meg a hétköznapi ember és az állam találkozását.
Ezért fontos a mintavétel (3. § v): a levéltár olyan iratokból is átvehet darabokat, amelyek egyébként selejtezésre kerülnének, ha az irattári tétel egészének megőrzése nem indokolt, de egyes ügyiratok megtartása szükséges. A történész számára ez azt jelenti, hogy egy sorozat töredéke is fennmaradhat – de akkor tudni kell, hogy az nem teljes, és nem is véletlen minta.
2. A levéltári rend: fond, állag, sorozat, tétel, darab
A levéltári anyagot hierarchikus rendben tartják nyilván. Ez a rend nem a történész kérdéseit követi, hanem az iratkeletkezés rendjét.
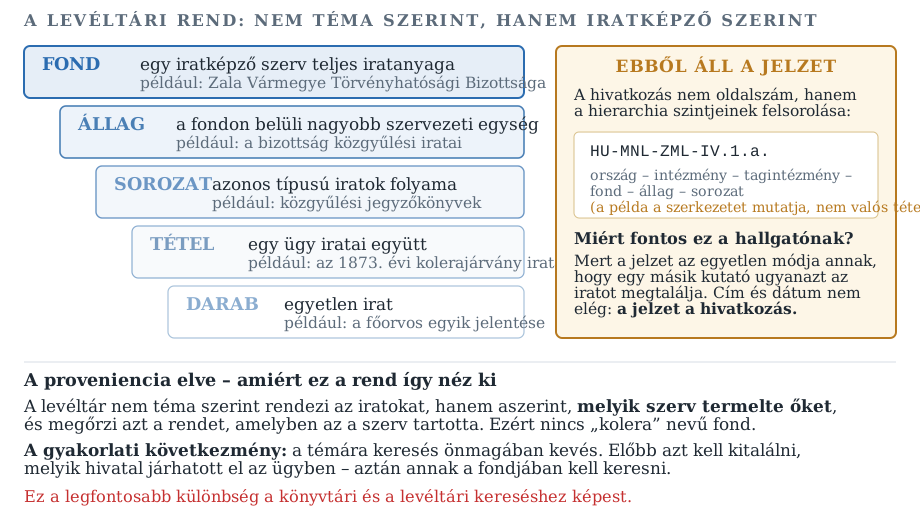
Definíció Fogalom: proveniencia elve (a származás elve)
A levéltári rendezés alapelve: egy iratképző szerv iratanyagát nem szabad összekeverni más szervek irataival, és meg kell őrizni azt a belső rendet, amelyben az a szerv az iratait tartotta.
Ebből következik, hogy a levéltári struktúra legfelső szintje a fond: egy iratképző szerv – például egy vármegyei közgyűlés, egy minisztérium, egy bíróság – szervesen összetartozó iratanyaga.
Definíció Fogalom: pertinencia elve (a vonatkozás elve)
A proveniencia ellentéte: az iratokat nem az iratképző szerv szerint, hanem tárgyuk, keletkezési helyük vagy idejük szerint rendezik – vagyis aszerint, hogy mire vonatkoznak. A 19. századi levéltári gyakorlatban ez volt az uralkodó rendezési elv; ma a proveniencia a fő szabály, a pertinencia pedig a kivétel.
Hol találkozik vele mégis? Két jellegzetes helyen:
- Középkori oklevelek. A Magyar Nemzeti Levéltár Diplomatikai Levéltár (DL) gyűjteménye nem iratképzők szerint áll, hanem egyetlen, folyamatosan számozott oklevélsorozat – mert az oklevelek az évszázadok során elszakadtak az eredeti őrzőjüktől. Itt tehát darabszinten, tárgy szerint keres.
- Építészeti és műszaki tervek. A tervtárak anyagát rendszerint az épület vagy a helyrajzi szám szerint rendezik, nem a tervező hivatal szerint – mert a használót az érdekli, melyik házról van szó.
Amit ebből gyakorlatilag tudni kell: ha egy gyűjtemény pertinencia szerint van rendezve, akkor kivételesen mégis lehet tárgyra keresni – de ez a kivétel, és a fondszerkezetű anyag túlnyomó többségénél nem működik.
Figyelem Ezért nincs „kolera” nevű fond. Ha az 1873-as kolerajárványt kutatja, nem azt kell keresnie, hogy hol van a járványról szóló iratcsomó. Azt kell kitalálnia, hogy melyik hivatal járt el a járvány ügyében – az alispán? a vármegyei közgyűlés? a tiszti főorvos? a település elöljárósága? –, és annak a szervnek a fondjában kell keresnie.
Ez a lépés a levéltári kutatás legnehezebb és legfontosabb mozzanata. Egy mondatban: előbb a szervet találja meg, aztán az iratot.
Tipp A jelzet a hivatkozás. Egy levéltári iratra nem lehet úgy hivatkozni, ahogy egy könyvre: nincs szerzője, címlapja és oldalszáma. A hivatkozás maga a jelzet, amely a hierarchia szintjeit sorolja fel: ország, intézmény, tagintézmény, fond, állag, sorozat – és szükség szerint a tétel vagy az iktatószám.
Jegyzeteléskor a jelzetet írja fel először, még mielőtt elkezdi olvasni az iratot. Utólag visszakeresni sokkal drágább, mint előre feljegyezni. A pontos hivatkozási formákról az ELP és a LIR fejezet ad példákat.
Mélyebben Nyilvántartás vagy segédadatbázis?
A levéltári anyagot kétféle elektronikus rendszer teszi kereshetővé, és ezeket nem szabad összekeverni:
- a levéltári nyilvántartó rendszer a levéltár hivatalos nyilvántartását tartalmazza, a levéltárban kialakított rendet követve – ilyen az ELP és a LIR;
- a segédadatbázis ettől a rendtől eltérhet: tematikus, tárgyi vagy időrendi gyűjteményeket hozhat létre, például egy korszakra vagy egy eseményre – ilyen az AdatbázisokOnline legtöbb adatbázisa és az Állambiztonsági archontológia.
Miért számít ez a hivatkozásnál? Mert a segédadatbázis a levéltári anyag feldolgozása, nem maga az irat. Ha egy adatbázisban talált adatra hivatkozik, jelölje meg az adatbázist és az eredeti irat jelzetét is – az adatbázis ugyanis változhat, javíthatják, újraindexelhetik.
3. Melyik levéltárba menjen?
A magyar levéltári rendszert a levéltári törvény két nagy csoportra osztja: közlevéltárakra és nyilvános magánlevéltárakra.
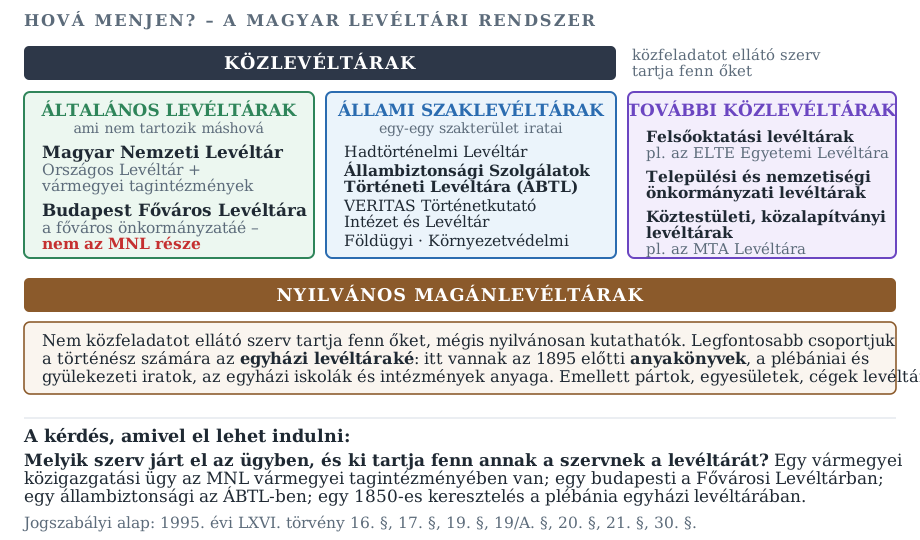
3.1 Általános levéltárak
A törvény szerint két általános levéltár van: a Magyar Nemzeti Levéltár és a Budapest Főváros Önkormányzata által fenntartott levéltár (16. § (2)). A nemzeti levéltár a Magyar Nemzeti Levéltár (16. § (3)).
Az MNL központi általános levéltár, vármegyei szervezeti egységekkel (tagintézményekkel) (17. § (1)). Vagyis az Országos Levéltár és a vármegyei levéltárak egyetlen intézmény részei, közös keresőfelülettel.
Figyelem Budapest Főváros Levéltára (BFL) nem az MNL része. Önálló általános levéltár, amelynek fenntartója Budapest Főváros Önkormányzata. Ez a gyakorlatban azt jelenti, hogy egy budapesti közigazgatási, bírósági vagy cégügy iratai nem az MNL-ben, hanem a BFL-ben vannak.
Az ELP éppen ezért a két intézmény közös felülete – nem azért, mert összetartoznak, hanem mert megállapodtak a közös szolgáltatásban.
3.2 Állami szaklevéltárak
Az állami szaklevéltár egy-egy szakterület iratanyagát őrzi. A törvény tételesen felsorolja őket (19. § (1)): a Hadtörténelmi Levéltár, a Földügyi és Távérzékelési Levéltár, a Környezetvédelmi és Vízügyi Levéltár, az Állambiztonsági Szolgálatok Történeti Levéltára (ÁBTL), a VERITAS Történetkutató Intézet és Levéltár, valamint az állam által fenntartott tudományos, kulturális vagy egészségügyi intézmények levéltárai.
Figyelem A LIR fejezetben bemutatott rendszert az Állambiztonsági Szolgálatok Történeti Levéltára üzemelteti – ez önálló állami szaklevéltár. Ugyanígy önálló a Hadtörténelmi Levéltár is.
Ez a különbség a gyakorlatban is számít: más a kutatási rend, más a jogosultsági rendszer, más a keresőfelület.
3.3 További közlevéltárak
- Felsőoktatási levéltárak (19/A. §) – például az ELTE Egyetemi Levéltára: itt vannak a beiratkozási és vizsgaanyagok, a kari és rektori iratok, a doktori eljárások dokumentumai. Egyetem- és tudománytörténeti, valamint prozopográfiai kutatáshoz nélkülözhetetlenek.
- Települési és nemzetiségi önkormányzati levéltárak (20. §).
- Köztestületek, közalapítványok és egyéb közfeladatot ellátó szervek levéltárai (21. §) – például az MTA Levéltára.
3.4 Nyilvános magánlevéltárak
A nyilvános magánlevéltár (30. §) nem közfeladatot ellátó szerv fenntartásában működik, mégis nyilvánosan kutatható. A történész számára ezek közül a legfontosabbak az egyházi levéltárak.
Tipp Ha családfát vagy helytörténetet kutat, előbb-utóbb egyházi levéltárba is eljut. Az állami anyakönyvezés Magyarországon 1895. október 1-jén indult; az azt megelőző időszak születési, házassági és halálozási bejegyzései a felekezetek anyakönyveiben találhatók, amelyeket az egyházi levéltárak őriznek.
A digitalizált anyakönyvekről és a családfakutatás menetéről a Családfakutatás fejezet szól.
4. Mit kutathat, és mit nem?
A levéltári anyag kutathatóságát törvény szabályozza. Két feltételnek kell egyszerre teljesülnie: elég régi-e az irat, és – ha személyes adatot tartalmaz – letelt-e az érintett védelmi ideje.
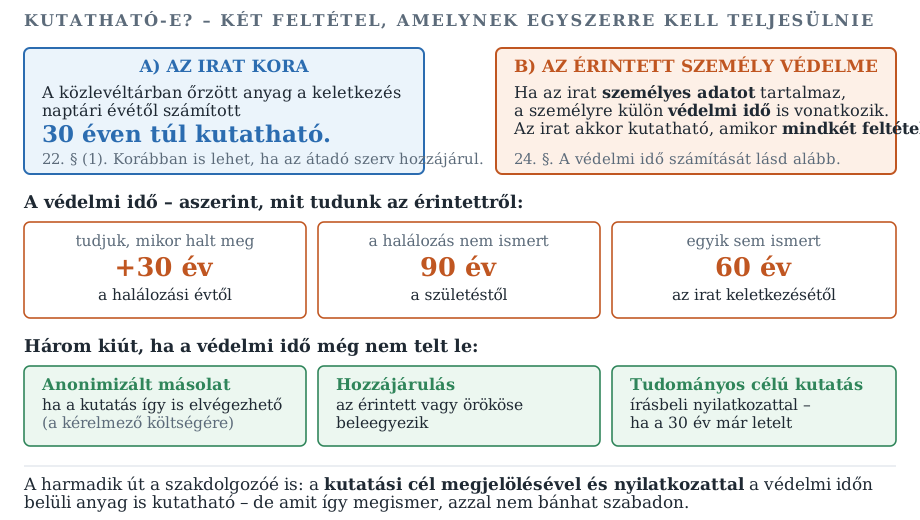
Definíció A két szabály
1. A harmincéves korlát. A közlevéltárban őrzött, a keletkezés naptári évétől számított harminc éven túli levéltári anyagban – a 24. és 25. §-ban meghatározott korlátozásokkal – kutatás végezhető (22. § (1)). Harminc éven belül is folytatható kutatás, ha ahhoz az átadó szerv hozzájárul.
2. A védelmi idő. Ha törvény másként nem rendelkezik, a személyes adatot tartalmazó levéltári anyag az érintett halálozási évét követő harminc év után kutatható. Ha a halálozás ténye és ideje nem ismert, a születéstől számított kilencven év; ha sem a születés, sem a halálozás ideje nem ismert, az irat keletkezésétől számított hatvan év után (24. § (1)).
Mélyebben Miért három különböző szám?
Első ránézésre önkényesnek tűnik, hogy 30, 90 vagy 60 év. Valójában mindhárom ugyanazt a célt szolgálja: azt az időpontot közelíteni, amikor az érintett személyiségi jogai már nem sérülhetnek.
- Ha tudjuk a halálozás évét, abból lehet kiindulni: +30 év.
- Ha nem tudjuk, de a születést igen, akkor a törvény egy hosszú élettartamot feltételez, és ahhoz ad ráhagyást: 90 év a születéstől.
- Ha egyiket sem tudjuk, csak maga az irat marad támpontnak: 60 év.
A logika tehát a bizonytalansággal együtt nő: minél kevesebbet tudunk az emberről, annál óvatosabb a szabály. Ez a gondolat visszatér az adatkezelés és adatvédelem fejezetben is.
Figyelem A két feltétel közül a szigorúbb dönt. Egy 1960-ban keletkezett irat 1990 óta elmúlt harmincéves; ha viszont egy 1945-ben született, ma is élő személy adatait tartalmazza, a védelmi idő miatt akkor sem kutatható szabadon.
A gyakorlatban ez a 20. századi témák – személyzeti anyagok, egészségügyi iratok, rendőrségi és bírósági ügyek – kutatásánál fontos.
A törvény három lehetőséget ad a védelmi időn belüli kutatásra (24. § (2)):
- anonimizált másolat, ha a kutatás így is elvégezhető – a kérelmező költségére;
- hozzájárulás: az érintett, halála után pedig bármely örököse beleegyezik;
- tudományos célú kutatás – feltéve, hogy a 22. § (1) szerinti harminc év már eltelt –, írásbeli támogató állásfoglalás egy tudományos kutatást rendeltetésszerűen végző közfeladatot ellátó szervtől (például egyetemtől vagy kutatóintézettől) és a kutatási cél igazolása mellett.
Figyelem A harmadik út felelősséggel jár. A tudományos célú kutatáshoz a kutatónak nyilatkoznia kell, és a megismert személyes adatokkal nem bánhat szabadon: nem hozhatja nyilvánosságra, nem adhatja tovább, és a publikációban is csak úgy használhatja, ahogy a nyilatkozat engedi.
Ez nem formaság. Egy szakdolgozat, amely azonosítható élő személyek egészségügyi vagy büntetőügyi adatait közli, jogsértő – függetlenül attól, hogy a hallgató jóhiszeműen járt el.
Vannak esetek, amikor a kutatás egyáltalán nem engedélyezhető (25. §): minősített adat esetén az érvényességi idő lejártáig; nemzetközi kötelezettségvállalás körében keletkezett vagy külföldi szerv által átadott iratoknál; illetve olyan, köziratnak nem minősülő anyagban, amelynél az átadó kikötötte a korlátozást. A kutatási kérelem megtagadását a levéltár köteles írásban megindokolni (25. § (3)), és jogorvoslatnak is helye van (29. §).
Tipp A látogatói jegy. A kutatás megkezdése előtt a levéltár látogatói jegyet ad ki, és nyilvántartásba veszi a kutató adatait (23. §). Ez ingyenes, de ügyintézést igényel, és nem minden levéltárban azonos a menete. Szemináriumi vagy szakdolgozati kutatás tervezésekor számoljon rá egy külön alkalommal – és nézze meg előre a levéltár nyitvatartását, mert a kutatószolgálatok gyakran tartanak nyári zárvatartást.
5. Hol keresse online?
A levéltári kutatás ma nem a kutatóteremben kezdődik, hanem otthon: a nyilvántartások és a digitalizált anyag jelentős része online kereshető.
| Felület | Mit ad? | Melyik fejezet? |
|---|---|---|
| Elektronikus Levéltári Portál (ELP) | az MNL és a BFL nyilvántartása és digitális állománya, kutatói kérésekkel | ELP |
| Levéltári Információs Rendszer (LIR) | az ÁBTL nyilvántartása, személykeresővel | LIR |
| AdatbázisokOnline | az MNL adatbázis-gyűjtő felülete: tételes, kereshető adatok | AdatbázisokOnline |
| Hungaricana | digitalizált levéltári, könyvtári és múzeumi anyag közös portálja | Hungaricana |
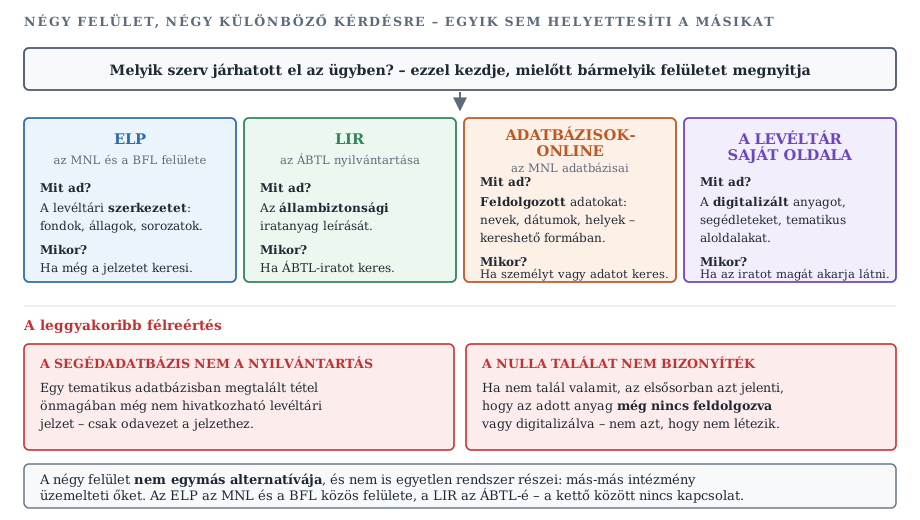
Figyelem A mesterséges intelligencia és a levéltári jelzetek. A Magyar Nemzeti Levéltár Kutatószolgálata 2026. augusztus 19-én közleményt adott ki arról, hogy a mesterséges intelligencia „gyakran szolgáltat téves vagy valótlan információkat, ezért az általa adott válaszok nem tekinthetőek önmagukban hiteles forrásnak”, és kéri a kutatókat, hogy elsődlegesen a hivatalos levéltári nyilvántartásokat és segédleteket használják.
Ez a figyelmeztetés nagyon is konkrét jelenségre válaszol: a nyelvi modellek valósnak látszó, de nem létező levéltári jelzeteket állítanak elő. Egy jelzet formailag mindig helyesnek fog tűnni – ellenőrizni csak a nyilvántartásban lehet. A jelenségről bővebben a Mesterséges intelligencia fejezet szól.
Forrás: MNL Kutatószolgálat, „Közlemény a mesterséges intelligencia használatáról a kutatás során”, 2026. 08. 19.
Gyakorlás: melyik levéltárba menne?
Nyolc kutatási helyzet. Döntse el mindegyikről, melyik levéltár őrzi az iratot – és mindig azt kérdezze magától: melyik szerv járt el az ügyben?
Feladat Melyik levéltárba menne?
Döntse el minden helyzetről, melyik levéltár őrzi az iratot: MNL Országos Levéltára, MNL vármegyei tagintézmény, Budapest Főváros Levéltára, ÁBTL, Hadtörténelmi Levéltár, felsőoktatási levéltár vagy egyházi levéltár. Indokolja egy mondatban, melyik szerv járt el az ügyben.
| # | A kutatási helyzet |
|---|---|
| 1 | Egy zalai falu 1873-as kolerajárványa a vármegyei intézkedések alapján. |
| 2 | Egy budapesti bérház 1930-as építési engedélye. |
| 3 | Egy 1955-ös ügynökjelentés egy megfigyelt személyről. |
| 4 | Egy dédapa 1916-os katonai szolgálatának adatai. |
| 5 | Egy 1850-es keresztelés egy somogyi faluban. |
| 6 | Kik doktoráltak a budapesti tudományegyetemen 1910-ben? |
| 7 | Egy minisztériumi rendelet előkészítő iratai 1968-ból. |
| 8 | Egy vidéki város 1970-es tanácsülési jegyzőkönyvei. |
Esettanulmány
Esettanulmány Egy kérdés útja a kutatási tervtől az iratig
Egy hallgató témája: hogyan reagált a helyi közigazgatás egy 19. századi járványra. Nézzük meg, milyen lépéseken kell végigmennie.
1. lépés – a kérdésből szerv lesz. „Ki intézkedett járvány idején?” A 19. századi vármegyében ez az alispán és a vármegyei közgyűlés, egészségügyi kérdésekben a tiszti főorvos, települési szinten az elöljáróság. Már itt kiderül, hogy nem egy, hanem több iratképző szerv jön szóba.
2. lépés – a szervből levéltár lesz. Mindegyik vármegyei szerv, tehát az MNL adott vármegyei tagintézménye az illetékes. Ha a járvány egy budapesti kerületet is érintett, ott a BFL.
3. lépés – a levéltárból fond lesz. A nyilvántartásban meg kell keresni az adott szerv fondját, azon belül a megfelelő állagot és sorozatot – például a közgyűlési jegyzőkönyveket vagy az alispáni iratokat.
4. lépés – a fondból jelzet lesz. A kiválasztott egység jelzetét fel kell jegyezni: ez lesz a hivatkozás, és ezzel lehet kikérni az iratot.
5. lépés – ellenőrzés a kutathatóságra. 1873-as anyagról van szó: a 30 éves korlát rég letelt, és a védelmi idő is – a 60 éves szabály alapján biztosan. Szabadon kutatható.
Mi történt volna, ha a hallgató a „kolera” szót írja be egy keresőbe? Kaphatott volna találatokat – tárgyszóval ellátott adatbázistételeket vagy digitalizált sajtóanyagot –, de a vármegyei intézkedésekhez csak a szerv felől juthat el. A kereső a jó kérdés után jön, nem helyette.
Önellenőrző kérdések
1. Mi a különbség a közirat és a levéltári anyag között?
Válasz megjelenítése
A közirat minden olyan irat, amely közfeladatot ellátó szerv irattári anyagába tartozik vagy tartozott. A levéltári anyag ennek – és a természetes személyek iratainak – a levéltárban őrzött, maradandó értékű része. Minden levéltári anyag volt egyszer irat, de nem minden iratból lesz levéltári anyag.
2. Melyik lépésnél dől el, hogy egy irat egyáltalán fennmarad-e? Miért nevezzük ezt forráskritikai kérdésnek?
Válasz megjelenítése
A selejtezésnél. Forráskritikai kérdés, mert az, hogy egy korszakban mit ítéltek megőrzésre méltónak, maga is történeti információ – és mert a selejtezés szabja meg a kutatható forrásbázis határát.
3. Hány éven belül kell a nem selejtezhető köziratokat levéltárba adni?
Válasz megjelenítése
A keletkezés naptári évétől számított tizenötödik év végéig (12. § (1)), indokolt esetben meghosszabbítható határidővel.
4. Sorolja fel a levéltári hierarchia öt szintjét a legfelsőtől a legalsóig.
Válasz megjelenítése
Fond – állag – sorozat – tétel – darab.
5. Fogalmazza meg egy mondatban a proveniencia elvét, és mondjon rá egy következményt a keresésre nézve.
Válasz megjelenítése
Egy iratképző szerv anyagát nem szabad más szervek irataival összekeverni, és meg kell őrizni a szerv saját rendjét. Következmény: nem témára, hanem iratképző szervre kell keresni – előbb a hivatalt kell megtalálni.
6. Mikor rendezik az iratokat mégis tárgy szerint, és mi ennek a neve?
Válasz megjelenítése
Ez a pertinencia elve. Ma kivételes; jellemzően a középkori oklevélgyűjteményeknél (például a Diplomatikai Levéltárnál) és a tervtáraknál találkozni vele, ahol az iratok elszakadtak az eredeti iratképzőjüktől, vagy ahol a használót az épület, nem a tervező hivatal érdekli.
7. Miért nem az MNL része Budapest Főváros Levéltára?
Válasz megjelenítése
Mert önálló általános levéltár, amelynek fenntartója Budapest Főváros Önkormányzata (16. § (2)). Az ELP azért közös felület, mert a két intézmény megállapodott a közös szolgáltatásban.
8. Melyik levéltár őrzi az állambiztonsági iratokat, és milyen intézménytípusba tartozik?
Válasz megjelenítése
Az Állambiztonsági Szolgálatok Történeti Levéltára (ÁBTL), amely állami szaklevéltár (19. § (1)).
9. Hány év a védelmi idő, ha az érintett halálozásának ideje nem ismert, a születéséé viszont igen?
Válasz megjelenítése
Kilencven év a születéstől (24. § (1)).
10. Nevezze meg a védelmi időn belüli kutatás három lehetséges útját.
Válasz megjelenítése
Anonimizált másolat; az érintett vagy örököse hozzájárulása; tudományos célú kutatás támogató állásfoglalással, ha a harminc év már letelt (24. § (2)).
11. Hol vannak az 1895 előtti anyakönyvek, és miért?
Válasz megjelenítése
Az egyházi levéltárakban, mert az állami anyakönyvezés csak 1895. október 1-jén indult; azelőtt a felekezetek vezették az anyakönyveket.
Összefoglalás
A levéltári kutatás abban különbözik a könyvtáritól, hogy nem a műre, hanem a kontextusra kérdez. Az iratok egyediek, nem téma szerint, hanem az iratképző szerv szerint rendezettek, és a hozzájuk vezető út mindig ugyanaz: előbb a szervet kell megtalálni, aztán a fondot, végül a jelzetet.
A magyar levéltári rendszerben a közlevéltárak – az általános levéltárak (MNL és BFL), az állami szaklevéltárak, a felsőoktatási, önkormányzati és köztestületi levéltárak – mellett a nyilvános magánlevéltárak, mindenekelőtt az egyházi levéltárak őrzik a történeti forrásanyagot.
A kutathatóságot két szabály együtt határozza meg: a harmincéves korlát és a személyes adatokra vonatkozó védelmi idő (30 / 90 / 60 év). Ez utóbbin belül is van kutatási lehetőség, de felelősséggel jár.
A következő két fejezet azokat a felületeket mutatja be, amelyeken ez a rendszer online kereshetővé válik: az ELP az MNL és a BFL, a LIR az ÁBTL nyilvántartását.
Kulcsfogalmak
közirat – Minden olyan irat, amely közfeladatot ellátó szerv irattári anyagába tartozik vagy tartozott, a keletkezés idejétől és az őrzés helyétől függetlenül.
maradandó értékű irat – Olyan irat, amely a történelmi múlt kutatásához, a közfeladatok ellátásához vagy az állampolgári jogok érvényesítéséhez nélkülözhetetlen, más forrásból nem vagy csak részlegesen megismerhető adatot tartalmaz.
levéltári anyag – Az irattári anyagnak, továbbá a természetes személyek iratainak levéltárban őrzött maradandó értékű része, valamint a védetté nyilvánított maradandó értékű magánirat.
selejtezés – Az iratok meghatározott rend szerinti kiválogatása és megsemmisítése; a kutatható forrásbázis határa itt dől el.
proveniencia elve – A levéltári rendezés alapelve: egy iratképző szerv anyagát nem szabad más szervek irataival összekeverni, és meg kell őrizni a szerv saját belső rendjét.
pertinencia elve – A proveniencia ellentéte: az iratok tárgy, hely vagy idő szerinti rendezése. Ma kivételes; jellemzően a középkori oklevélgyűjteményeknél és a tervtáraknál találkozni vele.
fond – Egy iratképző szerv szervesen összetartozó iratanyaga; a levéltári rendszerezés legfelső szintje.
levéltári jelzet – Az iratanyag szabványos azonosítója, amely az országkódot, az intézmény azonosítóját és a hierarchia szintjeit tartalmazza; levéltári forrásra ezzel kell hivatkozni.
közlevéltár – A nem selejtezhető köziratokkal kapcsolatos levéltári feladatokat végző, közfeladatot ellátó szerv által fenntartott levéltár.
nyilvános magánlevéltár – Nem közfeladatot ellátó szerv vagy természetes személy által fenntartott, nyilvánosan kutatható levéltár; legfontosabb csoportjuk az egyházi levéltáraké.
védelmi idő – A személyes adatot tartalmazó levéltári anyag kutatási korlátozása: az érintett halálozási évét követő 30 év, illetve – ha a halálozás nem ismert – a születéstől számított 90 év, ha egyik sem ismert, az irat keletkezésétől számított 60 év.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- 1995. évi LXVI. törvény a köziratokról, a közlevéltárakról és a magánlevéltári anyag védelméről. Nemzeti Jogszabálytár, https://njt.hu/jogszabaly/1995-66-00-00 (elérve: 2026. 08. 22.).
- Magyar Nemzeti Levéltár Kutatószolgálata: Közlemény a mesterséges intelligencia használatáról a kutatás során. 2026. 08. 19. https://mnl.gov.hu/ (elérve: 2026. 08. 22.).
Ajánlott irodalom
Linkek és eszközök
| Név | URL | Mire jó? |
|---|---|---|
| Elektronikus Levéltári Portál | https://www.eleveltar.hu/ | az MNL és a BFL nyilvántartása, kutatói kérések |
| Magyar Nemzeti Levéltár | https://mnl.gov.hu/ | az intézmény és tagintézményei, hírek, kutatószolgálat |
| AdatbázisokOnline | https://adatbazisokonline.mnl.gov.hu/ | az MNL adatbázis-gyűjtő felülete |
| Hungaricana | https://hungaricana.hu/ | digitalizált levéltári, könyvtári és múzeumi anyag |
| Magyarországi levéltárak kiadványai | https://library.hungaricana.hu/hu/collection/magyarorszagi_leveltarak_kiadvanyai/ | levéltári segédletek és kiadványok |
| Nemzeti Jogszabálytár | https://njt.hu/ | a levéltári törvény hatályos szövege |
Elektronikus Levéltári Portál (ELP)
| Szerző(k) | Bakó Zsigmond |
| Becsült feldolgozási idő | 90 perc |
| Előfeltétel | Mi a forrás? |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszköz alapadatai
| Eszköz neve | Elektronikus Levéltári Portál (ELP) |
| URL | https://www.eleveltar.hu |
| Üzemeltető | Magyar Nemzeti Levéltár (MNL) és Budapest Főváros Levéltára (BFL) |
| Hozzáférés | Keresés és böngészés regisztráció nélkül; kutatói kérésekhez regisztráció és beiratkozás szükséges |
| Regisztráció | Kutatói kérések leadásához, munkafüzetekhez |
| Tartalomtípus | Levéltári nyilvántartások, leírási egységek, digitális levéltári állomány |
| Lefedettség | Az MNL és a BFL közös adatbázisa; kereshető az egyházi és felsőoktatási levéltárak nyilvántartása is |
Miről szól ez a fejezet?
Ez a fejezet a magyar közlevéltári kutatás legfontosabb online belépési pontját, az Elektronikus Levéltári Portált (ELP) mutatja be. Megtanulja, hogyan keressen iratanyagot egyszerű és részletes kereséssel, hogyan szűkítse a találatokat, hogyan böngéssze a levéltári struktúrát, és hogyan rendezze, exportálja a találati listát.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- megkülönbözteti a levéltári nyilvántartó rendszert a levéltári segédadatbázistól, és példát hoz mindkettőre;
- önállóan futtat egyszerű keresést az ELP-n, helyettesítő karakterek használatával;
- részletes keresést állít össze több feltételből, ÉS/VAGY/NEM kapcsolatokkal és időkör-megadással;
- böngészi a levéltári struktúrát, és megállapítja egy rekord helyét a hierarchiában;
- a találati listát rendezi, fazettákkal szűkíti, nézetet vált és exportálja.
Bevezetés
Fogalomtisztázás: elektronikus levéltári szakrendszerek
Az elektronikus levéltári szakrendszerek gyűjtőfogalom. A fogalom alatt azon nyilvántartások és segédadatbázisok összességét értjük, amelyek a levéltári iratanyag
- nyilvántartását,
- kutatását,
- online szolgáltatását
tűzik ki célul.
Az elektronikus levéltári nyilvántartásokon belül különbséget kell tenni a levéltári nyilvántartó rendszerek és a levéltári segédadatbázisok között.
Definíció Fogalom: elektronikus levéltári nyilvántartó rendszer
Egy levéltár hivatalos nyilvántartását tartalmazó, esetleg publikáló rendszer. A nyilvántartó rendszerek vezetését legtöbbször jogszabályok, szabványok, belső utasítások határozzák meg. A bennük rögzített iratanyagokat, levéltári egységeket a levéltárban kialakított rend szerint közlik, és azt nem változtathatják meg.
Definíció Fogalom: elektronikus levéltári segédadatbázis
A segédadatbázisok esetében nem kell a levéltárakban kialakított rendet követni: a segédadatbázison szabadon létre lehet hozni egyes tematikus, tárgyi, időrendi gyűjteményeket. A segédadatbázis éppen ezért a levéltári anyag valamilyen szempontból történő csoportosítása, levéltári nyilvántartáson kívüli feldolgozása. Célja egy-egy korszak, történelmi esemény stb. kapcsán a legfőbb dokumentumok összegyűjtése, kutatók és érdeklődők számára elérhetővé tétele.
Ez a fejezet a Magyar Nemzeti Levéltár (MNL) és Budapest Főváros Levéltára (BFL) közös rendszereivel foglalkozik:
- Elektronikus Levéltári Portál (ELP) – nyilvántartó rendszer: ez a fejezet;
- AdatbázisokOnline – segédadatbázisok gyűjtőhelye: lásd az AdatbázisokOnline fejezetet.
Az Állambiztonsági Szolgálatok Történeti Levéltárának (ÁBTL) saját rendszerei – a LIR nyilvántartás és a hozzá kapcsolódó segédadatbázisok – nem tartoznak ide, és nem is kapcsolódnak az ELP-hez; azokat a LIR fejezet tárgyalja. A négy felület viszonyáról a levéltári rendszer fejezet 5. szakasza ad áttekintést.
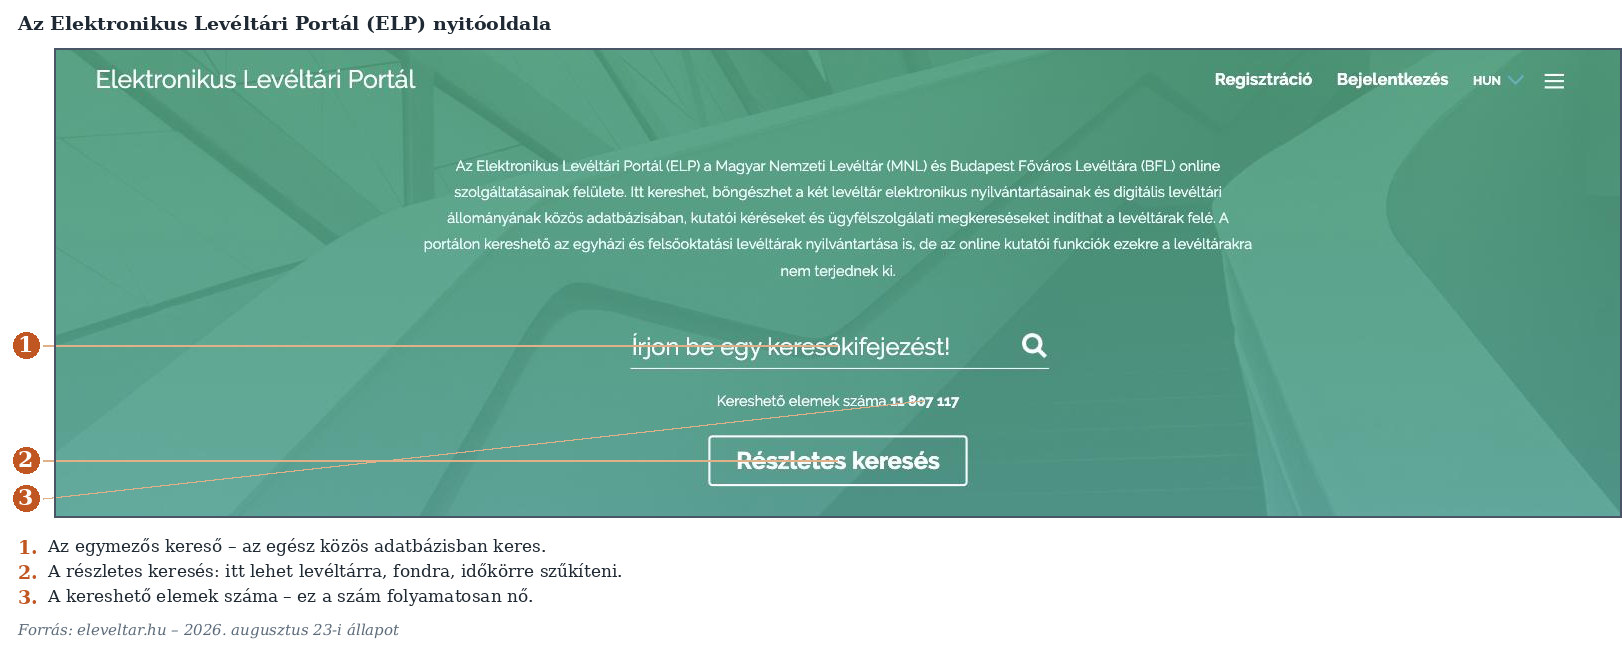
Mi az ELP?
Definíció Fogalom: Elektronikus Levéltári Portál (ELP)
Az ELP a Magyar Nemzeti Levéltár (MNL) és Budapest Főváros Levéltára (BFL) online szolgáltatásainak felülete. Itt kereshet, böngészhet a két levéltár elektronikus nyilvántartásainak és digitális levéltári állományának közös adatbázisában, kutatói kéréseket és ügyfélszolgálati megkereséseket indíthat a levéltárak felé. A portálon kereshető az egyházi és felsőoktatási levéltárak nyilvántartása is, de az online kutatói funkciók ezekre a levéltárakra nem terjednek ki.
Forrás: https://www.eleveltar.hu/home, utolsó megnyitás: 2024. 10. 07.
Az ELP a következő webcímen nyitható meg: www.eleveltar.hu
A fejezet célja bemutatni az ELP-n történő
- iratanyagkeresést,
- a keresések szűkítését,
- a találati listák rendezését és exportálását,
- munkafüzetek létrehozását,
- iratanyagok kikérését.
1. Egyszerű keresés
A böngésző címsorába írjuk be a webcímet: www.eleveltar.hu. A címet beírva az ELP főoldalán középen megjelenő keresőablakban kezdhetjük meg az iratanyagok keresését.
A keresőablakba írjuk be a keresőkifejezést, a keresőszót.
Tipp Helyettesítő karakterek
*– bármennyi karaktert helyettesít?– pontosan egy karaktert helyettesít" "– az idézőjelben szereplő pontos kifejezés vagy szó keresése
Ezek különösen hasznosak a régies vagy ingadozó helyesírású nevek
keresésénél: a Széch?nyi keresőkifejezés például egyszerre
találja meg a Széchenyi és a Széchényi alakot.
A keresés elindításakor (az ENTER-t megnyomva vagy a nagyítóra kattintva) a rendszer automatikusan tovább navigál a Keresés menüpontba.
Az egyszerű keresés lefuttatásához tehát a Keresés oldalon rá kell kattintanunk a Keresés gombra.
2. Részletes keresés
A részletes kereséssel egyszerre több keresési feltételt állíthatunk be.
2.1 Feltételek hozzáadása és törlése
Új feltételt az Új feltétel hozzáadása gombbal tudunk hozzáadni a kereséshez (jobb oldalt alul).
Amennyiben valamelyik feltételre nincs szükségünk, azt az adott feltétel sorának végén, a piros X-szel tudjuk törölni.

2.2 Logikai kapcsolatok
A feltételek között a következő kapcsolatot állíthatjuk be:
- ÉS: a feltételeknek egyszerre kell érvényesülniük;
- VAGY: amennyiben bármelyik érvényesül, az megjelenik találatként;
- NEM: a „NEM” érték utáni feltétel nem teljesülhet a szűréskor.
2.3 Egy feltétel felépítése
Egy-egy feltétel a következő egységekből áll (balról jobbra haladva):
- Az adatmező kiválasztása – azt adhatjuk meg, hogy melyik adatmezőben szeretnénk keresni.
- A reláció – azt adhatjuk meg, hogy a keresőkifejezést a kiválasztott adatmező tartalmazza, azzal kezdődik, vagy pontosan azzal egyenlő.
- A keresőszó vagy kifejezés.

2.4 Időkör megadása
A keresési feltételek alatt bal oldalon adhatjuk meg, hogy mely időkörből keressük az iratanyagot. Az első adatmező az időkör kezdete, a második mező az időkör vége. A formátum: év.hónap.nap.
Példa Egy összetett keresés összeállítása
Az adott keresésnél:
- a megnevezés „1956”-tal kezdődjön, ÉS tartalmazza a „szabadságharc” VAGY „forradalom” kifejezést;
- a jelzete VAGY „HU-MNL-”-lel, VAGY „HU_BFL”-lel kezdődjön;
- a Tartalom mező NE tartalmazza az „ellenforradalom” szót;
- az időkör kezdete 1956.10.23., a vége 1956.11.04.
3. Böngészés a levéltári struktúrában
Az egyes levéltárakon belül az iratanyagok levéltári struktúrában helyezkednek el. A struktúrát az ELP-n belül a Böngészés a levéltári struktúrában kereséssel tudjuk megjeleníteni.
A struktúrában az egyes levéltári szintek a sor elején látható
nyilakkal (>) nyithatók le. Amennyiben egy szintet
lenyitottunk, a nyíl lefelé fog mutatni (v).
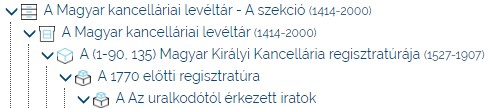
Amennyiben a struktúrában egyszer rákattintunk egy rekordra, megjelennek:
- a részletes adatok;
- a jobb felső sarokban három műveleti ikon, balról jobbra haladva:
- Munkafüzetbe mentés,
- Kosárba helyezés,
- Struktúra szűkítése erre az ágra – az ikonra kattintva a felsőbb szintek eltűnnek, a kiválasztott rekord és az alatta lévő szintek maradnak csak láthatóak a struktúrában.
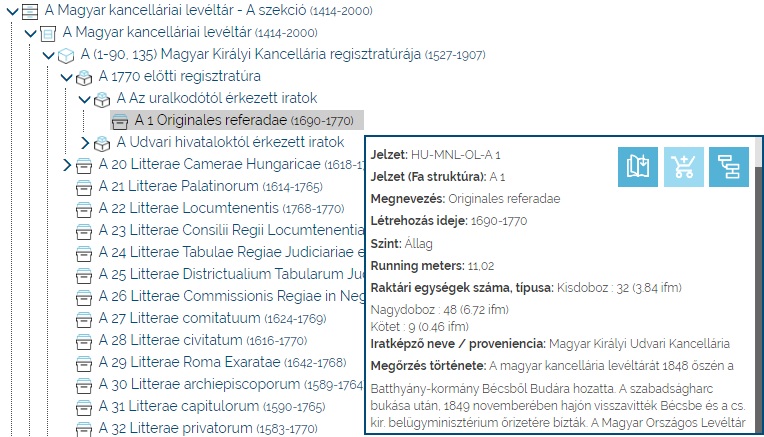
Tipp A struktúrában való böngészés akkor is hasznos, ha a keresés eredménytelen volt. Egy irat kontextusa – hogy melyik fond, állag, sorozat része – gyakran több információt hordoz, mint maga a tétel megnevezése, és a szomszédos rekordok átnézése új találatokhoz vezethet.
4. A találati lista és a találatok
A keresés lefutása után megjelenik a Találati lista, amely tartalmazza a keresés eredményét.
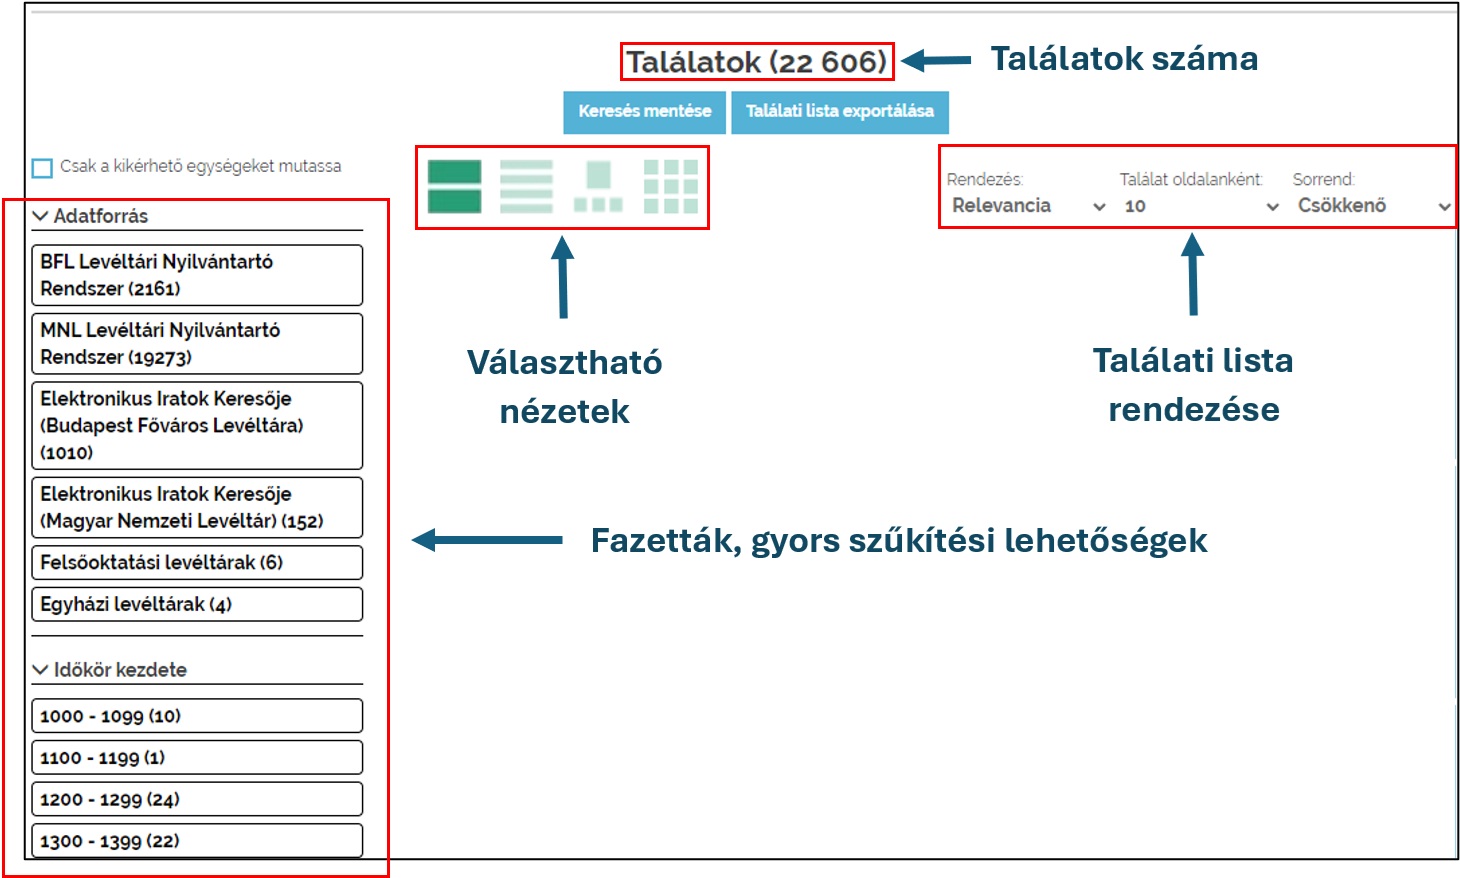
4.1 Választható nézetek
A választható nézetek a következők (balról jobbra haladva):
- Részletes nézet: a legtöbb adat megjelenítése a találati listában;
- Lista nézet: csak a legfőbb adatok megjelenítése;
- Struktúra nézet: a talált rekordok elhelyezése a struktúrában;
- Csempe nézet: a digitális tartalom előnézetének megjelenítése.
4.2 A találati lista rendezése
A rendezésnél (balról jobbra haladva) kiválasztható, hogy:
- mi alapján rendezze a rendszer a találati listát (relevancia, jelzet, megnevezés, struktúra, időkör kezdete, szint);
- mennyi találat jelenjen meg az oldalon (10/20/50/100);
- milyen sorrendben jelenjenek meg a találatok.
4.3 Fazetták
Definíció Fogalom: fazetta
A rendszer által felkínált, találati listával kapcsolatos szűrési lehetőség. Az iratanyag kapcsán előre paraméterezett fazettákkal a lista tovább szűkíthető például adatforrás, időkör vagy irattípus alapján.
4.4 A találatok
A Részletes nézetben a következő adatokkal jelennek meg a találatok:
- Az iratanyag megnevezése kék színnel jelenik meg a találati rekord bal felső részén. A megnevezés egyben link is, amelyre kattintva az iratanyag/találat részletei nyithatók meg.
- A jobb felső sarokban megjelenő ikonok (balról jobbra):
- Elhelyezés a levéltári struktúrában: az egeret az ikonra húzva megtekinthető, hogy az iratanyag hol helyezkedik el a levéltári struktúrán belül;
- Munkafüzetbe helyezés/mentés: az adott rekord elmenthető egy általunk létrehozott munkafüzetbe, ahonnan további műveleteket végezhetünk vele;
- Kosárba helyezés: az iratanyag kosárba helyezhető.
- A találati rekord bal felső sarkában található négyzet kipipálásával több találatot is kijelölhetünk, majd tömegesen kikérhetünk vagy kosárba helyezhetünk.
- A találat címe alatt megtalálhatók az adott iratanyaggal kapcsolatos információk. Az adatok sorában a keresés találati szövegkörnyezete látható.
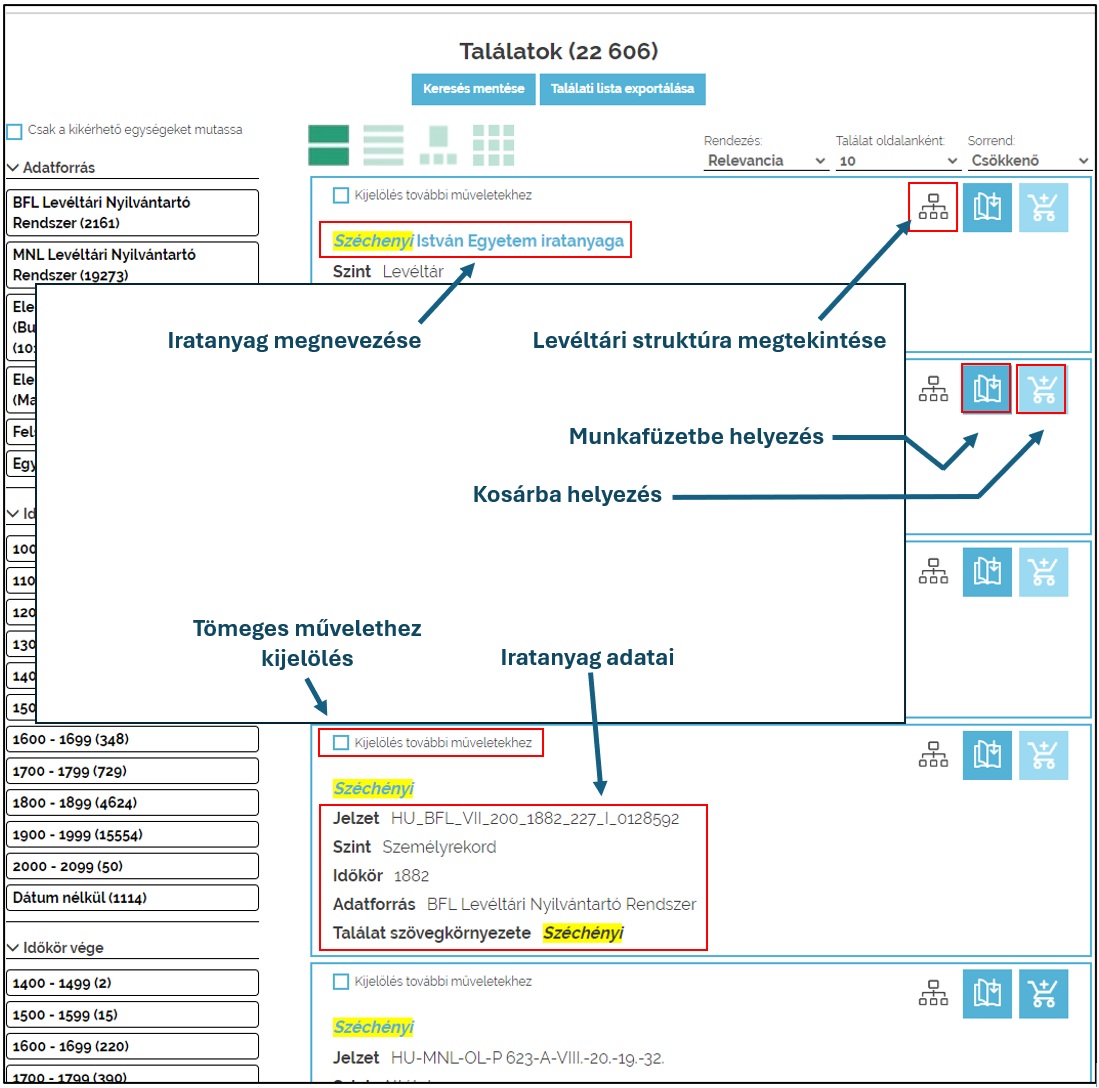
Figyelem A találat nem azonos a forrással. Az ELP találata egy leírási egység: az iratanyagot leíró metaadatrekord, nem maga az irat. Ha van hozzá digitális tartalom, azt megnézheti; ha nincs, a rekord csak azt mondja meg, hogy az irat létezik, és hol keresendő. A dolgozatában mindig a levéltári jelzettel hivatkozzon az iratra, ne az ELP találati oldalára.
5. Hogyan hivatkozzon erre a forrásra?
A levéltári iratra a levéltári jelzettel hivatkozunk. A jelzet felépítése az országkóddal és az intézmény azonosítójával kezdődik, majd a levéltári hierarchia szintjei következnek (fond, állag, sorozat, tétel, iktatószám).
Példa a lábjegyzetben:
HU-MNL-OL-P 1234-2. cs.-15. sz. Az iratot digitalizált formában az Elektronikus Levéltári Portálon értem el: https://www.eleveltar.hu, elérve: 2026. 08. 20.
Gyakorlati feladat
Feladat 1. feladat – Keresés az Elektronikus Levéltári Portálon
Nyissa meg a böngészőben az ELP-t (https://www.eleveltar.hu), majd végezze el a lépéseket és válaszoljon a kérdésekre.
Egyszerű kereséssel keressen rá a Kossuth Lajos keresőkifejezésre. Hány rekordból áll a találati lista?
Kattintson a Részletes keresés-re, majd állítsa be, hogy: Kossuth Lajos maradjon a keresőkifejezés; a keresőkifejezést a Megnevezés mezőben keresse a rendszer; a mező tartalmazza a keresőkifejezést. Hány rekordból áll a találati lista?
Vegyen fel egy új feltételt: a két feltétel között állítsa be a VAGY relációt; a keresőkifejezés Széchenyi István legyen; a Megnevezés mezőben keresse; a mező legyen egyenlő a keresőkifejezéssel. Hány rekordból áll a találati lista?
Törölje a Széchenyi István feltételt, helyette vegyen fel egy új feltételt ÉS relációval; a keresőkifejezés levél legyen; a Teljes szöveg mezőben keresse; azok a rekordok legyenek találatok, amelyek tartalmazzák a kifejezést. Hány rekordból áll a találati lista?
Állítsa be, hogy az időszak kezdete 1801.01.01., vége 1899.12.31. legyen. Hány rekordból áll a találati lista?
A fazetták segítségével állítsa be, hogy a találati listában csak azok az elemek jelenjenek meg, amelyeknél nincs digitális tartalom. Hány rekordból áll a találati lista?
Állítsa be a Találatoknál a Lista nézetet. A találatokból melyik négy mező adattartalma jelenik meg a listában (az oszlopok megnevezése a felső sorban)?
Rendezze a listát: Rendezés: Megnevezés, Sorrend: Növekvő.
Az elkészült listát exportálja a Találati lista exportálása gombra kattintva.
Kérdések az exportált lista kapcsán:
- Mi annak az iratanyagnak a jelzete, amelyben adatot talált Szemere Bertalanról?
- Kossuth Lajos miniszteri iratainak mi az évköre/időköre?
- Hány darab Tétel szintű rekord/iratanyag található a listában?
- Mi annak az iratanyagnak a jelzete és megnevezése, amelyben megtalálható Kossuth Lajos ügyvédi oklevele és bizonyítványai?
- Ebben az iratanyagban mikori a legkorábbi irat?
Önellenőrző kérdések
1. Mi a különbség a levéltári nyilvántartó rendszer és a segédadatbázis között?
Válasz megjelenítése
A nyilvántartó rendszer a levéltár hivatalos nyilvántartását tartalmazza, a levéltárban kialakított rend szerint, amelyet nem változtathat meg. A segédadatbázis szabadon hozhat létre tematikus, tárgyi vagy időrendi gyűjteményeket: a levéltári anyag valamilyen szempontú csoportosítása, a nyilvántartáson kívüli feldolgozása.
2. Melyik két levéltár szolgáltatásainak közös felülete az ELP?
Válasz megjelenítése
A Magyar Nemzeti Levéltáré (MNL) és Budapest Főváros Levéltáráé (BFL). A portálon kereshető az egyházi és felsőoktatási levéltárak nyilvántartása is, de az online kutatói funkciók ezekre nem terjednek ki.
3. Milyen helyettesítő karaktereket használhat az ELP keresőjében?
Válasz megjelenítése
A * bármennyi karaktert, a ? pontosan egy
karaktert helyettesít; az idézőjel (” “) a pontos kifejezés keresésére
szolgál.
4. Mit jelentenek a fazetták?
Válasz megjelenítése
A rendszer által előre paraméterezett szűrési lehetőségek a találati listán (pl. adatforrás, időkör, irattípus szerint), amelyekkel a lista tovább szűkíthető.
5. Igaz-e, hogy az ELP kutatói kéréseinek leadásához előzetes regisztráció és beiratkozás szükséges?
Válasz megjelenítése
Igen. Keresni és böngészni regisztráció nélkül is lehet, de a kutatói kérések leadásához regisztráció és beiratkozás kell.
Összefoglalás
Ebben a fejezetben megismerte a magyar közlevéltári kutatás legfontosabb online belépési pontját. Tisztáztuk az elektronikus levéltári szakrendszerek fogalomkörét, és elkülönítettük a nyilvántartó rendszereket a segédadatbázisoktól. Végigvettük az ELP négy fő munkamódját: az egyszerű keresést helyettesítő karakterekkel, a többfeltételes részletes keresést logikai kapcsolatokkal és időkörrel, a struktúrában való böngészést, valamint a találati lista kezelését (nézetváltás, rendezés, fazetták, exportálás).
A legfontosabb módszertani tanulság: az ELP találata egy leírási egység, nem maga az irat. A digitális felület a kereséshez és a tájékozódáshoz nélkülözhetetlen, de a hivatkozás alapja a levéltári jelzet marad.
Kulcsfogalmak
elektronikus levéltári segédadatbázis – A levéltári anyag valamilyen szempontú, a hivatalos nyilvántartáson kívüli csoportosítása, tematikus vagy időrendi gyűjteményekbe rendezve.
elektronikus levéltári nyilvántartó rendszer – Egy levéltár hivatalos nyilvántartását tartalmazó, jogszabályok és szabványok szerint vezetett rendszer.
fazetta – A rendszer által felkínált, előre paraméterezett szűrési lehetőség a találati listán.
leírási egység – A levéltári nyilvántartás egy rekordja, amely egy adott szintű iratanyagot (fond, állag, sorozat, tétel, darab) ír le.
levéltári jelzet – Az iratanyag szabványos azonosítója, amely az országkódot, az intézmény azonosítóját és a hierarchia szintjeit tartalmazza.
levéltári struktúra – A levéltári anyag hierarchikus rendje, amely a fondtól az egyes iratokig tagolja az állományt.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Elektronikus Levéltári Portál – Súgó és bemutatkozás. https://www.eleveltar.hu/home (elérve: 2024. 10. 07.)
Linkek és eszközök
- Elektronikus Levéltári Portál – https://www.eleveltar.hu – elérve: 2026. 08. 20.
- Magyar Nemzeti Levéltár – https://mnl.gov.hu/ – elérve: 2026. 08. 20.
- Budapest Főváros Levéltára – https://bparchiv.hu/ – elérve: 2026. 08. 20.
Levéltári Információs Rendszer (LIR)
| Szerző(k) | Havasi-Mészáros Dániel |
| Becsült feldolgozási idő | 60 perc |
| Előfeltétel | Mi a forrás?, Elektronikus Levéltári Portál |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszköz alapadatai
| Eszköz neve | Levéltári Információs Rendszer (LIR) |
| URL | https://lir.abtl.hu/ords/r/abtl/liron/home |
| Üzemeltető | Állambiztonsági Szolgálatok Történeti Levéltára (ÁBTL) |
| Hozzáférés | Ingyenes; a publikus tartalom bejelentkezés nélkül is elérhető, bővebb tartalom bejelentkezést követően |
| Regisztráció | A kutatási kérelem pozitív elbírálását követően az intézmény végzi el a kutató regisztrációját és felhasználói profiljának elkészítését |
| Tartalomtípus | Levéltári leírási egységek és személyrekordok metaadatai |
| Időkörök | 1944–1990 (a levéltár őrzési köre) |
| Indulás | 2024. július 30. |
Miről szól ez a fejezet?
Arról, hogy a LIR hogyan viszonyul a többi levéltári felülethez – az ELP-hez, az AdatbázisokOnline-hoz és a levéltárak saját oldalaihoz –, a levéltári rendszer fejezet 5. ábrája ad áttekintést.
Ez a fejezet a Levéltári Információs Rendszert (LIR) mutatja be, amely az Állambiztonsági Szolgálatok Történeti Levéltárának (ÁBTL) online levéltári információs rendszere, és a levéltárban őrzött iratanyagok, valamint a hozzájuk kapcsolódó információk keresését és megismerését teszi lehetővé. A rendszer célja, hogy a kutatók és az érdeklődő állampolgárok számára korszerű, online felületen biztosítsa a levéltári anyagokhoz kapcsolódó információk elérését. A LIR különböző hozzáférési szinteken kezeli a nyilvános és a korlátozottan hozzáférhető adatokat, ezáltal az adatvédelmi követelményeknek is megfelel.
A fejezet egyben esettanulmány arra, hogy egy levéltári adatbázis felépítése maga is szerkesztői döntések sorozata – és hogy ezek a döntések befolyásolják, mit talál meg a kutató.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- elhelyezi a LIR-t a magyar levéltári e-kutatási szolgáltatások történetében, és megnevezi, mi különbözteti meg az ÁBTL helyzetét a többi levéltárétól;
- megkülönbözteti a LIR négy keresési módját (egyszerű keresés, összetett keresés, személykereső, hierarchiaböngésző), és megmondja, melyiket mikor érdemes használni;
- megmagyarázza, miért lát egy bejelentkezés nélküli felhasználó kevesebb adatot, mint egy tudományos kutató, és mely jogszabály áll emögött;
- eszközkritikai szempontból értékeli, hogy egy adatbázis publikálási döntései (mi minősül publikusnak) hogyan befolyásolják a kutatási eredményt;
- helyesen hivatkozik egy ÁBTL-iratra a levéltári jelzet alapján.
Bevezetés
A nagyközönség számára láthatatlan erők feszülnek egymásnak a levéltárakban, ahol két jog összecsapása zajlik: egyrészt hogy a nagyközönség a lehető legszélesebb körben ismerhesse meg az adott intézmény által őrzött iratanyagokat, másrészt hogy az iratokban található, jogszabályokban meghatározott személyes adatok védelmét is garantálni kell.6
Ez a feszültség adja a fejezet keretét. A LIR nem egyszerűen egy keresőfelület: egy olyan kompromisszum eredménye, amelyben a levéltár egyszerre próbál minél többet megmutatni és minél kevesebbet kockáztatni.
1. Előzmény: e-kutatás a magyar levéltárakban
Elsőként a Kalocsai Főegyházmegyei Levéltár indította el e-kutatási szolgáltatását 2010 végén, amely kezdeményezésből a Magyarországi Egyházi Levéltárosok Egyesületének gondozásában 2015-ben elindulhatott a Matricula nevű oldal, amely egy helyen gyűjtötte össze a magyarországi egyházi levéltárak e-kutatási szolgáltatásait. Csatlakozott a Váci Püspöki és Káptalani Levéltár (2015), a Veszprémi Főegyházmegyei Levéltár (2016), a Pécsi Egyházmegyei Levéltár (2018) és a Székesfehérvári Püspöki és Székeskáptalani Levéltár (2019). 2015-ben a Magyarországi Evangélikus Egyház keretei között debütált az Őskereső is.7
A felsorolt egyházi levéltárak szolgáltatásaik keretében túlnyomó többségében különféle (születési, keresztelési, bérmálási, házassági és halálozási) anyakönyveket tettek elérhetővé. Ezen iratanyagok közzététele több szempontból is szerencsés: egyrészt a családfakutatók elsődleges forrásai, és a kutatók viszonylag könnyen ki tudják keresni a számukra releváns információkat; levéltári oldalról pedig azért is jók, mert a bennük szereplő adatok védelmi idejét egységesen lehet megállapítani.8
Hasonló tematika mentén indult el az AdatbázisokOnline is, amely jelenlegi formáját 2020-ban nyerte el, de elődjét a Magyar Országos Levéltár már 2009-ben elindította. Jelenleg 21 levéltár 61 adatbázisa közvetlenül kereshető, további 151 adatbázis eléréséhez pedig információt kaphatnak a kutatók. A felsorolásból a Hungaricana közgyűjteményi portált sem hagyhatjuk ki, ahol számos levéltár és más közgyűjtemények anyagai is megtekinthetők (lásd a Hungaricana fejezetet).9
A közlevéltárak közül az ÁBTL indította el elsőként – előbb 2020 elején kísérleti jelleggel, majd 2021 elején hivatalosan is – az e-kutatás szolgáltatását.10
2. Miért különleges az ÁBTL helyzete?
Az ÁBTL őrzi többek között a BM III. Főcsoportfőnökség iratait, amelyek iránt a rendszerváltás óta hullámzó, de töretlen a társadalmi érdeklődés. A szocialista korszak titkosszolgálatai által keletkeztetett iratok számos személyes és különleges adatot tartalmaznak, amelyek nagyközönség általi megismerhetősége igencsak nehézkes a hatályos adatvédelmi jogszabályok miatt. Ezeket az iratokat még a tudományos kutatók számára történő kiadás előtt is át kell olvasniuk a referenseknek, és anonimizálniuk kell a védelmi idő alá eső egészségügyi, kóros szenvedélyre, szexuális irányultságra utaló információkat.11
Ebből következik, hogy az ÁBTL esetében nem lehetséges az iratok olyan módon való közzététele az interneten, mint az egyházi levéltárak vagy az AdatbázisokOnline tartalmai esetében. Az iratanyagok kétharmadát ugyanis dossziék teszik ki, amelyek a legkülönbözőbb témákra vonatkozóan tartalmaznak információkat, valamint számos személyes és szenzitív adatot is. Ezért alakult ki az az eljárás, hogy a kutatónak minden egyes alkalommal ki kell kérnie a kutatni kívánt iratanyagot, amelyet azok referense előolvas (szükség esetén anonimizál is), illetve eldönti, hogy az beletartozik-e az adott kutatás tematikájába.12
Figyelem Az online kutatás nem csak nyereség
Az e-kutatás bevezetése a levéltár számára kockázatokkal is jár: lazul vagy megszűnik a kutató és a referens kapcsolata, így a levéltár elveszíti az „iratanyagok hasznosulásának nyomon követését”; a kutatók számára nem áll rendelkezésre helyszíni levéltárosi segítség; és felmerül annak veszélye, hogy egyes kutatók csupán azon iratokat felhasználva írják meg értekezéseiket, amelyekre az adatbázisok alapján rábukkannak – ami szükségképpen torzuláshoz vezet.13
Ez pontosan az a jelenség, amit a Digitális bölcsészet fejezetben eszközkritikának neveztünk: a keresőfelület nemcsak megtalálja, hanem ki is jelöli a forrásbázist.
3. A LIR elindulása és előzményei
Az e-kutatást átmeneti megoldásnak szánta az ÁBTL. A weboldal tervezésére kevés idő és anyagi erőforrás állt rendelkezésre; azt teljes egészében a levéltár egyik informatikusa fejlesztette Drupal 7 CMS-ben, amelynek supportja 2025 januárjában járt le. A support nélkül maradt oldal tanúsítványok hiányában védtelen lett volna egy esetleges hackertámadás esetén, és ezt az információbiztonsági kockázatot nem vállalhatta az intézmény.14
Az e-kutatás felületén a kutató a számára jóváhagyott iratanyag digitális kutatói példányát olvashatta: azt a másolatot, amelyet a referens előolvasás és – ahol szükséges volt – anonimizálás után engedett ki. A képen látható lapozó a dosszié 643 oldalát mutatja, a vízjel pedig magán a képen jelzi a példány eredetét.
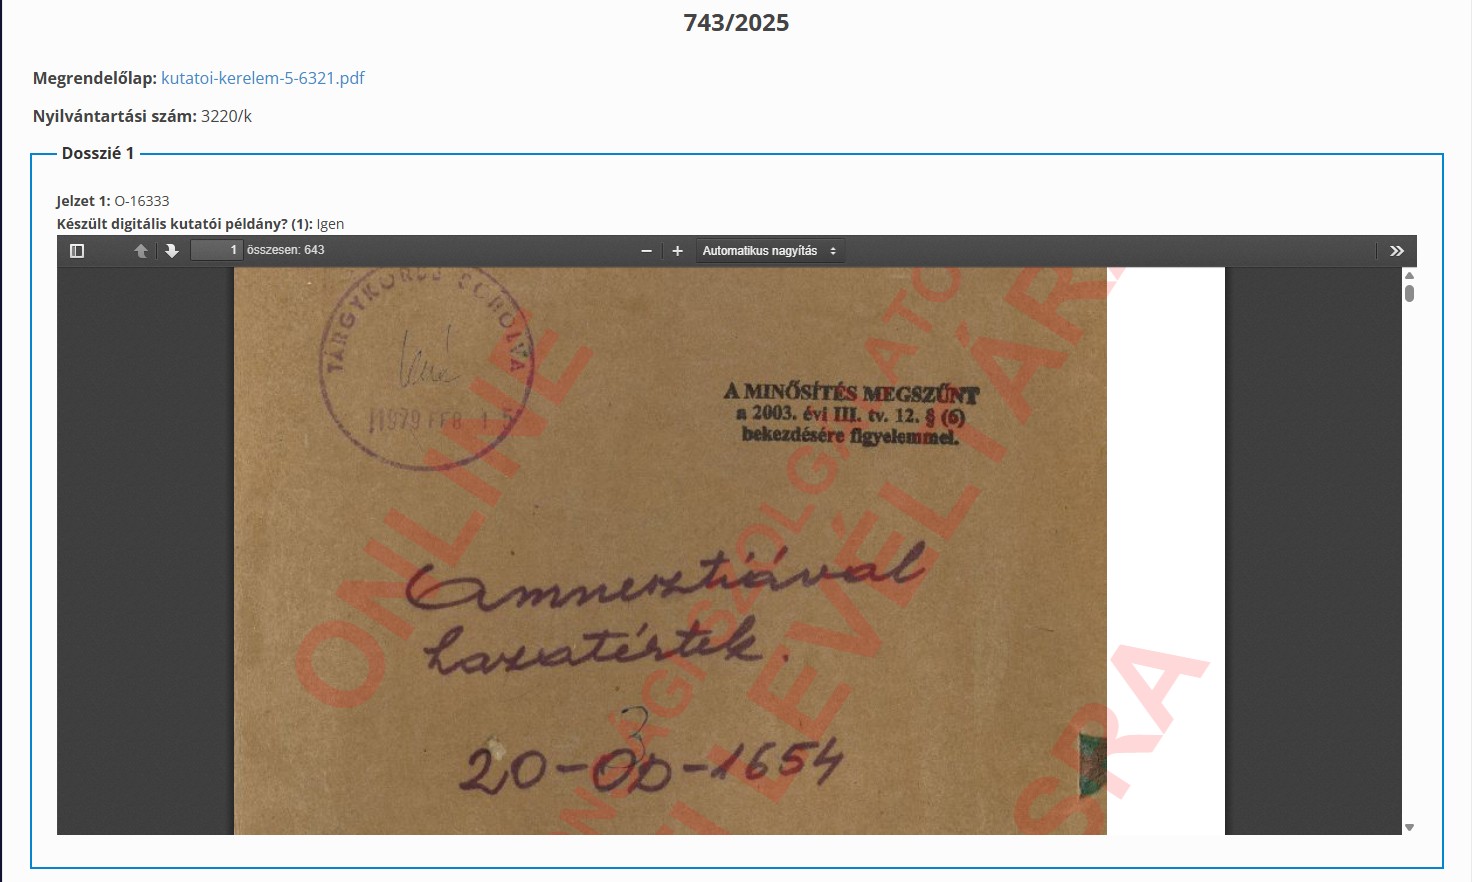
2024 nyaráig az átlag állampolgár az ÁBTL őrzésében lévő iratokról csak a honlapon elérhető fond- és állagjegyzék, illetve az oda feltöltött PDF-ek alapján tudott tájékozódni. A tudományos kutatók az e-kutatáson felül hozzáfértek a SpyOne nevű oldalhoz is, ahol személyek, illetve iratanyagok metaadatai alapján indíthattak iratkereséseket. Az oldalon azonban külön személykereső nem volt, csak az ügyirat/dosszié szintű leírási egységek és azok metaadatai jelentek meg, a találati listákat nem lehetett szűkíteni, és egy leírási egység részletes nézetében nem látszott az irat helye a levéltári struktúrában.15
A változás 2024. július 30-án következett be, a Levéltári Információs Rendszer elindulásával. A nevezett adatbázishoz minden érdeklődő szabadon hozzáférhet; az egyszerű és összetett keresési módok mellett a direkt személykeresés is elérhetővé vált, illetve ide költözött át az ÁBTL honlapjáról az élő fond- és állagjegyzék is.16
Mivel az új adatbázisban minden szintű leírási egység megtalálható, a találati listákban akár több szintű leírási egységek is megjelenhetnek, több szempont alapján (szintek, évkörök, földrajzi helyek, tárgyszavak) szűrhetők, sőt exportálhatók is (CSV, Excel vagy PDF formátumban).17
4. Mi előzte meg a rendszer indulását?
Mélyebben Adatbázis-építés a színfalak mögött
Az ÁBTL összesen mintegy 4600 iratfolyóméternyi anyagot őriz, amelynek nagyjából kétharmadát dosszié típusú iratok teszik ki. A levéltár korábban állagszint alatt nem rendelkezett böngészhető levéltári hierarchiával, egy-két irategyüttest leszámítva.18
Miért fontos ez? A LIR elindulásáig az ÁBTL kutatói digitális iratkereséseik során meg voltak fosztva annak lehetőségétől, hogy egyből lássák, egy adott irat pontosan hol helyezkedik el a levéltári hierarchiában – ami nélkülözhetetlen az iratok kontextusának megértéséhez.
Az ÁBTL negyedmillió dosszié/ügyirat típusú leírási egységéből körülbelül 70 000 darab besorolása történt meg 2018-ig. A teljességre törekvő digitális struktúra építése ebben az évben indult, és az addig felvett rekordok besorolása három évig tartott: e folyamat során 180 000 dosszié/ügyirat került a helyére. A feladat nem csupán a rekordok hierarchiába sorolásáról szólt: sok esetben az állag alatti struktúrát is ki kellett alakítani, mert a raktári nyilvántartások nem egyértelműen definiálták, milyen rekordtípusnak felelnek meg az ügyirat fölött álló levéltári szintek.19
Az adatbázis másik értékes objektuma az iratokban megemlített személyek rekordja: jelenleg valamivel több mint egymillió személyrekord található az adatbázisban, amelyeken a jobb kereshetőség érdekében adattisztítást végeztek.20
A tanulság a kutató számára: amikor egy adatbázisban keres, nem „az iratanyagban” keres, hanem abban a struktúrában, amelyet a levéltárosok felépítettek – és amely folyamatosan épül tovább.
5. Hozzáférés és jogosultsági szintek
A LIR használatához a tudományos kutatók profilt kapnak. A profil aktiválása után kétféle belépési mód választható: a Központi Azonosítási Ügynökkel (KAÜ) történő belépés, illetve autentikátor segítségével történő kétfaktoros azonosítás.21
Miért ilyen szigorú a belépés? Egyfelől jogszabályi változások történtek, másfelől az új rendszerben több adat érhető el, strukturáltabban, jobban kereshető formában. A rendszer tervezésekor az információbiztonsággal megbízott vállalkozás magas (4-es) szintűnek ítélte meg a kiberbiztonsági besorolást a benne tárolt személyes és szenzitív adatok sokasága miatt; a követelmények szintjére lefordítva ez KAÜ-integrációt vagy kétfaktoros azonosítás használatát írta elő.22
5.1 Ki mit lát?
A tudományos kutatói jogkörrel rendelkező felhasználók a bejelentkezést követően minden leírási egységet és személyrekordot láthatnak. Ezzel szemben a bejelentkezés nélküli felhasználók csak a publikusként megjelölt rekordokat.23
Az adatbázis-építés során minden leírási egységet és minden személyrekordot elláttak minősítővel: a leírási egységeknél sorozatszintig publikusra állították, minden más esetben nem publikusra. Számos iratanyag tárgya ugyanis neveket tartalmaz, amelyeket a személyes és különleges adatok védelme miatt nem lehet közzétenni. A levéltár azonban törekszik arra, hogy az átlagos érdeklődő a lehető legtöbb adathoz juthasson hozzá, ezért célul tűzte ki, hogy folyamatosan felülvizsgálja és publikussá teszi iratanyagainak metaadatait.24
Az adatbázis 114 510 publikus személyrekorddal indult el. Ez a szám a következő személyek halmazából tevődött össze: mindazok, akik a BM hivatalos alkalmazottai voltak és az ÁBTL archontológiai adatbázisában szerepelnek (lásd az Állambiztonsági archontológia fejezetet); vagy legalább 30 éve elhaláloztak; illetve – ha a halálozási dátum nem volt ismert – akiknek a születési évétől már több mint 120 év telt el.25
Mit jelent ez a gyakorlatban? A következő két képen ugyanaz a fond – az Állambiztonsági munkához készült háttéranyagok (A-anyag) – szerepel, egyszer bejelentkezés nélkül, egyszer tudományos kutatói jogkörrel. A publikus nézetben a fond neve látszik, de alatta nem nyílik tovább a fa; a kutatói nézetben megnyílnak az alatta álló leírási egységek a jelzetükkel és tárgyukkal együtt.
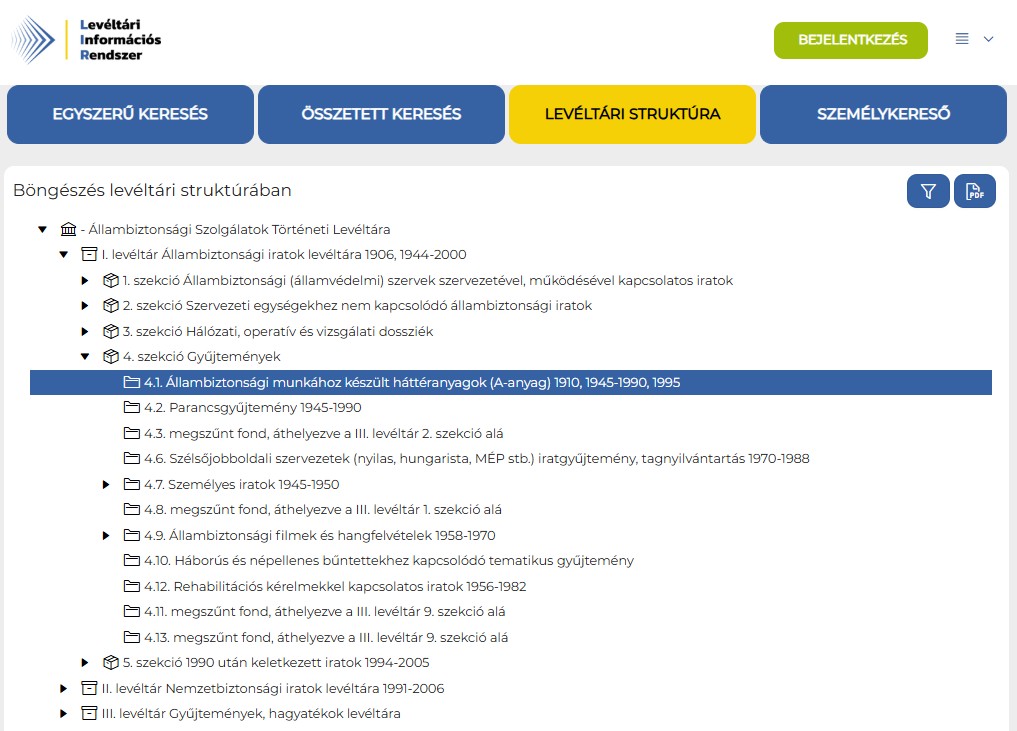
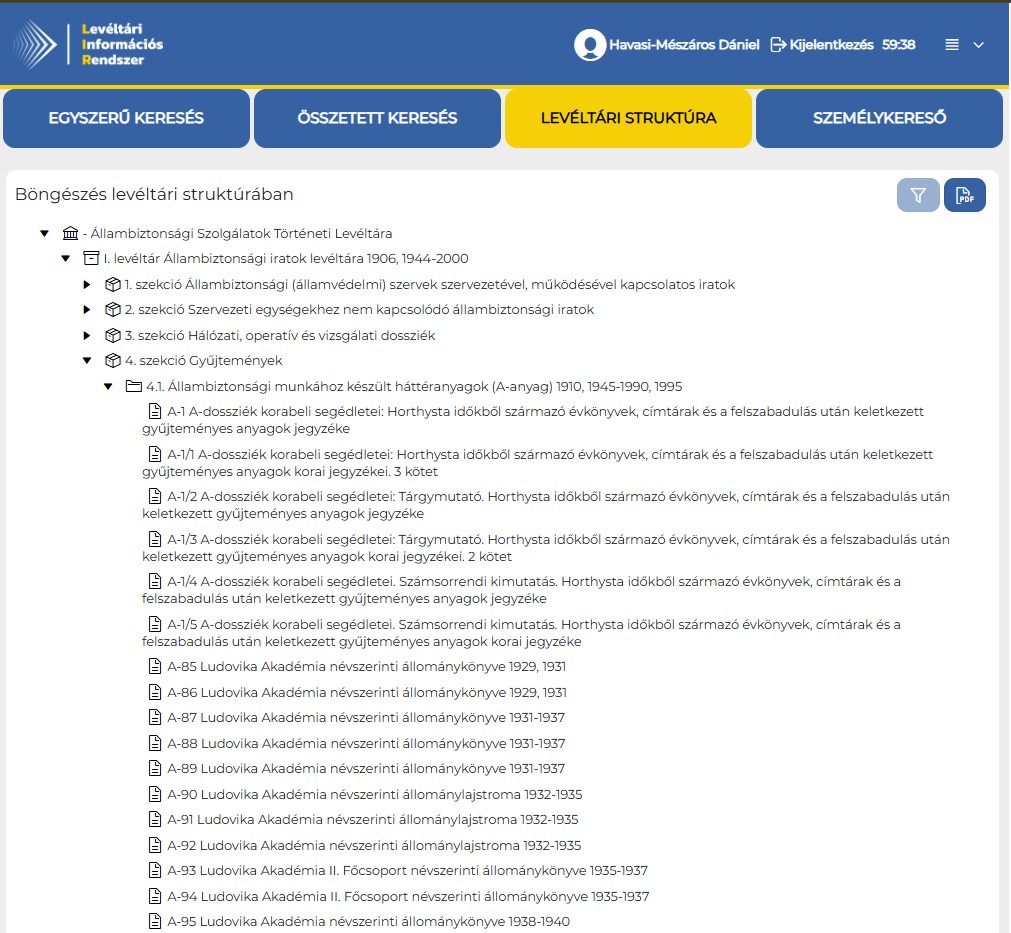
Figyelem Ugyanaz a keresés, más eredmény
A védendő adatok miatt a személykereső eltérő eredményeket hoz ugyanarra a keresési kifejezésre attól függően, hogy tudományos kutatói vagy átlagos felhasználói jogkörrel végezzük el.26 Ha tehát egy szakirodalmi hivatkozás alapján keres valamit, és nem találja, az nem feltétlenül jelenti azt, hogy nincs az adatbázisban – lehet, hogy csak az Ön jogosultsági szintjén nem látszik.
6. Keresési módok a LIR-ben
A rendszerben négy fő működésmód választható: egyszerű keresés, összetett keresés, személykereső és hierarchiaböngésző.27
6.1 Egyszerű keresés
Az egyszerű keresés menü használatával (a keresőmezőbe írt kifejezéssel) szabad szavas keresést tudunk indítani. Keresendő kulcsszóként épp úgy megadhatunk személynevet, mint eseményt, tárgyszót vagy helyszínt. E keresés során a program a leírási egységek következő metaadatai között keres: „jelzet”, „tárgy”, „kivonat”, „irat évköre” és „téma évköre” mezők.28
Tipp A keresősávba beírt kulcsszavaknál
alkalmazhatók a helyettesítő karakterek (* és
?), illetve a többszavas keresőkifejezés pontos keresésére
szolgáló idézőjelek („ ”). Ezt az általános keresési formát első
tallózáshoz ajánljuk. Mivel több mező adataiban is keres,
előfordulhat, hogy az eredmény túlságosan széles spektrumú lesz –
ilyenkor a találati listát a szűrők segítségével pontosíthatjuk.
6.2 Összetett keresés
Ha határozottabb elképzelésünk van arról, hogy hol és mit keresünk, akkor érdemes lehet az összetett keresést vagy a levéltári struktúra böngészését használni. Az összetett keresés során egy vagy több mezőben tudunk megadni keresőkifejezéseket; ennek segítségével kereséseinket specifikussá tehetjük.
Figyelem Az egyszerű kereséssel ellentétben az összetett keresés csak a megadott mezőben fut le (például „jelzet”, „tárgy”, „évkör(ök)”, „település”). Minél több adatot ad meg a keresés elindítása előtt, annál pontosabb találati listát kap.29
A keresőmezők többsége szabad szavas keresést tesz lehetővé, azonban némelyik mező (például „ország”, „megye”, „település”) választólistával segíti a kutatást.30
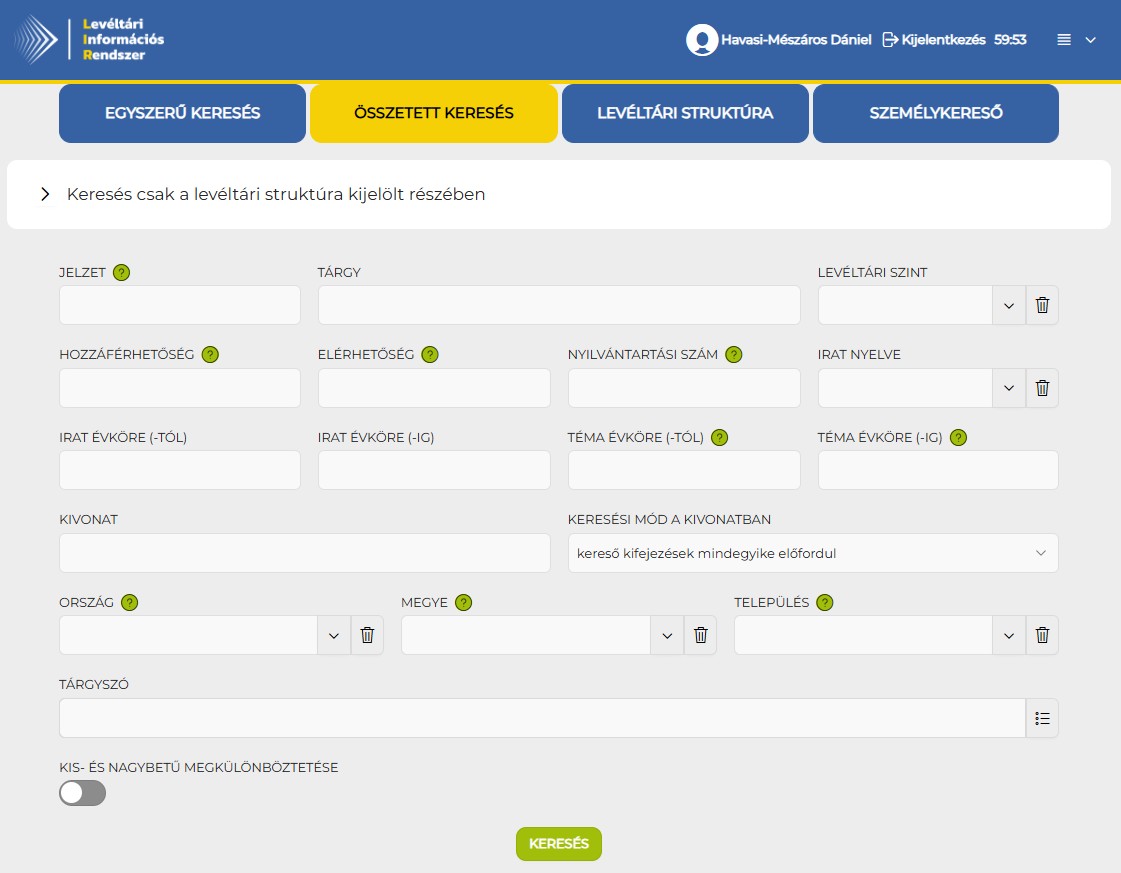
6.3 A találati lista kezelése
A kapott találati listán szerepelnek a keresési eredményeink, amelyeket a bal oldali sávban elhelyezett szűrőkkel tovább árnyalhatunk. Ezek az úgynevezett dinamikus szűrők csak olyan szűrési feltételeket ajánlanak fel, amelyek megtalálhatók az adott találati halmazban. Ez a gyakorlatban azt jelenti, hogy a „település” szűrő például csak akkor ajánlja fel a Budapest kifejezést, ha a találati listánkban van olyan leírási egység, amelyben szerepel települési metaadatként Budapest.31
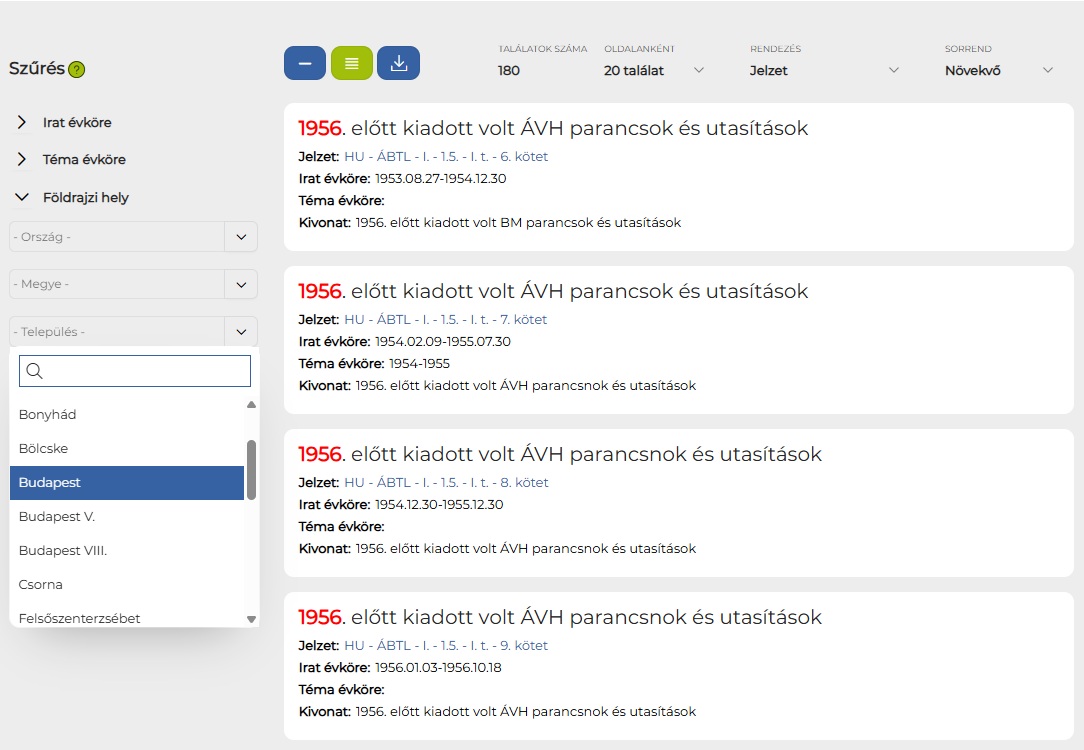
A találati listát kétféle módon tudjuk böngészni: táblázatos, illetve részletes megjelenítési módban. Emellett letölthetjük az aktuálisan megjelenített oldal találatait, illetve különböző paraméterek szerint sorba is rendezhetjük keresésünk eredményeit.32
6.4 Személykereső
A személykereső az összetett kereséshez hasonlóan akár több mező adatai alapján történő kombinált keresést is lehetővé tesz. Kereshető adatok: „név”, „anyja neve”, „születési név”, „a születés helye és ideje”, „foglalkozás”, korabeli „lakcím (település)”, illetve „a halálozás helye és ideje”.33
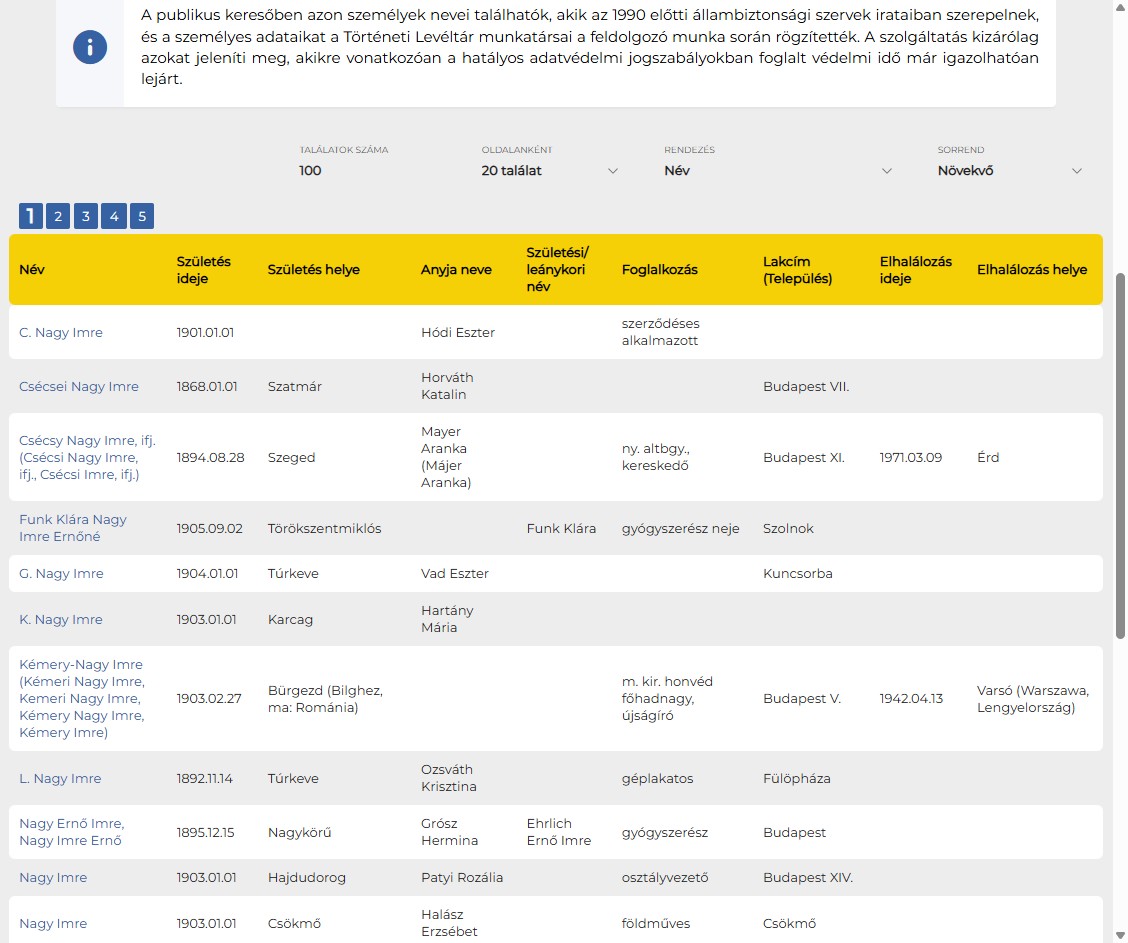
Ha egy adott személyrekord részletes nézetét egy tudományos kutató nyitja meg, akkor ő a részletes adatokon túl azt is látja, hogy az adott illető mely leírási egységekhez kapcsolódik.34
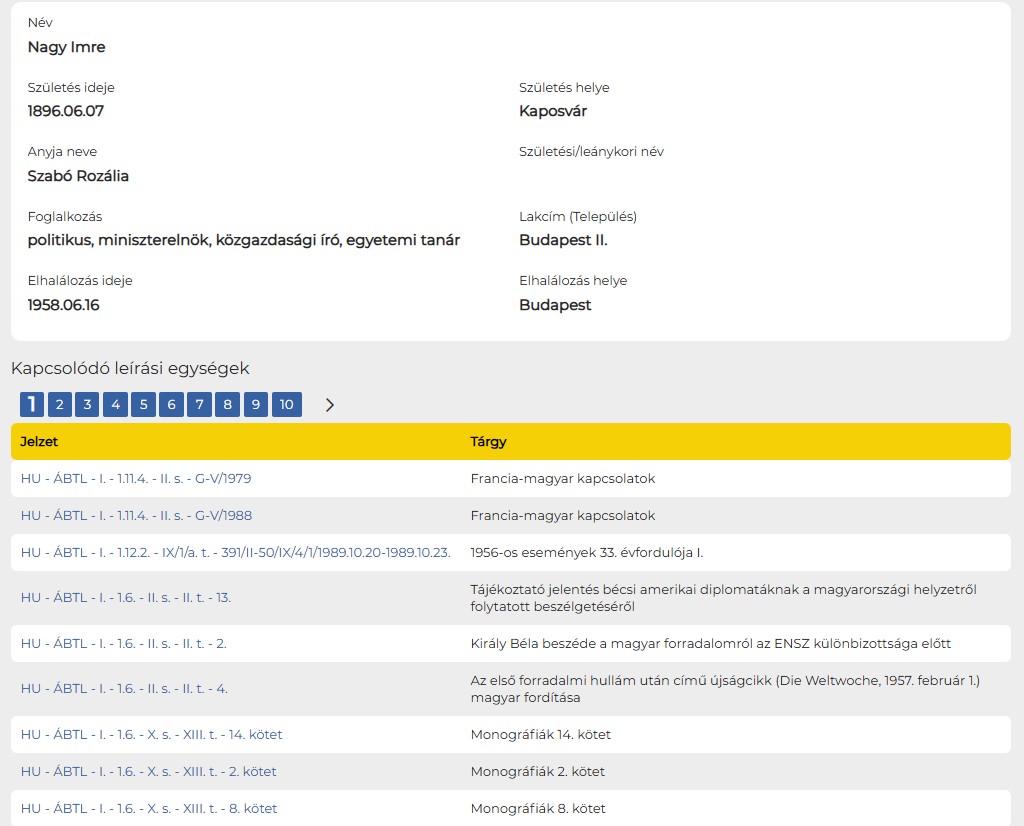
Mélyebben A személykereső azért is lett mindenki számára elérhető, mert a levéltár abban bízik: ha valaki megtalálja saját magát vagy egy felmenőjét, akkor nagyobb valószínűséggel keresi meg az intézményt iratbetekintési – vagy akár kutatási – kéréssel, hiszen már tudja, hogy megkeresése pozitív eredménnyel jár.35
A publikus felületen csak azoknak a személyeknek a rekordjai jelennek meg, akiknek az adatai kívül esnek a védendő adatok körén. A bejelentkezés nélküli felületen a személykereső modulban erre emlékeztet az alábbi szöveg is:
„A publikus keresőben azon személyek nevei találhatók, akik az 1990 előtti állambiztonsági szervek irataiban szerepelnek, és a személyes adataikat a Történeti Levéltár munkatársai a feldolgozó munka során rögzítették. A szolgáltatás kizárólag azokat jeleníti meg, akikre vonatkozóan a hatályos adatvédelmi jogszabályokban foglalt védelmi idő már igazolhatóan lejárt.”
6.5 Hierarchiaböngésző
Az intézmény aktuális fond- és állagjegyzékében a levéltári leírások hierarchikusan épülnek fel, és ezt a struktúrát tükrözi az adatbázis is. A megfelelő fond vagy állag megtalálása után annak tartalma sokszor a levéltári struktúra böngészésével tekinthető át a legjobban. Sorozatszintig mindenki megismerheti az itt közzétett adatokat és az adott szinthez tartozó segédleteket.36
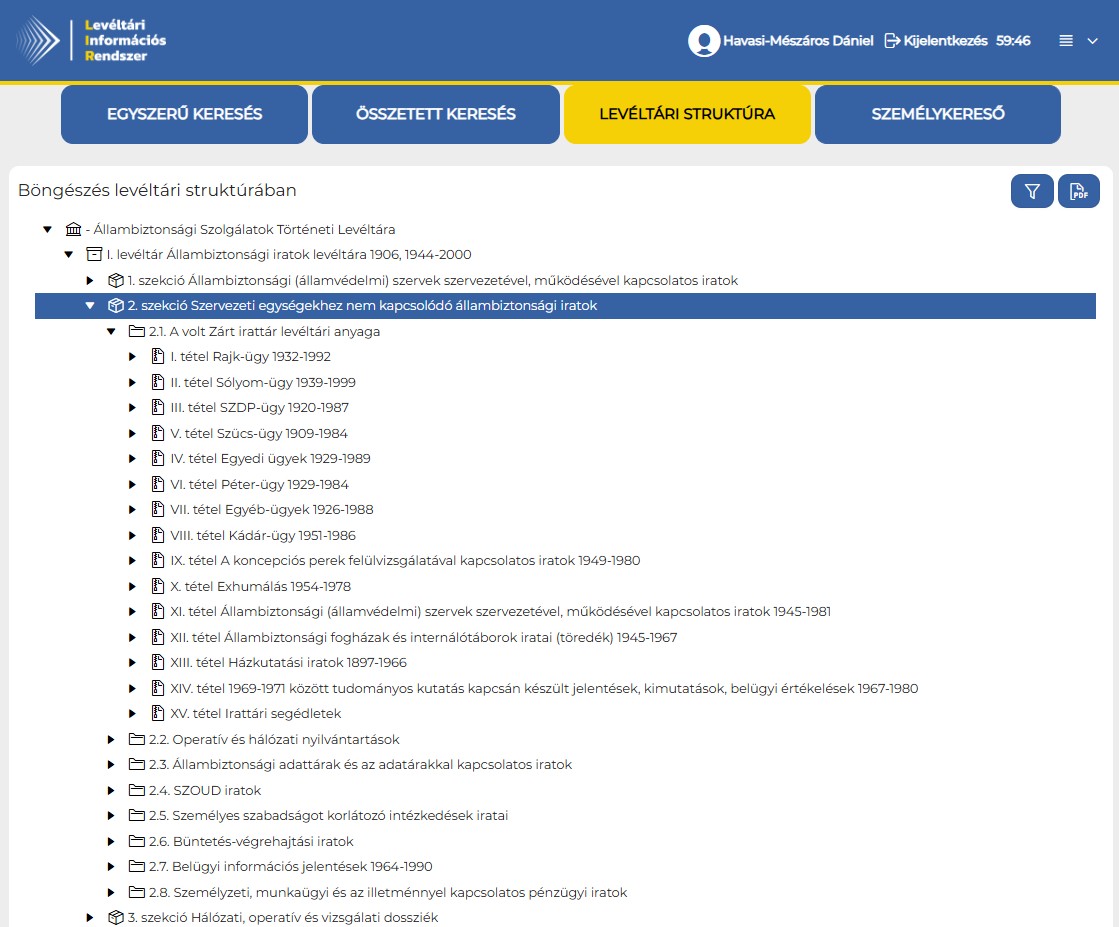
7. Az ÁBTL többi online felülete
A LIR az ÁBTL nyilvántartása: azt mondja meg, milyen leírási egységekről és személyrekordokról van információja a levéltárnak. Emellett az ÁBTL több olyan tematikus segédadatbázist is üzemeltet, amely egy-egy korszakot, eseményt vagy kérdéskört dolgoz fel – ezekkel ebben a könyvben külön fejezetekben is foglalkozunk. Ezek nem a nyilvántartás részei, hanem annak feldolgozásai – ezért ugyanaz vonatkozik rájuk, mint minden segédadatbázisra: odavezetnek a jelzethez, de nem helyettesítik.
| Felület | Mit ad? | Hol tárgyaljuk? |
|---|---|---|
| Állambiztonsági archontológia | az állambiztonsági szervek tisztségviselői, beosztástörténettel | Állambiztonsági archontológia |
| Topotéma – Állambiztonsági helyeken | az állambiztonsághoz köthető budapesti helyszínek térképen | Térbeli adatbázisok 3. szakasza |
| Tüntetések, demonstrációk 1988–1989 | a rendszerváltás tüntetéseinek forrásközlő idővonala | Tüntetések, demonstrációk |
Figyelem Ezek mind az ÁBTL felületei – nem az MNL-éi. Külön kell keresni bennük, és a LIR-ben talált leírási egység nem feltétlenül szerepel a segédadatbázisokban (és fordítva). Ha egy személyt vagy eseményt keres, érdemes mindegyiket végignézni.
8. Hogyan hivatkozzon erre a forrásra?
Az ÁBTL-iratokra a rajtuk feltüntetett levéltári jelzet megadásával hivatkozunk. A jelzet minden esetben tartalmazza az országkódot (HU), az intézmény azonosítóját (ÁBTL), az adott levéltári törzsszámot, alsóbb leírási egységeknél pedig tartalmazhatja a sorozat- és/vagy tételszámot és azok rövidített jelét (s./t.), valamint az irat iktatószámát.37
Példa lábjegyzetben:
HU – ÁBTL – I. – 2.1. – XII/7. tétel
A jelzet elemei balról jobbra: az ország (HU), az intézmény (ÁBTL), a levéltár (I.), az állag (2.1.) és a tétel (XII/7.). A LIR minden leírási egység részletes nézetében kiírja a teljes jelzetet, fölötte pedig megmutatja az egység helyét a levéltári struktúrában – innen másolható ki pontosan.
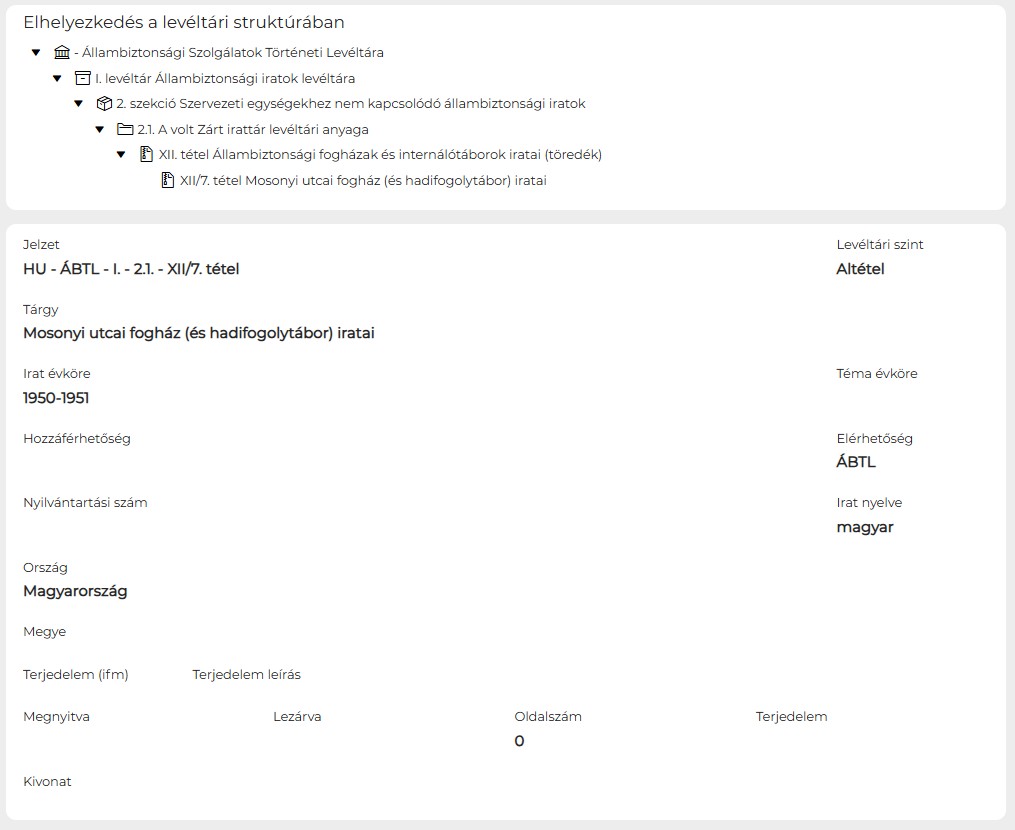
Figyelem Néhány esetben a levéltári jelzetek ma már pontosabbak, mint korábban: volt olyan irategyüttes, amely rendezésen esett át. Mindig az aktuális jelzetet ellenőrizze a LIR-ben, ne a régebbi szakirodalomból átvettet.
Gyakorlati feladat
Feladat 1. feladat – Publikus és nem publikus adatok
Nyissa meg a LIR-t bejelentkezés nélkül (https://lir.abtl.hu/ords/r/abtl/liron/home).
Futtasson le egy egyszerű keresést egy Önt érdeklő tárgyszóra vagy eseménynévre. Jegyezze fel a találatszámot.
Nyisson meg egy találatot részletes nézetben. Milyen metaadatokat lát? Melyik szintű leírási egységről van szó?
Böngéssze végig a hierarchiában felfelé az adott rekord fölött álló szinteket. Mit tudott meg az irat kontextusáról, amit a találati listából nem?
Írja le két-három mondatban: mit nem lát ezen a jogosultsági szinten, és miért? Melyik jogszabály áll emögött?
Elvárt formátum: kb. 250 szavas szöveg, a találati adatokkal és egy képernyőképpel.
Feladat 2. feladat – Eszközkritikai reflexió
Olvassa el a fejezet 5. szakaszát, majd válaszoljon írásban:
Tegyük fel, hogy egy szemináriumi dolgozatot ír, amelyhez kizárólag a LIR publikus felületén talált iratokat használja. Milyen rendszerszintű torzítás kerülhet így a dolgozatába? Fogalmazzon meg két konkrét torzítási forrást, és mindegyikhez javasoljon egy ellenlépést.
Elvárt formátum: egy bekezdésnyi (kb. 200 szavas) érvelés.
Önellenőrző kérdések
1. Mikor indult el a LIR, és mit váltott ki?
Válasz megjelenítése
2024. július 30-án indult el, és a SpyOne adatbázist váltotta ki. Az ÁBTL honlapjáról az élő fond- és állagjegyzék is ekkor költözött át a LIR felületére.
2. Miért nem teheti közzé az ÁBTL az iratait úgy, ahogyan az egyházi levéltárak az anyakönyveket?
Válasz megjelenítése
Mert az ÁBTL iratanyaga rengeteg személyes és szenzitív adatot tartalmaz. Ezek védelmi ideje nem állapítható meg egységesen: kiadás előtt referensi előolvasást, szükség esetén anonimizálást kell végezni.
3. Melyik négy keresési mód érhető el a LIR-ben?
Válasz megjelenítése
Egyszerű keresés, összetett keresés, személykereső és hierarchiaböngésző.
4. Mit jelentenek a „dinamikus szűrők”?
Válasz megjelenítése
Olyan szűrők, amelyek csak azokat a szűrési feltételeket ajánlják fel, amelyek ténylegesen előfordulnak az adott találati halmazban.
5. Miért kaphat ugyanarra a keresésre más eredményt két felhasználó?
Válasz megjelenítése
Mert a rekordok publikus/nem publikus minősítése és a felhasználó jogosultsági szintje (bejelentkezés nélküli felhasználó vagy tudományos kutató) meghatározza, mely leírási egységek és személyrekordok jelennek meg.
Összefoglalás
Ebben a fejezetben megismerte az ÁBTL online adatbázisát, a LIR-t: hol helyezkedik el a magyar levéltári e-kutatási szolgáltatások történetében, miért különleges az ÁBTL helyzete, milyen munka előzte meg a rendszer indulását, és milyen keresési módok állnak rendelkezésre. A fejezet legfontosabb módszertani tanulsága azonban túlmutat ezen az egy adatbázison: egy levéltári adatbázis tartalma nem azonos a levéltár tartalmával. Hogy mit talál meg benne, azt jogszabályok, adatvédelmi minősítések, digitalizálási prioritások és a struktúraépítés állapota együtt határozzák meg. A jó kutató ezt nem panaszként, hanem forráskritikai adatként kezeli.
Kulcsfogalmak
dinamikus szűrő – Olyan találati listaszűrő, amely csak az adott találathalmazban ténylegesen előforduló szűrési feltételeket ajánlja fel.
hivatásos alkalmazott – Az a személy, aki az állambiztonsági szervezetekkel hivatásos szolgálati viszonyban állt, ideértve a „titkos” és a „szigorúan titkos” állományú munkatársakat is (2003. évi III. törvény 1. § (2) 4.).
leírási egység – A levéltári (leírási) egység önálló entitásként kezelt digitális megfelelője. Az ÁBTL-ben – az ISAD(G) leírástól eltérően – nemcsak a jelenleg fizikai formában létező dokumentumokat vagy dokumentumegyütteseket jelenti, hanem azoknak az iratoknak a digitális leképezését is magában foglalhatja, amelyek egykor (más iratok által bizonyíthatóan) léteztek, és metaadataik segítségével részben rekonstruálhatók. (ISAD(G) fogalomtár)
leírás szintje – „A leírási egység helye a fond hierarchiájában.” (ISAD(G) fogalomtár)
levéltári egység – „A levéltári anyag levéltári vertikális tagolódása (rendszerezés, rendezés) során keletkező része, amelynek a rendszerbeli helyét levéltári szintnek nevezzük.” Megkülönböztetünk felső szintű (levéltári intézmény anyaga, fondfőcsoport, szekció, levéltár, fondcsoport, fond, állag), középszintű (fősorozat, sorozat, alsorozat, kútfő, tétel, altétel) és alsó szintű (ügyirat, ügyiratdarab, egyes irat) levéltári egységeket. (Levéltári fogalomtár)
levéltári jelzet – „Levéltári egység egyedi azonosítására alkalmas kód, amely számok, betűk, írásjelek és szóközök rendszeréből áll”, és a legmagasabb levéltári szintből kiindulva tartalmazza mindazon levéltári egységek jelzeteit, amelyekbe az adott egység beletartozik. Nemzetközi adatcseréhez nélkülözhetetlen, ezért célszerű, ha tartalmazza az országot és a levéltári intézményt azonosító kódot, valamint a leírási egység egyedi azonosítóját is. (Levéltári fogalomtár)
(levéltári) kutatás – „A levéltári anyag tanulmányozása, abból adatok kigyűjtése tudományos vagy más cél érdekében.” A levéltár a levéltári anyagot nyilvántartása, tudományos igényű rendszerezése és tájékoztatási célú segédletek (vagy segédadatbázisok) készítése útján teszi kutatásra alkalmassá, és így bocsátja a kutatók rendelkezésére. (Levéltári fogalomtár alapján)
kutató – „A levéltárban érvényes látogatói jeggyel rendelkező, a levéltár által őrzött levéltári anyagban kutatást végző személy.” (Levéltári fogalomtár)
(adatbázis-)rekord – Az adatbázis önálló, egyedi azonosítóval ellátott információs egysége, amely egy adott személyre, partnerre vagy leírási egységre vonatkozó strukturált adatokat és metaadatokat tartalmaz. Nem tévesztendő össze az ISAD(G) szabvány irat (record) fogalmával. (ISAD(G) fogalomtár)
metaadat – Az iratokhoz vagy leírási egységekhez kapcsolódó strukturált információ, amely segíti azok azonosítását, kezelését, visszakeresését, értelmezését és hosszú távú megőrzését. (Levéltári fogalomtár alapján)
digitális kutatói példány – Az ÁBTL-ben használt kifejezés: az iratok azon digitális másolati példánya, amelyet kutatók számára készítettek elő. Az egyik fajtáját magánkutatók részére állítják össze – ebben nemcsak a védendő különleges adatokat, hanem a védelem alá eső személyes adatokat is anonimizálják. A másik a tudományos kutatói példány, amelyben csak a védendő különleges (egészségi állapotra, kóros szenvedélyre és szexuális életre vonatkozó) információkat takarják ki.
autentikáció (azonosítás) – Olyan biztonsági folyamat, amelynek során ellenőrzik, hogy egy entitás valóban az-e, akinek vagy aminek mondja magát. Célja, hogy a rendszerekhez és szolgáltatásokhoz csak az arra feljogosítottak férhessenek hozzá. Leggyakoribb formája az egyfaktoros azonosítás (felhasználónév és jelszó); a kétfaktoros azonosításnál egy további hitelesítési elem is belép. (NKI fogalomtár)
publikus rekord – A LIR-ben olyan leírási egység vagy személyrekord, amelyet a levéltár bejelentkezés nélküli felhasználók számára is megjeleníthetőnek minősített.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Havasi-Mészáros Dániel: Levéltári Információs Rendszer – Az Állambiztonsági Szolgálatok Történeti Levéltárának új online adatbázisa. Levéltári Szemle 75. (2025) 2. sz. 43–61.
- 2003. évi III. törvény az elmúlt rendszer titkosszolgálati tevékenységének feltárásáról és az Állambiztonsági Szolgálatok Történeti Levéltára létrehozásáról. https://net.jogtar.hu/jogszabaly?docid=a0300003.tv
- 2017. évi XCIV. törvény (a 2003. évi III. törvény módosításáról). https://mkogy.jogtar.hu/jogszabaly?docid=A1700094.TV
Ajánlott irodalom
- Cseh Gergő Bendegúz: A magyarországi állambiztonsági szervek intézménytörténeti vázlata, 1945–1990. Trezor 1. 1999.
- Tóth Eszter: Iratbeszállítás, rendezés, segédletkészítés a levéltárban (1997–2012). Betekintő 2012/3. 1–11.
Linkek és eszközök
- Levéltári Információs Rendszer (LIR) – https://lir.abtl.hu/ords/r/abtl/liron/home – elérve: 2026. 09. 02.
- Állambiztonsági Szolgálatok Történeti Levéltára – https://www.abtl.hu/ – elérve: 2026. 08. 20.
- AdatbázisokOnline – https://adatbazisokonline.mnl.gov.hu/ – elérve: 2026. 09. 02.
- Hungaricana – https://www.hungaricana.hu/hu/ – elérve: 2026. 09. 02.
- Magyarországi Evangélikus Egyház – Őskereső – https://matricula.hu/mee – elérve: 2026. 09. 02.
- Levéltári fogalomtár – https://fogalomtar.archivportal.hu/ – elérve: 2026. 09. 02.
Digitalizált sajtó és térkép: az Arcanum forrásgyűjteményei
| Szerző(k) | Gyulai Katalin |
| Becsült feldolgozási idő | 90 perc |
| Előfeltétel | Az Arcanum tudományos gyűjteményei, Mi a forrás?, Digitalizálás és OCR |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszköz alapadatai
| Eszköz neve | Arcanum Újságok (2024 májusáig Arcanum Digitális Tudománytár, ADT) és Arcanum Térképek |
| URL | https://adt.arcanum.com/hu/discover/ · https://maps.arcanum.com/ |
| Hivatalos hivatkozási forma | ujsagok.arcanum.com és/vagy „Arcanum Újságok” – a
felhasználási feltételek ezt írják elő |
| Üzemeltető | Arcanum Adatbázis Kiadó (1989. január 1. óta működik) |
| Hozzáférés | A keresés díjtalan, a dokumentum megnyitása előfizetéses. ELTE-s hallgatóként eduID-vel lépjen be: az egyetem intézményi előfizetése a teljes tartalmat megnyitja |
| Regisztráció | A kereséshez nem kell; a megjelenítéshez előfizetés vagy intézményi belépés |
| Tartalomtípus | Napilapok, hetilapok, képes magazinok, tudományos folyóiratok, évkönyvek, almanachok, lexikonok, hivatalos közlönyök, cím- és névtárak, compassok |
| Időkörök | A 18. századtól napjainkig; a súlypont a 19–20. század |
| Méret | 94 185 160 oldal (2026. 08. 24.) – folyamatosan nő |
| Fontos korlát | A szöveg OCR-rel készült, nem korrektúrázott – a negatív találat itt gyenge bizonyíték (lásd OCR) |
Miről szól ez a fejezet?
Az Arcanum tudományos gyűjteményei fejezetben azt néztük meg, mit ad az Arcanum szakirodalomként: kézikönyveket, lexikonokat, folyóiratcikkeket. Ez a fejezet a másik felét mutatja be: a korabeli sajtót, a hivatalos kiadványokat és a történeti térképeket – vagyis azt az anyagot, amely a történész számára forrás.
A kettő technikailag ugyanaz a felület és ugyanaz a keresőnyelv. Módszertanilag viszont egészen más: a forrásnál nem az a kérdés, hogy igaz-e, amit ír, hanem az, hogy ki, mikor, kinek és miért írta – és hogy a gépi feldolgozás mit torzított rajta.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- felismerje az adatbázis főbb tartalomtípusait, és megmondja, mely kérdéshez melyiket érdemes választani;
- önállóan futtasson egyszerű és részletes keresést, és idézőjellel kifejezésre keressen;
- egy nagy találathalmazt a bal oldali szűkítőkkel kutatható méretűre szorítson;
- megkülönböztesse a betűsorra és az entitásra irányuló keresést, és megindokolja, miért érdemes kétes esetben mindkettőt lefuttatni;
- a dokumentumnézetben megtalálja a hivatkozáshoz szükséges összes adatot, és a találatot Korall-stílusban idézhető formában rögzítse;
- megmondja, mit szabad letölteni és mit nem, és miért nem az OCR-szövegből idézünk;
- megnevezze a gépi arcfelismerésen alapuló keresés kutatási hasznát és etikai kockázatát;
- az Arcanum Térképeken georeferált térképeket egymásra fektetve önálló megfigyelést tegyen.
Bevezetés
A sajtó és a térkép abban közös, hogy mindkettő korabeli tanúságtétel – nem utólagos elemzés. Egy napilap arról szól, amit egy adott napon nyilvánosan el lehetett mondani; egy katonai felmérés arról, hogy egy állam hogyan látta és mérte fel a saját területét. Egyik sem semleges: mindkettő mögött ott van egy szerkesztőség, egy hivatal, egy szándék.
Az Arcanum Újságok felülete néhány jól megválasztott keresőszóval teszi kutathatóvá ezt az anyagot – a 18. századtól napjainkig megjelent napilapokban, hetilapokban, szaklapokban, könyvekben és hivatalos kiadványokban egyszerre.
Példa Egy tipikus feladathelyzet
Tegyük fel, hogy szemináriumi dolgozatot ír a Horthy-korszak egyik pénzemberéről, Chorin Ferencről – méghozzá családtörténeti szempontból. A feladatban megkapta a szülei és a felesége nevét, és ebből kellene rekonstruálnia a családi kapcsolatokat egy generációval visszafelé és egyet előre.
Levéltári kutatás nélkül, egyetlen délután alatt ez korábban lehetetlen lett volna. Az Arcanum Újságok anyagában viszont ott vannak a gyászjelentések, az eljegyzési és esküvői hírek, a társasági rovatok és a gazdasági értesítők – és mindegyik kereshető.
Figyelem Az Arcanum Újságok szövege OCR-rel készült. A Kézikönyvtár anyagával ellentétben – amely kézi szedésű és korrektúrázott – itt a szöveg gépi felismerés eredménye. Ennek két következménye van:
- A negatív találat gyenge bizonyíték. Ha nem talál rá valamit, az lehet azért is, mert a felismerés elrontotta a szót.
- Csonkolással kell keresni, nem pontos alakra. Ennek okait a keresőnyelvi szakasz és a Digitalizálás és OCR fejezet tárgyalja részletesen.
1. Mi az Arcanum Újságok?
Definíció Fogalom: Arcanum Újságok / Arcanum Digitális Tudománytár (ADT)
Magyarország legnagyobb, folyamatosan bővülő digitális periodika-adatbázisa: napilapok, hetilapok, képes magazinok, tudományos folyóiratok, évkönyvek, almanachok és hivatalos kiadványok lapszámai, teljes szöveggel kereshetően. 2026 augusztusában több mint 94 millió oldalt tartalmazott. A keresés és a találati lista díjtalan, a dokumentum megnyitásához előfizetés vagy intézményi hozzáférés szükséges.
Az Arcanum Adatbázis Kiadó 1989 januárja óta működik, és több online adatbázist épít: az Arcanum Újságok mellett az Arcanum Kézikönyvtárat, az Arcanum Térképeket és a Hungaricanát. Az 1990-es években a munka még CD-ROM-os adatközlést jelentett, elsősorban kézikönyvekre fókuszálva – ezek az anyagok ma a Kézikönyvtár felületén érhetők el. Később minden olyan dokumentumot digitalizáltak, amelyhez hozzáférésük volt, és amelyet relevánsnak találtak a kutatók, a családtörténet-kutatók és az érdeklődők számára.
A cél az volt, hogy a dokumentumok OCR-rel, azaz optikai karakterfelismeréssel váljanak kereshetővé – ez gyorsítja fel a kutatást.
1.1 Miért a sajtó?
Mert a magyar történelem 19–20. századi szakaszáról a legsűrűbb, legfolytonosabb és legkevésbé válogatott forrásanyag a sajtó. Egy levéltári fond arról szól, amit egy intézmény keletkeztetett és megőrzött; a napilap arról, amit egy adott napon nyilvánosan el lehetett mondani. A kettő más kérdésekre válaszol.
Ehhez jönnek a hivatalos kiadványok, amelyeket sokan elfelejtenek: a tiszti cím- és névtárak, a Központi Értesítő, a Nagy Magyar Compass, a telefonkönyvek és a kisnyomtatványok. Ezek nem olvasmányok, hanem névsorok és adatsorok – és éppen ezért pótolhatatlanok, ha egy személy hivatali pozíciójára, cégére vagy gazdasági érdekeltségére kérdez rá.
Figyelem És mire nem jó a sajtó? Arra, hogy önmagában bizonyítson. A napilap azt közli, amit a szerkesztőség közölhetőnek tartott – cenzúra alatt azt, amit engedtek. A hír lehet elhallgatás, torzítás vagy propaganda eredménye is.
A sajtóforrásnál ezért mindig két kérdés jár együtt: mit írnak, és miért épp ezt. A Mi a forrás? fejezet külső és belső kritikája itt közvetlenül alkalmazandó.
2. A felület felépítése
Az Arcanum Újságok oldala egyszerű, könnyen áttekinthető. A felső menüsorban a nyitóoldal gombja után egy Keresés, egy Böngészés és egy nyelvválasztó ikon következik – mindhárom legördül.
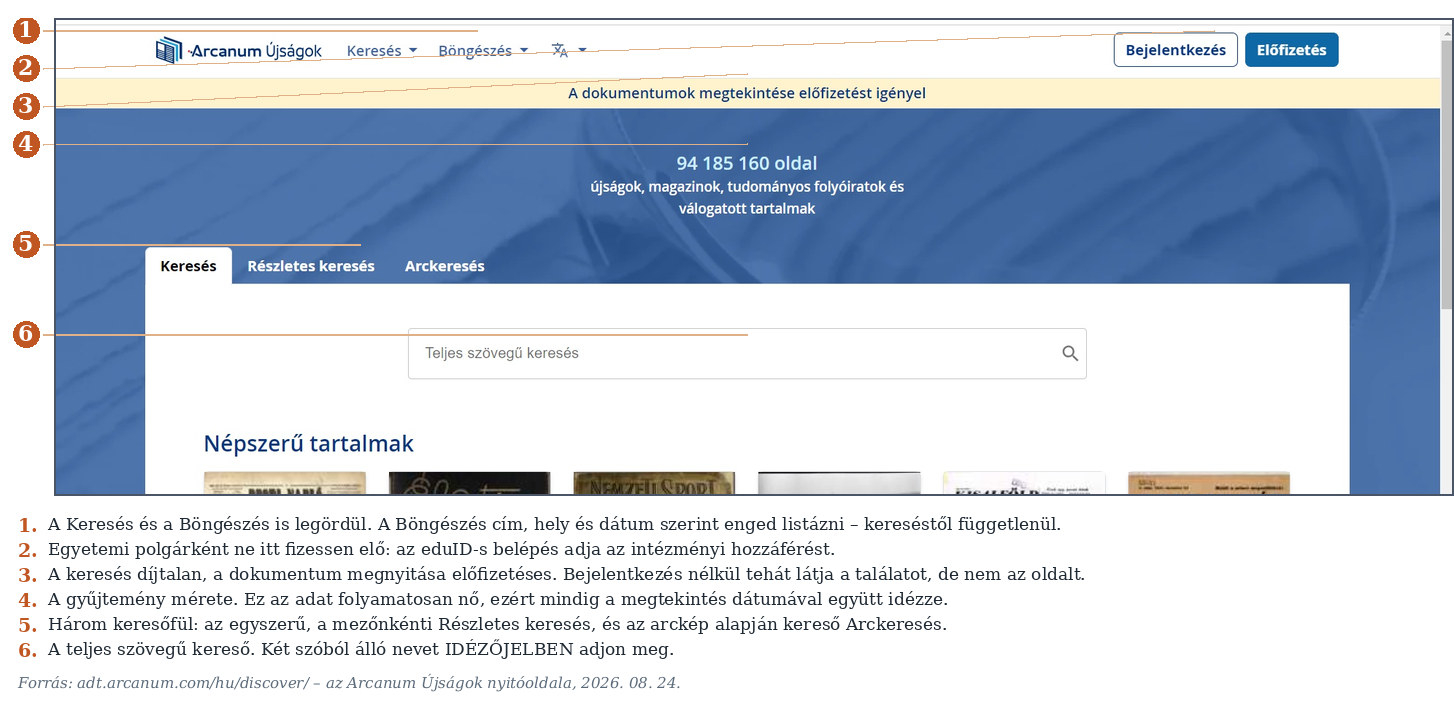
- A Keresés menüpont alatt ugyanaz a három lehetőség nyílik le, ami középen fülekként is látszik: Keresés, Részletes keresés, Arckeresés.
- A Böngészés menüpont cím, hely és dátum szerint enged listázni. Ez a legtöbbek által kihagyott funkció, pedig önálló haszna van: ha nem tudja, mit keressen, itt megnézheti, egyáltalán mi van a gyűjteményben egy adott helyről vagy évből.
Tipp Egyetemi polgárként az eduID-vel lépjen be.
A Bejelentkezés alatt három út van: e-mail és jelszó, társított fiók (Facebook, Google), illetve eduID. Az utolsó az, amelyik az ELTE intézményi előfizetését aktiválja – ettől lesz a teljes tartalom elérhető. Ha jól sikerült, a fejlécben megjelenik, hogy Teljeskörű hozzáférés biztosítva (Eötvös Loránd Tudományegyetem).
Az Előfizetés gombra tehát ne kattintson: az a magánszemélyeknek szól.
A nyitólap közepén álló keresődoboz alatt a Részletes keresés fülön külön felület nyílik: itt választható keresőmező, adhatók meg keresőszavak, a + Feltétel hozzáadása ponttal további mezők vehetők fel, a dátumszűkítővel pedig nyitott és zárt intervallum is megadható. A felület alján egy rövid, példákkal illusztrált „Puska” segít a keresőnyelvben.
A harmadik fül az Arckeresés: egy fénykép feltöltésével a teljes képanyagon lefuttatható az arcfelismerés. Erről a 7. szakaszban lesz szó bővebben.
3. Keresés és szűkítés
3.1 Egyszerű keresés
Írja be a keresett nevet, címet vagy fogalmat – két idézőjel
közé. Például: "Arany János",
"Tiszti cím- és névtár", "gépgyár".
Az idézőjel itt nem díszítés: ez teszi a két szót egyetlen kifejezéssé. Nélküle a kereső az olyan találatot is elfogadja, ahol a két szó külön-külön, egymástól távol szerepel – és a találati szám a többszörösére ugrik.
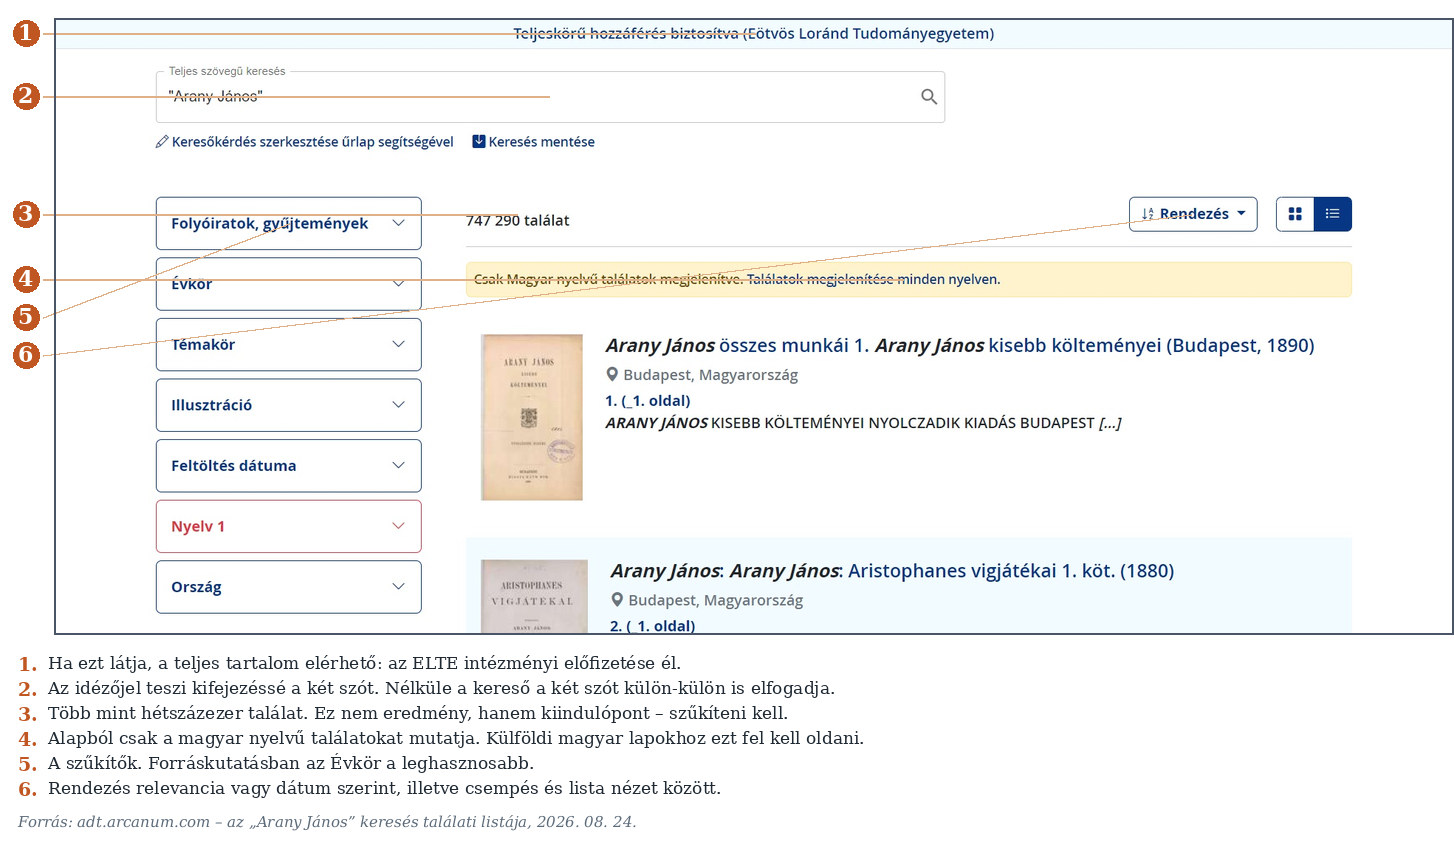
A találati lista alapértelmezetten lista nézetben jelenik meg: a címoldal képe mellett a dokumentum címe, alatta a kiadás helye város, ország formátumban, majd a találat pontos helye a köteten belül, végül a keresőszót tartalmazó szövegkörnyezet néhány sora – a találat dőlten, félkövéren kiemelve.
Egy oldalon alapértelmezetten 20 találat látszik; az oldal alján, az impresszum fölött ez 50-re vagy 100-ra állítható. A jobb felső sarokban a Rendezés gombbal relevancia vagy dátum szerint sorrendezhet, mellette pedig csempés és lista nézet közt válthat.
Tipp Rendezzen dátum szerint.
Időrendben sokkal könnyebb átlátni, mikor jelenik meg először és mikor tűnik el egy téma a sajtóból – és a lista végignézése közben rendszerint kiderül, milyen további szűrőt érdemes beállítani.
Tipp Mentse el a keresést.
A találati lista fölött álló Keresés mentése funkcióval bármikor visszatérhet ugyanahhoz a keresőkérdéshez. További haszna, hogy értesítést kap, ha az új feltöltések nyomán a keresés újabb találatokat ad – ami egy hónapokig futó szakdolgozati kutatásnál valódi előny.
3.2 Részletes keresés: a mezők
A Részletes keresés fülön megválaszthatja, melyik mezőre irányuljon a keresés:
| Mező | Mire jó? |
|---|---|
| Teljes szöveg | az alapeset: a lap teljes szövegében keres |
| Teljes szöveg (pontos) | pontos alakra, a szótövezés kikapcsolásával |
| Cím | cikkcímek – a cikkszegmentálásnak köszönhetően |
| Szerző | aláírt cikkek szerzője |
| Képaláírás | fotók és illusztrációk kísérőszövege |
| Lábjegyzet | tudományos folyóiratok jegyzetapparátusa |
| Tulajdonnév – Személy | személynév mint entitás |
| Tulajdonnév – Hely | helynév mint entitás |
| Tulajdonnév – Intézmény | intézménynév mint entitás |
| Tulajdonnév – Esemény | események |
A feltételek összekapcsolhatók, a keresés dátumtartománnyal szűkíthető, és az összeállított keresőkérdés nyers formában is szerkeszthető.
Mélyebben Mit jelent, hogy „tulajdonnév mint entitás”?
A teljes szövegű keresés karaktersorozatot keres. Ha beírja, hogy
Széchenyi, a kereső mindent megtalál, amiben ez a betűsor
előfordul: a személyt, a Széchenyi fürdőt, a Széchenyi utcát, a
Széchenyi Könyvtárat.
A tulajdonnév-indexek mögött ezzel szemben természetesnyelv-feldolgozás áll: a rendszer előre végigelemezte a szöveget, és megjelölte, hogy egy-egy név személyre, helyre, intézményre vagy eseményre utal-e. Amikor a „Tulajdonnév – Személy” mezőben keres, nem betűsorra keres, hanem arra, amit a gép személynek minősített.
Két dolgot érdemes ebből megjegyezni. Egyrészt ez nagyságrendekkel csökkenti a zajt. Másrészt: ez is gépi döntés, tehát tévedhet – és ugyanaz a forráskritikai kérdés vonatkozik rá, mint az adatmodellekre általában (lásd Mi az adatbázis?). Ha egy nevet a gép nem ismert fel személyként, az entitáskeresés nem hozza – a teljes szövegű keresés viszont még megtalálhatja. Kétes esetben futtassa mindkettőt.
3.3 Szűkítők
A szűkítők a találati lista bal oldalán jelennek meg, tehát csak akkor, ha már lefuttatott egy keresést. Hét szűkítő van:
| Szűkítő | Mit tud? |
|---|---|
| Folyóiratok, gyűjtemények | Egy vagy több kiadványra szűkít. A cím mellett kis körben ott áll, hány találat esik rá – ez maga is adat |
| Évkör | Előbb évtizedet választ, azon belül lehet évre szűkíteni |
| Témakör | Egy vagy több témakör, a találatszámokkal együtt |
| Illusztráció | Van / Nincs / Arc |
| Feltöltés dátuma | Akkor hasznos, ha korábban már keresett erre, és most csak az újonnan feltöltött anyagot nézné meg |
| Nyelv | A forrás nyelve. Alapból magyarra szűkít – ezt fel kell oldani, ha idegen nyelvű anyagot is akar |
| Ország | A kiadás helye. Ezzel kereshetők a külföldön megjelent magyar periodikák |
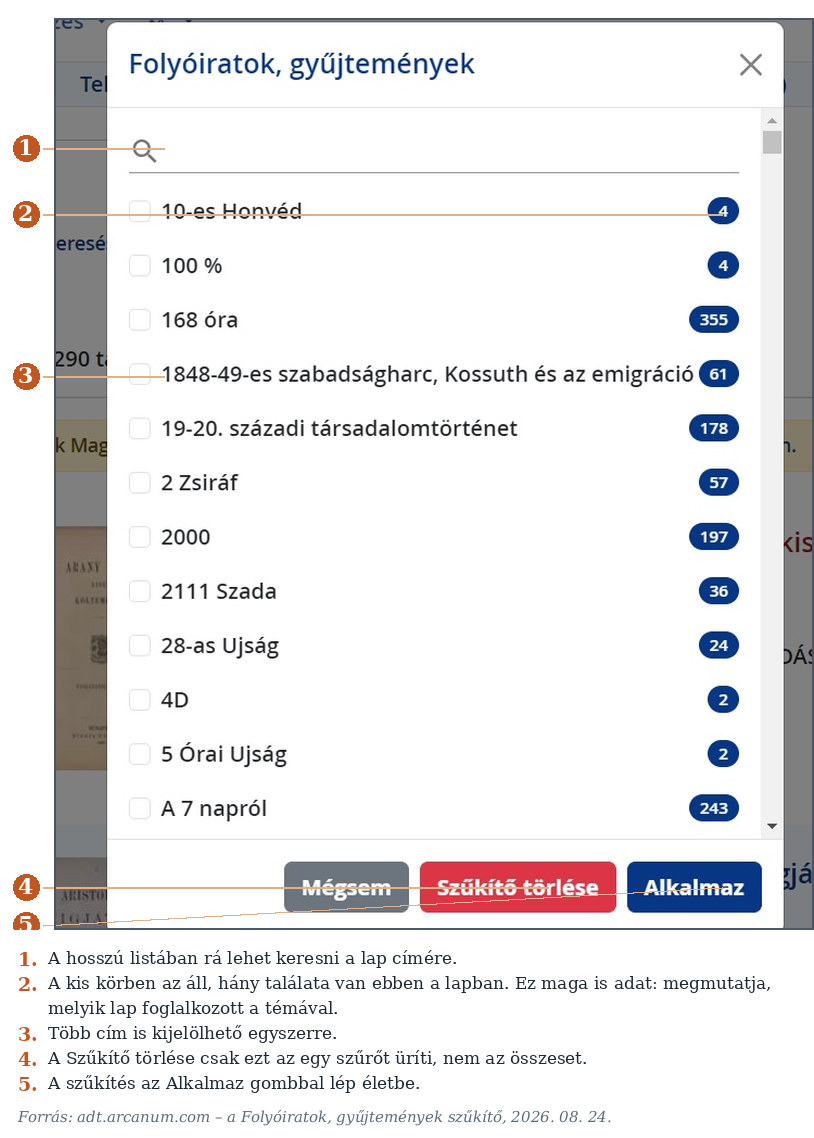
Tipp Az évkör a leghasznosabb szűkítő a forráskutatásban. Ha korabeli reakciót keres egy eseményre, szűkítsen az esemény évére és az azt követő néhány hónapra – így a találati listáról eltűnik az összes későbbi, visszatekintő írás, és csak az marad, ami akkor és ott megjelent.
Példa Hétszázezerből huszonnégy – két szűrővel
A kérdés: lehettek-e építészek a budapesti törvényszék szakértői között, és ha igen, kik?
- Egyszerű keresés az
"építészeti szakértő"kifejezésre. - Szűkítés a Folyóiratok, gyűjtemények szűrővel egyetlen kiadványra: Magyarország tiszti cím- és névtára.
- Szűkítés a vizsgált évkörre.
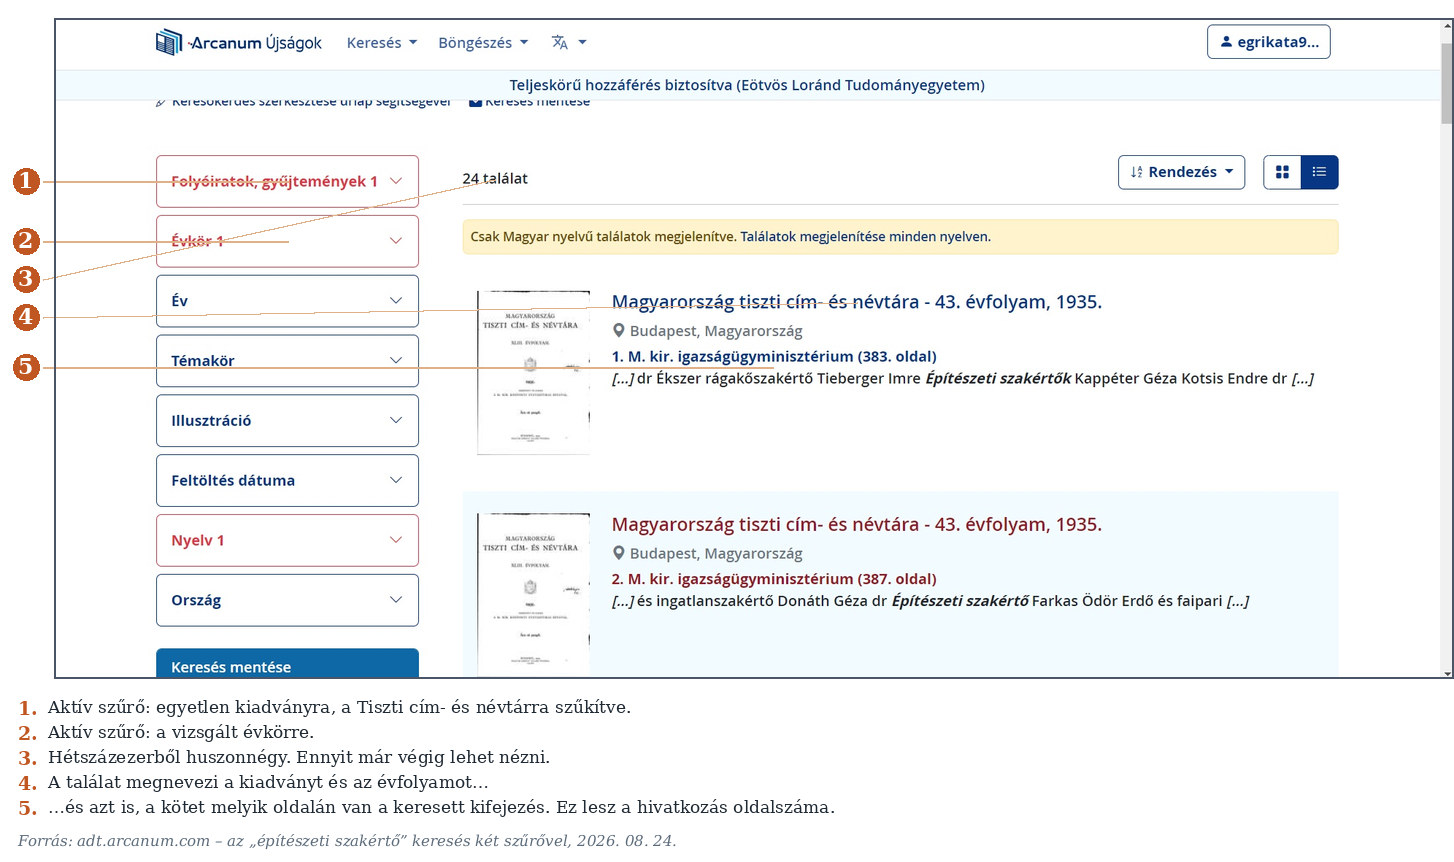
A találat megnevezi a kötetet, az évfolyamot és azt is, a kötet melyik oldalán áll a keresett kifejezés – ez lesz a hivatkozás oldalszáma.
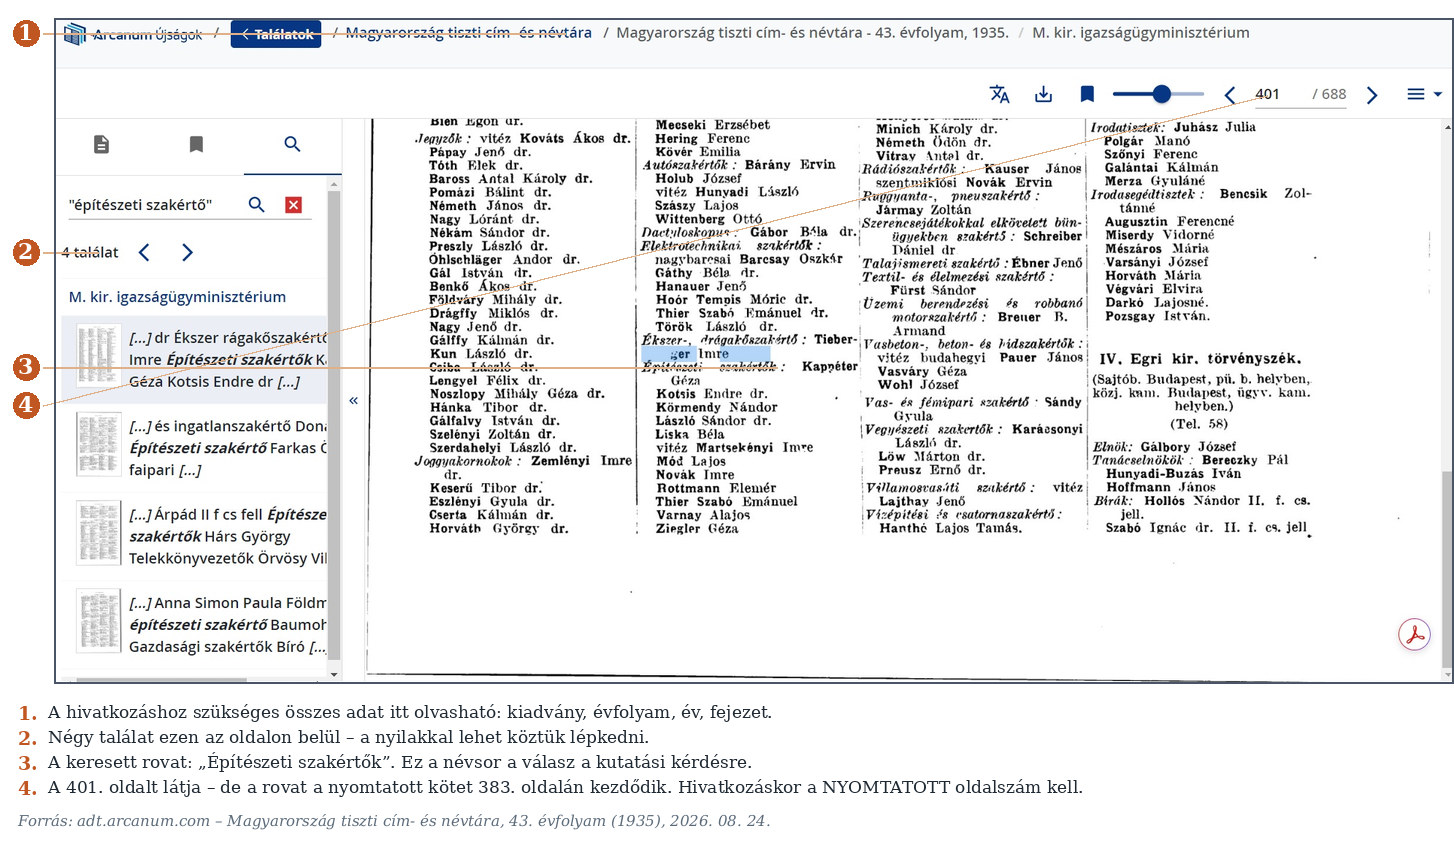
A tanulság módszertani: a névtárban nem minden évben szerepel építészeti szakértő. A hiány itt nem keresési hiba, hanem eredmény – azt mondja meg, mikor volt ilyen tisztség betöltve és mikor nem.
Mélyebben A nagy találatszám nem eredmény
A "filoxéra" kifejezés 2026 augusztusában 22 092
találatot adott az Arcanum Újságokban. Ugyanez a szó a MATARKA-ban 36 cikket – mert az a
címeket indexeli, nem a teljes szöveget.
A nagyobb szám nem jobb eredmény: más kérdésre válasz. És a 22 092 tétel között ott van egymás mellett egy 1985-ös Agrártörténeti Szemle-tanulmány (szakirodalom) és egy 1875-ös napilaptudósítás (forrás) – a találati lista semmivel nem jelzi a különbséget. Ez a fejezet és az Arcanum tudományos gyűjteményei fejezet szétválasztásának oka.
4. A találatok kezelése
A találati listán a képre vagy a leíró szövegre kattintva megnyílik a dokumentumnézet: a keresőszó a saját szövegkörnyezetében, az eredeti oldalképen, kiemelve.
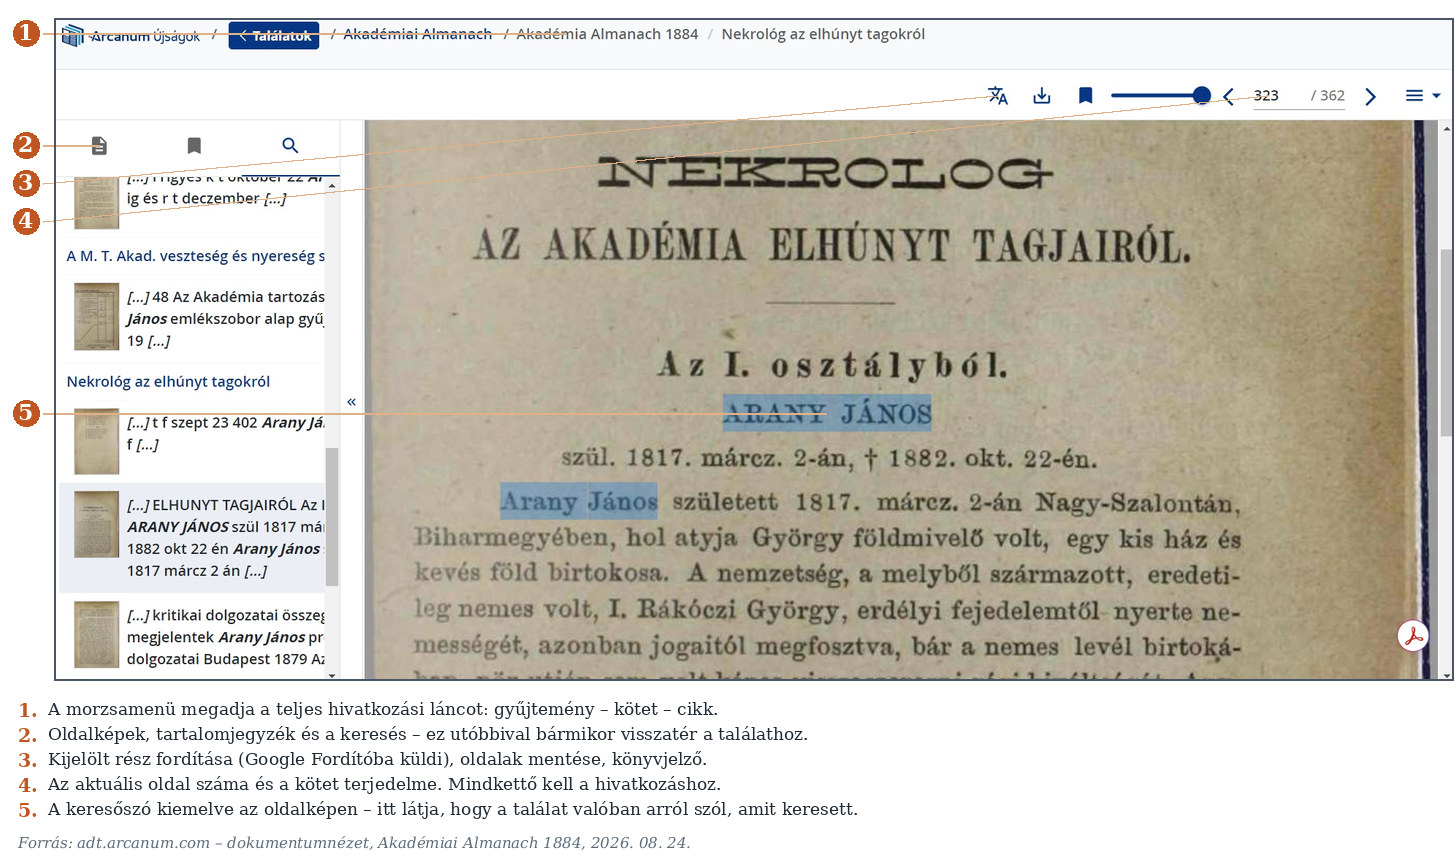
A bal oldali sávban három ikon van: Oldalképek (a kötet összes oldala kicsinyítve), Tartalomjegyzék (ha az adott kiadványnál elérhető, pontjaira kattintva a fejezethez ugrik) és Keresés – ez utóbbival bármikor visszatér a találathoz, tehát a böngészés közben sem veszíti el.
A felső menüsorban, balról jobbra:
- Kijelölt szövegrész fordítása – kattintás után kijelöli a részt, a felület a Google Fordítóba küldi;
- Oldalak mentése – megadható, mettől meddig tölti le a részletet;
- Saját könyvjelző hozzáadása – megjegyzéssel és címkével a profiljába menti a találatot, így később egyszerűen visszakereshető;
- nagyítócsúszka;
- az aktuális oldal száma és a kötet terjedelme – átírható, és a nyilakkal lapozható;
- Menü – Elrendezés, Nagyítás, Forgatás.
Figyelem Mit szabad letölteni?
A felhasználási feltételek pontosan megmondják. Egyszerre legfeljebb 50 oldal tölthető le és tárolható a saját gépen, illetve nyomtatható ki. Magánelőfizetőre emellett napi 5000 oldalas korlát vonatkozik; intézményi hozzáférésnél – tehát ELTE-s belépéssel – a napi limitet az intézmény állapítja meg, és ha a kar eléri, a letöltés másnapig szünetel mindenkinek.
Kifejezetten tilos:
- az adatbázis jelentős részét letölteni, „különösen egy cím (folyóirat, újság) összes számát, ill. teljes évfolyamát”;
- bot, robot vagy script használata automatikus letöltésre;
- a mentett anyagot harmadik félnek átadni, más által is elérhető internetes felületre feltölteni, többszörözni vagy nyomtatásban kiadni;
- a mentett anyagot üzleti célra hasznosítani.
A szabály megsértése a fiók felfüggesztésével, majd törlésével jár. És ami a tudományos munka szempontjából a legfontosabb: az előfizetés önmagában nem jelent szerzői jogi felhasználási engedélyt. A szabad felhasználás keretein túl a jogosult engedélyét külön kell beszerezni.
5. A találat nem azonos a forrással
Ez a fejezet legfontosabb módszertani szakasza.
Amit a képernyőn lát, az a dokumentum digitalizált másolata. Hivatkozni viszont úgy kell rá, mintha a nyomtatott, fizikai példányt tartaná a kezében – mert lényegében azt is tartja: az oldalkép az eredeti lap fényképe.
Ebből következik a szakasz szabálya:
Figyelem Soha ne az OCR-szövegből idézzen.
A kereső azért találta meg a szót, mert a gép felismerte – de a gépi felismerés hibázik. Ha szó szerinti idézetet vesz át, olvassa el az oldalképet, és onnan írja ki a szöveget. A találati listán megjelenő szövegkivonat kereséshez való segédeszköz, nem idézhető forrás.
Ugyanez vonatkozik a terjedelemre: a digitalizált dokumentum idézhető, de csak néhány mondat, illetve bekezdés erejéig, illusztrációként, a megfelelő hivatkozással. Egész művek átvételére a felhasználás nem terjedhet ki.
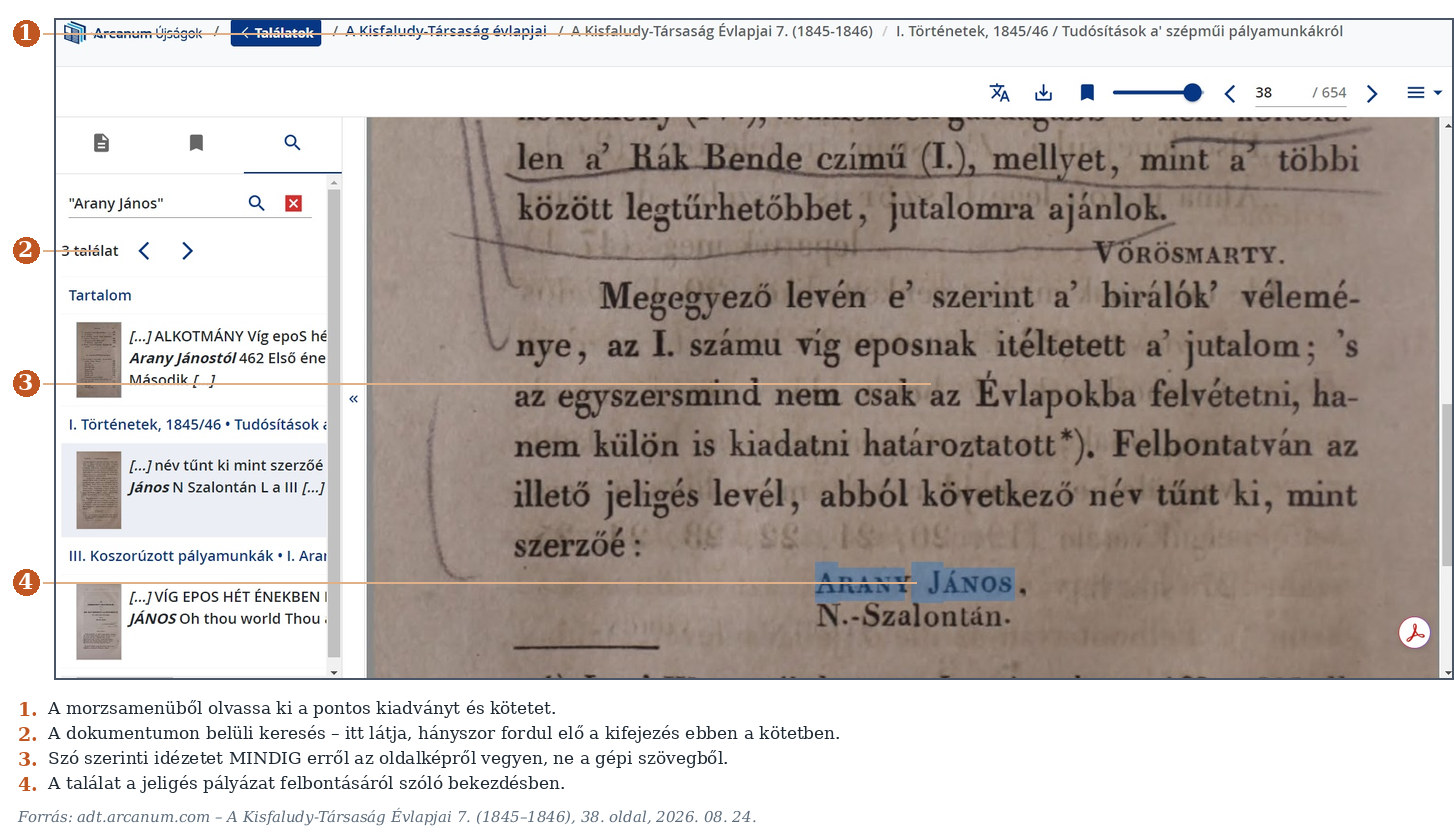
Példa Helyes idézés az oldalképről
Az "Arany János" keresés egyik első találata A
Kisfaludy-Társaság Évlapjai, ahol a jeligés pályázatra beküldött
Az elveszett alkotmány-t méltatják. A bírálat zárómondata az
oldalképről kiolvasva:
„Megegyező lévén e’ szerint a’ bírálók’ véleménye, az I. számú víg eposnak ítéltetett a’ jutalom; ’s az egyszersmind nem csak az Évlapokba felvétetni, hanem külön is kiadatni határoztatott. Felbontatván az illető jeligés levél, abból következő név tűnt ki, mint szerzőé: Arany János, N.-Szalontán.”
A Kisfaludy-Társaság Évlapjai 7. (1845–1846) 38.
Figyelje meg a korabeli helyesírást – a hiányjeleket, a régies alakokat. Ezeket az OCR rendszeresen elrontja; az idézet hűsége csak az oldalképről őrizhető meg.
6. Hogyan hivatkozzon erre a forrásra?
A kötet a Korall folyóirat hivatkozási rendjét követi (lásd a Használati útmutatót). Sajtóforrásnál ez a következőt jelenti.
A lábjegyzetben rövidített alak:
Ambrózy 1942.
Az irodalomjegyzékben a teljes alak – szerző, év, cím, a lap neve, a megjelenés dátuma, oldalszám:
Ambrózy Migazzi Nóra 1942: Asszonyok a filmszakmában – Zseltvay Edit. Nemzeti Újság 1942. december 13. 17.
Egy további példa, ugyanebben a rendben:
Sz. Solymos Bea 1943: „Asszonyokkal a hazáért”. A Baross Női táborának ez évi országos dísztáborozása. Nemzeti Figyelő 1943. március 7. 5.
Tipp Ha nincs oldalszám
Mellékleteknél és egyes lapoknál nincs használható oldalszám. Ilyenkor a digitális forrásra érdemes linkkel is hivatkozni, mert így teljes biztonsággal visszakereshető:
Hausz Boriska 1941: Hölgyek a filmszakmában. Film, Színház, Irodalom 1941. december 26. Forrás:
<URL>Utolsó letöltés: 2026. …
Az Arcanum felhasználási feltételei szerint az adatbázis hivatalos
hivatkozási formája ujsagok.arcanum.com, illetve az
„Arcanum Újságok” megnevezés.
Figyelem A mentett fájl neve nem hivatkozás.
A letöltött oldalrészlet fájlneve nem minden esetben tartalmazza a forrás adatait. Ezért a hivatkozást a mentéssel egy időben írja fel – nem másnap, amikor már nem tudja, melyik lapból, melyik számból, melyik oldalról származik.
A dokumentumnézet morzsamenüje és az oldalszámmező együtt minden szükséges adatot megad; egy képernyőkép a fejlécről öt másodperc, és megspórol egy órát.
7. Cikkszegmentálás és arckeresés
Az Arcanum két olyan technológiát is alkalmaz, amely a puszta OCR-en túlmutat.
Az újságszegmentálás a beszkennelt újságoldalt cikkekre bontja: helyreállítja az olvasási sorrendet, felismeri a címeket és a képaláírásokat. Ennek köszönhető, hogy a találat nem „a 7. oldal”, hanem egy megnevezett cikk, és hogy a cím- és a szerzőmezőre külön lehet keresni.
Az arckeresés sajtófotókon és illusztrációkon keres arcok alapján: egy feltöltött fényképről indulva megmutatja, hol tűnik fel ugyanaz az arc a képanyagban.
Figyelem Az arckeresés etikai kérdéseket vet fel, amelyeket a történésznek is végig kell gondolnia.
Kutatási haszna nyilvánvaló: egy fényképen szereplő, névtelen tömegből azonosíthatóvá válhatnak személyek, és rekonstruálható, ki hol jelent meg nyilvánosan.
De épp ez a kockázat is. A 20. századi sajtófotókon szereplő emberek egy része ma is élhet, vagy közvetlen leszármazottai élnek. A képen való szereplés annak idején nem jelentett hozzájárulást ahhoz, hogy valakinek az összes nyilvános megjelenése gépi arcfelismeréssel egyetlen listába gyűjthető legyen. A politikai rendezvényeken készült felvételeknél ez nem elméleti kérdés.
Az Adatkezelés és adatvédelem fejezet elvei itt is érvényesek: a kutatási cél nem old fel minden korlátot, és a közlés mindig külön mérlegelést kíván a puszta kutatáshoz képest. Mielőtt arckeresésre alapozott eredményt publikál, kérdezze meg: a felismert személy azonosítása szükséges-e a kutatási kérdés megválaszolásához, vagy csak lehetséges?
8. Arcanum Térképek
A georeferált történelmi térképek felülete a Habsburg Birodalom és utódállamai térképanyagát teszi elérhetővé: az első, második és harmadik katonai felmérést, valamint kataszteri és várostérképeket. A térképek mai koordinátarendszerbe illesztve jelennek meg, ezért egymásra fektethetők és összehasonlíthatók – és történelmi településnevekre is lehet keresni.
Ez a felület kapcsolja össze a szöveges kutatást a térbelivel: egy 18. századi összeírásban szereplő birtok vagy egy 19. századi utcanév itt köthető konkrét helyhez. A módszertani folytatás a Budapest Időgép fejezetben és a vizualizációs fejezet térképes részében található.
Tipp Az egymásra fektetés a legerősebb funkció: két időpont térképét összevetve közvetlenül látszik, mi épült, mi tűnt el, hogyan változott a beépítettség vagy a birtokszerkezet. Ez önmagában is elemzés, nem csak illusztráció.
Tipp Ha elakad
| A tünet | Mi lehet a baj? |
|---|---|
| „Biztosan szerepel a lapban, mégsem találom.” | OCR-hiba. Próbáljon csonkolt alakot, más szóalakot, vagy keresse meg a lapszámot böngészéssel, és olvassa el az oldalt |
| „A találati lista üres.” | Nézze meg, nem zárja-e ki az összes találatot valamelyik aktív szűrő – a bal oldali sávban pirossal látszanak |
| „Csak magyar nyelvű találatokat kapok.” | A Nyelv szűrő alapból magyarra áll; a találati lista fölötti sárga sávban oldható fel |
| „Látom a találatot, de nem nyílik meg az oldal.” | Nincs bejelentkezve, vagy nem eduID-vel lépett be |
| „Nem tudok többet letölteni.” | Elérte az egyszerre letölthető 50 oldalt, vagy a kar napi limitjét |
Esettanulmány
Esettanulmány Milyen pályát választott Zseltvay Edit az érettségije után?
A kérdés. Zseltvay Elemér leánya, Zseltvay Edit 1922-ben született, 1932-ben kezdte tanulmányait az Angolkisasszonyok budapesti „Sancta Maria” Leánygimnáziumában, és 1940-ben érettségizett. Ez az utolsó adat, amely az életútjáról a levéltári forrásokból ismert. Milyen hivatást választott?
1. lépés – nyers keresés. Egyszerű keresés a teljes
felületen a "zseltvay edit" kifejezésre: szűkítés nélkül
36 találat. Végignézve látszik, hogy egy részük az
érettségi előtti időszakból való – főként iskolai évkönyvek –,
tehát a kérdés szempontjából nem releváns.
2. lépés – évkör. Az 1940–1959 intervallumra szűkítve 21 találat marad, vagyis csak az érettségi utáni időszak.
3. lépés – a találatok szétválogatása. A Színházi Élet hasábjain elsősorban a társasági életéről van szó: mely körökben mozgott, hol jelent meg. Ez érdekes, de nem a feltett kérdésre válaszol.
4. lépés – a szakmai nyom. A Film, Színház, Irodalom, a Nemzeti Újság és a Magyar Nők Lapja viszont olyan cikkeket közölt, amelyek Zseltvay Editet a filmipar felemelkedő fiatal vállalatvezetőjeként mutatják be. Ezt hivatalos kiadványok is megerősítik: a Központi Értesítő és a Nagy Magyar Compass egy hirdetőiroda ügyvezetőjeként tünteti fel.
A válasz: a filmipar reklámágával foglalkozó vállalatot alapított és vezetett.
És ami utána jött. A találatsor utolsó két tétele elárulja, hogy a vállalatvezetőt egy ingatlaneladást követően 1948-ban körözés alá vették, és vámorgazdaság vádjával eljárás indult ellene (Bűnügyi Körözések Lapja, 28. évf. [1949] 27. sz. 524.).
Mit tanultunk?
- A szűrő nem kényelmi funkció: a 36 találatból az évkör szűkítése emelte ki a kérdéshez tartozó 21-et. Nagyobb halmaznál a Folyóiratok, gyűjtemények szűrő ugyanezt gyorsabban elvégzi.
- Érdemes a hivatalos kiadványoktól a magazinok felé haladni, nem fordítva. A cím- és névtárak, értesítők, compassok rögzített tényt adnak – dátumot, pozíciót, cégnevet –, a társasági rovat pedig színezi. A hivatalos forrásból megszerzett pontos adatokkal (cégnév, cím) azután már célzott részletes keresést lehet indítani.
- A sajtó ott folytatja, ahol a levéltári forrás abbahagyja – de a Mi a forrás? fejezet kritikai kérdései változatlanul érvényesek maradnak rá.
Gyakorlati feladatok
Feladat 1. feladat – Egy saját kérdés végigvitele
Fogalmazzon meg egy személyre, intézményre vagy pozícióra vonatkozó kérdést a saját érdeklődési köréből.
Indítson egyszerű keresést, majd szűkítse a találatokat a bal oldali szűkítőkkel. Mellékeljen képernyőképet, amelyen a beállított szűrők is látszanak.
Mutassa be a legtöbb információt tartalmazó találatot (legfeljebb hármat): miért ezt tartja a legrelevánsabbnak?
Az oldalképről olvasva idézzen belőle egy mondatot.
Hivatkozza le a forrást Korall-stílusban.
Elvárt formátum: kb. féloldalas (250 szavas) szöveg + két képernyőkép. Az egyiken a találati lista legyen a beállított szűrőkkel, a másikon a kiemelt dokumentum.
Feladat 2. feladat – Entitás kontra betűsor (25 perc)
Válasszon egy olyan személynevet, amely intézmény, utca vagy közterület nevében is előfordul (például egy 19. századi közéleti szereplő neve).
Keressen rá a Teljes szöveg mezőben, és nézze meg az első húsz találatot: hány szól a személyről, és hány valami másról?
Keressen rá a Tulajdonnév – Személy mezőben, és végezze el ugyanezt.
Van-e olyan találat, amelyet csak az egyik módszer hozott? Mit tanult ebből?
Feladat 3. feladat – Forrás vagy szakirodalom? (20 perc)
Futtasson le egy keresést a saját témájából, és az első húsz találatot ossza két oszlopba: korabeli forrás és szakirodalom.
Melyik oszlop lett hosszabb, és miért?
Volt-e olyan tétel, amelyet nehéz volt besorolni? Mi tette bizonytalanná?
Milyen szűkítővel tudta volna eleve az egyik típusra korlátozni a keresést?
Feladat 4. feladat – Két térkép egymáson (25 perc)
Válasszon ki egy települést az Arcanum Térképeken.
Nyissa meg a második és a harmadik katonai felmérés lapját ugyanarról a helyről, és fektesse őket egymásra.
Írjon le három konkrét változást (beépítettség, úthálózat, vízrajz, birtokszerkezet).
Fogalmazzon meg egy kutatási kérdést, amely ebből a megfigyelésből következik – és nevezze meg, milyen írott forrás kellene a megválaszolásához.
Feladat 5. feladat – Reflexió az arckeresésről (írásbeli, 1 oldal)
Olvassa el újra a fejezet arckeresésről szóló Figyelem dobozát, majd fejtse ki az álláspontját: milyen kutatási helyzetben tartja indokoltnak a gépi arcfelismerés használatát történeti sajtófotókon, és hol húzná meg a határt a kutatás és a publikálás között? Érveljen, ne csak véleményt írjon.
Önellenőrző kérdések
1. Melyek az Arcanum Újságok főbb tartalomtípusai?
Válasz megjelenítése
Napi- és hetilapok, periodikák, szaklapok, könyvek, valamint egyéb kiadványok: évkönyvek, almanachok, hivatalos közlönyök, cím- és névtárak, telefonkönyvek, compassok, kisnyomtatványok.
2. Milyen forrást használna egy személy gazdasági érdekeltségeinek kutatásához?
Válasz megjelenítése
A Nagy Magyar Compasst, a Központi Értesítőt vagy más értesítőket – ezek rögzített, ellenőrizhető adatot adnak (cégnév, tisztség, dátum), szemben a sajtó társasági rovataival.
3. Hogyan éri el, hogy a kereső csak azokat a találatokat adja, amelyekben egy személy vezeték- és keresztneve egymás mellett szerepel?
Válasz megjelenítése
Idézőjelbe teszi a kifejezést: “Arany János”. Az idézőjel
teszi a két szót egyetlen keresett kifejezéssé.
4. Miért gyenge bizonyíték a negatív találat az Arcanum Újságokban?
Válasz megjelenítése
Mert a szöveg OCR-rel készült, nem korrektúrázva. Ha egy szóra nincs találat, az lehet azért is, mert a gépi felismerés elrontotta a szót – nem csak azért, mert nem szerepel a lapban. Korrektúrázott anyagnál (Kézikönyvtár) a negatív találat sokkal erősebb jel.
5. Mi a különbség a „Teljes szöveg” és a „Tulajdonnév – Személy” mezőben végzett keresés között?
Válasz megjelenítése
A teljes szövegű keresés betűsort keres: a
Széchenyi mindent megtalál, a személytől a fürdőn át az
utcáig. A tulajdonnév-index mögött természetesnyelv-feldolgozás áll: a
rendszer előre megjelölte, hogy egy név személyre, helyre, intézményre
vagy eseményre utal-e. Ez nagyságrendekkel csökkenti a zajt – de gépi
döntés, tehát tévedhet. Kétes esetben mindkettőt érdemes lefuttatni.
6. Honnan vegye a szó szerinti idézetet, és miért?
Válasz megjelenítése
Az oldalképről, nem az OCR-szövegből és nem a találati lista szövegkivonatából. A gépi felismerés hibázik, és a korabeli helyesírást különösen gyakran rontja el; az idézet hűsége csak az eredeti oldalképről őrizhető meg.
7. Mennyit tölthet le egyszerre, és mi az, ami kifejezetten tilos?
Válasz megjelenítése
Egyszerre legfeljebb 50 oldalt. Tilos az adatbázis jelentős részét letölteni – különösen egy lap összes számát vagy teljes évfolyamát –, tilos bot vagy script használata, a mentett anyag továbbadása, internetre feltöltése, nyomtatásban való kiadása és üzleti hasznosítása. Az előfizetés önmagában nem jelent szerzői jogi felhasználási engedélyt.
8. Mit tesz lehetővé a térképek georeferálása?
Válasz megjelenítése
Azt, hogy a történeti térképek mai koordinátarendszerbe illesztve jelenjenek meg, tehát egymásra fektethetők és összehasonlíthatók, és történelmi településnevekre is lehet keresni. Két időpont összevetése önmagában is elemzés: látszik, mi épült, mi tűnt el, hogyan változott a beépítettség vagy a birtokszerkezet.
Összefoglalás
Az Arcanum Újságok a 19–20. századi magyar történelem legsűrűbb, legfolytonosabb forrásanyagát teszi kereshetővé: napilapokat, magazinokat, folyóiratokat, de hivatalos kiadványokat – cím- és névtárakat, értesítőket, compassokat – is. Egyetemi polgárként eduID-vel lépjen be, ettől nyílik meg a teljes tartalom.
A keresés két úton indulhat. Az egyszerű keresés idézőjellel tesz két szót kifejezéssé; a részletes keresés mezőnként dolgozik, és a tulajdonnév-indexekben nem betűsorra, hanem entitásra keres. Egy nagy találathalmazt a bal oldali szűkítők tesznek kutathatóvá – forráskutatásban az évkör a leghasznosabb.
A dokumentumnézetből minden hivatkozási adat kiolvasható, és a hivatkozást a mentéssel egy időben kell felírni. Szó szerinti idézetet mindig az oldalképről vegyen, soha az OCR-szövegből: a gépi felismerés hibázik, a korabeli helyesírást pedig különösen gyakran rontja el. A letöltés korlátozott, és az előfizetés önmagában nem jelent szerzői jogi engedélyt.
Végül: a cikkszegmentálás teszi lehetővé a cím-, szerző- és képaláírás-keresést; az arckeresés kutatási haszna mellett komoly etikai kérdést vet fel; az Arcanum Térképek georeferált katonai felmérései pedig egymásra fektethetők, és ezzel a szöveges kutatás térbelivel egészíthető ki.
Kulcsfogalmak
arckeresés – Gépi arcfelismerésen alapuló keresés sajtófotókon és illusztrációkon.
cikkszegmentálás – A beszkennelt újságoldal cikkekre bontása: az olvasási sorrend helyreállítása, a címek és képaláírások felismerése.
georeferálás – Történeti térkép mai koordinátarendszerbe illesztése, amelynek révén a lapok egymásra fektethetők és összehasonlíthatók.
kifejezéskeresés (idézőjeles keresés) – Több szóból álló kifejezés keresése egyetlen egységként, idézőjelek közé zárva; enélkül a kereső a szavak külön-külön előfordulását is elfogadja.
oldalszintű találat – Olyan keresési eredmény, amely nem egy megnevezett cikkre, hanem egy teljes újságoldalra mutat.
tulajdonnév-index (entitáskeresés) – Olyan keresőmező, amely nem betűsorra, hanem a gép által személynek, helynek, intézménynek vagy eseménynek minősített névre keres.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Arcanum Újságok – https://adt.arcanum.com/hu/discover/ – elérve: 2026. 08. 24.
- Arcanum Újságok: Felhasználási feltételek – https://www.arcanum.com/hu/adt/felhasznalasi-feltetelek/ – elérve: 2026. 08. 24.
- Arcanum Térképek – https://maps.arcanum.com/hu/ – elérve: 2026. 08. 24.
- Az Arcanum Adatbázis Kiadóról – https://www.arcanum.com/hu/rolunk/ – elérve: 2026. 05. 29.
Ajánlott irodalom
- Bertényi Iván (szerk.) 2006: A történelem segédtudományai. Budapest.
- Bánáti Anna: A Bibliával robbantak be, ma már 40 millió digitalizált oldalnál tartanak – az Arcanum-sztori. Forbes – https://forbes.hu/a-magazin/a-bibliaval-robbantak-be-ma-mar-40-millio-digitalizalt-oldalnal-tartanak-az-arcanum-sztori/ – elérve: 2026. 05. 21.
- Arcanum blog (felhasználási példák) – https://arcanum.blog.hu/ – elérve: 2026. 05. 29.
- Optical Character Recognition (kutatási segédlet, Penn State University Libraries) – https://guides.libraries.psu.edu/OCR – elérve: 2026. 05. 22.
Linkek és eszközök
| Név | URL | Mire jó? |
|---|---|---|
| Arcanum Újságok | https://adt.arcanum.com/hu/discover/ | korabeli sajtó és hivatalos kiadványok teljes szöveggel |
| Felhasználási feltételek | https://www.arcanum.com/hu/adt/felhasznalasi-feltetelek/ | letöltési korlátok, idézés, szerzői jog |
| Arcanum Térképek | https://maps.arcanum.com/hu/ | georeferált történeti térképek |
| Arcanum (szolgáltatásismertető) | https://www.arcanum.com/hu/ | a felületek áttekintése |
| Az Arcanum Adatbázis Kiadóról | https://www.arcanum.com/hu/rolunk/ | a szolgáltató bemutatkozása |
Europeana: európai közgyűjtemények egy felületen
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 75 perc |
| Előfeltétel | Hungaricana, Mi a forrás?, Mi az adatbázis? |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszköz alapadatai
| Eszköz neve | Europeana |
| URL | https://www.europeana.eu/hu |
| Üzemeltető | Europeana Foundation, az Európai Unió támogatásával |
| Hozzáférés | Ingyenes, regisztráció nélkül kereshető |
| Regisztráció | Csak a kedvencek és a saját galériák mentéséhez |
| Tartalomtípus | Aggregátor: több mint kétezer európai közgyűjtemény digitalizált anyagának leíró adatai – kép, szöveg, hang, videó, 3D |
| Időkörök | Az ókortól napjainkig, gyűjteményenként eltérően |
| Méret | 2026. 08.: kb. 33,6 millió kép, 24,4 millió szöveg, 1,2 millió hang, 369 ezer videó, 9864 3D-tétel |
| Fontos korlát | A tétel nem a dokumentum, hanem a róla szóló leírás: a tárgy az őrző intézménynél marad, és a jogállapot rekordonként eltérhet |
Miről szól ez a fejezet?
A Hungaricana magyar közgyűjtemények anyagát szolgáltatja. Az Europeana ugyanezt teszi európai léptékben: több mint kétezer intézmény digitalizált anyagát kereshetjük egyetlen felületen.
A fejezet azonban nem elsősorban egy újabb keresőfelületről szól. Az Europeana azért különösen tanulságos, mert működési elve – az aggregáció – olyan kérdéseket tesz szemléletessé, amelyek minden nagy digitális gyűjteményre érvényesek: honnan jön a metaadat, ki felel a minőségéért, mit jelent a jogállapot-jelzés, és mit tud mondani a hiány.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- elmagyarázza az aggregáció működését, és megmondja, mit tárol az Europeana és mi marad az intézménynél;
- összeállítson egy összetett keresést a felület mezőivel és szűrőivel;
- értelmezze a jogállapot-jelzéseket, és megkülönböztesse a jogi tényt a szolgáltató nyilatkozatától;
- felismerje az aggregált metaadat tipikus hibáit: a duplumokat, a névváltozatokat és a gépi fordítás torzításait;
- szabályosan hivatkozzon egy Europeanán megtalált tételre.
Bevezetés
Definíció Fogalom: Europeana
Az Európai Unió támogatásával működő közös hozzáférési pont Európa digitalizált kulturális örökségéhez. Nem gyűjtemény, hanem aggregátor: több mint kétezer európai közgyűjtemény digitalizált anyagának leíró adatait gyűjti egy keresőfelületre.
2026 augusztusában a felület a következő nagyságrendeket mutatta:
| Típus | Tételszám |
|---|---|
| kép | 33 634 914 |
| szöveg | 24 400 436 |
| hang | 1 222 844 |
| videó | 368 765 |
| 3D | 9 864 |
Figyelem Ez a szám nem azt jelenti, amit elsőre gondolna. Az „ötvenkilencmillió tétel” nem ötvenkilencmillió különböző dokumentum. Ugyanaz a mű több intézménytől is bekerülhet, és a tételek egy része nem önálló dokumentum, hanem annak egy darabja (egy lapszám, egy oldal, egy fénykép egy sorozatból). A számot nagyságrendként érdemes olvasni, nem leltárként.
1. Hogyan működik? Az aggregációs lánc
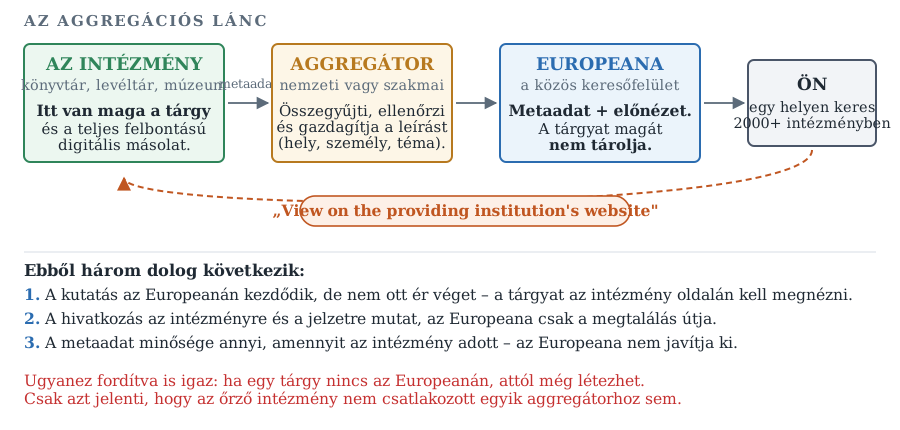
Az Europeana saját leírása szerint nem dolgozik közvetlenül a kétezer intézménnyel: közéjük aggregátorok hálózata ékelődik – nemzeti vagy szakmai gyűjtőpontok –, amelyek összegyűjtik, ellenőrzik és gazdagítják az adatokat (például földrajzi helyet rendelnek hozzájuk, vagy személyekhez, helyekhez, témákhoz kapcsolják őket).
Mélyebben Miért fontos ez a történésznek?
Mert megmagyarázza, honnan erednek a hibák. Az Europeana leírásának minősége annyi, amennyit az intézmény adott és az aggregátor át tudott venni. Az Europeana nem javítja ki a hiányos katalógustételt, és nem egyesíti a duplumokat.
Ez ugyanaz a probléma, amelyet a Mi az adatbázis? fejezet adatintegritásként tárgyalt – csak itt nem egyetlen adatbázison belül jelentkezik, hanem kétezer forrásból összeöntött adaton.
2. Keresés
2.1 Mezők
A részletes keresésben mezőre lehet keresni. A legfontosabbak: Full-text (teljes szöveg, ahol van), a négy gyűjtőmező – What (mi), When (mikor), Where (hol), Who (ki) –, valamint az egyedi mezők: cím, alternatív cím, alkotó, közreműködők, leírás, kiadó, dátum, keletkezési idő, azonosító, jogok, forrás, tárgyszó, típus, hely, provenienciа. Minden feltételhez választható a contains vagy a does not contain módosító, és több feltétel kapcsolható össze.
2.2 Szűrők
| Szűrő | Mire jó? |
|---|---|
| Theme | témakör (régészet, művészet, divat, sajtó…) |
| Type of media | kép, szöveg, hang, videó, 3D |
| Can I use this? | felhasználhatóság a jogállapot alapján |
| Providing country | a szolgáltató intézmény országa |
| Language | a leírás vagy a tétel nyelve |
| Aggregator | melyik gyűjtőponton át érkezett |
| Providing institution | a konkrét intézmény |
| Rights statement | pontos jogi nyilatkozat |
| Colour, Image orientation, Image size, File format | képi tulajdonságok |
Tipp Két szűrőt érdemes rögtön megtanulni. A Providing institution akkor kell, ha egy adott gyűjtemény anyagát akarja végignézni – így az Europeana gyűjteményböngészővé válik. A Can I use this? pedig akkor, ha az anyagot publikálni is szeretné: ezzel eleve csak olyan tételeket lát, amelyeknél ez jogilag rendezett.
3. A találati lista olvasása
Minden találat megadja a szolgáltató intézményt, a címet, egy leírásrészletet, a médiatípust és – ez a legfontosabb – a jogállapot-jelzést.
Tipp A jogállapot-jelzés és a szolgáltató neve a találati lista két legfontosabb adata. Hogy ez a gyakorlatban mit jelent, azt a fejezet esettanulmánya mutatja meg egy konkrét kereséssel: ugyanaz a 19. századi munka hat rekordban, négyféle jogállapottal szerepelt.
Figyelem A gépi fordítás torzít. Az Europeana a leírásokat automatikusan lefordítja a felület nyelvére. Ugyanebben a keresésben szerepelt egy tétel „Slaughterhouses and scenen from Hungary’s Revolution” címmel, egy másiknál a leírás „Marczius of the Year on 16” alakban jelent meg, egy harmadikban a „Tensile:“ szó állt ott, ahol nyilvánvalóan más szerepelt az eredetiben.
Mindig nézze meg az eredeti nyelvű leírást („View this item in another language”), mielőtt a leírásra hivatkozik vagy annak alapján kizár egy tételt. A gépi fordítás a keresést is befolyásolja: ha a fordított alakra keres, az eredetit nem feltétlenül találja meg.
4. Jogállapotok: mit szabad kezdeni vele?
Az Europeana a nemzetközi rightsstatements.org nyilatkozatait és a Creative Commons licenceket használja. A gyakorlatban a következőkkel találkozik:
| Jelzés | Mit jelent? |
|---|---|
| Public Domain | közkincs; szabadon felhasználható |
| CC0 | a jogosult lemondott minden jogáról |
| CC BY / CC BY-SA | szabadon felhasználható, megnevezéssel (a SA: azonos feltételekkel megosztva) |
| CC BY-NC és rokonai | csak nem kereskedelmi célra |
| No Copyright – Non-Commercial Use Only | a szolgáltató szerint nincs szerzői jogi védelem, de csak nem kereskedelmi használatot enged |
| No Copyright – Other Known Legal Restrictions | nincs szerzői jog, de más jogi korlát van (pl. szerződéses) |
| In Copyright | védett mű |
| Copyright Not Evaluated | nem vizsgálták meg – a bizonytalanság jelzése |
Figyelem A „Copyright Not Evaluated” nem azt jelenti, hogy tilos. Azt jelenti, hogy a kérdést senki nem tette fel. Ilyenkor Önnek kell utánajárnia – a szerző halálának évéből és a magyar szerzői jogi védelmi időből (a szerző halálát követő év első napjától számított 70 év) kiindulva, ahogy a Digitális forráskiadás fejezet 3.3 pontja leírja.
És fordítva: az „In Copyright” jelzés sem feltétlenül helytálló, ahogy a fenti esettanulmány mutatja. A jelzés a szolgáltató álláspontja. Ha publikálni készül, ne a jelzésre hagyatkozzon, hanem tisztázza a tényleges jogi helyzetet – és ha az intézmény álláspontja ettől eltér, vegye fel vele a kapcsolatot.
Ez a fejezet a nyilatkozatok olvasásáról szól. Konkrét felhasználási kérdésben kérjen szakértői véleményt; a szerkesztő nem jogász.
5. Hogyan hivatkozzon rá?
Figyelem A forrás az intézménynél lévő dokumentum, nem az Europeana-rekord.
Ez ugyanaz az elv, amelyet a Mi a forrás? fejezet a remediációról mond, és amelyet a Hungaricana fejezetnél is alkalmaztunk. Az Europeana közvetítő réteg – ráadásul itt kettő is van: az aggregátor és a portál.
A hivatkozásnak ezért az őrző intézményre és annak azonosítójára kell mutatnia. Ezt a tételoldal „View on the providing institution’s website” linkje adja meg: kattintson rá, és onnan vegye az adatokat.
Rossz: Europeana, History of the war in Hungary…, elérve 2026.
Jó: Wenkstern, Otto: History of the war in Hungary in 1848 and 1849. [kiadási adatok az intézményi rekordból]. Országos Széchényi Könyvtár, [jelzet]. Elérhető: [az intézményi rekord URL-je] (elérve: 2026. 08. 21.); megtalálva az Europeana portálon.
6. Mire jó, és mire nem?
Tipp Amire jó:
- Felfedezés. Egyetlen kereséssel kétezer intézményt fésül át – olyanokat is, amelyekről nem tudta, hogy van magyar vonatkozású anyaguk. A fenti próbakeresésben a bajor, az oxfordi, a francia, a szerb és a litván gyűjtemény is előjött.
- Külföldi gyűjtemények magyar anyaga. A magyar történelem forrásainak jelentős része külföldi közgyűjteményekben van; ezek magyar felületen nem, itt viszont előkerülnek.
- Jogtiszta illusztráció. A „Can I use this?” szűrővel gyorsan találhat szabadon felhasználható képet előadáshoz, dolgozathoz, kiállításhoz.
- Anyagtípusok, amelyeket a szöveges adatbázisok nem adnak: tárgyak, érmék, viseletek, hangfelvételek, filmek.
Amire nem jó:
- Teljes szövegű kutatásra. Sok tételnél csak a leírás kereshető, maga a szöveg nem. Erre az Arcanum Újságok és a Szaktárs való.
- Mennyiségi állításokra. A duplumok és az egyenetlen feltöltöttség miatt a találatszám nem mérőszám.
- Végpontnak. Az Europeana megtalálja a tételt; megnézni, letölteni és hivatkozni az intézmény oldalán kell.
Esettanulmány
Esettanulmány Egy könyv, hat rekord, négyféle jogállapot
Egy próbakeresés (1848 Hungary, 2026. augusztus 21.,
4327 találat) első oldalán Otto Wenkstern History of the war in
Hungary in 1848 and 1849 című, 19. századi munkája
hatszor szerepelt, különböző intézményektől – és a
jogállapota rekordonként más volt:
| Szolgáltató | Jogállapot-jelzés |
|---|---|
| Országos Széchényi Könyvtár | In Copyright |
| Országos Széchényi Könyvtár (másik rekord) | Copyright Not Evaluated |
| Bayerische Staatsbibliothek (három rekord) | No Copyright – Non-Commercial Use Only |
| Bodleian Libraries, Oxford | In Copyright |
Ugyanaz a mű, ugyanabból a korszakból. A szerző a 19. században élt, tehát a védelmi idő minden számítás szerint rég lejárt – a mű közkincs.
Az alkotó neve is háromféle alakban szerepelt: Otto
Wenkstern, Wenkstern, Otto, Otto von. Wenckstern.
Két rekordban pedig egyenesen technikai azonosító került a szerző
helyére (/direct/2179544,
#agentOf:nhf0ppn_1).
Három tanulság adódik ebből:
- A jogállapot-jelzés nem jogi tény, hanem a szolgáltató nyilatkozata. Azt mondja meg, mit gondol az intézmény a jogi helyzetről – és az intézmények óvatosak. A „Copyright Not Evaluated” azt jelenti: nem vizsgálták meg.
- A duplumok nem hibák, hanem az aggregáció természetes következményei. A találatszám nem művek száma. Aki „hány dokumentum maradt fenn?” típusú kérdésre találatszámmal válaszol, súlyosan téved.
- A névváltozatok miatt az alkotóra keresés hiányos. Ez pontosan az a probléma, amelyre a névtéradatbázisok születtek (lásd Digitális forráskiadás) – az Europeana ezt a munkát az aggregátorokra hagyja, azok pedig különböző mélységben végzik el.
Gyakorlati feladatok
Feladat 1. feladat – Duplumkeresés (25 perc)
Válasszon egy 19. századi magyar vonatkozású művet vagy témát, és keressen rá az Europeanán.
- Nézze át az első két találati oldalt: van-e olyan mű, amely többször szerepel? Hány rekordban, mely intézményektől?
- Egyezik-e a jogállapot-jelzésük? Ha nem, mi lehet az eltérés oka?
- Egyezik-e az alkotó nevének írásmódja?
- Írja le két mondatban, mit jelent mindez a találatszám értelmezésére nézve.
Feladat 2. feladat – A lánc végigjárása (20 perc)
Válasszon egy tetszőleges tételt, amelynél van digitalizált kép.
- Jegyezze fel, mit lát az Europeana tételoldalán: milyen mezők vannak kitöltve, és mi hiányzik.
- Kattintson a „View on the providing institution’s website” linkre.
- Vesse össze a kettőt: milyen adat van meg az intézménynél, ami az Europeanán nincs? Van-e fordítva is ilyen (amit az aggregátor tett hozzá)?
- Állítsa össze a helyes hivatkozást.
Feladat 3. feladat – Jogállapot-vizsgálat (30 perc)
Keressen három olyan tételt, amelynek jogállapota „Copyright Not Evaluated” vagy „In Copyright”, de a keletkezési ideje alapján valószínűleg közkincs.
- Mindháromnál nézze meg, mit tud kideríteni a szerzőről és a halálozási évéről (segítség: Arcanum Kézikönyvtár életrajzi lexikonai).
- A magyar védelmi idő alapján mi a véleménye a tényleges jogi helyzetről?
- Fogalmazzon meg egy rövid, udvarias e-mailt az intézménynek, amelyben a jelzés felülvizsgálatát kéri. (Az e-mailt ne küldje el – ez szemináriumi gyakorlat.)
Feladat 4. feladat – Külföldön őrzött magyar anyag (30 perc)
Szűkítse a keresést a Providing country szűrővel egy nem magyar országra, és keressen magyar vonatkozású anyagot.
- Milyen intézményeknél talált? Sorolja fel ötöt.
- Válasszon ki egy tételt, amelyről nem tudott, hogy létezik, és írjon róla fél oldalt: mi az, hol őrzik, mihez lenne használható?
Önellenőrző kérdések
1. Mit tárol az Europeana, és mi marad az intézménynél?
Válasz megjelenítése
Az Europeana a leíró adatokat (metaadatot) és egy előnézetet tárol; maga a tárgy és a teljes felbontású digitális másolat az őrző intézménynél marad. Ezért vezet minden tételoldalról link az intézmény saját oldalára, és ezért kell a hivatkozásnak is oda mutatnia.
2. Mi az aggregátor szerepe a láncban?
Válasz megjelenítése
Nemzeti vagy szakmai gyűjtőpont az intézmények és az Europeana között: összegyűjti, ellenőrzi és gazdagítja az adatokat (földrajzi hely, személyek, témák hozzárendelése). Az Europeana nem dolgozik közvetlenül a kétezer intézménnyel.
3. Miért nem mérőszám a találatszám?
Válasz megjelenítése
Mert ugyanaz a mű több intézménytől is bekerülhet (duplumok), mert egy tétel lehet egy dokumentum része is (lapszám, oldal), és mert a feltöltöttség intézményenként rendkívül egyenetlen. „Hány ilyen dokumentum maradt fenn?” típusú kérdésre az Europeana találatszáma nem válasz.
4. Mit jelent a „Copyright Not Evaluated” jelzés?
Válasz megjelenítése
Azt, hogy a szolgáltató intézmény nem vizsgálta meg a jogi helyzetet – nem azt, hogy a felhasználás tilos. Ilyenkor a kutatónak kell utánajárnia, például a szerző halálozási évéből és a védelmi időből kiindulva.
5. Miért lehet ugyanannak a 19. századi műnek négyféle jogállapota?
Válasz megjelenítése
Mert a jelzés nem jogi tény, hanem az adott szolgáltató intézmény nyilatkozata a saját digitális másolatáról. Az intézmények óvatosak és eltérő gyakorlatot követnek; van, amelyik meg sem vizsgálta a kérdést. A mű maga ettől még lehet közkincs.
6. Miért kell megnézni az eredeti nyelvű leírást?
Válasz megjelenítése
Mert a felület automatikusan lefordítja a leírásokat, és a gépi fordítás gyakran torzít vagy értelmetlenné válik. Ha a fordított szövegre hagyatkozik, téves következtetést vonhat le – és ha a fordított alakra keres, az eredetit nem találja meg.
7. Mikor NEM az Europeana a megfelelő eszköz?
Válasz megjelenítése
Teljes szövegű kutatásra (arra az Arcanum Újságok vagy a Szaktárs való), mennyiségi állítások alátámasztására (a duplumok miatt), és végpontként – a tételt mindig az intézmény oldalán kell megnézni és onnan hivatkozni.
Összefoglalás
Az Europeana több mint kétezer európai közgyűjtemény anyagát teszi egy helyen kereshetővé, és ezzel olyan gyűjteményeket is elérhetővé tesz, amelyekről a magyar kutató nem is tudott. A magyar történelem forrásainak jelentős része külföldön van – ez a felület az egyik legjobb út hozzájuk.
A használatához azonban meg kell érteni, hogy aggregátor: a leírást tárolja, nem a tárgyat, és a leírás minősége annyi, amennyit az intézmény adott. Ebből következik a fejezet három gyakorlati szabálya. A találatszám nem mérőszám, mert tele van duplummal. A jogállapot-jelzés nem jogi tény, hanem a szolgáltató nyilatkozata. És a kutatás az Europeanán kezdődik, de az őrző intézménynél ér véget – ott kell megnézni a tárgyat, és oda kell hivatkozni.
Kulcsfogalmak
aggregátor – Nemzeti vagy szakmai gyűjtőpont, amely intézmények digitalizált anyagának leíró adatait összegyűjti, ellenőrzi, gazdagítja és továbbadja egy közös portálnak.
Copyright Not Evaluated – Jogállapot-jelzés, amely azt közli, hogy a szolgáltató nem vizsgálta meg a szerzői jogi helyzetet; nem tiltás, hanem a bizonytalanság jelzése.
Creative Commons licenc – Szabványos felhasználási engedélycsalád (CC0, CC BY, CC BY-SA, CC BY-NC), amely előre rögzíti, mit tehet a felhasználó a művel.
Europeana – Az Európai Unió támogatásával működő közös hozzáférési pont Európa digitalizált kulturális örökségéhez; több mint kétezer intézmény anyagát aggregálja.
jogállapot-jelzés (rights statement) – A szolgáltató intézmény nyilatkozata a digitális másolat jogi helyzetéről; nem azonos a mű tényleges jogi státuszával.
szolgáltató intézmény (providing institution) – Az a közgyűjtemény, amely a tárgyat őrzi és a digitális másolatot előállította; a hivatkozás mindig rá mutat.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Europeana – „About us” oldal és a portál keresőfelülete; a
fejezetben szereplő tételszámok és találati példák a szerkesztő
próbakereséseiből származnak (
1848 Hungary, 4327 találat) – elérve: 2026. 08. 21.
Ajánlott irodalom
- Rights Statements – a nemzetközi jogállapot-nyilatkozatok hivatalos leírásai. https://rightsstatements.org/
- Creative Commons – a licencek hivatalos ismertetője. https://creativecommons.org/licenses/
Linkek és eszközök
- Europeana – https://www.europeana.eu/hu – elérve: 2026. 08. 21.
- Europeana – Rólunk – https://www.europeana.eu/en/about-us – elérve: 2026. 08. 21.
- Europeana Pro (szakmai oldal, aggregátorhálózat) – https://pro.europeana.eu/ – elérve: 2026. 08. 21.
- Rights Statements – https://rightsstatements.org/ – elérve: 2026. 08. 21.
- Creative Commons licencek – https://creativecommons.org/licenses/ – elérve: 2026. 08. 21.
Fortepan: közösségi fotóarchívum
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 60 perc |
| Előfeltétel | Mi a forrás?, Europeana |
| Ajánlott utána | Filmhíradók Online – ugyanez a kérdés mozgóképen |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszköz alapadatai
| Eszköz neve | Fortepan |
| URL | https://fortepan.hu/ |
| Üzemeltető | Fortepan (közösségi szerkesztőség, önkéntes szerkesztőkkel) |
| Hozzáférés | Teljesen ingyenes, regisztráció nélkül böngészhető és nagy felbontásban letölthető |
| Regisztráció | Nem szükséges |
| Licenc | CC BY-SA 3.0 – szabadon felhasználható a forrás megnevezésével, azonos feltételekkel továbbadva |
| Tartalomtípus | Történeti fényképek: családi albumok, hagyatékok, hivatásos fotósok életművei, cégek fotódokumentációja |
| Időkörök | A 19. század végétől a 20. század végéig |
| Méret | 2026. 08.: 219 696 fénykép (2010-ben ötezerrel indult) |
| Fontos korlát | A gyűjtemény adományokból áll, ezért nem reprezentatív mintája a magyar fényképtermésnek |
Miről szól ez a fejezet?
Az eddigi adatbázis-fejezetek szöveges forrásokról szóltak. A Fortepan más: ez fényképarchívum, és ezzel egy olyan forrástípushoz vezet, amellyel a történészhallgatók ritkán tanulnak meg rendesen bánni.
A fénykép csábító forrás, mert azt ígéri, hogy „így nézett ki”. Valójában azonban ugyanolyan szerkesztett, nézőpontos és töredékes, mint bármely írott forrás – csak ezt nehezebb észrevenni rajta. A fejezet ezért két dolgot tanít egyszerre: hogyan használjuk a Fortepant, és hogyan kritizáljuk a fényképet mint forrást.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- jellemezze a Fortepan gyűjteményét: honnan származik az anyag, ki válogatja és ki írja le;
- megtalálja a felületen a kutatási kérdéséhez illő képeket a különböző böngészési módokkal;
- a Fortepan által kért pontos formában hivatkozzon egy fényképre, és megmondja, mit enged a licenc;
- forráskritikai kérdéseket tegyen fel egy fényképnek: ki készítette, kinek, mi maradt a képen kívül, mennyire megbízható a képaláírás;
- megkülönböztesse a szerzői jogi kérdést a személyiségi jogitól.
Bevezetés
Definíció Fogalom: Fortepan
Szabad felhasználású, közösségi fotóarchívum. A honlap 2010-ben indult ötezer, jórészt lomtalanításokon talált fényképpel; azóta több száz család, amatőr és hivatásos fotós, valamint közgyűjtemény bővítette. 2026 augusztusában 219 696 fényképet tartalmazott, ingyenesen letölthető jó minőségben.
A gyűjtemény eredete magyarázza a jellegét. Nem egy intézmény tervezett gyarapítási politikája hozta létre, hanem adományok sorozata: hagyatékok, családi albumok, hivatásos fotósok életművei, cégek fotódokumentációi. A szerkesztőség válogat a beérkező anyagból, a leírásokat pedig önkéntes szerkesztők írják.
Két-három havonta kerül fel újabb 2–3000 kép; ilyenkor gyakran több adományozó családi fotói keverednek, de az is előfordul, hogy egy szerző teljes fotóhagyatéka kerül fel egyben.
Mélyebben Mit jelent ez a forrásbázisra nézve?
Az Europeana fejezetben láttuk, hogy egy aggregátornál a gyűjtemény összetétele az intézmények csatlakozási hajlandóságától függ. A Fortepannál a torzítás más természetű, de éppolyan valóságos: azt tartalmazza, amit valaki felajánlott és a szerkesztőség kiválasztott.
Ebből következik, hogy a Fortepan gyűjteménye nem reprezentatív mintája a magyar 20. századi fényképtermésnek. Felül vannak reprezentálva azok a társadalmi csoportok, amelyeknek volt fényképezőgépük és amelyek hagyatéka megmaradt; alul azok, akiknek nem volt, vagy akiknek a hagyatéka elpusztult. Ez pontosan a Mi a forrás? fejezet reprezentativitási kérdése – csak képekre alkalmazva.
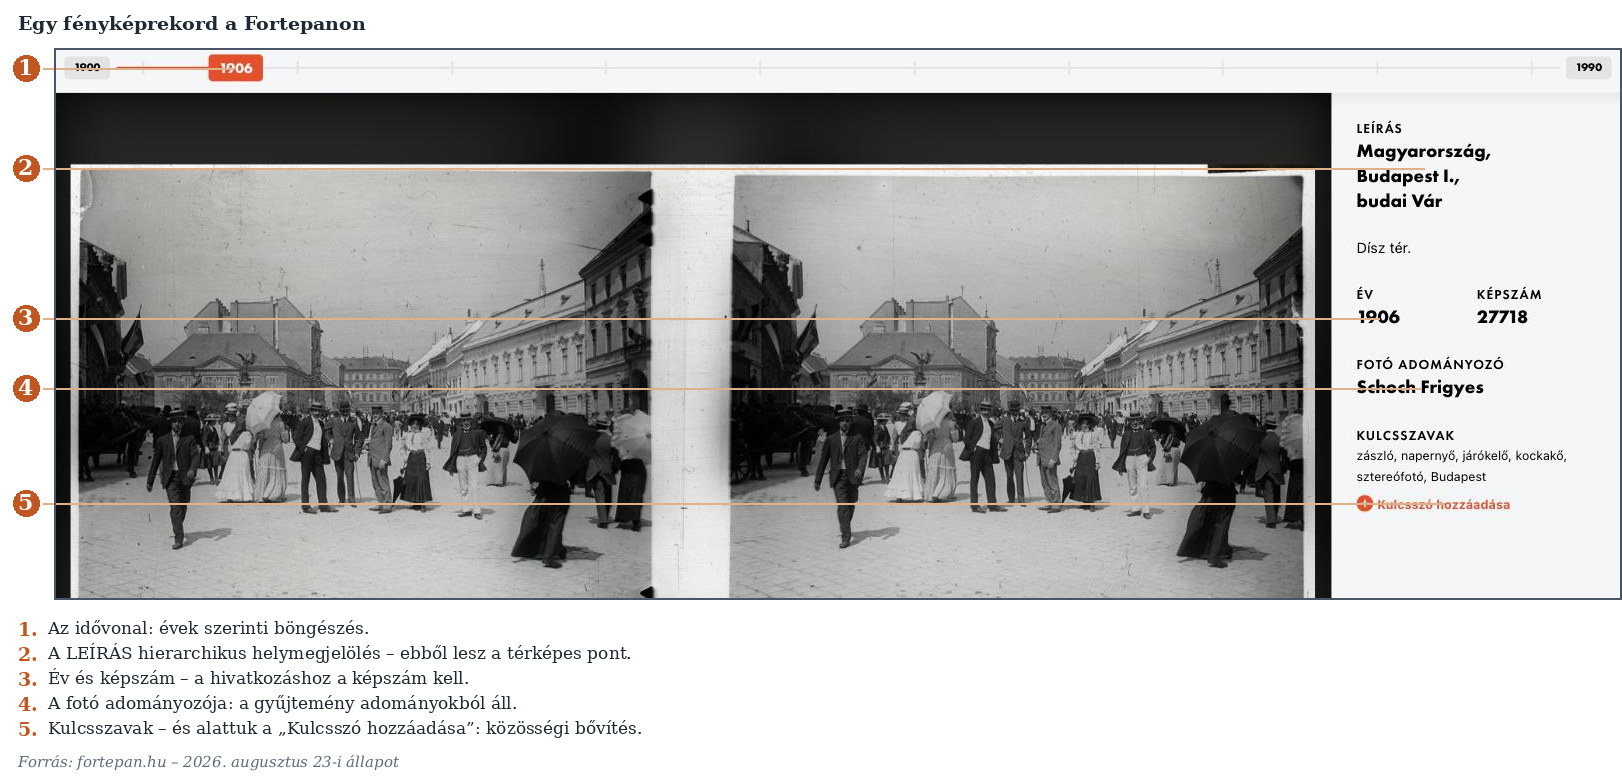
1. Hogyan böngésszünk?
A felület négy utat kínál:
| Mód | Mire jó? |
|---|---|
| Keresés | kulcsszóra – a képaláírások szövegében |
| Idővonal | évek szerinti sáv (nagyjából 1900-tól 1990-ig) |
| Térkép | helyhez kötött képek földrajzi böngészése |
| Feltöltések / sorozatok | egy-egy adományozó vagy hagyaték anyaga együtt |
Tipp A sorozat szerinti böngészés a leginkább alulhasznált mód, pedig kutatásmódszertanilag ez a legjobb. Egyetlen kép önmagában illusztráció; egy fotós teljes hagyatéka viszont korpusz: látszik belőle, mit fényképezett rendszeresen és mit soha, hogyan változott a témaválasztása, mikor hol járt. Ez már elemezhető anyag – és ez az, amit egy Google-képkeresés soha nem ad meg.
1.1 A térképes felület
A Térkép menüpont (fortepan.hu/hu/map/)
a helyhez köthető felvételeket mutatja térképen. Ugyanaz a kereső és
ugyanaz az összetett kereső működik rajta, mint a klasszikus felületen,
csak a találatok a helyükön jelennek meg.
A felület megnyitásakor felugró ismertető négy dolgot mond el – és mind a négy fontos a forráskritika szempontjából:
| Amit a felület kimond | Mit jelent ez a kutatásban? |
|---|---|
| „önkéntes szerkesztők munkájával építettük” | a helymeghatározás közösségi munka, nem intézményi adatrögzítés |
| „elsősorban a budapesti fotóink” | a térkép erősen Budapest-központú, nem az ország egészét mutatja |
| „több tízezer fényképről van szó” | a gyűjtemény több mint kétszázezer képéből csak egy rész van a térképen |
| „Természetesen lehetnek tévedéseink, ezeket igyekszünk javítani” | a pontok egy része bizonytalan, és ezt a szerkesztők maguk mondják ki |
Figyelem A térkép nem a gyűjtemény. A felület saját ismertetője is így zárul: aki „a teljes gyűjteményt szeretné látni, akkor továbbra is a klasszikus Fortepan felületen érdemes böngésznie”.
Ebből az következik, hogy a térképre nem lehet mennyiségi állítást alapozni. Ha egy településről nincs pont, abból nem következik, hogy nincs róla fénykép a Fortepanon – csak az, hogy azt a képet még nem helyezte el senki a térképen. Ugyanez fordítva is igaz: a budapesti sűrűség a szerkesztői figyelem eloszlását mutatja, nem a fényképezés történeti eloszlását.
Ez pontosan az a hibalehetőség, amelyet a Térbeli adatbázisok fejezet gyűjtőköri hiánynak nevez – szemben a történeti hiánnyal.
Tipp A térképnézet
hivatkozható. A böngésző címsorába a felület beírja az aktuális
nézet középpontját és nagyítását – például
?gc=47.4979,19.0402&gz=12 –, így a link
ugyanoda nyílik meg másnál is. Ha egy dolgozatban vagy
órán egy konkrét környékre akarja irányítani az olvasót, ezt a címet
másolja ki, ne csak a map/ végződésűt.
A képek rekordjában viszont nem szerepel koordináta: az adatlapon a Leírás (például „Magyarország, Budapest I., budai Vár” + „Dísz tér.”), az Év, a Képszám, a Fotó adományozó és a Kulcsszavak látszik. A helymeghatározás tehát külön réteg, amelyet a szerkesztők ehhez a szöveges leíráshoz rendelnek hozzá – vagyis a Fortepan térképe a geokódolás tankönyvi példája.
Mélyebben A kulcsszavak is közösségi munkából nőnek. A képek adatlapján a Kulcsszavak mező alatt ott a „Kulcsszó hozzáadása” gomb: bejelentkezett felhasználók bővíthetik a leírást.
Ez ugyanaz a szerkezet, mint a Filmhíradók Online szakmai és nézői címkéje, vagy a Csillagos házak „Reflexiók” rovata: az intézményi és a közösségi adat egymás mellett áll, és a kutatónak külön kell tudnia kezelni a kettőt. Kereséshez mindkettő jó; hivatkozáshoz azt kell megírni, melyikről van szó.
2. A licenc: mit szabad vele csinálni?
Definíció A Fortepan licence: CC BY-SA 3.0
A képek Creative Commons Nevezd meg! – Így add tovább! licenc alatt érhetők el. Ez azt jelenti, hogy szabadon letöltheti, felhasználhatja, átdolgozhatja és akár kereskedelmi célra is használhatja őket – két feltétellel: nevezze meg a forrást, és ha átdolgozza, az eredményt ugyanilyen licenc alatt adja tovább.
Ez a magyar internet egyik legszabadabb kulturális gyűjteménye, és ezért is érdemes kiemelten kezelni: dolgozathoz, előadáshoz, kiállításhoz, publikációhoz gond nélkül használható.
3. Hogyan hivatkozzon rá?
Figyelem A Fortepan maga adja meg a hivatkozás formáját – használja azt.
A képaláírásokban gyakran ott áll: „A kép forrását kérjük így adja meg:“ – és utána a pontos formula. Egy közgyűjteményből származó anyagnál ez így néz ki:
Fortepan / BFL XIV.380 Karafiáth Jenő iratai / Szekfű András adománya
Vagyis a hivatkozás három elemet tartalmaz: a
Fortepant mint közvetítőt, az eredeti őrző gyűjteményt és jelzetet,
valamint az adományozót. Magánadománynál általában a rövidebb
Fortepan / [adományozó neve] alak szerepel.
Egészítse ki a képazonosítóval (a kép egyedi száma) és az elérés dátumával – így a hivatkozás visszakereshető.
Ez nem formaság: a licenc feltétele a megnevezés. Aki elhagyja, megsérti a licencet.
4. Két különböző jog
Figyelem A szerzői jog rendezett – a személyiségi jog nem feltétlenül.
A CC BY-SA licenc a szerzői jogról szól: arról, hogy a fotós (vagy jogutódja) hozzájárult a felhasználáshoz.
A képen szereplő emberek joga ettől független kérdés. Egy 1960-as évekbeli utcaképen felismerhető emberek egy része ma is él. Az, hogy a fotós hagyatéka szabad licenc alá került, nem jelenti azt, hogy a képen szereplők hozzájárultak volna bármihez – ők jellemzően nem is tudtak a fényképezésről.
A gyakorlati szabály: tudományos és oktatási felhasználásnál ez ritkán okoz problémát. Óvatosnak akkor kell lenni, ha a kép azonosítható magánszemélyt mutat érzékeny helyzetben, vagy ha a felhasználás olyan állítást sugall róla, amit nem lehet igazolni. Ilyenkor kérdezzen meg egy szakértőt.
Ugyanez a kérdés merül fel az Arcanum arckeresésénél és az Adatkezelés és adatvédelem fejezetben.
5. A fénykép mint forrás
A Fortepan könnyű használata csábít arra, hogy a képeket puszta illusztrációként kezeljük. A történész munkája viszont akkor kezdődik, amikor a képhez ugyanazokat a kérdéseket teszi fel, mint egy irathoz.
Tipp Hat kérdés minden fényképhez
- Ki készítette, és minek? Családi emlék, sajtófotó, hivatali dokumentáció, megrendelt felvétel? A cél megszabja, mi került a képre.
- Mikor és hol pontosan? A képaláírás datálása néha becslés. Mire alapozza?
- Mi van a képen kívül? A fénykép kivágás: a fotós eldöntötte, mit hagy ki.
- Beállított vagy spontán? A szereplők tudtak-e a fényképezésről?
- Kik hiányoznak? Kik azok, akik nem szoktak képre kerülni?
- Ki írta a képaláírást, és mikor? A Fortepan leírásait önkéntesek írják, gyakran évtizedekkel a felvétel után. Ez másodlagos információ.
Figyelem A képaláírás nem a forrás része. Ez a fejezet legfontosabb gyakorlati tanulsága. Amikor egy fortepanos képaláírás azt mondja, hogy „1937 · Budapest V. · Eötvös tér”, akkor egy önkéntes szerkesztő megállapítását olvassa, nem a fényképen szereplő adatot.
Az ilyen azonosítás gyakran nagyon jó – a közösség sokszor épületrészletből, villamosszámból vagy ruhadivatból következtet –, de megállapítás marad. Ha egy dolgozat érvelése a kép datálásán vagy helyszínén múlik, ellenőrizze független forrásból, és jelezze, honnan tudja.
Esettanulmány
Esettanulmány Egy képaláírás rétegei
Nézzünk meg egy tipikus fortepanos leírást (1938, Balatonkenese):
„Curling bemutató a Magyar Jogász Sportegyesület (MJSE) tagjainak a befagyott Balaton jegén a Székesfővárosi tisztviselők üdülőtelepe (később Honvéd üdülő) előtt.”
Bontsuk szét, mi micsoda:
- Amit a kép mutat: emberek a jégen, egy épület a háttérben, téli öltözet.
- Amit az adományozó tudott: ki van a képen, milyen alkalomból készült – ez a családi vagy hivatali emlékezetből jön.
- Amit a szerkesztő tett hozzá: az épület azonosítása és a „(később Honvéd üdülő)“ kiegészítés. Ez utólagos tudás, amely a felvétel idején nem létezett.
- Amit a leírás nem mond meg: ki fényképezett és miért; hogy a „bemutató” szó a fotós, az adományozó vagy a szerkesztő szava-e.
A tanulság: a képaláírás legalább három tudásréteget kever össze, és nem jelöli, melyik honnan való. Ha a kutatása szempontjából számít, melyik réteg melyik – például mert az esemény jellegére akar következtetni –, akkor a leírásra nem hagyatkozhat: vissza kell mennie az adományozóhoz, a közgyűjteményi jelzethez, vagy korabeli forráshoz.
Gyakorlati feladatok
Feladat 1. feladat – Egy hagyaték mint korpusz (40 perc)
Válasszon a „Korábbi feltöltések” közül egy fotóhagyatékot (egy fotós vagy egy család anyagát).
- Nézzen át belőle legalább ötven képet, és készítsen listát arról, mi a visszatérő téma.
- Mi az, ami feltűnően hiányzik? (Például: van-e munkahelyi kép? van-e utcai jelenet? kik szerepelnek és kik nem?)
- Írjon fél oldalt arról, milyen kutatási kérdésre lenne alkalmas ez a hagyaték – és milyenre nem.
Feladat 2. feladat – Hivatkozásgyakorlat (15 perc)
Válasszon ki három képet: egyet magánadományból, egyet közgyűjteményi anyagból, egyet pedig egy nevesített fotós hagyatékából.
- Írja le mindháromhoz a szabályos hivatkozást a Fortepan által kért formában, kiegészítve a képazonosítóval és az elérés dátumával.
- Mit tenne másképp, ha a képet egy nyomtatott kiadványban közölné?
Feladat 3. feladat – A hat kérdés alkalmazása (30 perc)
Válasszon egy képet, amely a szakdolgozati vagy szemináriumi témájához kapcsolódik, és futtassa végig rajta az 5. szakasz hat kérdését. Ahol nem tud válaszolni, írja oda, honnan lehetne megtudni.
Végül fogalmazzon meg egy mondatot: mit bizonyít ez a kép, és mit csak illusztrál?
Feladat 4. feladat – Térkép vagy gyűjtemény? (20 perc)
Válasszon egy magyarországi települést, amely nem Budapest – lehetőleg olyat, amelyhez köze van.
- Nyissa meg a Fortepan térképét, és nagyítson rá a településre. Hány fényképet talál?
- Keressen rá ugyanarra a településnévre a klasszikus Fortepan keresőjével is. Hány találatot kap?
- Ha a két szám eltér, magyarázza meg, miért – a térképes felület saját ismertetője alapján.
- Fogalmazzon meg egy állítást, amelyet a térkép alapján nem tenne meg.
Önellenőrző kérdések
1. Honnan származik a Fortepan anyaga?
Válasz megjelenítése
Adományokból: a honlap 2010-ben indult ötezer, jórészt lomtalanításokon talált fényképpel, azóta több száz család, amatőr és hivatásos fotós, valamint közgyűjtemény bővítette. A beérkező anyagból a szerkesztőség válogat, a leírásokat önkéntesek írják.
2. Miért nem reprezentatív a gyűjtemény?
Válasz megjelenítése
Mert azt tartalmazza, amit valaki felajánlott és a szerkesztőség kiválasztott. Felül vannak reprezentálva azok a csoportok, amelyeknek volt fényképezőgépük és amelyek hagyatéka megmaradt. Mennyiségi következtetést tehát nem szabad rá alapozni.
3. Mit enged és mit követel a CC BY-SA licenc?
Válasz megjelenítése
Enged: letöltést, felhasználást, átdolgozást, akár kereskedelmi célra is. Követel: a forrás megnevezését, és hogy az átdolgozott mű ugyanilyen licenc alatt kerüljön tovább. A megnevezés elhagyása licencsértés.
4. Mi a különbség a szerzői jog és a személyiségi jog között ebben a helyzetben?
Válasz megjelenítése
A szerzői jog a fotós (vagy jogutódja) jogairól szól – ezt a licenc rendezi. A képen szereplő emberek személyiségi joga ettől független: ők jellemzően nem járultak hozzá semmihez. Tudományos és oktatási felhasználásnál ez ritkán okoz gondot, de azonosítható magánszemély érzékeny helyzetben történő ábrázolásánál óvatosság kell.
5. Miért nem része a képaláírás a forrásnak?
Válasz megjelenítése
Mert utólag, önkéntes szerkesztők írták, gyakran évtizedekkel a felvétel után, és több tudásréteget kevernek: amit a kép mutat, amit az adományozó tudott, és amit a szerkesztő utólag azonosított. A leírás megállapítás, nem adat – ha az érvelés múlik rajta, ellenőrizni kell.
6. Miért érdemes hagyatékonként böngészni kép helyett?
Válasz megjelenítése
Mert egyetlen kép illusztráció, egy teljes hagyaték viszont korpusz: látszik belőle, mit fényképezett a szerző rendszeresen és mit soha, hogyan változott a témaválasztása. Ez már elemezhető anyag.
7. Miért nem lehet a Fortepan térképére mennyiségi állítást alapozni?
Válasz megjelenítése
Mert a térképen a gyűjtemény több mint kétszázezer képéből csak „több tízezer” szerepel, a helymeghatározást önkéntes szerkesztők végzik, és a munka „elsősorban a budapesti fotókra” irányult. Ha egy településről nincs pont, abból nem következik, hogy nincs róla fénykép – csak az, hogy azt még nem helyezte el senki a térképen. A budapesti sűrűség a szerkesztői figyelem eloszlását mutatja, nem a fényképezés történeti eloszlását.
Összefoglalás
A Fortepan több mint kétszázezer archív fényképet tesz szabadon felhasználhatóvá – a magyar internet egyik legértékesebb és legszabadabb gyűjteménye. A licenc (CC BY-SA) minden tudományos és oktatási felhasználást enged, cserébe a forrás megnevezését kéri; a pontos formulát maga az archívum adja meg.
A Térkép menüpont a helyhez köthető felvételeket mutatja földrajzi nézetben, és a nézet hivatkozható címmel is rendelkezik. A felület saját ismertetője azonban kimondja, hogy önkéntes munkával épült, „elsősorban a budapesti fotókra” irányult, „több tízezer” képet tartalmaz a kétszázezerből, és hogy „lehetnek tévedéseink”. A térkép tehát nem a gyűjtemény – aki a teljeset akarja látni, a klasszikus felületen böngésszen.
A fejezet két figyelmeztetést hangsúlyoz. Az egyik a gyűjteményről szól: az anyag adományokból áll, ezért nem reprezentatív – mennyiségi állítást nem lehet rá alapozni. A másik a képaláírásról: azt önkéntesek írták utólag, és legalább három tudásréteget kever össze. A fénykép attól, hogy „látszik rajta”, nem lesz átlátszó forrás; ugyanúgy meg kell kérdezni tőle, ki készítette, kinek, és mi maradt a képen kívül.
Kulcsfogalmak
CC BY-SA – Creative Commons „Nevezd meg! – Így add tovább!” licenc: szabad felhasználás a forrás megnevezésével, az átdolgozás pedig azonos licenc alatt adható tovább.
Fortepan – Szabad felhasználású, közösségi fotóarchívum; anyaga adományokból áll, a leírásokat önkéntes szerkesztők írják.
fotóhagyaték – Egy fotós vagy egy család teljes fennmaradt képanyaga; korpuszként elemezve többet mond, mint az egyes képek külön-külön.
képaláírás – A képhez utólag rendelt leíró szöveg; nem a forrás része, hanem megállapítás, amely több tudásréteget kever.
személyiségi jog – A képen szereplő ember joga a képmásához; független attól, hogy a fotós szerzői jogi értelemben hozzájárult-e a felhasználáshoz.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Fortepan – a honlap saját ismertetője, licencjelzése és képaláírásai; a fejezetben szereplő adatok és példák a szerkesztő böngészéséből származnak – elérve: 2026. 08. 21.
- Fortepan Térkép – a felület megnyitáskor felugró saját ismertetője. https://fortepan.hu/hu/map/ – elérve: 2026. 08. 22.
Ajánlott irodalom
- Creative Commons – a licencek hivatalos ismertetője. https://creativecommons.org/licenses/
Linkek és eszközök
- Fortepan – https://fortepan.hu/hu/ – elérve: 2026. 08. 21.
- Fortepan – Rólunk – https://fortepan.hu/hu/ („Rólunk” menüpont) – elérve: 2026. 08. 21.
- Fortepan Térkép – https://fortepan.hu/hu/map/ – elérve: 2026. 08. 22.
- Heti Fortepan blog – https://hetifortepan.capacenter.hu/ – elérve: 2026. 08. 21.
- Creative Commons licencek – https://creativecommons.org/licenses/ – elérve: 2026. 08. 21.
Filmhíradók Online: a mozgókép mint forrás
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 75 perc |
| Előfeltétel | Mi a forrás?, Fortepan |
| Ajánlott utána | Digitális forráskiadás – a hivatkozásról |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszköz alapadatai
| Eszköz neve | Filmhíradók Online |
| URL | https://filmhiradokonline.hu/ |
| Üzemeltető | Nemzeti Filmintézet Magyarország – Filmarchívum (indulásakor a Neumann Nonprofit Kft. és a NAVA) |
| Hozzáférés | Ingyenes, regisztráció nélkül nézhető |
| Regisztráció | Csak hozzászóláshoz és saját („nézői”) címke megadásához |
| Tartalomtípus | Magyar filmhíradók egyes híradásai („bejátszásai”), szöveges adatlappal |
| Időkörök | Az idővonal 1913-tól 1991-ig tart – 1915, 1917 és 1920 kihagyásával |
| Felhasználás | „elsősorban oktatási, kutatási és közismereti célokat szolgál”; üzleti célú felhasználás csak a filmarchívum engedélyével |
Miről szól ez a fejezet?
Az előző fejezet a fényképről szólt, ez a mozgóképről – pontosabban a mozgókép egy különleges fajtájáról: a filmhíradóról, amelyet 1913 és 1991 között a magyar mozikban a nagyfilm előtt vetítettek.
A filmhíradó kettős forrás. Egyfelől tudósít: valóban megtörtént eseményeket mutat, gyakran az egyetlen fennmaradt mozgóképes felvételen. Másfelől maga is forrás a nyilvánosságról: arról, hogy mit tartott a mindenkori hatalom bemutatásra érdemesnek, milyen szavakkal mondta el, és mit hagyott ki. A történész számára ez a második réteg legalább olyan érdekes, mint az első.
A fejezet emellett egy technikai készséget is tanít: hogyan lehet szövegesen keresni mozgóképben.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- megmondja, mi a filmhíradó, és miért kettős természetű forrás;
- eligazodjon a felület négy böngészési módja között (idő, témák, nevek, helyek), és megválassza a kérdéséhez illőt;
- elmagyarázza, mit keres valójában a szabadszavas kereső – és miért nem a képet;
- elolvassa egy filmhír adatlapját, és megkülönböztesse rajta a korabeli és a mai eredetű mezőket;
- felismerje a szakmai és a nézői címke különbségét, és megítélje, melyikre lehet hivatkozni;
- forráskritikai kérdéseket tegyen fel egy filmhíradó-részletnek: ki készítette, milyen felügyelet alatt, kinek szánta, mit hallgat el.
Bevezetés
Mi a filmhíradó?
Definíció Filmhíradó
Rendszeresen – jellemzően hetente – készülő, mozikban a főfilm előtt vetített rövid összeállítás, amely több önálló híradásból („bejátszásból”) áll. A televízió elterjedése előtt ez volt az egyetlen mozgóképes hírműfaj.
Miért fontos ez a történésznek? Mert állami vagy államilag felügyelt gyártásban készült, kötelezően vetítették, és a nézőszáma óriási volt. A filmhíradó tehát nem csupán dokumentum: a korabeli hivatalos nyilvánosság egyik legfontosabb csatornája.
A magyar filmhíradók sorozatai a 20. század politikai fordulatait követték. A felületen a híradók a saját korabeli sorozatcímükkel szerepelnek – a próbakeresések során például a következők fordultak elő: Magyar Híradó, Vörös Riport Film (1919), Magyar Világhíradó (a két világháború között), Mafirt Krónika és Heti Hírek (1945 után), majd Magyar Filmhíradó. Már a sorozatcímek változása is politikatörténeti forrás.
Figyelem Az idővonal hiányai önmagukban is kérdést vetnek fel.
A főoldal idővonala 1913-tól 1991-ig sorolja az éveket, de három év egyszerűen hiányzik róla: 1915, 1917 és 1920. Ez ellenőrizhető: az idővonalon a szám ott sincs, nem csak üres.
Mit jelent ez? Óvatosan kell fogalmazni. A hiány jelentheti azt, hogy abban az évben nem készült híradó; azt, hogy készült, de nem maradt fenn; és azt is, hogy fennmaradt, de még nincs feldolgozva. Ezt a kötet nem találja ki: a válaszhoz filmtörténeti szakirodalom kell.
Amit viszont máris le lehet szögezni: aki a felületen „nem talál semmit” egy évből, annak nem az évről, hanem a gyűjteményről tud meg valamit.
1. A négy böngészési mód
A felület súgója szerint négyféle rendezőelv áll rendelkezésre; ezekhez járul a szabadszavas keresés.
| Böngészési mód | Mire jó? | Mikor válassza? |
|---|---|---|
| Idő (a főoldal „időgépe”) | év kiválasztása kattintással, hónap a gördítősávval | ha ismert dátumú eseményt keres |
| Témák | tárgyi kategóriák szerinti lista | ha jelenséget kutat, nem eseményt |
| Nevek | a híradásokban megnevezett személyek betűrendes listája | ha egy emberhez gyűjt anyagot |
| Helyek | a híradásokban megnevezett helyszínek | ha egy településhez vagy régióhoz |
| Toplisták | a legnézettebb filmhírek tematikus listái | recepciótörténeti kérdéshez, illetve tájékozódásra |
Tipp Az „idővonal” nem ugyanaz, mint a georeferált időgép. A Budapest Időgép térképeket fektet egymásra; itt az „időgép” csak a dátum szerinti böngészés felülete. Ugyanaz a szó, két különböző dolog – a digitális eszközök nevei gyakran megtévesztőek.
2. Amit a kereső valójában keres
Ez a fejezet legfontosabb technikai tudnivalója. A szabadszavas kereső nem a képben keres, hanem az egyes filmhírekhez rögzített szövegekben – köztük a felvételen elhangzó, illetve a képen megjelenő feliratok átiratában.
Egy filmhír adatlapja a következő mezőket tartalmazza:
| Mező | Mi ez? | Korabeli vagy mai? |
|---|---|---|
| Inzertszöveg | a néma híradók képre írt felirata, betűhív átiratban | korabeli |
| Elhangzó szöveg | a narráció (a „kommentár”) átirata; néma tételnél: [végig néma] | korabeli |
| Kivonatos leírás | a felvétel tartalmának rövid összefoglalása | mai, feldolgozói |
| Kapcsolódó témák | tárgyi kategóriák | mai |
| Szakmai címkék | a feldolgozók tárgyszavai | mai |
| Kapcsolódó helyek | a híradásban szereplő helyszínek | mai besorolás |
| Személyek | a híradásban megnevezett személyek | mai besorolás |
| Nyelv / Kiadó / Azonosító | technikai és gyártói adatok | vegyes |
| Kapcsolódó linkek | átvezetés a NAVA-hoz és az NDA-hoz | mai |
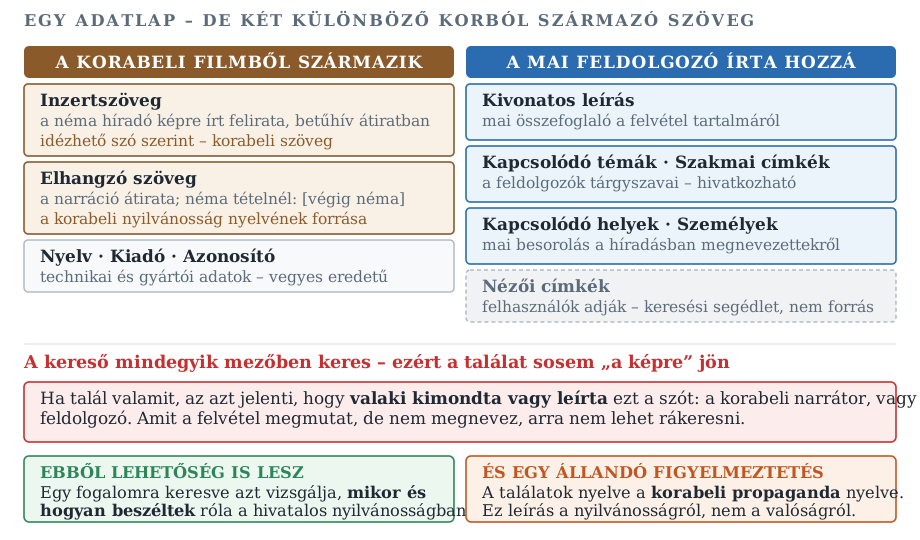
Figyelem A találat a szövegen alapul, nem a képen.
Ha rákeres egy fogalomra, és találatot kap, az azt jelenti, hogy valaki kimondta vagy leírta ezt a szót: vagy a korabeli narrátor, vagy a mai feldolgozó. Ebből két dolog következik.
Először: amit a híradó megmutat, de nem nevez meg, azt a kereső nem találja meg. Egy tömegjelenetben látható tárgy, egy háttérben álló épület, egy felismerhető arc – ha nem került bele a szövegbe, nincs.
Másodszor: a találat nyelve a korabeli propaganda nyelve. Ez nem hiba, hanem lehetőség: ha egy fogalomra keres rá, valójában azt vizsgálja, mikor és hogyan beszéltek róla. Ez a filmhíradó-adatbázis egyik legerősebb kutatási használata.
Mélyebben Kétféle címke egymás mellett
A felület a filmhírek mellett kétféle címkelistát vezet, és külön fülön mutatja őket: Szakmai és Nézői. Az elsőt a feldolgozók adják, a másodikat regisztrált felhasználók – a súgó szerint „a videókat elláthatja egyéni címkékkel is, regisztráció és belépés után”.
A találati listán mindkettő látszik, külön sorban: Címkék:
és Nézői címkék:. A próbakeresések során a nézői címkék mezője
rendre üresen (-) állt – a közösségi címkézés tehát létező,
de kevéssé kihasznált lehetőség.
Miért fontos ez? Mert a kettő nem azonos megbízhatóságú. A szakmai címke az archívum állítása, hivatkozható. A nézői címke egy olvasó megjegyzése: hasznos ötletadó, de önmagában nem forrás. Ugyanez a különbség, mint a Csillagos házak „Reflexiók” rovatában, vagy a Fortepan közösségi képazonosításaiban.
A gyakorlatban: használja mindkettőt a kereséshez, de csak a szakmait a hivatkozáshoz – és a nézőit is csak akkor idézze, ha megnevezi, hogy honnan való.
3. Amit egy hiányzó kópia tanít
A találati listán olykor egy szürke, áthúzott képkocka jelenik meg, mellette a felirattal: „Az eredeti kópia hiányzik”. A tétel adatlapja megvan – dátum, sorozatcím, bejátszásszám, cím –, de a film maga nem nézhető meg.
Mélyebben Ez a legfontosabb dolog, amit ez az adatbázis megtanít.
A hiányzó kópiás rekord pontosan azt a különbséget mutatja meg, amelyet a levéltári rendszerről szóló fejezet is tárgyal: a nyilvántartás és a megőrzött anyag nem ugyanaz. Az archívum tudja, hogy az a híradás létezett – a korabeli kísérőiratokból, a gyártási jegyzékekből –, de a filmszalag elveszett vagy megsemmisült.
Ez a rekord tehát negatív bizonyíték: forrásként hivatkozható arra, hogy 1924 áprilisában a Magyar Híradó 6. számának 2. bejátszása egy bizonyos eseményről szólt, még akkor is, ha a felvétel nem látható.
Csak azt kell megírni, hogy nem látta. Aki egy ilyen tételre úgy hivatkozik, mintha megnézte volna a filmet, hamis állítást tesz a forráshasználatáról.
4. Forráskritika: mit mutat és mit hallgat el a filmhíradó?
A filmhíradó szerkesztett műfaj, és a szerkesztés nem véletlenszerű. A következő öt kérdést érdemes minden tételnél feltenni.
Figyelem Öt kérdés egy filmhíradó-részlethez
- Ki gyártotta, és milyen felügyelet alatt? A sorozatcím megmondja a korszakot és többnyire a politikai keretet is. Ugyanaz az esemény 1938-ban és 1948-ban más hangsúlyt kap.
- Kinek szánták? Mozinézőknek, a főfilm előtt. Ez rövid, látványos, könnyen érthető formát kényszerít – és megmagyarázza a hangvételt.
- Mit mond a szöveg, és mit mutat a kép? Nem mindig ugyanazt. Az Elhangzó szöveg és a képen látható tartalom eltérése önmagában elemzendő jelenség.
- Mi nincs a felvételen? A filmhíradó a bemutatható eseményekről szólt. Ami hiányzik – sztrájk, hiány, kudarc, üldöztetés –, az szintén állítás.
- Hányadik bejátszás? A híradón belüli sorrend rangsor: ami elöl van, azt tartották fontosabbnak.
Tipp A megtekintésszám nem forrásadat. Az adatlapon szereplő „… megtekintés” a mai weboldal nézettségét mutatja, nem a korabeli mozilátogatottságot. Ugyanígy a „megosztás” és a „hozzászólás” is a mai recepcióról szól. Ezeket lehet elemezni – de akkor a jelen kutatásához, nem a múltéhoz.
Esettanulmány
Esettanulmány Ugyanaz a filmfelvétel két adatbázisban
A Topotéma Andrássy út 60. adatlapján két filmhíradó-részlet szerepel. A próbát a szerkesztő 2026. augusztus 22-én végezte el.
1. lépés – amit a Topotéma ad. A helyszín adatlapján, a Videók rovatban két tétel áll, a szerkesztők saját, leíró címével:
- „Háborús bűnösök az Andrássy út 60. pincéjében és kihallgatásuk a 62.-ben (1945. október, Mafirt Krónika 10.)”
- „Háborús bűnösök beszállítása az Andrássy út 60.-ba (1945. október, Heti Hírek 8.)”
2. lépés – rákeresés a filmhíradó-adatbázisban. A
Andrássy út 60 keresőkifejezésre a Filmhíradók Online
2 találatot ad – pontosan a két fenti híradást:
| Dátum | Sorozat és bejátszás | A híradás eredeti címe |
|---|---|---|
| 1945. október | Heti Hírek 8/7. bejátszás | Háborús főbűnösök hazahozatala |
| 1945. október | Mafirt Krónika 10/11. bejátszás | Megérkezett a háborús bűnösök második csoportja az Amerikai Egyesült Államokból |
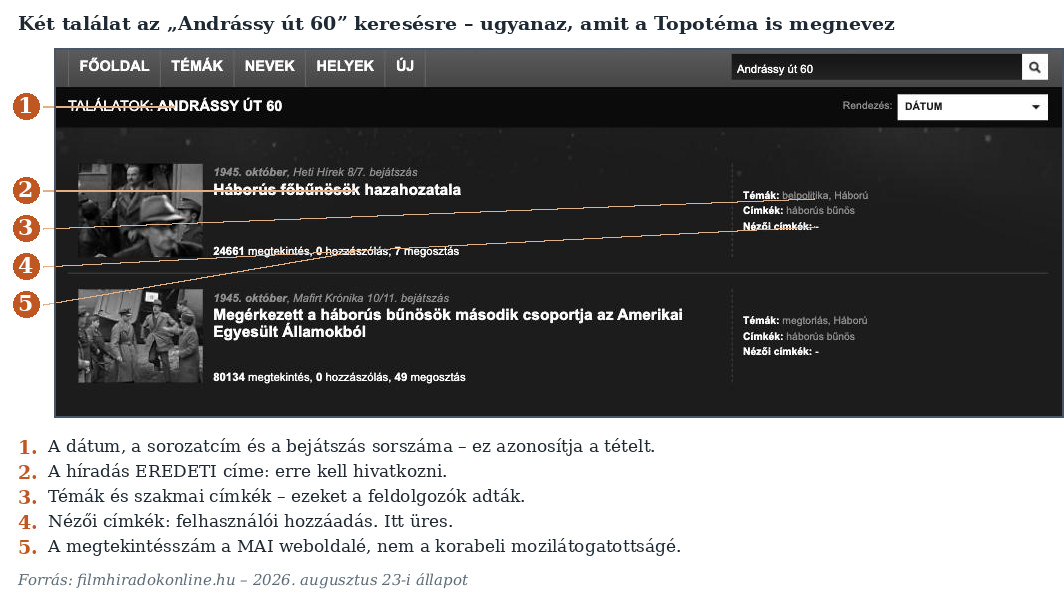
3. lépés – az összevetés. Két dolog látszik azonnal.
A cím nem ugyanaz. A Topotéma a helyszín felől nevezi meg a felvételt („az Andrássy út 60. pincéjében”), az archívum a korabeli, gyártáskori címet őrzi („Háborús főbűnösök hazahozatala”). Egyik sem téves: a kettő két különböző szempontból beszél ugyanarról a filmről. Hivatkozáskor az eredeti címet kell használni, a leírót legfeljebb magyarázatként.
A találat a narrációra jön. A keresés azért működött, mert az „Andrássy út 60.” elhangzik vagy szerepel a híradás szövegében. Ha a felvételen csak látszana az épület, a kereső nem találta volna meg.
Mélyebben Miért érdemes mindkét adatbázist megnézni?
A Topotéma a helyszínt teszi rendezőelvvé: megmondja, melyik épületről van szó, és köré rakja az iratokat meg a visszaemlékezéseket. A Filmhíradók Online a híradást teszi rendezőelvvé: megadja a pontos sorozatcímet, a bejátszásszámot, a korabeli szöveget és a teljes tételt.
A kettő együtt ad hivatkozható forrást: a hely felől megtaláljuk a filmet, a filmarchívumból megkapjuk a pontos azonosítóját. Ez ugyanaz a logika, mint a térbeli adatbázisok fejezetének esettanulmányában – csak ott a cím, itt a felvétel a közös pont.
Gyakorlati feladatok
Feladat 1. feladat – Korabeli vagy mai? (10 perc)
Nyisson meg egy tetszőleges filmhírt, és sorolja két oszlopba az adatlap mezőit: melyik származik a korabeli filmről, és melyiket írta hozzá a mai feldolgozó? Melyik oszlopban lévő adatot idézné szó szerint egy dolgozatban, és melyiket használná csak tájékozódásra?
Feladat 2. feladat – Egy szó története (30 perc, írásbeli)
Válasszon egy fogalmat, amely a 20. századi magyar közbeszédben végig jelen volt (például: munka, ifjúság, béke, modern).
- Keressen rá a szabadszavas keresőben, és jegyezze fel a találatszámot.
- Nézzen meg három találatot három különböző évtizedből.
- Írja le, hogyan változik a szó környezete: milyen képek, milyen jelzők, milyen szereplők társulnak hozzá.
- Fogalmazza meg egy mondatban, mit mond ez a korabeli nyilvánosságról – és mit nem mond a korabeli valóságról.
Feladat 3. feladat – Az ötödik kérdés (20 perc)
Válasszon egy teljes híradószámot (a filmhír adatlapján a „Több filmhír ebből a híradóból” sávval lehet a tételei között lépegetni).
- Írja fel a bejátszások sorrendjét és címét.
- Mi került az első helyre, és mi az utolsóra?
- Milyen témák hiányoznak, amelyeket Ön az adott hónapról tudva elvárt volna?
- Egy bekezdésben: mit mond a sorrend a híradó készítőinek fontossági sorrendjéről?
Feladat 4. feladat – Két adatbázis, egy felvétel (25 perc)
Ismételje meg az esettanulmány próbáját egy másik helyszínnel.
- Keressen a Topotémában olyan helyszínt, amelyhez film tartozik.
- Jegyezze fel, milyen címmel hivatkozik rá a Topotéma.
- Keresse meg ugyanazt a Filmhíradók Online-on, és írja fel a sorozatcímet, a szám és a bejátszás sorszámát.
- Írja meg a hivatkozást úgy, ahogyan egy szemináriumi dolgozatba kerülne.
Önellenőrző kérdések
1. Miért kettős természetű forrás a filmhíradó?
Válasz megjelenítése
Mert egyszerre tudósít megtörtént eseményekről – gyakran az egyetlen fennmaradt mozgóképes felvételen –, és maga is forrás a korabeli nyilvánosságról: arról, hogy mit tartottak bemutatásra érdemesnek, milyen szavakkal, és mit hagytak ki.
2. Mit keres valójában a szabadszavas kereső?
Válasz megjelenítése
A filmhírekhez rögzített szövegeket: az inzertek átiratát, az elhangzó narráció szövegét és a mai feldolgozói leírásokat. A képet nem. Amit a felvétel megmutat, de nem nevez meg, arra nem lehet rákeresni.
3. Mi a különbség a szakmai és a nézői címke között?
Válasz megjelenítése
A szakmai címkét a feldolgozók adják: ez az archívum állítása, hivatkozható. A nézőit regisztrált felhasználók, belépés után: hasznos keresési ötlet, de önmagában nem forrás, és csak a származása megnevezésével idézhető.
4. Mire jó egy olyan rekord, amelynél „az eredeti kópia hiányzik”?
Válasz megjelenítése
Arra, hogy dokumentálja: az adott híradás létezett, adott sorozatban, adott számmal és címmel – akkor is, ha a filmszalag nem maradt fenn. Ez hivatkozható adat, de a kutatónak meg kell írnia, hogy a felvételt magát nem látta.
5. Miért nem forrásadat a megtekintésszám?
Válasz megjelenítése
Mert a mai weboldal nézettségét mutatja, nem a korabeli mozilátogatottságot. Ugyanez igaz a megosztásokra és a hozzászólásokra: ezek a jelen recepciójáról szólnak, és csak arról használhatók bizonyítékként.
6. Mit tudunk meg abból, hogy az idővonalról hiányzik 1915, 1917 és 1920?
Válasz megjelenítése
Elsősorban a gyűjteményről, nem az évekről. A hiány jelentheti azt, hogy nem készült híradó, azt, hogy nem maradt fenn, és azt is, hogy még nincs feldolgozva. A három lehetőség között csak filmtörténeti szakirodalom alapján lehet dönteni – az adatbázis önmagában nem dönti el.
Összefoglalás
A filmhíradó 1913 és 1991 között a mozikban vetített, hetente megjelenő hírműfaj volt, amely önálló híradásokból („bejátszásokból”) állt. Kettős forrás: tudósít az eseményekről, és egyben dokumentálja a korabeli hivatalos nyilvánosságot.
A Filmhíradók Online ezt az anyagot teszi ingyenesen elérhetővé, bejátszásonként, szöveges adatlappal. Négyféle böngészési mód – idő, témák, nevek, helyek –, valamint szabadszavas keresés áll rendelkezésre.
A legfontosabb módszertani tudnivaló, hogy a kereső a szövegben keres, nem a képben: az inzertek és a narráció átiratában, illetve a mai feldolgozói leírásokban. Ebből következik, hogy a találatok nyelve a korabeli nyilvánosság nyelve – és hogy amit a felvétel mutat, de nem nevez meg, arra nem lehet rákeresni.
Az adatlapon korabeli (inzertszöveg, elhangzó szöveg) és mai (kivonatos leírás, témák, címkék, személyek, helyek) eredetű mezők keverednek; a kettőt szét kell választani. A szakmai címke hivatkozható, a nézői csak megnevezett közlésként. A „hiányzó kópia” jelzésű rekordok pedig arra emlékeztetnek, hogy a nyilvántartás és a megőrzött anyag nem ugyanaz.
Kulcsfogalmak
filmhíradó – Rendszeresen készülő, mozikban a főfilm előtt vetített összeállítás önálló híradásokból; a televízió elterjedése előtt az egyetlen mozgóképes hírműfaj.
bejátszás – Egy filmhíradó-számon belüli önálló híradás; a Filmhíradók Online-on ez az adatbázis rekordegysége.
inzert (inzertszöveg) – A néma filmhíradókban a képre írt felirat; a felületen betűhív átiratban szerepel, és kereshető.
elhangzó szöveg – A hangos híradók narrációjának átirata; a korabeli nyilvánosság nyelvének közvetlen forrása.
szakmai címke – Az archívum feldolgozói által adott tárgyszó; az intézmény állítása, hivatkozható.
nézői címke – Regisztrált felhasználó által megadott címke; keresési segédlet, de nem forrásértékű állítás.
hiányzó kópia – Olyan rekord, amelynek adatai ismertek, de a filmfelvétel nem maradt fenn; negatív bizonyítékként hivatkozható.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Filmhíradók Online. Nemzeti Filmintézet – Filmarchívum. https://filmhiradokonline.hu/ (elérve: 2026. 08. 22.)
- Filmhíradók Online: Mi ez? https://filmhiradokonline.hu/intro.php (elérve: 2026. 08. 22.)
- Filmhíradók Online: Segítség. https://filmhiradokonline.hu/help.php (elérve: 2026. 08. 22.)
- Topotéma: Államvédelmi központ, vizsgálati szervek, kémelhárítás, pincefogdák. Andrássy út 60. https://topotema.hu/object/525 (elérve: 2026. 08. 22.)
Ajánlott irodalom
Linkek és eszközök
| Név | URL | Mire jó? |
|---|---|---|
| Filmhíradók Online | https://filmhiradokonline.hu/ | magyar filmhíradók bejátszásonként, adatlappal |
| NAVA – Nemzeti Audiovizuális Archívum | https://nava.hu/ | a magyar audiovizuális kötelespéldány-archívum |
| Nemzeti Filmintézet – Filmarchívum | https://filmarchiv.hu/ | az üzemeltető intézmény |
| Topotéma | https://topotema.hu/ | helyszínek, egyes adatlapokon filmhíradó-részletekkel |
| Fortepan | https://fortepan.hu/ | állókép ugyanezekhez a korszakokhoz |
Oral history: az elbeszélt emlékezet mint forrás
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 90 perc |
| Előfeltétel | Mi a forrás?, Filmhíradók Online |
| Ajánlott utána | Adatkezelés és adatvédelem, Mesterséges intelligencia |
| Verzió / dátum | v0.1 / 2026. augusztus |
Miről szól ez a fejezet?
Eddig írott iratokkal, fényképekkel és filmekkel dolgoztunk. Ez a fejezet arról a forrástípusról szól, amely nem volt meg addig, amíg a kutató létre nem hozta: a történeti interjúról.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- megkülönböztesse egymástól az esemény idejét és a visszaemlékezés keletkezésének idejét, és megmondja, miért mindkettő fontos;
- megtaláljon egy interjút a 20. Század Hangja Archívumban, és a metaadatlapról leolvassa a hozzáférési szintjét;
- keressen a Szabad Európa Rádió 1956-os műsorainak szó szerinti leiratában, és ellenőrizze a találatait;
- megmondja, miben más a Centropa szerkesztett életrajza, mint egy szó szerinti interjúátirat, és hogyan kell rá hivatkozni;
- felsorolja azokat a dokumentumokat, amelyek egy szakszerűen archivált interjúhoz tartoznak, és azokat a nyilatkozatokat, amelyek a felhasználását szabályozzák;
- megtervezzen egy saját interjút a hozzájárulástól a leiratig – és eldöntse, használhat-e hozzá gépi leiratozót.
Bevezetés
A Mi a forrás? fejezet azzal kezdte: forrás minden, amiből a múltra következtetni tudunk. Az oral history ennek a mondatnak a legkényesebb esete, mert itt a forrás a kutató közreműködésével jön létre: a kutató nem csupán megtalálja, hanem részben létre is hozza.38
Ez elsőre gyanúsnak hangzik. Pedig nem az: ugyanez igaz egy régészeti ásatásra vagy egy kérdőíves felvételre is. A különbség annyi, hogy az interjúnál a létrehozás nyoma ott marad a forrásban – a kérdésekben, a hallgatásokban, abban, hogy ki ült szemben az elbeszélővel. Éppen ezért az oral history-forrás a forráskritika szempontjából nem szegényebb, hanem gazdagabb a többinél: egyszerre őrzi azt, amiről beszélnek, és azt, ahogyan a beszéd pillanatában látták.
1. Mi az oral history – és mikor forrás?
Definíció Fogalom: oral history
Kutatási módszer és forrástípus egyszerre: a kutató szándékosan, kutatási céllal készít és rögzít visszaemlékező interjút olyan személlyel, aki egy múltbeli eseménynek, folyamatnak vagy élethelyzetnek részese vagy tanúja volt – majd a felvételt és a hozzá tartozó dokumentációt megőrizhető, kutatható formában archiválja.
Két dolog van ebben a meghatározásban, ami könnyen elsikkad.
Az egyik: kutatási céllal. Egy családi videó a nagymama nyolcvanadik születésnapjáról nem oral history-interjú, még ha sok mindent el is mesél benne. Attól lesz azzá, hogy kérdés vezérli, és hogy a felvétel mellé odakerül, ki kérdezte, mikor, miért és milyen körülmények között.
A másik: archiválja. Az interjú, amely a kutató merevlemezén marad, a tudomány számára nem létezik: nem ellenőrizhető, nem hivatkozható, és a kutató halálával elvész. A magyar oral history-gyűjtemények éppen ezért nem az interjúk raktárai, hanem intézmények, amelyek a megőrzés feltételeit is kezelik.
1.1 Amit az interjú tud, és amit nem
| Amire az interjú a legjobb forrás | Amire önmagában nem elég |
|---|---|
| Mindennapok, munkahelyi és családi élet, amiről nem keletkezett irat | Pontos dátumok, számadatok, jogszabályi részletek |
| Az, hogy a résztvevők hogyan élték meg és hogyan magyarázták az eseményeket | Az események menetének rekonstruálása |
| Azoknak a csoportoknak a története, amelyek nem hagytak hátra írott forrást | Egy döntés hivatalos indoklása |
| Az emlékezet alakulása: mit gondolt erről a beszélő az interjú idején | Egy állítás igazságtartalmának eldöntése |
Az oral history-források és a többi forrás kölcsönösen ellenőrzik egymást39 – a szóbeli forrás nem helyettesíti az iratot, és az irat sem a szóbelit.
Figyelem A leggyakoribb kezdő hiba
Az interjút úgy olvasni, mint egy jegyzőkönyvet: kiemelni belőle az évszámokat és a neveket, mint valami adatbázisból.
Egy 2005-ben felvett interjú a második világháborúról nem 1944-es forrás. Két időpontja van: az elbeszélt eseményé és az elbeszélésé.40 Aki csak az évszámokat írja ki, épp azt dobja el, amiért az interjú készült.
Példa Egy 1970-es években készült gyári munkásinterjúból nem fogja megtudni, mekkora volt pontosan a bérfeszültség a Salgótarjáni Síküveggyárban – arra ott a vállalati irat. Azt viszont csak innen tudja meg, hogy a munkások mit gondoltak róla, milyen szavakkal beszéltek egymás pozíciójáról, és mit tartottak igazságosnak. A két forrás ugyanarról szól, de nem ugyanazt mondja – és épp ez a használható bennük.
1.2 Az interjú mint közös termék
Az oral history gyakorlatában a „hogyan kérdezzünk” kérdését fokozatosan felváltotta a „hogyan hallgassunk” kérdése – és ezzel párhuzamosan az interjúalanyból interjúpartner lett.41
Ez nem udvariassági fordulat: azt jelenti, hogy az elbeszélés nem egyszerű adatszolgáltatás, hanem közös jelentésalkotás.
Ebből két gyakorlati következmény adódik a dolgozatához:
- Az interjú készítőjének neve forráskritikai adat. Nem mindegy, hogy egy holokauszt-túlélővel egy kortárs történész, egy családtag vagy egy külföldi kutató beszélgetett-e.
- A kérdéseket is idézni kell, legalábbis akkor, amikor egy válaszra hivatkozik. Kérdés nélkül a válasz mást jelent.
2. A 20. Század Hangja Archívum
A legnagyobb magyar kvalitatív kutatási archívum. A Magyar Tudományos Akadémia Szociológiai Kutatóintézetében hívták életre 2009 tavaszán, 2019 óta a Társadalomtudományi Kutatóközpont Kutatási Dokumentációs Központjának részeként működik. Célja saját megfogalmazása szerint, hogy feltérképezze és kutathatóvá tegye a társadalomkutatók birtokában lévő hangzó és képi anyagokat, valamint a kutatások során keletkezett írott dokumentumokat.
Két honlapja van, és ezt érdemes rögtön az elején tisztázni, mert sokan itt akadnak el:
| Cím | Mire való |
|---|---|
20szazadhangja.tk.hu |
A bemutatkozó oldal: itt olvasható minden gyűjtemény részletes ismertetője, és innen tölthetők le a nyilatkozatok. |
voices.tk.mta.hu |
Maga az adattár: itt lehet böngészni a tételeket és megnézni a metaadatlapjukat. |
2.1 Mit őriz?
Nem interjúkat őriz, hanem kutatásokat. Ez a legfontosabb különbség a többi gyűjteményhez képest. Egy gyűjtemény jellemzően egy társadalomkutató életművének nyersanyaga: interjúk és átirataik, kérdőívek, adatlapok, terepjegyzetek, fényképek, kutatási jelentések és a belőlük született tanulmányok.
Néhány példa a gyűjtemények közül, hogy lássa a nagyságrendeket és a tematikai szélességet:
- Kemény István gyűjteménye – az 1971-es reprezentatív cigányvizsgálat anyaga, 283 dokumentum.
- Munkáséletmód kutatás – budapesti gyárak dolgozóinak életmódvizsgálata az 1970-es évek közepéről, 630 dokumentum, mintegy 1200 emberről.
- Kamarás István gyűjteménye – papi élet, bázisközösségek, megtérés, irodalomrecepció 1976 és 1990 között; 1101 digitalizált dokumentum, köztük nagyjából 550 interjúátirat.
- Munkaszolgálat 1939–1945 – a nemzetközi Dokumentation Zwangsarbeit kutatás magyar része: 19 magyar nyelvű, egyenként 2–4 órás élettörténeti interjú.
- Roma Polgárjogi Esték – roma aktivisták, művészek, politikusok élettörténetei 2012–2013-ból, 288 dokumentum.
- Szuhay Péter gyűjteménye – a roma holokauszt kutatása 12 településen, 2005-ből, 376 dokumentum.
A lista 2026 augusztusában közel negyven gyűjteményt sorol fel. A teljes, folyamatosan bővülő felsorolás a Kutatható gyűjtemények oldalon olvasható.
2.2 Hogyan böngésszen?
Az adattár minden gyűjteményen belül hatféle böngészési szempontot kínál:
- beküldés dátuma szerint,
- szerzők szerint,
- címek szerint,
- tárgyszavak szerint,
- kutatásvezetők szerint,
- kutatási módszerek szerint,
- dokumentumtípus szerint.
Az utolsó három szokatlan, és a leghasznosabb. Ha például azt szeretné látni, mely kutatások dolgoztak félig strukturált interjúval, azt itt módszer szerint kiválaszthatja – az írott források világában erre nincs megfelelő.
Figyelem A „szerző” itt nem az interjúalany
Az adattár Dublin Core-alapú metaadatokat használ (lásd a Mi az adatbázis? fejezetet). Ebben a
dc.contributor.author mező az interjú
készítőjét jelöli, nem azt, aki beszél.
Ez logikus – a szerzői jogi értelemben vett szerző valóban a kérdező –, de könnyű félreolvasni. Aki a szerzőnévre hivatkozik abban a hitben, hogy az interjúalanyt idézi, rossz nevet ír a lábjegyzetbe.
2.3 Mit lát egy tételen?
Minden tételnek van egy egyszerű és egy teljes metaadatlapja. A teljes lap mutatja meg igazán, mit tud az archívum.
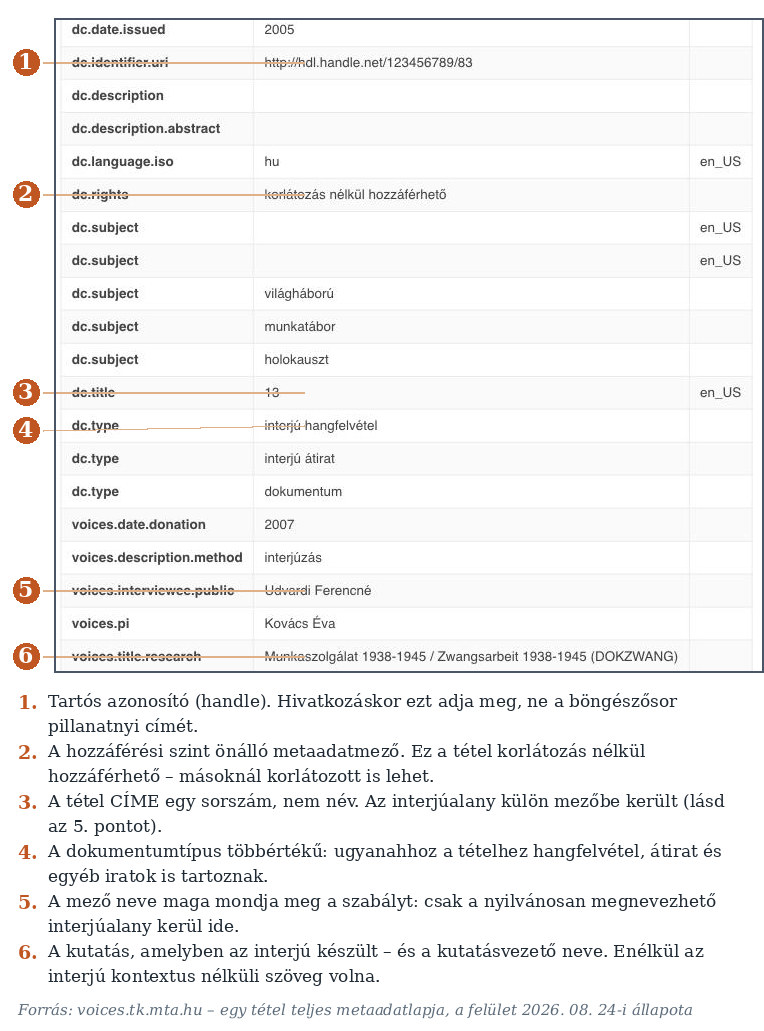
Négy dolgot érdemes megjegyezni róla.
(1) A hozzáférési szint önálló metaadatmező. A
dc.rights mezőben ott áll, hogy az adott tétel „korlátozás
nélkül hozzáférhető” – vagy éppen nem az. Ne a gyűjtemény egészéről
feltételezze a hozzáférhetőséget: a Munkaszolgálat-gyűjtemény
ismertetője például kifejezetten kimondja, hogy „az interjúkhoz
különböző hozzáférési jogosultságok tartoznak”.
(2) Egy tétel = egy interjú összes dokumentuma. A példában szereplő tételhez hozzájárulási nyilatkozat, ötoldalas adatlap, háromoldalas protokoll és biográfia, két interjúátirat (az eredeti és a fordítás), négy videórészlet és öt hangfájl tartozik. Erről szól az 5. ábra: egyetlen interjúból ennyi minden keletkezik.
(3) A tétel címe sorszám, a név külön mezőben van. A
voices.interviewee.public mező neve maga fogalmazza meg a
szabályt: ide csak a nyilvánosan megnevezhető
interjúalany kerül. Ahol nincs ilyen hozzájárulás, ott a tétel névtelen
marad.
(4) A kutatás neve is ott van. A
voices.title.research mezőből derül ki, melyik projekt
keretében készült az interjú, a voices.pi mezőből pedig, ki
vezette azt. Enélkül az interjú kontextus nélküli szöveg volna.
2.4 Hogyan jut hozzá az anyaghoz?
A metaadatokat bárki megnézheti. A fájlok megnyitásához felhasználói nyilatkozat kell: az archívum honlapjáról letölthető, ki kell tölteni, aláírni, és e-mailben vagy postán beküldeni. A nyilatkozat egyben adatkezelési szabályzat is.
Tipp Ezt időben intézze el.
A nyilatkozat elküldése és a hozzáférés megnyitása nem azonnali. Ha egy szemináriumi dolgozathoz oral history-forrást tervez használni, a nyilatkozatot a félév elején küldje el, ne a leadás előtti héten.
Addig sem áll a munka: a gyűjteményismertetők és a metaadatlapok szabadon olvashatók, és ezekből már meg lehet tervezni, pontosan mely tételekre lesz szüksége.
Mélyebben Miért van egyáltalán szükség nyilatkozatra?
Mert az archívumban őrzött anyagok jelentős része élő vagy nemrég élt emberek személyes adata, és a felhasználás feltételeit nem az archívum találta ki, hanem az interjúalany szabta meg – a saját hozzájárulási nyilatkozatában (lásd a 6.2 szakaszt). A felhasználói nyilatkozattal Ön ennek a láncnak az utolsó szemévé válik.
Ennek a rendszernek van egy tudományos hozadéka is: lehetővé teszi a másodelemzést, vagyis azt, hogy egy 1971-ben más kérdéssel felvett anyagot ma valaki egészen más kérdéssel olvasson újra. Több gyűjtemény ismertetője kifejezetten erre buzdít.
3. Az OSZK Történeti Interjúk Tára és a Magyar Október
Az Országos Széchényi Könyvtár audiovizuális gyűjteményének központi egysége a Történeti Interjúk Tára, amely 1985-ös megalakulása óta gyűjt és készít filmes, majd videós életútinterjúkat.
Az előtörténete önmagában is tanulságos. A dokumentumfilmesek egy része – a Századunk-csoport munkatársai, elsősorban Bokor Péter filmrendező – már a kezdetektől felismerte, hogy a teljes felvétel értékesebb, mint a belőle összevágott műsor: a napi adásba csak másolat került, az eredeti anyagot megőrizték. A tár lényegében ebből a hagyatékból nőtt ki.
Ma mintegy 1500 interjú van a gyűjteményben, az egyórástól a negyvenórás, sok alkalommal felvett élettörténetig, sokféle hordozón: filmen, UMATIC-on, Beta SP-n, VHS-en, DVCam-en, DVD-n és elektronikus formában. A tár a felvételek szövegét folyamatosan legépeli, a régi, papírra gépelt átiratokat pedig számítógépre viszi.
3.1 A hármas engedély
Ez a fejezet legszigorúbb hozzáférési modellje, és érdemes pontosan megjegyezni. Az interjúk hármas engedéllyel kutathatók:
- az interjúalany,
- az interjú készítője,
- és az interjútár vezetője engedélyével.
Ezen felül kutatói nyilatkozatot kell kitölteni, a kutatás pedig helyben, a Történeti Fénykép- és Interjútár olvasótermében történik.
Figyelem Ezt egy féléves szemináriumi dolgozat időkeretébe nehéz beilleszteni.
Ha a témájához feltétlenül ebből a tárból kellene interjú, azzal hónapokkal korábban kell elkezdeni foglalkozni, és a témavezetőjével együtt.
2020 végén indult egy program, amely a tár anyagából válogatva, kontextusba helyezve, a szerzői jogi törvénnyel összhangban hozna létre digitális tartalomszolgáltatást.
3.2 Ami viszont szabadon kutatható: a Szabad Európa Rádió 1956-os adásai
Az OSZK Jelenkortörténeti Gyűjteményének része a Szabad Európa Rádió Archívuma. 1997 óta a könyvtár – megállapodás alapján – „örökös és át nem ruházható joggal” bír a magyar szerkesztőség archív gyűjteménye felett.
A gyűjtemény legizgalmasabb részének útja regényes. A forradalom után Adenauer német kancellár bekérette a Szabad Európa Rádióban elhangzott adásanyagokat, hogy megvizsgálják, elhangzott-e fegyveres ellenállásra való egyértelmű felszólítás. A hangfelvételek ezután a koblenzi Bundesarchivba kerültek, onnan pedig 2001 őszén 311 darab 90 perces hangszalag érkezett a magyar nemzeti könyvtárba: az 1956. október 22. és november 13. között elhangzott SZER-adások. A tár munkatársai ezeket digitalizálták, és elkészítették a szöveges leiratot.
Az eredmény a magyaroktober.hu oldalon szabadon
kutatható; a rádiós rész külön címen, a szer.oszk.hu
felületen érhető el.
Ez a fejezet egyetlen olyan anyaga, amelyet most, azonnal, regisztráció nélkül, otthonról használni tud – és amelyben szó szerinti szövegre lehet keresni.
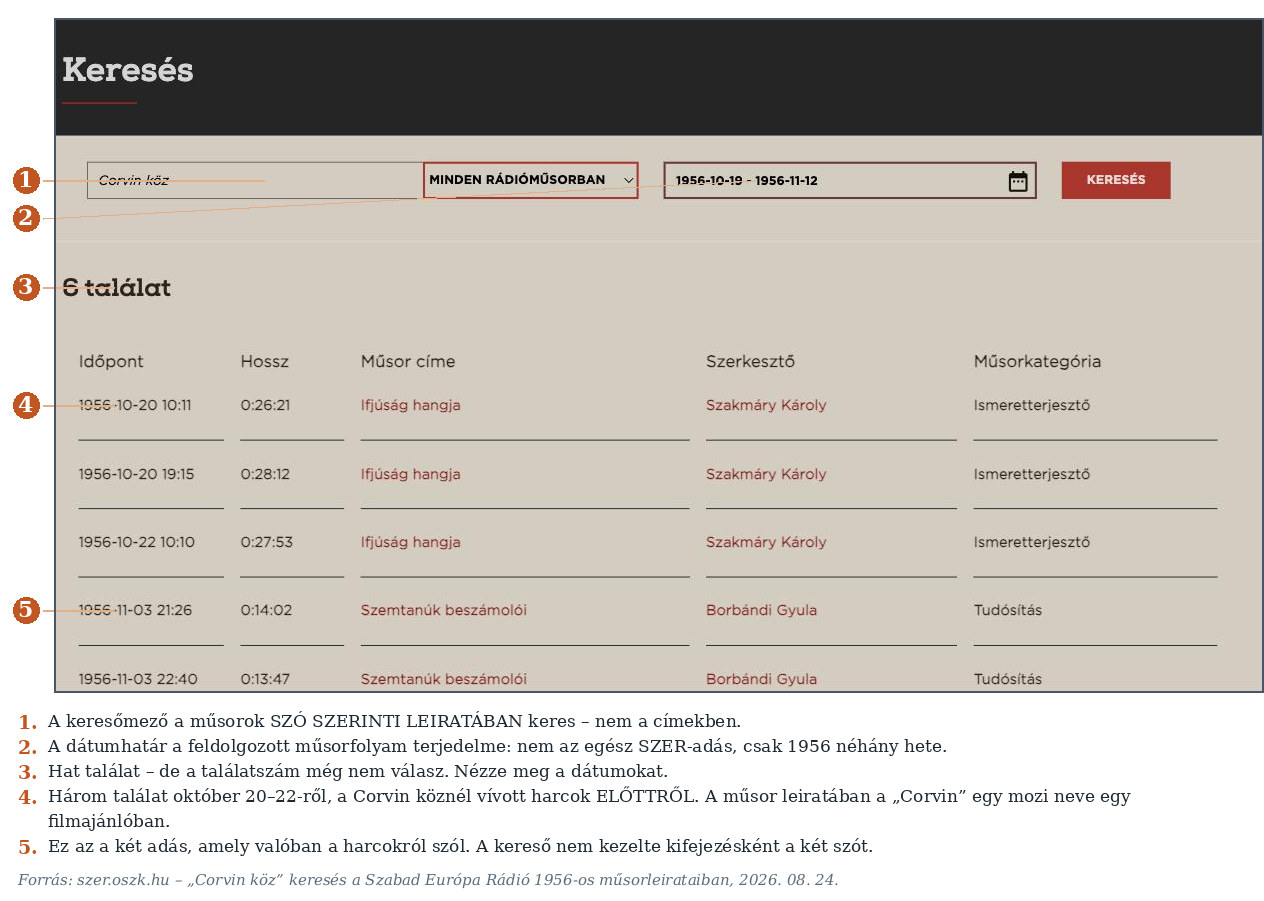
Figyelem A találatszám még nem válasz
2026. augusztus 24-én a Corvin köz keresés hat találatot
adott. Ebből három 1956. október 20-ról és 22-ről származik – vagyis
a Corvin köznél vívott harcok előttről. Ha valaki csak
a találatszámot nézi, könnyen arra jut, hogy a Szabad Európa már október
20-án beszélt a Corvin közről.
Nem beszélt. Az október 20-i adás – az Ifjúság hangja című műsor – leiratában a „Corvin” szó egyetlen helyen fordul elő: egy filmajánlóban, a Corvin mozi neveként.
A tanulság általános, és minden szabadszavas keresőre igaz: a kereső nem feltétlenül kezeli kifejezésként a beírt szavakat. Mielőtt egy találatra hivatkozik, nyissa meg a leiratot, és nézze meg, hol és milyen értelemben szerepel benne a keresett szó. Ugyanez a probléma jött elő a Cikkszintű keresés fejezet operátorainál is.
Tipp Amit ez a felület tud, és más nem
Minden találat mellett ott a pontos időpont percre, a műsor hossza, címe, szerkesztője és műsorkategóriája – és megnyitva a teljes szó szerinti leirat, valamint maga a hangfelvétel.
Ez azt jelenti, hogy egy 1956-os témájú dolgozatban percre datálható szövegforrást tud idézni, és mellé oda tudja tenni, hogy ki szerkesztette az adást. Írott forrásból ilyen pontosságot ritkán kap.
Figyeljen viszont a dátumhatárra: a feldolgozott műsorfolyam 1956 néhány hetét fedi le, nem a SZER teljes, 1950-től 1993-ig tartó működését.
4. Centropa: szerkesztett életrajzok
A Centropa közép- és kelet-európai zsidó családok 20. századi élettörténeteit gyűjti. Az Életrajzok felület magyarul is használható, és a három gyűjtemény közül ez az, amelyik a legkevesebb akadályt állítja az olvasó elé: a teljes szöveg és a hozzá tartozó családi fényképanyag regisztráció nélkül olvasható.
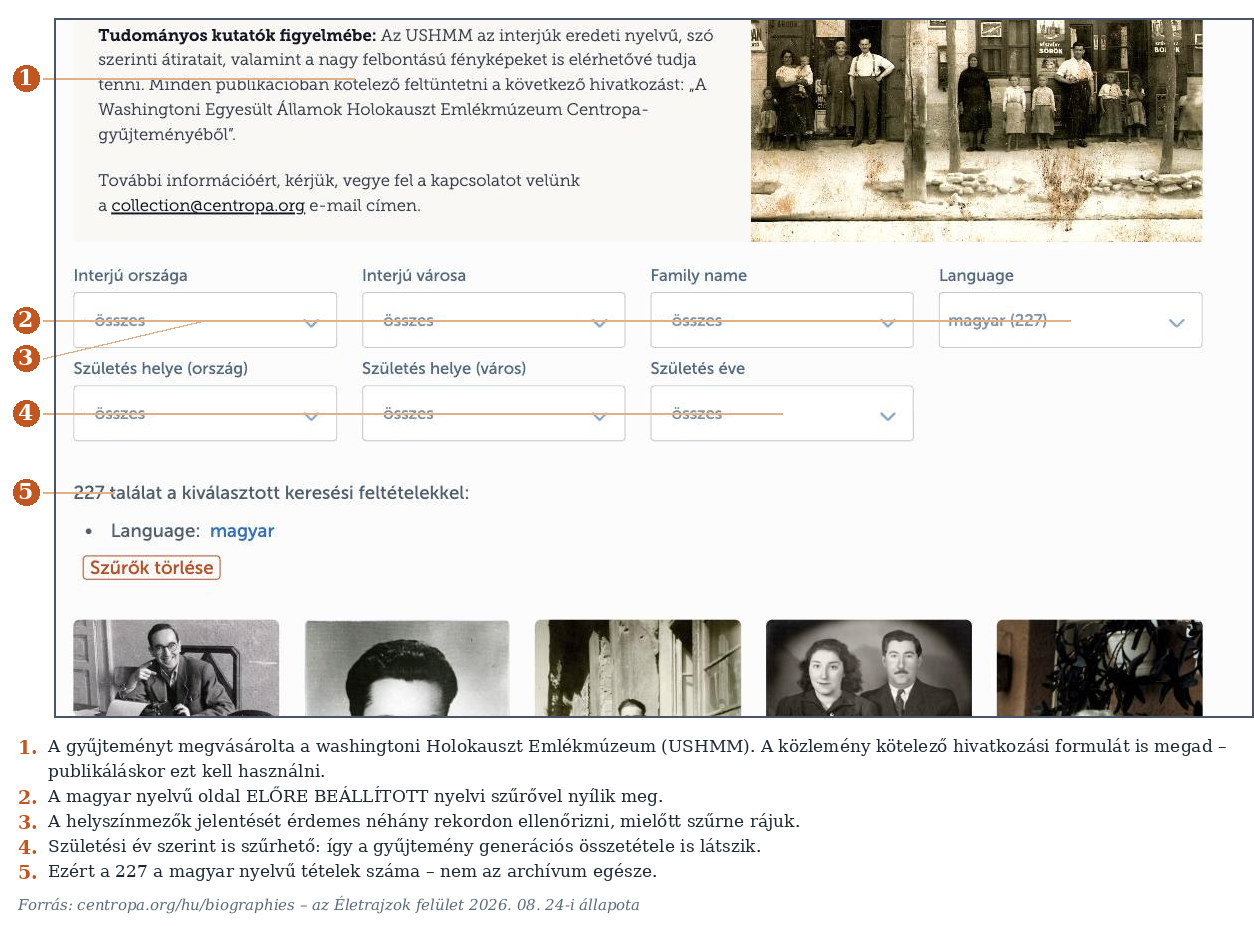
4.1 Amit tudni kell róla, mielőtt idézne
(1) Ez nem szó szerinti átirat, hanem szerkesztett elbeszélés. A felületen folyamatos, olvasható életrajzi szöveget talál, nem kérdés-felelet formájú interjúátiratot. A szerkesztés maga is értelmezés: kihagy, sorrendet választ, összevon. Ha egy mondatot idéz belőle, azt idézi, ahogyan a Centropa megszerkesztette – ezt a dolgozatban jelezni kell.
(2) Az eredeti nyelvű, szó szerinti átirat máshol van. Az oldal saját közleménye szerint a Centropa archívumát megvásárolta a washingtoni Holokauszt Emlékmúzeum (USHMM), amely az interjúk eredeti nyelvű, szó szerinti átiratait és a nagy felbontású fényképeket is elérhetővé tudja tenni. Ha tehát a pontos szöveg kell, oda kell fordulni.
(3) Kötelező hivatkozási formula van. Ugyanez a közlemény kimondja, hogy minden publikációban fel kell tüntetni: „A Washingtoni Egyesült Államok Holokauszt Emlékmúzeum Centropa-gyűjteményéből”.
Figyelem A magyar oldal előre beállított szűrővel nyílik meg
A centropa.org/hu/biographies címen a nyelvi szűrő eleve
magyar értéken áll, és a kiírt 227 találat ezért a
magyar nyelvű tételek száma, nem az archívum egésze. A
nyelvválasztóban ott van többek között az angol, a német és a cseh
is.
A számokat ne adja össze: ugyanaz az élettörténet több nyelven is szerepelhet, mert a Centropa az interjúk jelentős részét fordításban is közli.
4.2 Mit lát egy életrajzon?
Minden életrajz mellett ott a forráskritikához szükséges minimum: ki készítette az interjút, melyik évben, hol, és melyik projekt keretében. A szöveg mellett két további fül található: a Fotók, illetve a Photos on a map, amely a családi fényképeket térképre helyezi.
Tipp Nézze meg a mezők jelentését, mielőtt szűrne rájuk.
Egy 2004-ben Kolozsvárott készült interjú rekordjában az Interjú helyszíne mezőben Kolozsvár áll – az Ország mezőben viszont Magyarország. Nem tudjuk biztosan, mit rögzít ez a mező (elképzelhető, hogy a Centropa melyik irodája készítette az interjút), és amíg nem tudjuk, nem szabad ráépíteni egy állítást.
Ez a fejezet visszatérő tanulsága, és a Térbeli adatbázisok fejezet is ugyanezt mondta: egy szűrő akkor használható, ha tudjuk, mit mér. Ellenőrizze néhány rekordon, mielőtt statisztikát csinál belőle.
5. A három gyűjtemény együtt
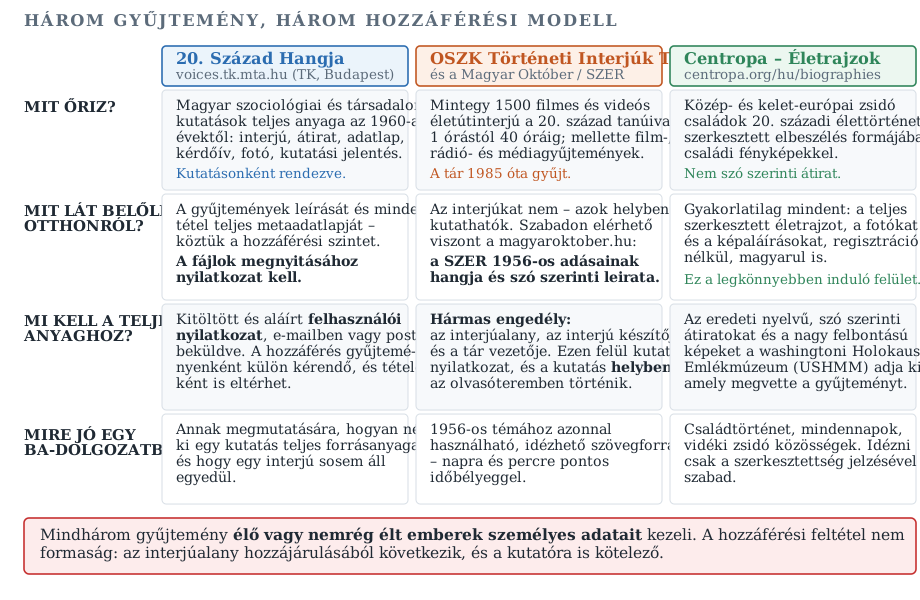
Ha egy mondatban kellene eldönteni, hova induljon:
- 1956-os témához → a Magyar Október / SZER-leiratok, azonnal.
- Társadalomtörténeti, munkás-, roma- vagy oktatástörténeti témához → a 20. Század Hangja, a nyilatkozat elküldése után.
- Család-, mindennapok- és zsidó közösségtörténethez → a Centropa, a szerkesztettség jelzésével.
- Ha csak ez az egy interjú kellene, és sehol nincs
meg → akkor jön a
- szakasz.
5.1 Gyakorló: melyik gyűjteményhez fordulna?
Nyolc kutatási helyzet. Mindegyiknél döntse el, hova indulna először. Figyelje meg, hogy nem mindig a leggazdagabb gyűjtemény a jó válasz – néha az számít, mennyi idő alatt jut hozzá.
Feladat Melyik gyűjteményhez fordulna?
Döntse el minden helyzetről, hová indulna először: 20. Század Hangja, OSZK Történeti Interjúk Tára, Magyar Október / SZER, Centropa, vagy saját interjút kell készíteni.
| Kutatási helyzet | Válasz |
|---|---|
| 1956-os rádióadások szó szerinti szövege, lehetőleg ma | Magyar Október / SZER |
| 1970-es évekbeli munkásinterjúk a kérdőívekkel és jelentésekkel együtt | 20. Század Hangja |
| Vidéki zsidó család mindennapjai, magyarul, azonnal olvashatóan | Centropa |
| Filmre vett, többórás életútinterjú egy közéleti szereplővel | OSZK Történeti Interjúk Tára |
| „Hogyan beszélnek ma a falu egykori középparasztjai…” | Saját interjú |
| Hányszor hangzott el a „munkástanács” szó a forradalom alatt | Magyar Október / SZER |
| Az 1971-es cigányvizsgálat teljes dokumentációja | 20. Század Hangja |
| 2005-ös élettörténeti interjú egy kényszermunkással | 20. Század Hangja |
A vezérfonal: előbb azt kérdezze meg, mennyi ideje van, csak utána azt, hol a leggazdagabb az anyag.
6. Ha saját interjút készít
Ez a szakasz nem helyettesíti a módszertani szakirodalmat, és nem is arra való, hogy elolvasása után azonnal interjút készítsen. Célja felhívni a figyelmet az interjúkészítés lehetőségére és korlátaira.
Figyelem Saját interjút csak a témavezetőjével egyeztetve készítsen.
Az interjú élő emberek személyes – gyakran különleges – adatait hozza létre és rögzíti. Ennek adatvédelmi következményei vannak, amelyekért Ön felel. Erről az Adatkezelés és adatvédelem fejezet szól, és a 6.5 szakasznak is ez a tárgya.
6.1 Kérdés, nem téma
Az interjú akkor lesz forrás, ha kutatási kérdés hívta életre. „Beszélgetek a nagypapámmal a téeszesítésről” még nem kutatás; „azt szeretném megérteni, hogyan beszélnek ma a falu egykori középparasztjai a belépés kényszeréről” már az.
Ez ugyanaz a lépés, amit a Hogyan épül fel egy történeti kutatás? fejezet kérdésélesítő feladata gyakoroltat.
6.2 A hozzájárulás
A hozzájárulási nyilatkozat nem adminisztratív teher, hanem az a dokumentum, amelyben az interjúalany szabja meg, mit lehet a szöveggel később kezdeni. A 20. Század Hangja Archívum honlapjáról letölthető ilyen minta – ez a legjobb kiindulópont, mert egy működő archívum gyakorlatát tükrözi.
Legalább ezekre kell kiterjednie:
- ki készíti az interjút, milyen kutatás keretében, milyen célra;
- készül-e hangfelvétel, videó, átirat;
- megnevezhető-e az interjúalany, vagy csak névtelenül idézhető;
- felhasználható-e a szöveg későbbi kutatásokhoz (másodelemzés), és elhelyezhető-e archívumban;
- van-e olyan része az elbeszélésnek, amelyet az alany zárolni kér, és visszavonhatja-e később a hozzájárulást.
Tipp A hozzájárulás nem egy aláírás, hanem egy beszélgetés.
Az aláírt papír a beszélgetés lenyomata, nem a helyettesítője. Az interjú előtt mondja el érthetően, magyarul, mit fog csinálni a felvétellel – és utána is kérdezze meg, maradt-e olyan, amit az alany mégsem szeretne írásban látni.
Az oral history etikai kérdései éppen azért kerültek az utóbbi időben előtérbe, mert felmerült az interjúpartnerek emlékezetének „kirablásával” kapcsolatos aggodalom.42
6.3 Az interjúhelyzet
A szakirodalom egyik legfontosabb tanulsága, hogy a jó interjú nem attól jó, hogy sok kérdést tesz fel. Az élettörténeti interjúk gyakorlatában a hangsúly a kérdezésről a hallgatásra helyeződik: az első kérdés után a kérdező lehetőleg hagyja, hogy az interjúpartner maga építse fel az élettörténeti nagyelbeszélést, és inkább jelenlétével, mint közbeszólásaival biztassa.43
Amit ebből a gyakorlatra le lehet fordítani:
- Egy jó nyitókérdés többet ér, mint húsz jó részletkérdés. Az élettörténeti interjú nyitókérdése rendszerint tág és nyitott.
- A hallgatás nem üresjárat. A csend után gyakran a legfontosabb mondat jön.
- A részletkérdések a végére valók – amikor a saját elbeszélés már lezárult.
- Ne javítsa ki az alanyt. Ha egy évszám nem stimmel, jegyezze fel, és ellenőrizze utólag más forrásból. A tévedés maga is adat.
- A körülmények is forrás. Ki volt még a szobában, mi hangzott el a felvétel előtt és után – ez a protokoll tárgya (lásd a következő szakaszt).
6.4 Ami az interjú után keletkezik
Az archívumok gyakorlata megmutatja, mi tartozik egy szakszerűen elkészített interjúhoz. A 2.3 szakaszban látott tétel négy dokumentumtípust tartalmazott a felvételen kívül – és ugyanezt a négyet kell Önnek is előállítania.
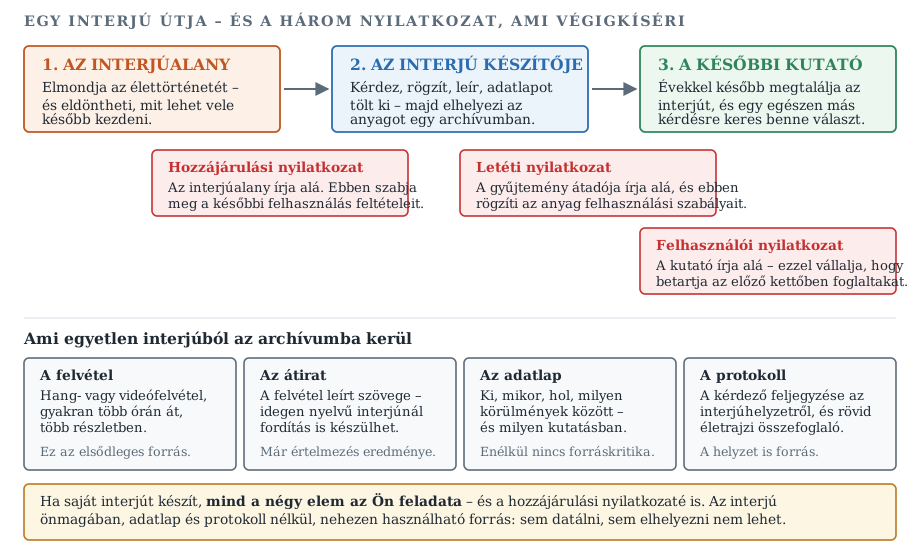
Figyelem Adatlap és protokoll nélkül az interjú nehezen használható forrás.
Sem datálni, sem elhelyezni nem lehet: nem derül ki, ki beszél, mikor, milyen kutatásban és milyen helyzetben. Öt év múlva Ön maga sem fogja tudni.
Ezt a két dokumentumot az interjú napján írja meg, ne később.
6.5 Leiratozás – és mikor használhat gépi segítséget?
A leiratozás a munka leglassabb része: egy óra beszéd kézzel leírva rendszerint négy-hat óra. Kézenfekvő gépi beszédfelismerőhöz nyúlni. Magyar nyelvre a legismertebb ilyen szolgáltatás az Alrite, amely a hangból és videóból leiratot készít, időbélyeggel, beszélőelkülönítéssel, felirattal és fordítással; a leiratban keresni is lehet. Használatához regisztráció kell, a folyamatos használat pedig előfizetéshez kötött – a pontos csomagokat és feltételeket az oldalon kell megnézni, mert változnak.
És most jön az a rész, ami miatt ez a szakasz itt van.
Figyelem Interjúfelvétel feltöltése egy felhőszolgáltatásba.
Az ELTE BTK Történeti Intézetének MI használati szabályzata a 3.6. pontban szigorúan tiltja, hogy MI-rendszerbe kerüljenek – többek között – az oral history interjúk átirataiban szereplő személyes adatok, valamint a nem publikált kutatási eredmények. Ugyanezt mondja ki a 4/2025. (X. 28.) rektori utasítás 4.3. és 6.4. pontja a személyes adatokra általában.
Egy frissen felvett interjú hangfájlja tele van személyes adattal: nevekkel, címekkel, születési évekkel, egészségügyi és vallási adatokkal – és magával a hanggal, amely azonosít.
Ez nem formaság: az adatvédelmi előírások megsértése a szabályzat 8.1. pontja szerint súlyos vétség.
Tipp Mit tehet ehelyett?
- Kérdezze meg a témavezetőjét, mielőtt bármit feltölt, és kérje írásban a választ.
- Terjessze ki a hozzájárulási nyilatkozatot. Ha az alany kifejezetten hozzájárul ahhoz, hogy a felvétel gépi leiratozáshoz külső szolgáltatóhoz kerüljön, az más helyzet – de akkor tudnia kell megmondani neki, melyik szolgáltatóhoz és milyen feltételekkel.
- Olvassa el a szolgáltató adatkezelési tájékoztatóját – hol tárolják a fájlt, meddig, és felhasználják-e modelltanításra.
- Ha bizonytalan, írja le kézzel. Lassabb, de a leiratozás közben olyan dolgokat vesz észre – szünetet, hangsúlyt, önjavítást –, amit a gép nem jelöl, és amit egy jó elemzés használni tud.
Az MI-használat teljes szabályozását a Mesterséges intelligencia fejezet 4. szakasza tárgyalja; a nyilatkozattételi kötelezettség erre az esetre is vonatkozik.
És az egyetemi Teams? Az sem megoldás. A dékáni utasítás által „megbízható MI-szolgáltatásnak” nevezett környezet a szerzői jogvédett tartalom bevitelét engedi meg – a személyes adatét nem. Egy interjúfelvétel pedig tele van személyes adattal. Lásd a Mesterséges intelligencia fejezet vonatkozó alszakaszát.
Esettanulmány Egy nap kétféle hangja – 1956. november 4.
A kérdés: hogyan beszélt a szovjet bevonulás napjáról a Szabad Európa Rádió akkor – és hogyan beszélnek róla a visszaemlékezők évtizedekkel később?
A lépések:
- A
szer.oszk.hufelületen szűkítse a dátumot 1956. november 3–5-re, és nézze végig, milyen műsorok szerepelnek. Válasszon ki egy tudósítást, és olvassa el a teljes leiratát. - Jegyezze fel a műsor pontos időpontját, címét, szerkesztőjét és műsorkategóriáját – ezek lesznek a hivatkozás adatai.
- Keresse meg ugyanennek a napnak az emlékét egy visszaemlékezésben: a Centropa magyar életrajzai között több olyan is van, amelyben az 1956-os ősz szerepel.
- Írja le, mi a különbség a két szöveg időszerkezetében: az egyik a történés közben, a másik a történés után évtizedekkel keletkezett.
- Végül: melyik kérdésre melyiket használná? Fogalmazzon meg egy-egy kutatási kérdést, amelyre az egyik jó forrás, a másik nem.
Amit tanulni lehet belőle: nem azt, hogy melyik forrás „igazabb”, hanem hogy más kérdésre válaszolnak. A kettős datálás elve itt kézzelfoghatóvá válik.
Reflexiós feladatok
Feladat 1. feladat – A találat és a szöveg
A
szer.oszk.hufelületen keressen rá egy Önt érdeklő kifejezésre (például: munkástanács, Kossuth tér, határ).Jegyezze fel a találatok számát, majd nyisson meg legalább hármat, és keresse meg a leiratban, hol szerepel a keresett szó.
Készítsen táblázatot: dátum – műsor címe – a szó tényleges előfordulása – valóban arról szól-e, amire Ön gondolt?
Írjon egy bekezdést arról, hány találat bizonyult félrevezetőnek, és miért.
Elvárt formátum: háromsoros táblázat + kb. 150 szavas reflexió.
Feladat 2. feladat – Olvasson egy metaadatlapot
Nyissa meg a voices.tk.mta.hu oldalt, válasszon ki egy
gyűjteményt, azon belül egy tételt, és nézze meg a
teljes elembejegyzését.
Mi a tétel hozzáférési szintje? Melyik mezőből derül ki?
Ki a
dc.contributor.author, és ki avoices.interviewee.public? Mi köztük a különbség?Melyik kutatásban készült az interjú, és ki vezette azt?
Milyen dokumentumtípusok tartoznak a tételhez? Hány fájl, és milyen formátumban?
Írja meg úgy a tétel hivatkozását, hogy abból egy olvasó vissza tudja találni – a tartós azonosító (handle) felhasználásával.
Elvárt formátum: öt rövid válasz + egy kész hivatkozás.
Feladat 3. feladat – Tervezzen egy interjút (nem kell elkészítenie)
Válasszon egy témát, amelyhez saját interjú illene, és készítsen interjútervet:
egy mondatban a kutatási kérdés;
kit kérdezne meg, és miért éppen őt;
a nyitókérdés – pontosan úgy, ahogyan feltenné;
öt részletkérdés, amelyeket csak az elbeszélés lezárása után tenne fel;
mit tartalmazna a hozzájárulási nyilatkozat: nevesíthető-e az alany, archiválható-e a felvétel, visszavonható-e a hozzájárulás;
hogyan készítené el a leiratot – és ha gépi segítséget használna, milyen engedéllyel és milyen feltételekkel (lásd a 6.5 szakaszt).
Elvárt formátum: kb. egyoldalas interjúterv.
Önellenőrző kérdések
1. Miért mondjuk, hogy egy visszaemlékező interjúnak két időpontja van?
Válasz megjelenítése
Mert az elbeszélt esemény ideje és az elbeszélés ideje két különböző dolog. Egy 2005-ben felvett interjú a második világháborúról nem 1944-es forrás: azt is őrzi, hogyan látta a beszélő 2005-ben azt, ami 1944-ben történt.
2. A 20. Század Hangja Archívumban kit jelöl a „szerző” mező?
Válasz megjelenítése
Az interjú készítőjét, nem az interjúalanyt. Az interjúalany külön
mezőben (voices.interviewee.public) szerepel, és csak
akkor, ha nyilvánosan megnevezhető.
3. Honnan tudja meg, hogy egy tétel hozzáférhető-e korlátozás nélkül?
Válasz megjelenítése
A teljes metaadatlap dc.rights mezőjéből. A hozzáférési
szint tételenként eltérhet, ezért a gyűjtemény egészéről nem szabad rá
következtetni.
4. Mit jelent az OSZK Történeti Interjúk Tárában a „hármas engedély”?
Válasz megjelenítése
Azt, hogy az interjú kutatásához az interjúalany, az interjú készítője és az interjútár vezetője engedélye is kell – ezen felül kutatói nyilatkozat, és a kutatás helyben, az olvasóteremben történik.
5. Mi a különbség egy Centropa-életrajz és egy interjúátirat között?
Válasz megjelenítése
A Centropa-életrajz szerkesztett, folyamatos elbeszélés, nem szó szerinti átirat. A szerkesztés maga is értelmezés, ezért idézéskor jelezni kell. Az eredeti nyelvű, szó szerinti átiratokat a washingtoni Holokauszt Emlékmúzeum (USHMM) tudja elérhetővé tenni, amely a gyűjteményt megvásárolta.
6. Miért nem elég a találatszám egy szabadszavas keresőben?
Válasz megjelenítése
Mert a kereső nem feltétlenül kezeli kifejezésként a beírt szavakat. A
Corvin köz keresés olyan 1956. október 20-i adást is
találatként adott, amelynek leiratában a „Corvin” egy mozi neveként
szerepel. Hivatkozás előtt meg kell nyitni a szöveget, és meg kell nézni
a tényleges előfordulást.
7. Melyik négy dokumentum tartozik egy szakszerűen archivált interjúhoz?
Válasz megjelenítése
A felvétel, az átirat, az adatlap (ki, mikor, hol, milyen kutatásban) és a protokoll (a kérdező feljegyzése az interjúhelyzetről, rövid életrajzzal). Ezen felül a felhasználást a hozzájárulási, a letéti és a felhasználói nyilatkozat szabályozza.
8. Feltöltheti-e egy frissen felvett interjú hangfájlját egy online leiratozó szolgáltatásba?
Válasz megjelenítése
Alapesetben nem. A Történeti Intézet MI használati szabályzatának 3.6. pontja szigorúan tiltja az oral history interjúk átirataiban szereplő személyes adatok MI-rendszerbe vitelét, a rektori utasítás 4.3. és 6.4. pontja pedig a személyes adatokét általában. Kivétel csak a témavezető vagy kutatásvezető kifejezett írásos engedélyével van.
Összefoglalás
Ebben a fejezetben azzal a forrástípussal ismerkedtünk meg, amely a kutató közreműködésével jön létre. Láttuk, hogy az interjúnak két időpontja van, és hogy ez nem hibája, hanem a legfőbb értéke: egyszerre őrzi az eseményt és azt, ahogyan később látták.
Három magyar nyelven használható gyűjteményt jártunk körül, három különböző hozzáférési modellel. A 20. Század Hangja Archívum egész kutatások anyagát őrzi, metaadatai szabadon olvashatók, a fájlokhoz felhasználói nyilatkozat kell. Az OSZK Történeti Interjúk Tára mintegy 1500 életútinterjút őriz, hármas engedéllyel és helyben kutathatóan – ugyanakkor a Magyar Október / SZER felületén az 1956-os rádióadások hangja és szó szerinti leirata bárki számára szabadon kereshető. A Centropa szerkesztett életrajzai a legkönnyebben elérhetők, de éppen a szerkesztettségüket kell a hivatkozásban jelezni.
Végül átvettük, mi tartozik egy saját interjúhoz: a kutatási kérdéstől a hozzájárulási nyilatkozaton át a felvételig, az átiratig, az adatlapig és a protokollig. És láttuk, hogy a leiratozás gépesítése nem technikai, hanem adatvédelmi kérdés: egy interjúfelvétel feltöltése külső szolgáltatóhoz adattovábbítás, amelyet az egyetemi és intézeti szabályozás alapesetben tilt.
A fejezet legfontosabb mondata: az interjú nem attól lesz forrás, hogy felvették, hanem attól, hogy dokumentálták.
Kulcsfogalmak
adatlap (interjúé) – Az interjú alapadatait rögzítő dokumentum: ki, mikor, hol, milyen kutatás keretében készítette, kivel. Enélkül az interjú nem datálható és nem kritizálható forrásként.
hozzájárulási nyilatkozat – Az interjúalany által aláírt dokumentum, amelyben meghatározza, milyen feltételekkel használható fel később az elbeszélése: megnevezhető-e, archiválható-e, felhasználható-e másodelemzéshez.
kettős datálás – Az az elv, hogy egy visszaemlékező forrásnál mindig két időpontot kell megadni és figyelembe venni: az elbeszélt eseményét és az elbeszélés keletkezéséét.
másodelemzés – Egy korábbi kutatás céljára felvett anyag újraolvasása egy másik kutatási kérdés szempontjából; a kvalitatív kutatási archívumok egyik fő célja, hogy ezt lehetővé tegyék.
oral history – Kutatási módszer és forrástípus: kutatási céllal készített, rögzített és archivált visszaemlékező interjú egy esemény, folyamat vagy élethelyzet részesével vagy tanújával.
protokoll (interjúé) – A kérdező feljegyzése magáról az interjúhelyzetről – körülmények, jelenlévők, a felvételen kívül elhangzottak –, rendszerint rövid életrajzi összefoglalóval együtt.
szerkesztett életrajz – Interjúból készült, folyamatos elbeszéléssé formált szöveg, amely nem azonos a szó szerinti átirattal; a szerkesztés maga is értelmezői döntések sora.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Horváth Sándor: Muszáj interjúzni? Az oral history mint nyilvános és/vagy szakszerű történelem. Forrás, 2011/7–8. 21–38. http://epa.oszk.hu/02900/02931/00145/pdf/EPA02931_forras_2011_7-8_021-038.pdf
- Vértesi Lázár: Oral history. A szemtanúként elbeszélt történelem lehetőségei. Aetas, 2004/1. 158–172. https://epa.oszk.hu/00800/00861/00027/pdf/vertesi.pdf
- A 20. Század Hangja Archívum és Kutatóműhely gyűjteményismertetői és letölthető nyilatkozatai (TK SZI).
- Az Országos Széchényi Könyvtár ismertetője az audiovizuális dokumentumokról (Történeti Interjúk Tára, Magyar Mozgóképkincs Gyűjtemény, Szabad Európa Rádió Archívum, Médiafigyelő Gyűjtemény).
- A Centropa Életrajzok felületének kutatóknak szóló közleménye.
- 4/2025. (X. 28.) rektori utasítás a mesterséges intelligencia oktatásban történő használatáról az Eötvös Loránd Tudományegyetemen, 4.3. és 6.4. pont.
- Mesterséges intelligencia használati szabályzat. ELTE BTK Történeti Intézet, 3.6. és 8.1. pont.
Ajánlott irodalom
- „Interjúzni muszáj.” A magyar oral history gyűjtemények története. Ujkor.hu https://ujkor.hu/content/interjuzni-muszaj-a-magyar-oral-history-gyujtemenyek-tortenete
Linkek és eszközök
- 20. Század Hangja Archívum és Kutatóműhely (bemutatkozó oldal) – https://20szazadhangja.tk.hu/kutathato-gyujtemenyek-uj – elérve: 2026. 08. 24.
- 20. Század Hangja – letölthető nyilatkozatok – https://20szazadhangja.tk.hu/letoltheto-dokumentumok – elérve: 2026. 08. 24.
- 20. Század Hangja adattár (böngészés, metaadatlapok) – https://voices.tk.mta.hu/ – elérve: 2026. 08. 24.
- OSZK – audiovizuális dokumentumok – https://oszk.hu/av_dokumentumok – elérve: 2026. 08. 24.
- Magyar Október – az 1956-os forradalom online adatbázisa – https://www.magyaroktober.hu/ – elérve: 2026. 08. 24.
- Szabad Európa Rádió 1956-os műsorai, leirattal – https://szer.oszk.hu/ – elérve: 2026. 08. 24.
- Centropa – Életrajzok – https://www.centropa.org/hu/biographies – elérve: 2026. 08. 24.
- Alrite (magyar nyelvű gépi leiratozó szolgáltatás) – https://alrite.io/ – elérve: 2026. 08. 24.
Digitális forráskiadás
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 90 perc |
| Előfeltétel | Mi a forrás?, Digitalizálás és OCR |
| Verzió / dátum | v0.1 / 2026. augusztus |
Miről szól ez a fejezet?
Ez a fejezet arról szól, mi történik akkor, amikor egy történeti forrásból tudományos igényű digitális kiadvány lesz. Megnézzük a forráskiadás típusait, a munkafolyamat lépéseit a tervezéstől a közzétételig, a metaadatstruktúra megtervezését és a formátumválasztás szempontjait. Végül egy magyar platformot, a dHUplát mutatjuk be.
A fejezet nemcsak azoknak szól, akik maguk készítenek forráskiadást: aki használ digitális forráskiadást, annak is tudnia kell, milyen döntések állnak mögötte – ez a forráskritika része.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- megkülönbözteti a digitális forráskiadás négy típusát (fakszimile, teljes szövegű, kritikai, fordítás), és mindegyikhez példát hoz;
- felsorolja a forráskiadás munkafolyamatának fő lépéseit, és megnevezi, melyik lépésben milyen döntés születik;
- egy konkrét dokumentumról megállapítja a szerzői jogi státuszát a 70 éves védelmi idő szabálya alapján;
- összeállítja egy forrás alapvető (deskriptív) és technikai metaadatait;
- indokolt választást tesz a kiadás formátuma (PDF, XML/TEI, JPEG/PNG) között egy adott kiadási cél mellett.
Bevezetés
Definíció Fogalom: digitális forráskiadás
Olyan tudományos gyakorlat, amely a történeti dokumentumokat nemcsak digitalizált formában, hanem kritikai jegyzetekkel, metaadatokkal és kereshető módon teszi hozzáférhetővé a kutatók és az érdeklődők számára. A cél nem csupán a forrás digitalizálása, hanem annak tudományos feldolgozása és az eredeti dokumentum értelmezésének segítése.
Miért van szükség digitális forráskiadásokra?
- Hozzáférhetőség. A digitalizált dokumentumok könnyen elérhetők online felületeken, ami különösen fontos azoknál a forrásoknál, amelyek fizikai formában nehezen hozzáférhetők.
- Kereshetőség. A szöveg digitalizálása lehetővé teszi a kulcsszavak és kifejezések gyors keresését. Ez jelentősen meggyorsítja a kutatási munkát, különösen nagy terjedelmű források esetén.
- Metaadatok hozzáadása. A dokumentumokat kiegészítik olyan információkkal, mint a szerző, a keletkezés dátuma, a helyszín és a témakör. Ezek elősegítik a dokumentumok rendszerezését és könnyebb visszakereshetőségét.
- Kritikai jegyzetek. A forráskiadások magyarázatokkal, jegyzetekkel és szövegkritikai megjegyzésekkel gazdagodnak, amelyek segítik a szöveg tudományos feldolgozását.
- Kapcsolhatóság. A digitalizált források más adatbázisokhoz és forrásokhoz kapcsolhatók, így kontextusba helyezhetők és hálózatokba rendezhetők.
- Interaktivitás és vizualizáció. A felhasználók megjegyzéseket fűzhetnek a szöveghez, vagy grafikus ábrázolásokat, kapcsolati hálókat is elérhetnek.
1. A digitális forráskiadás típusai
A digitális forráskiadás nem egységes módszer, hanem különböző formákat és típusokat foglal magában. A történeti dokumentumok digitalizálásának célja és a kutatási igények határozzák meg, hogy milyen típusú kiadás készül.
1.1 Fakszimile kiadás
Jellemzői: az eredeti dokumentum képi megjelenítése digitalizált formában; a dokumentum eredeti külalakjának és formátumának megőrzése.
Előnyei: a forrás eredeti formájában látható, ami fontos a paleográfiai és filológiai vizsgálatokhoz; a képi megjelenítés lehetővé teszi az eredeti írás, az aláírások és a pecsétek tanulmányozását.
Hátrányai: kereshetősége korlátozott, csak a kép megtekintésére alkalmas; az eredeti szöveg nem szerkeszthető, nem másolható.
Példa: régi oklevelek digitalizált másolatai az Országos Levéltár honlapján.
1.2 Teljes szövegű kiadás
Jellemzői: a dokumentum szövegének átírt és digitalizált változata; kereshető és szerkeszthető formában érhető el.
Előnyei: könnyen kereshető kulcsszavak alapján; a szöveg nyelvi elemzése egyszerűen elvégezhető.
Hátrányai: az eredeti dokumentum formátuma elveszik; előfordulhatnak átírási hibák, különösen kézírásos anyagok esetében.
Példa: Móricz Zsigmond levelezése a dHUpla platformon.
1.3 Kritikai kiadás
Jellemzői: a dokumentum szövegének átírása jegyzetekkel és kritikai megjegyzésekkel ellátva; a szöveg variánsait és értelmezési lehetőségeit is tartalmazza.
Előnyei: tudományos igényű feldolgozás részletes magyarázatokkal; segít az olvasónak megérteni az eltérő szövegváltozatok közötti különbségeket.
Hátrányai: nagy szakmai felkészültséget igényel; elkészítése időigényes és bonyolult.
Példa: Kölcsey Ferenc összes verseinek kritikai kiadása.
1.4 Fordítás
Jellemzői: az eredeti nyelven íródott dokumentum átírt és fordított változata; gyakran párhuzamosan jelenik meg az eredeti és a fordított szöveg.
Előnyei: idegen nyelvű források könnyebb megértése; a történeti kontextus bemutatása több nyelven.
Hátrányai: a fordítás eltérhet az eredeti szöveg jelentésétől; az eredeti nyelvi sajátosságok elveszhetnek.
Példa: latin nyelvű középkori oklevelek magyar fordításai.
Tipp A négy típus nem zárja ki egymást – a jó digitális forráskiadás gyakran egyszerre kínálja a fakszimilét (oldalkép) és a teljes szövegű átiratot, kritikai jegyzetekkel. Amikor forráskiadást használ, mindig nézze meg, melyik réteget látja éppen: az oldalképet vagy az átiratot. Idézni az oldalkép alapján ellenőrzött szöveget szabad.
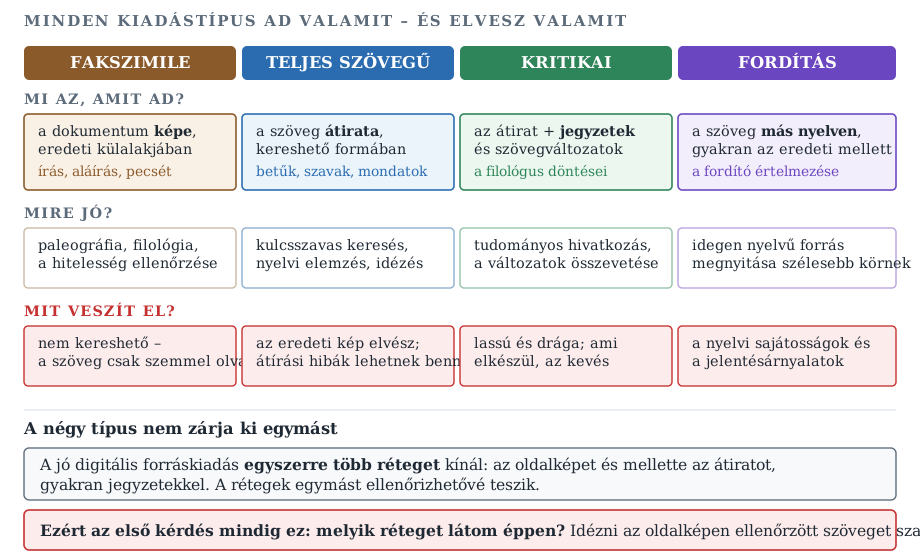
2. Mi nem forráskiadás? – a levéltári adatbázis elhatárolása
Ez a könyv IV. része végig levéltári adatbázisokról szól: a Hungaricanáról, az ELP-ről, a LIR-ről, az Állambiztonsági archontológiáról. Fontos tisztázni, hogy ezek nem forráskiadások – és hogy miért nem.
A szakirodalom gyakran tárgyalja együtt a levéltári adatbázisokat és a digitális forráskiadásokat, elmosva a határt közöttük. Helyesebb a kettőt különválasztani – ahogyan „egy mikrofilmtekercset sem tekintünk forráskiadásnak”.
Definíció Fogalom: tudományos digitális szövegkiadás
Olyan kiadás, amely a történeti dokumentum kritikai reprezentációja: a forrást digitális formában jeleníti meg, metaadatokkal látja el, és szövegkritikai megjegyzéseket fűz hozzá. Nem tekinthető annak az a digitalizált dokumentum, amely nem reflektál a szöveg és a hordozó sajátosságaira.
A két forma logikája alapvetően eltér:
| Szempont | Levéltári adatbázis | Digitális forráskiadás |
|---|---|---|
| Kiindulópont | az adatstruktúra | az adott forrás vagy forráscsoport |
| Szervezőelv | szabvány vagy előre rögzített változók | egységes elvek, de az egyedit kezeli |
| Cél | az iratra vonatkozó információ elérhetővé tétele, nyilvántartás | a forrás kritikai közreadása |
| Tudományos apparátus | nincs | van (jegyzetek, szövegkritika, bevezető tanulmány) |
| Hasonlat | „segédlettel ellátott mikrofilmtekercs” | kritikai kiadás digitálisan |
Figyelem Az adatbázisban tárolt adat önmagában nem informatívabb, mint ami az eredeti iratban van.
Az adatbázis előnye máshol van: az egységes adatszerkezetben, az ebből következő összekapcsolhatóságban és a gyors kereshetőségben. Ez sok, de nem ugyanaz, mint a forráskritikai feldolgozás.
Mind a levéltári adatbázisok, mind a tudományos igényű digitális forráskiadás szakmai fejlődését szolgálja, ha a két kategóriát nem mossuk össze.
2.1 A papíralapú forráskiadás típusai – amiből a digitális örököl
A digitális forráskiadás típusai (1. szakasz) a papíralapú hagyományból nőttek ki. Érdemes ismerni az eredetit is:
- Fakszimile kiadás – az eredetivel megegyező tartalmi és formai jegyekkel rendelkező hasonmás; a formai és anyagi hűségre koncentrál, különösen középkori és kora újkori iratoknál.
- Regeszta – az okleveleket kivonatosan közli, tudományos apparátussal.
- Teljes szövegű közlés – a teljes szöveget publikálja, előre meghatározott elvek szerint átírva és normalizálva.
- Kritikai szövegkiadás – a fentin túl szövegkritikai apparátusban közli a szövegbeli és a példányok közötti különbségeket.
- Fordítás – itt is kiemelten fontos a jegyzetapparátus.
Mélyebben Egy hiányzó szabvány
A magyar forráskiadásnak egyetlen hivatalos szabályzata van, és az 1920-ban jelent meg. A digitális technika azóta gyökeresen átalakította a lehetőségeket, de jelenleg nem áll rendelkezésre olyan szabvány, amely minimálisan meghatározná a történeti források digitális kiadásával szemben támasztott elvárásokat.
Ez nem elméleti hiány. Mivel a 20. századi géppel írt iratok OCR-ezése ma már könnyű, kevés erőfeszítéssel készíthetők olyan „kiadványok”, amelyek nem estek át alapos szöveggondozáson – ami a kézírásos szövegek átírásánál kényszerűségből mindig megtörténik.
2.2 Internetes forrásközlés – lehetőség és veszély
Egy kutató ma minimális költséggel publikálhat egy forrást bármely weboldalon. Ez leginkább a fakszimile kiadásra hasonlít, azzal a különbséggel, hogy míg egy fakszimile kötetben tematikusan több iratot publikálnak, az interneten egyetlen irat közzététele is lehetséges.
Figyelem A jelzetétől megfosztott iratkép önálló életre kel.
Az internetes iratpublikálás fő veszélye, hogy a kép a levéltári jelzete nélkül kerül fel, és onnantól nem lehet rá hivatkozni, sem egy nagyobb irategység részeként értelmezni. Ez ugyanaz a probléma, amiről a Hungaricana fejezet „A találat nem azonos a forrással” doboza szól – csak itt a közzétevő hibájából.
Magyar fórumok, amelyek ezt tudományos igénnyel teszik:
- ArchívNET – kifejezetten a történeti források online publikálására létrehozott internetes folyóirat; papíralapú változata nincs.
- Betekintő – levéltári kiadás, tanulmányokkal, nyomtatásban is megjelenik.
Ezekben legtöbbször nem az iratok szkennelt változata, hanem a teljes szövegű átirat jelenik meg kísérőtanulmánnyal és jegyzetapparátussal. Ez teljesíti a tudományos forráskiadás alapkritériumait – de csak részben használja ki a digitális publikálás technikai lehetőségeit.
Definíció Digitalizált kiadás vs. digitális kiadás
Egy papíralapon megtervezett és elkészített kiadás tartalma és funkciói nem változnak meg attól, hogy digitalizálják – ez digitalizált kiadás.
Egy digitális forráskiadás viszont nem adható ki nyomtatásban a tartalom és a funkcionalitás jelentős csökkenése nélkül: a nyomtatás során elveszik a lehetőség, hogy ugyanabból az elektronikus kódból nagyszámú dokumentumot lényegében korlátlan számú nézetben jelenítsünk meg.
3. Hogyan készül a digitális forráskiadás?
A digitális forráskiadás elkészítése több szakaszból áll, amelyek gondos tervezést, szakértelmet és megfelelő technikai megoldásokat igényelnek.
3.1 Célkitűzés meghatározása
Miért szeretnénk digitalizálni az adott forrást?
- Tudományos kutatás: az eredeti források elérhetővé tétele és kritikai feldolgozása.
- Közösségi hozzáférés: széles közönség számára elérhető források.
- Oktatási cél: források bemutatása egyetemi vagy középiskolai felhasználásra.
Példák: Móricz Zsigmond levelezésénél a cél az irodalmi élet és a társadalomtörténet vizsgálata; középkori okleveleknél a cél a történeti hűség és a kritikai elemzés biztosítása.
3.2 Források kiválasztása
Mely dokumentumok kerülnek feldolgozásra? Lehet egy adott szerző teljes levelezése; tematikus gyűjtemény (például politikai röplapok); vagy különleges történeti értékkel bíró dokumentumok (naplók, visszaemlékezések).
Szempontok a kiválasztáshoz:
- Relevancia: a téma kutatásának szempontjából fontos dokumentumok.
- Eredetiség: a dokumentumok hitelessége és történeti értéke.
- Hozzáférhetőség: fizikai elérhetőség és szkennelési lehetőségek.
Figyelem A forráskiadás maga is válogatás. Amikor később egy kutató ezt a kiadást használja, azzal a szerkesztői döntéssel is dolgozik, hogy mi került bele és mi nem. Ezért közöl minden komoly forráskiadás bevezető tanulmányt a kiválasztás elveiről – és ezért érdemes ezt a bevezetőt elolvasni, mielőtt az anyagot használja.
3.3 Szerzői jogi helyzet tisztázása
A digitális forráskiadás során kiemelten fontos a szerzői jogi helyzet alapos tisztázása. A szerzői jog védelme biztosítja a szerzők és jogutódok érdekeit, és meghatározza, hogy mikor és hogyan lehet egy dokumentumot nyilvánosan közzétenni.
A szerzői jogi védelem időtartama. A szerzői jogi védelem Magyarországon általában a szerző halálától számított 70 évig tart. A védelem időtartama nem a dokumentum keletkezési dátumától függ, hanem a szerző halálának időpontjától. A 70 év elteltével a mű közkinccsé válik, vagyis szabadon felhasználható, digitalizálható és közzétehető.
Példa Móricz Zsigmond 1942-ben halt meg, így az ő művei 2012-től váltak közkinccsé. Ady Endre 1919-ben hunyt el, így művei 1989 óta szabadon felhasználhatók.
Mikor szükséges jogutódi engedély? Ha a szerző halála óta kevesebb mint 70 év telt el, akkor a dokumentum szerzői jogi védelem alatt áll. Az ilyen művek digitalizálása és közzététele előtt engedélyt kell kérni a jogutódoktól (család, örökös, kiadó). Az engedély megszerzése dokumentált formában történjen, hogy később igazolható legyen a jogszerű felhasználás.
Kivétel: közhasznú dokumentumok. Bizonyos dokumentumok nem esnek szerzői jogi védelem alá, mert közérdekű adatokat tartalmaznak vagy az állam alkotta őket: hivatalos iratok (törvények, rendeletek, bírósági határozatok); közérdekű adatok (nyilvános statisztikák, jelentések); állami szervek által létrehozott anyagok.
Figyelem A közhasznú dokumentumok nem azonosak a kulturális értékű történeti dokumentumokkal (levelek, naplók), amelyek szerzői jogvédelem alá eshetnek. Egy irodalmi mű, még ha hivatalos iratok között is található, nem válik automatikusan közhasznúvá.
Hogyan ellenőrizhetjük a jogi helyzetet? A Szellemi Tulajdon Nemzeti Hivatalának szerzői jogi adatbázisaiból; digitalizált könyvtári adatbázisokból, amelyek gyakran tartalmaznak jogi információkat; levéltári nyilvántartásokból, ahol a dokumentum eredeti tárolási helye is megismerhető.
3.4 Digitalizálás és OCR
A munkafolyamat következő két lépése – a szkennelés technikai paramétereinek megválasztása és az optikai karakterfelismerés – önálló fejezetet kapott: lásd a Digitalizálás és OCR fejezetet.
A történeti forráskiadás azonban egy ponton túllép a klasszikus OCR-en: a levéltári anyag túlnyomó része kézírás, amelyet a nyomtatott betűkre kifejlesztett karakterfelismerő nem tud olvasni. Erre a feladatra külön eszközcsalád jött létre, a kézírás-felismerés (HTR, handwritten text recognition).
Mélyebben A Transkribus és a kézírás-felismerés
A Transkribus európai uniós projektek keretében fejlesztett platform, amely nemcsak szövegfelismerésre, hanem képelemzésre és a dokumentum szerkezetének felismerésére is alkalmas: kezeli a kézzel írt táblázatos formákat, és azonosítani tudja az utólagos bejegyzéseket is.
A gép azonban itt is csak segédeszköz. Az adott kézírás olvasására az algoritmust meg kell tanítani: ehhez megfelelő mennyiségű szöveget kézzel kell átírni, és ezt az átiratot mintaként a rendszer elé tenni. A platform kooperációra épül, több kutató dolgozhat közösen ugyanazon a dokumentumon – így a betanításhoz szükséges munka megosztható.
Miért gyengébb a magyar HTR? Az angol és a német nyelvű kézírás felismerése jelenleg sokkal pontosabb, mert ezeken a nyelveken már jóval több szöveget dolgoztak fel, vagyis a háttérben futó mesterségesintelligencia-alapú alkalmazás több forrásból tanulhatott. Ez nem a magyar nyelv sajátossága, hanem a rendelkezésre álló tanítóanyag mennyiségének kérdése: magyar nyelvű szövegek betanításával az algoritmus teljesítménye javítható. Ebből következik, hogy minden magyar HTR-projekt egyben közjószágot is termel.
Forrás: Ring Orsolya: Történeti források kiadása a digitális világban (Magyar Tudomány, 2025); Transkribus – https://www.transkribus.org/
4. A metaadatstruktúra megtervezése
A digitális forráskiadás során a metaadatok struktúrájának megtervezése alapvető fontosságú.
Definíció Fogalom: metaadat
Olyan információ, amely leírja, rendszerezi és kontextusba helyezi a digitális dokumentumot. Segítségével a digitalizált tartalmak kereshetők, visszakereshetők és más forrásokkal összekapcsolhatók.
4.1 Alapvető (deskriptív) metaadatok
Ezek az adatok írják le a dokumentum tartalmát és kontextusát.
| Mező | Mit tartalmaz? | Példa |
|---|---|---|
| Szerző | A dokumentum alkotója; több szerző esetén mindegyik | Móricz Zsigmond |
| Cím | A dokumentum hivatalos megnevezése; ha nincs, rövid leírás | Móricz Zsigmond levele Hatvany Lajoshoz |
| Dátum | A keletkezés vagy kiadás dátuma (év, hónap, nap) | 1928. május 14. |
| Helyszín | A létrehozás helye vagy kapcsolódó földrajzi adat | Budapest |
| Témakör | A dokumentum tárgya, szabványos kulcsszavakkal | Irodalomtörténet, 20. századi magyar irodalom |
| Nyelv | A dokumentum nyelve, ISO nyelvkóddal | hu |
4.2 Technikai metaadatok
Ezek az adatok a digitális objektum technikai jellemzőit írják le.
| Mező | Mit tartalmaz? | Példa |
|---|---|---|
| Fájlformátum | A digitális dokumentum formátuma | PDF/A |
| Fájlméret | A fájl digitális mérete | 5,2 MB |
| Forrás eredete | Az eredeti dokumentum lelőhelye, gyűjteménye | OSZK Kézirattár, Fond 123 |
| Digitalizálás dátuma | Mikor történt a digitalizálás | 2025. március 10. |
| Jogállás | A szerzői jogi helyzet vagy licenc | Közkincs (public domain) |
4.3 Metaadat-szabványok
A metaadatok egységesítése érdekében szabványokat alkalmazunk.
Dublin Core. Célja alapadatok tárolása és a könnyű hozzáférés biztosítása. Fő elemei: Title (cím), Creator (szerző), Subject (témakör), Date (dátum), Format (formátum). Előnye, hogy egyszerű, széles körben elfogadott és könnyen alkalmazható.
TEI (Text Encoding Initiative). Nemzetközi szabvány, amely a történeti és irodalmi szövegek digitális kiadására szolgál. Célja, hogy a szövegeket olyan formában jelenítse meg, amely a kutatók és a felhasználók számára is könnyen kereshető, strukturált és metaadatokkal gazdagított.
Definíció Fogalom: TEI (Text Encoding Initiative)
Nemzetközi, XML-alapú kódolási szabvány történeti és irodalmi szövegek digitális kiadásához. A szöveg elemeit (nevek, helyek, dátumok, szövegváltozatok, jegyzetek) címkékkel jelöli, így azok géppel is feldolgozhatóvá és kereshetővé válnak.
Miért hasznos a TEI?
- Strukturált szövegkezelés: lehetővé teszi a szövegek logikai és hierarchikus elrendezését.
- Tudományos feldolgozás: a szöveg elemzéséhez szükséges metaadatok és annotációk könnyen kezelhetők.
- Kereshetőség: az XML-alapú struktúra miatt a szöveg egyes elemei (nevek, helyek, dátumok) könnyen visszakereshetők.
- Interoperabilitás: a TEI-formátum széles körben elfogadott a digitális bölcsészeti projektekben.
5. A formátum kiválasztása
A formátum meghatározza a dokumentumok kezelésének, megjelenítésének és felhasználásának módját. A választás a dokumentum típusától, a felhasználás céljától és a kutatási igényektől függ.
PDF (Portable Document Format). Statikus, nyomtatásra alkalmas dokumentumformátum, amely megőrzi az eredeti elrendezést, formázást és képi megjelenítést. Előnye, hogy minden eszközön azonos, könnyen nyomtatható és archiválható. Hátránya, hogy a szöveg nem minden esetben kereshető (ha nem tartalmaz OCR-adatokat), és nehezen szerkeszthető. Tipikus felhasználás: fakszimile kiadások.
XML/TEI. Strukturált szövegformátum, amely címkékkel jelöli a szöveg szerkezetét, és alkalmas a szövegek logikai felosztására, annotációjára és elemzésére. Előnye a részletes, pontos szövegstruktúra; kiválóan alkalmas tudományos kiadásokhoz és szövegváltozatok kezelésére. Hátránya, hogy kezelése bonyolult lehet nem szakértő felhasználók számára, és létrehozása időigényes. Tipikus felhasználás: tudományos forráskiadások.
JPEG / PNG. Képfájlformátumok a dokumentumok vizuális megjelenítésére. A JPEG tömörített, a PNG veszteségmentes. Előnyük, hogy magas felbontásban is könnyen megoszthatók. Hátrányuk, hogy a képek szöveges tartalma nem kereshető, és a kiváló minőség nagy fájlméretet jelent. Tipikus felhasználás: fakszimile kiadások, kéziratok, eredeti dokumentumok megjelenítése.
Példa Egy forráskiadás három rétege
A Móricz-levelezés kiadásánál mindhárom formátum megjelenik: az eredeti levél szkennelt képe JPEG formátumban; a levelek fakszimile változata PDF-ben; a szöveges átirat pedig TEI-ben, amely a kritikai jegyzeteket is tartalmazza.
6. A dHUpla platform
Definíció Fogalom: dHUpla
A dHUpla (Digitális Bölcsészeti Platform) olyan online felület, amely lehetővé teszi a történeti és irodalmi dokumentumok digitális forráskiadását. A platform célja, hogy a kutatók, oktatók és hallgatók számára könnyen hozzáférhetővé tegye a tudományos igényességgel digitalizált és feldolgozott dokumentumokat.
Az eszköz alapadatai
| Eszköz neve | dHUpla – Digitális Bölcsészeti Platform |
| URL | https://dhupla.hu/ |
| Üzemeltető | Országos Széchényi Könyvtár Digitális Bölcsészeti Központja, a Petőfi Irodalmi Múzeum közreműködésével |
| Hozzáférés | Ingyenes, regisztráció nélkül |
| Tartalomtípus | Kritikai szövegkiadások, levelezéskiadások, folyóiratkiadás; kézirat-fakszimile és TEI-átirat |
| Fő menüpontok | Szövegkiadások, Entitástár, Kreatív tartalmak, Műhely |
6.1 Mi érhető el rajta?
A platform nem egyetlen kiadás, hanem kiadások gyűjtőhelye. A Szövegkiadások menüpont alatt egymástól független projektek állnak, közös felülettel és közös entitástárral:
| Kiadás | Típus | Mit tartalmaz? |
|---|---|---|
| Móricz Zsigmond levelezése (1892–1913) | digitális kritikai kiadás (2.0 verzió) | A 6.6 szakasz esetpéldája |
| Móricz Zsigmond: Tükör (1914–1917) | digitális forráskiadás | Világháborús naplófeljegyzések a hátországból és a hadszíntérről |
| Petőfi Sándor levelezése | digitális forráskiadás | A költő levelezésének az OSZK-ban őrzött része |
| Kiss József levelezése | digitális forráskiadás | A Hét alapító szerkesztőjének levelezése (PIM és OSZK) |
| Keresztury Dezső levelezése | digitális forráskiadás | Az OSZK Kézirattárának legterjedelmesebb levelezésanyaga, közel 70 év |
| Illyés Gyula naplói és jegyzetei | digitális forráskiadás | Naplójegyzetek |
| A Tett | digitális forráskiadás | Az avantgárd folyóirat 1915–1916-os évfolyama |
| Gróf Teleki László tanácsadása a nevelésről [1796] | digitális népszerűsítő kiadás | Kiadatlan 18. századi pedagógiai kézirat |
(A lista 2026. 08. 24-i állapot; a platform folyamatosan bővül.)
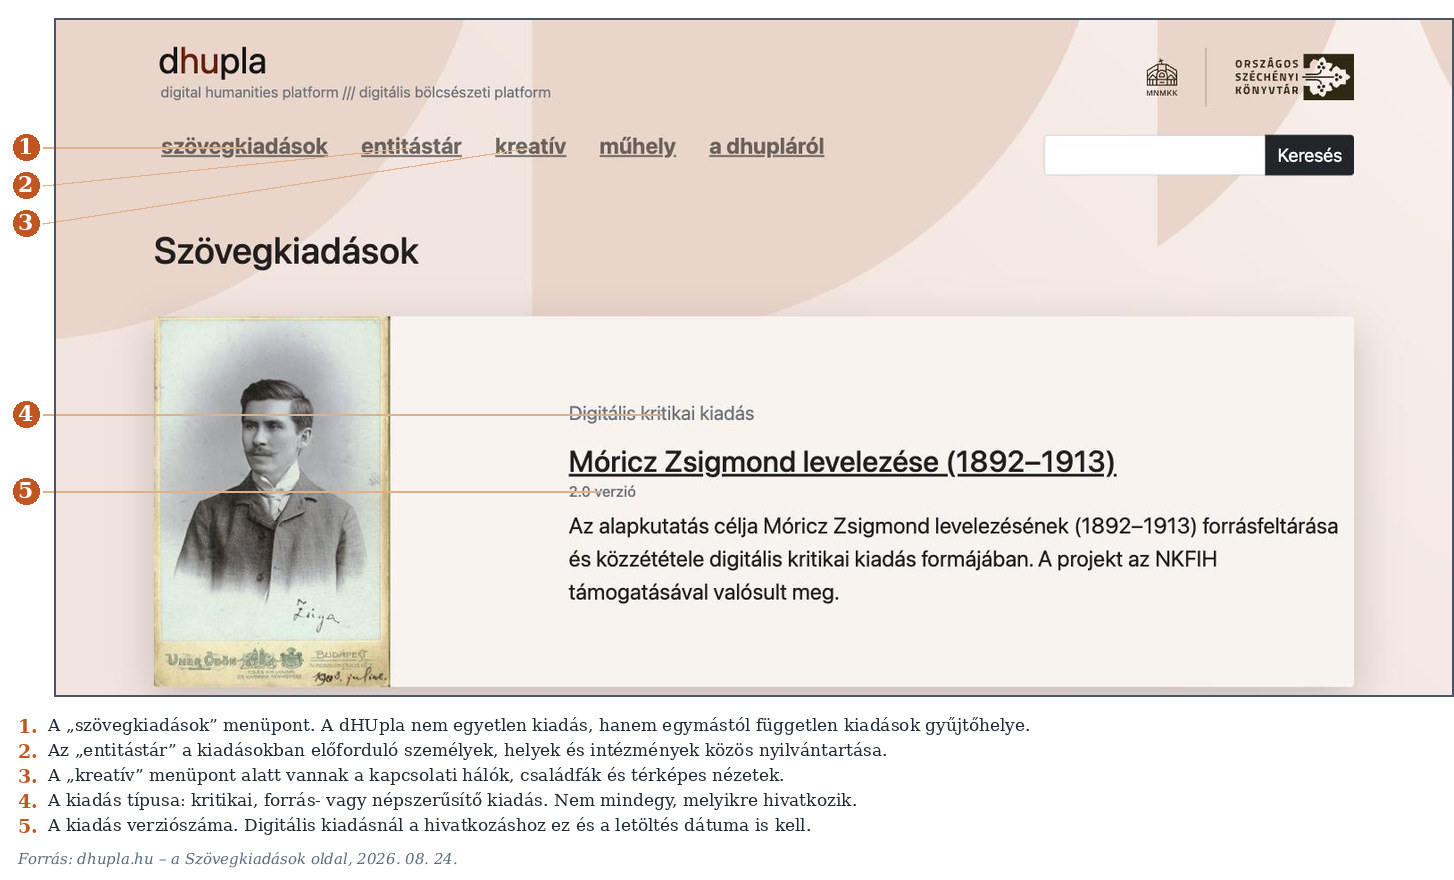
Történészhallgatóként ezek elsőre irodalmi kiadásoknak látszanak – és azok is. De egy levelezéskiadás társadalomtörténeti forrás is: kik írtak kinek, milyen gyakran, honnan hova, milyen ügyekben. A dHUpla épp ezt teszi vizsgálhatóvá, mert a leveleket nemcsak szövegként, hanem adatként is kezeli.
Tipp Az entitástár a lényeg.
A dHUpla külön menüpontja az Entitástár: a kiadásokban előforduló személyek, helyek és intézmények közös nyilvántartása. Ez teszi lehetővé, hogy ugyanaz a személy több kiadásban is azonosítható legyen – és ez az, amiből a következő szakaszban tárgyalt vizualizációk készülnek. Aki csak a levélszövegeket olvassa el, a platform felét használja ki.
6.2 A kreatív tartalmak: amikor a kiadásból adat lesz
A kreatív menüpont a platform legérdekesebb része a történész számára, mert itt látszik meg, mire jó, hogy a kiadás nemcsak szöveget, hanem azonosított entitásokat tárol. A vizualizációk mögött nincs új forrás: ugyanaz a levélanyag áll bennük, csak nem levelenként, hanem összesítve.
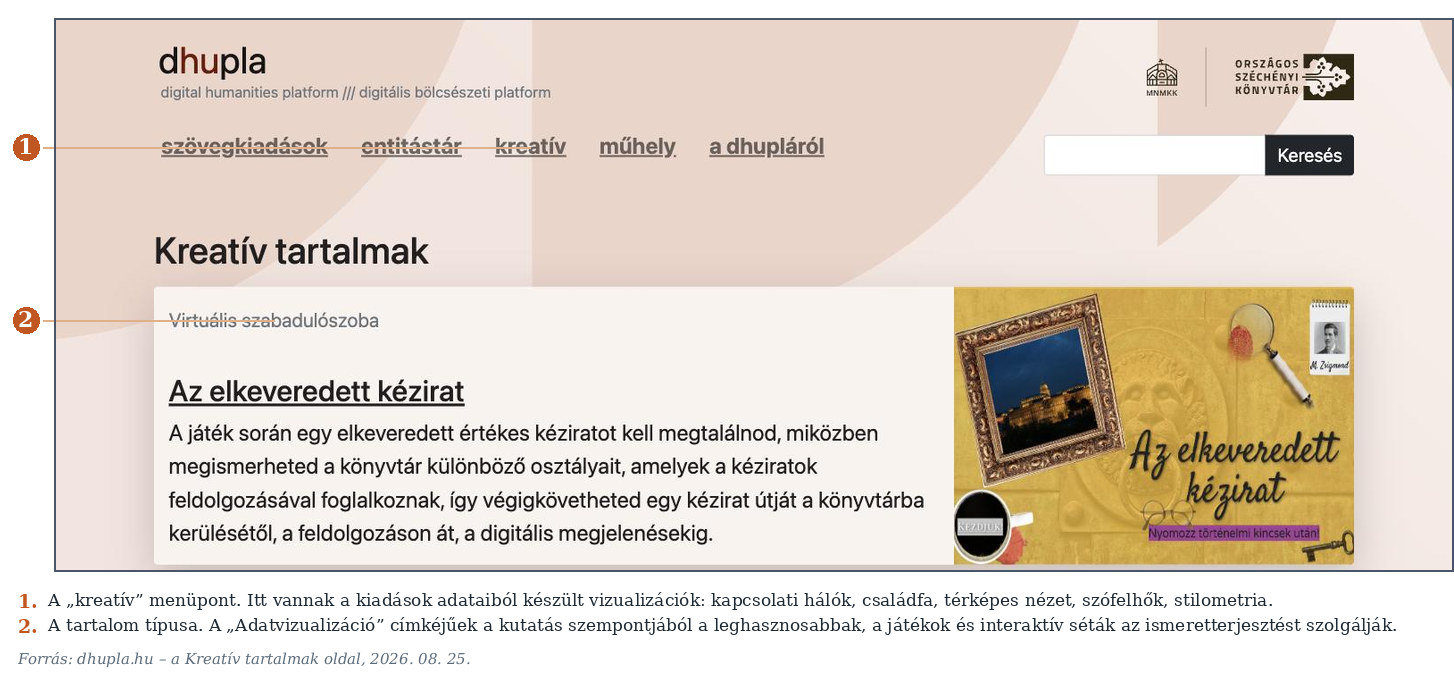
Kapcsolati hálók. A csomópontok a levelezőpartnerek, az élek a levélváltások. A platformon jelenleg négy ilyen áll: Vas István, Széchényi Ferenc (mintegy hétszáz autográf levélváltás alapján), Kiss József és Móricz Zsigmond (520 kézirat, 136 levelezőpartner). Ezek nem illusztrációk: azt mutatják meg, ki állt a kapcsolathálózat közepén, kik voltak a peremén, és mely csoportok kapcsolódtak egymáshoz – olyan kérdések, amelyeket a levelek egyenkénti elolvasásával nem lehet megválaszolni.
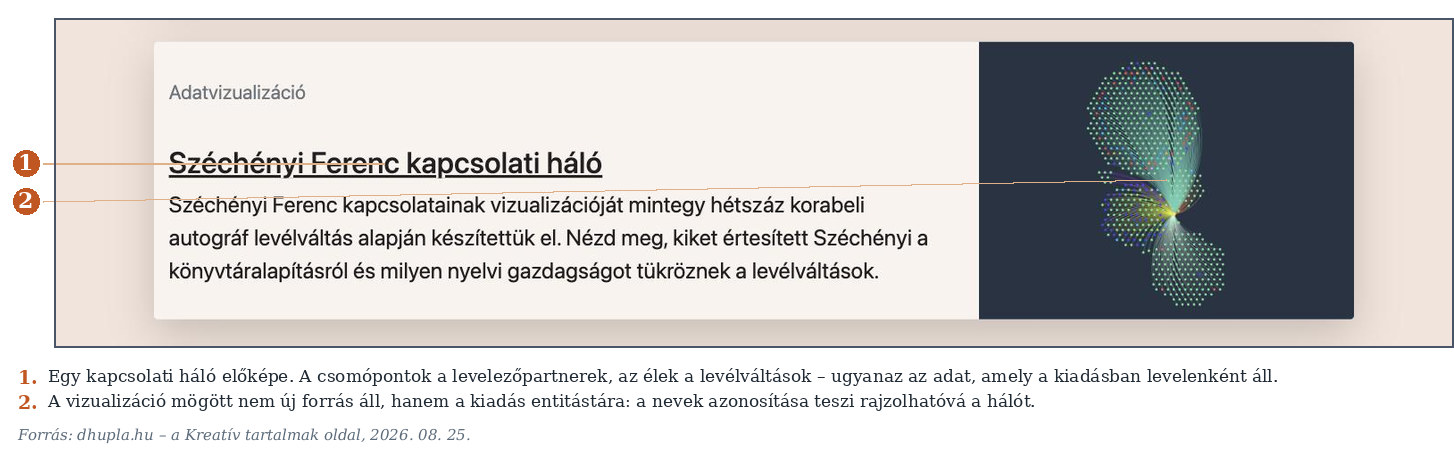
Családfa. A Móricz-családfa a Móricz- és a Holics-család rokonsági hálózatát ábrázolja: négy család, öt generáció, összesen 409 személy adata és viszonyrendszere. A Családfakutatás fejezet szempontjából ez mintapélda arra, hogyan néz ki egy forrásokra visszavezetett, publikált családfa – szemben a kereskedelmi szolgáltatások felhasználói fáival.
Térképes nézet. Az Írói levélváltások térben és időben több levelezést együtt vizsgál: a helyszínekből kiindulva mutatja a személyek és levelek hálózatát. Ez a Térbeli adatbázisok fejezet logikáját követi – az adat egy helyhez tartozik.
Szövegstatisztika. Szófelhők (Móricz-levelezés, Kiss József) és stilometriai elemzések (a Móricz-regénykorpusz és a levelezés stílusvizsgálata, konszenzusháló-ábrákkal). Ezek a szöveg mint adat megközelítés – a távoli olvasás – működő magyar példái.
Emellett ismeretterjesztő tartalmak is vannak (virtuális szabadulószoba, Móricz-séta, keresztrejtvény, adventi kalendárium), valamint egy önálló sajtóelemzési projekt az orosz–ukrán háború magyar online sajtóbeli szóhasználatáról.
Figyelem A vizualizáció nem forrás – hivatkozni a kiadásra kell.
Egy kapcsolati háló vagy egy szófelhő a kiadás adatainak feldolgozása: az látszik rajta, amit a kiadás entitástára tartalmaz, és úgy, ahogy a készítők kiválogatták. Ha egy ilyen ábrából von le következtetést, mindig írja meg, melyik korpuszon készült (a Széchényi-háló például „a projekt első szakaszában”, a nemzeti könyvtárban őrzött levelezésből), és hivatkozzon a mögötte álló kiadásra is – nem csak a képre.
6.3 Miért jött létre a dHUpla?
- Hogy hozzáférhetővé tegye a történeti forrásokat: a digitalizált anyagokat nemcsak megtekinthetővé, hanem kereshetővé és elemezhetővé teszi.
- Hogy támogassa a digitális bölcsészeti kutatásokat: a platformon található források a digitális filológia és történettudomány új eszközeit alkalmazzák.
- Hogy ösztönözze a közösségi alapú tudományos munkát: a dokumentumok feldolgozásában különböző kutatócsoportok is részt vehetnek.
6.4 Fő funkciók
Források digitalizálása és publikálása. A dHUpla lehetővé teszi a történeti dokumentumok digitalizálását, metaadatokkal való ellátását és online közzétételét. A publikált források szöveges átiratai kereshetők és annotálhatók. Példa: a Móricz Zsigmond levelezése projekt keretében a levelek digitalizálása és TEI-alapú feldolgozása.
Metaadatkezelés és annotálás. A platform támogatja a TEI szabványt, amely biztosítja a szövegek strukturált kezelését. A metaadatok között szerepel a szerző, a cím, a dátum, a témakör és a nyelv. Az annotációs lehetőség segíti a tudományos feldolgozást: kritikai jegyzetek, szövegvariánsok összehasonlítása, történeti magyarázatok.
Kereshetőség és interaktivitás. A dHUpla lehetővé teszi a kulcsszavas keresést az összes digitalizált forrás között. A keresési eredmények szűrhetők dátum, szerző és témakör szerint.
6.5 Az annotálás típusai
- Szöveges megjegyzés: az adott szövegrészhez kapcsolódó rövid magyarázat.
- Hivatkozás: külső forrásra vagy más dokumentumra mutató link.
- Szövegvariáns megjelölése: azonos szövegrészek különböző változatainak bemutatása.
A platform által publikált dokumentumok forráskritikai ellenőrzésen, metaadat-kiegészítésen és hitelesítési folyamaton esnek át.
6.6 Esetpélda: a Móricz-levelezés
A Móricz Zsigmond levelezése kiadás jól mutatja, mit tud egy digitális forráskiadás a nyomtatotthoz képest.
- Kézirat és átirat egymás mellett. A felület egyszerre jeleníti meg a levél kéziratos változatát és az átírását, az átiratban pedig ott állnak a szövegkritikai megjegyzések is. A használó tehát nem kényszerül arra, hogy elhiggye az átírást: ellenőrizheti.
- A nevek nem csak nevek. A szövegben szereplő személynevek közvetlenül kapcsolódnak az entitástárhoz, azon keresztül pedig a névtéradatbázishoz. Ez teszi lehetővé, hogy a kiadás más gyűjteményekkel is összekapcsolható legyen.
- A kiadás bővíthető. A második kiadás közel száz levéllel bővebb az elsőnél. Nyomtatásban ez új kötetet jelentett volna; itt a kiadás továbbépült, és a korábbi hivatkozások is érvényben maradtak.
- Vizuális böngészés. A felület kreatív tartalmak megjelenítésére is alkalmas: a vizuális nézeteken kapcsolati hálókat vagy családfákat böngészhetünk, vagyis a levelezés nemcsak olvasható, hanem elemezhető is.
Figyelem A bővíthetőség a hivatkozás szempontjából kétélű. Ha egy digitális kiadásra hivatkozik, mindig adja meg a kiadás verzióját (ha van) és a letöltés dátumát – különben az olvasó nem tudja rekonstruálni, melyik állapotot látta.
Mélyebben Egy TEI-annotáló demóeszköz
Annak megértéséhez, mit csinál valójában egy annotáló felület, nem kell platformra regisztrálni. A fejezet szerzőjének demóeszköze egyetlen HTML-fájl, amely telepítés nélkül, a böngészőben megnyitva működik. Három nézete van:
- Dokumentumok – a forrásszövegek kártyás nézetben, az annotációk típusonkénti összesítésével; a Szerkesztés gombbal a meglévő dokumentumok metaadatai módosíthatók.
- Annotálás – az egérrel kijelölt szövegrészhez entitástípus választható (Személy, Intézmény, Mű, Dátum, Hely, Egyéb), majd azonosító és opcionális megjegyzés adható meg. A jobb oldali listában az annotációk utólag szerkeszthetők vagy törölhetők.
- Kapcsolatháló – az annotációkból automatikusan generált hálózatgráf, amelyen a csomópontok az entitásokat jelölik, az élek pedig az együttes előfordulásokat: a tömör él az egy dokumentumon belüli, a szaggatott a több dokumentumban is megjelenő együttállást.
Az eszköz automatikusan ment a böngésző tárába (localStorage), így a munka újratöltés után folytatható, az elkészült annotáció pedig HTML, TEI XML és JSON formátumban exportálható. A TEI XML export mutatja meg a leglátványosabban a lényeget: a kijelölésekből géppel olvasható, szabványos kód lesz.
Gyakorlati feladatok
Feladat 1. feladat – Szerzői jogi státusz megállapítása
Az alábbi öt szerző esetében állapítsa meg, hogy műveik ma közkincsnek számítanak-e, és írja le a számítás menetét (halálozási év + 70 év).
- Egy 1935-ben elhunyt szerző.
- Egy 1958-ban elhunyt szerző.
- Egy 1919-ben elhunyt szerző.
- Egy 1942-ben elhunyt szerző.
- Egy 1990-ben elhunyt szerző.
Ezután válasszon ki egy Önt érdeklő 20. századi magyar szerzőt, nézzen utána a halálozási évének, és állapítsa meg a művei jogi státuszát. Jelölje meg, honnan vette az adatot.
Elvárt formátum: táblázat + két-három mondatos indoklás a saját példához.
Feladat 2. feladat – Metaadatlap készítése
Válasszon ki egy digitalizált dokumentumot valamelyik korábban megismert adatbázisból (Hungaricana, ELP, dHUpla).
Töltse ki hozzá a fejezet 4.1 és 4.2 pontjában szereplő metaadattáblákat, amennyire az elérhető adatokból tudja.
Jelölje meg, mely mezőket nem tudta kitölteni, és írja le, mit jelent ez a forrás kutathatósága szempontjából.
Döntse el, milyen formátumban adná ki ezt a dokumentumot (PDF, XML/TEI, JPEG/PNG vagy ezek kombinációja), és indokolja a döntést.
Elvárt formátum: két kitöltött táblázat + kb. 150 szavas indoklás.
Feladat 3. feladat – Kézirat, gépi átirat, kritikai kiadás: hármas összevetés
Ebben a feladatban ugyanannak a levélnek három állapotát veti össze: az eredeti kéziratot, egy gépi kézírás-felismerő (HTR) átiratát és a dHUplán elérhető kritikai kiadás szövegét. A cél nem az, hogy „megbuktassa” a gépet, hanem hogy pontosan megnevezze, mit tud és mit nem tud egy HTR-eszköz – és mit tesz hozzá mindehhez a szerkesztő. A kézírás-felismerésről a fejezet 3.4 szakaszának Mélyebben doboza szól.
a) A forrás kiválasztása. Nyissa meg a Móricz Zsigmond levelezése (1892–1913) kiadást a dHUplán (https://dhupla.hu/collection/moricz-zsigmond-levelezes), és válasszon ki egy olyan levelet, amelyhez fakszimile, vagyis a kézirat képe is tartozik. Példa: Móricz Zsigmond levele Osvát Ernőhöz, kelt 1908. november 10-én (https://dhupla.hu/text/o:mzs-lev.tei.910). Mentse el a kézirat képét a lehető legnagyobb méretben, és jegyezze föl a levél azonosítóját, keltezését, valamint a kiadás verziószámát – ez utóbbi a hivatkozáshoz kell.
b) Gépi átirat készítése. Regisztráljon a Transkribusra (https://www.transkribus.org/). Az ingyenes csomag havi 50 kreditet ad, és egy oldal felismerése 1 kreditbe kerül, tehát a feladathoz bőven elég; bankkártya nem szükséges hozzá. Hozzon létre egy kollekciót, töltse fel a képet, válasszon a nyilvános modellek közül a magyar nyelvű kézíráshoz illőt, futtassa le a felismerést, majd mentse ki az átiratot.
c) Hármas összevetés. Készítsen az alábbi minta szerint táblázatot, és gyűjtsön össze legalább tíz olyan helyet, ahol a három változat eltér egymástól (az utolsó oszlopot a d) pont alapján töltse ki):
| Hely (sor) | Amit Ön kiolvas a képről | A Transkribus átirata | A kritikai kiadás szövege | Eltérés típusa |
|---|---|---|---|---|
| … | … | … | … | … |
d) Az eltérések osztályozása. Sorolja be a talált eltéréseket az alábbi típusokba, és adja meg, melyikből hányat talált: betűtévesztés; szóhatár-hiba (egybeírás vagy szétírás); központozás; rövidítés feloldása; áthúzás, beszúrás vagy lapszéli bejegyzés kezelése; olvashatatlan vagy kihagyott szövegrész; a sorok és a szövegblokkok sorrendje.
e) Mit tesz hozzá a szerkesztő? Nevezzen meg legalább három olyan információt, amely a kritikai kiadásban ott van, de sem a képen, sem a gépi átiratban nem szerepel (például tárgyi jegyzet, a szövegben említett személyek azonosítása, a keltezés feloldása, szövegkritikai megjegyzés).
f) Következtetés. Kb. 200 szóban válaszoljon: milyen munkafázisban éri meg HTR-eszközt használni egy forráskiadási projektben, és milyen munkát nem vált ki? Támaszkodjon a d) pontban kapott saját számadataira.
Csoportos változat: három-négy fős csoportokban mindenki más levelet dolgozzon fel, majd a d) pont statisztikáit összesítsék. A nagyobb mintán látszik igazán, hogy a hibatípusok nem egyenletesen oszlanak el – és hogy melyiken segítene a modell betanítása, melyiken nem.
Elvárt formátum: kitöltött táblázat + a hibatípusok összesítése + kb. 200 szavas következtetés. Mellékelje a mentett kéziratképet és a Transkribusból exportált átiratot is.
Figyelem Móricz Zsigmond művei 2012 óta közkincsek, a kritikai kiadás jegyzetanyaga és a fakszimilék azonban nem: ezek a kiadást gondozó műhelyt, illetve az őrzőintézményt illetik. A feladat során keletkező fájlokat ezért kizárólag saját tanulmányi célra használja, ne tegye közzé őket. A Transkribusra feltöltött kép az Ön saját, zárt kollekciójába kerül – a feladat végeztével törölje.
Önellenőrző kérdések
1. Mi a különbség a fakszimile és a teljes szövegű kiadás között?
Válasz megjelenítése
A fakszimile az eredeti dokumentum képi megjelenítése: megőrzi a külalakot, de kereshetősége korlátozott. A teljes szövegű kiadás a szöveg átírt, kereshető és szerkeszthető változata, amelyben viszont az eredeti formátum elveszik, és átírási hibák is előfordulhatnak.
2. Meddig tart Magyarországon a szerzői jogi védelem?
Válasz megjelenítése
Általában a szerző halálától számított 70 évig. A védelem időtartama nem a keletkezés dátumától, hanem a szerző halálának időpontjától függ; utána a mű közkinccsé válik.
3. Mi a különbség a deskriptív és a technikai metaadat között?
Válasz megjelenítése
A deskriptív metaadat a dokumentum tartalmát és kontextusát írja le (szerző, cím, dátum, helyszín, témakör, nyelv). A technikai metaadat a digitális objektum jellemzőit (fájlformátum, méret, forrás eredete, digitalizálás dátuma, jogállás).
4. Mire való a TEI?
Válasz megjelenítése
Nemzetközi, XML-alapú szabvány történeti és irodalmi szövegek digitális kiadásához: címkékkel jelöli a szöveg szerkezetét és elemeit, így a szöveg strukturáltan kezelhető, kereshető és más rendszerekkel átjárható.
5. Miért fontos elolvasni egy forráskiadás bevezető tanulmányát?
Válasz megjelenítése
Mert a forráskiadás maga is válogatás: a bevezető ismerteti, mely dokumentumok kerültek be és milyen elvek alapján, továbbá milyen átírási és jegyzetelési szabályokat követtek. Enélkül nem tudjuk értékelni, mit reprezentál az anyag.
6. Miben más a HTR, mint az OCR, és miért nem helyettesíti a szerkesztői munkát?
Válasz megjelenítése
Az OCR nyomtatott betűkre készült, a HTR kézírásra; utóbbihoz az algoritmust az adott íráskép mintáin be kell tanítani, ezért teljesítménye erősen függ a rendelkezésre álló tanítóanyagtól (magyar nyelven ez ma kevesebb, mint angolul vagy németül). A HTR a szöveg betűsorát adja vissza, a kritikai kiadás viszont ennél többet tartalmaz: a rövidítések feloldását, az áthúzások és beszúrások jelölését, a keltezés és a személyek azonosítását, valamint a tárgyi jegyzeteket. Ezeket nem felismerés, hanem szerkesztői döntés hozza létre.
Összefoglalás
Ebben a fejezetben megismerte a digitális forráskiadás fogalmát és négy fő típusát, végigkövette a munkafolyamatot a célkitűzéstől a jogi helyzet tisztázásán át a metaadatolásig és a formátumválasztásig, végül megismerte a magyar dHUpla platformot.
Mit nyer a kutatás a digitális forráskiadással? Mindenekelőtt azt, hogy gyakorlatilag megszűnnek a terjedelmi korlátok: nem a nyomdaköltség dönti el, hány levél kerül be a kiadásba, és a kiadás utólag is bővíthető. Szabványos adatstruktúrát és megfelelő keretrendszert használva az így készült forráskiadások csatlakozhatnak az egységes névtéradatbázisokhoz, vagyis összekapcsolhatók más gyűjteményekkel. Végül a strukturált szöveg új kérdésfeltevéseket enged meg: szövegbányászati elemzést, szerzőazonosítást, kapcsolati hálózatok vizualizálását.
Mi a nehézsége? Legalábbis kezdetben magas a bekerülési költség: kell hozzá megfelelően képzett munkatárs, stabil tárolási környezet és hosszú távon fenntartott infrastruktúra. A digitális kiadás ráadásul nem reprodukálható teljes egészében nyomtatásban – ami előny a használatban, az kötöttség a megőrzésben: ha a platform megszűnik, a kiadás is elérhetetlenné válik. Ezért tartozik a digitális forráskiadáshoz elválaszthatatlanul a megőrzés kérdése is (lásd az Adatpublikálás és megőrzés fejezetet).
A legfontosabb tanulság a használó szempontjából: minden digitális forráskiadás mögött szerkesztői döntések sora áll – mit válogattak be, hogyan írták át, milyen jegyzeteket fűztek hozzá, milyen metaadatokat rögzítettek. Ezek a döntések meghatározzák, mit tud kikeresni belőle, és mit nem. Egy forráskiadás használata ezért mindig két forráskritikát igényel: egyet az eredeti forrásra, egyet a kiadásra.
Kulcsfogalmak
digitális forráskiadás – Történeti dokumentumok tudományos igényű, kritikai jegyzetekkel és metaadatokkal ellátott, kereshető digitális közzététele.
digitalizált kiadás vs. digitális kiadás – A digitalizált kiadás egy nyomtatott kiadvány elektronikus másolata; a digitális kiadás a digitális közeg logikája szerint készül, és nem reprodukálható maradéktalanul nyomtatásban.
entitástár – A kiadásban azonosított személyek, helyek, intézmények és művek nyilvántartása, amelyhez a szövegben szereplő említések hozzákapcsolódnak.
HTR (handwritten text recognition) – Kézírás-felismerés: a kézzel írt szövegek gépi olvasására szolgáló, betanítást igénylő eljárás (pl. Transkribus).
névtéradatbázis – Szabványosított névazonosítókat tartalmazó adatbázis, amely lehetővé teszi, hogy különböző gyűjtemények ugyanarra a személyre ugyanazzal az azonosítóval hivatkozzanak.
regeszta – A forrás tartalmi kivonata, amely a teljes szöveg közlése helyett a lényegi információt rögzíti.
Dublin Core – Egyszerű, széles körben elfogadott metaadat-szabvány alapadatok tárolására.
fakszimile kiadás – Az eredeti dokumentum képi megjelenítése digitalizált formában, az eredeti külalak megőrzésével.
kritikai kiadás – A szöveg átírása jegyzetekkel, kritikai megjegyzésekkel és a szövegváltozatok bemutatásával.
közkincs (public domain) – Olyan mű, amelynek szerzői jogi védelmi ideje lejárt (Magyarországon a szerző halálától számított 70 év után), és így szabadon felhasználható.
metaadat – A digitális dokumentumot leíró, rendszerező és kontextusba helyező információ; lehet deskriptív vagy technikai.
TEI (Text Encoding Initiative) – Nemzetközi, XML-alapú kódolási szabvány történeti és irodalmi szövegek digitális kiadásához.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Ring Orsolya: Történeti források kiadása a digitális világban – lehetőségek és gyakorlat. Magyar Tudomány 186. (2025) 10. sz. 2039–2050. https://www.akjournals.com/view/journals/2065/186/10/article-p2039.xml (a fejezet 2., 3.4. és 6. szakaszának, valamint az Összefoglalásnak a forrása)
Ajánlott irodalom
- Kenyeres István (szerk.): A történeti források kiadásának módszertani kérdései. FONS 7. (2000) 1. sz.
- Kóta Péter: Digitális forráskiadás. Gondolatok alapvető kérdésekről. Turul 88. (2015) 4. sz. 130–143.
- Maróthy Szilvia: A tudományos elektronikus szövegkiadások feldolgozása. In: Kiszl Péter – Csík Tibor (szerk.): Valóságos könyvtár – könyvtári valóság. Budapest, ELTE BTK, 2018. 351–356. https://doi.org/10.21862/vkkv2018.351
- Nagy Sándor: Adatbázisépítés és forráskiadás. Levéltári Közlemények 78. (2007) 1. sz. 173–176.
- Reisz T. Csaba: Történelem egy kattintásra? Századok 152. (2018) 685–694.
- Ress Imre: Digitális forráskiadás vagy elektronikus mutatózás? Levéltári Közlemények 77. (2006) 1. sz. 13–31.
- Sahle, Patrick: What Is a Scholarly Digital Edition? In: Driscoll, Matthew James – Pierazzo, Elena (szerk.): Digital Scholarly Editing. Theories and Practices. Cambridge, Open Book Publishers, 2016. 19–39.
- Sipos András: A digitalizálás mint a levéltári forráskiadás új útja? In: Korompay Klára et al. (szerk.): Forráskutatás, forráskiadás, tudománytörténet, II. Budapest, Magyar Nyelvtudományi Társaság, 2014. 64–72.
- A Magyar Történelmi Társulat forráskiadási szabályzata. Századok 1919–1920. Melléklet, 1–24.
Linkek és eszközök
- dHUpla – Digitális Bölcsészeti Platform – https://dhupla.hu/ – elérve: 2026. 08. 20.
- TEI Consortium – https://tei-c.org/ – elérve: 2026. 08. 20.
- DigiPhil – https://digiphil.hu/ – elérve: 2026. 08. 20.
- Szellemi Tulajdon Nemzeti Hivatala – https://www.sztnh.gov.hu/ – elérve: 2026. 08. 20.
- Transkribus (kézírásfelismerés) – https://www.transkribus.org/ – elérve: 2026. 08. 20.
- Móricz Zsigmond levelezése (dHUpla) – https://dhupla.hu/collection/moricz-zsigmond-levelezes – elérve: 2026. 08. 20.
- ArchívNET – XX. századi történeti források – https://www.archivnet.hu/ – elérve: 2026. 08. 20.
- TEI P5 példadokumentum – https://tei-c.org/release/doc/tei-p5-doc/en/html/examples-TEI.html – elérve: 2026. 08. 20.
Adat a történettudományban
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 90 perc |
| Előfeltétel | Mi a forrás?, Digitális bölcsészet |
| Verzió / dátum | v0.1 / 2026. augusztus |
Miről szól ez a fejezet?
A könyv eddigi fejezetei forrásokról szóltak: hogyan találjuk meg és hogyan értékeljük őket. Ez a fejezet egy lépéssel tovább megy, és azt kérdezi: mi történik akkor, amikor a forrásból adat lesz. Tisztázzuk a forrás és az adat különbségét, megnézzük, miért nem semleges egyetlen adatgyűjtés sem, és áttekintjük azt a három adattípust, amellyel a történész dolgozik. Ez a fejezet adja a fogalmi keretet a következő, konkrét adatbázisokat bemutató fejezetekhez.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- megkülönbözteti a forrás és az adat fogalmát, és példán bemutatja, hogy ugyanabból a forrásból más kutatási kérdés más adatot állít elő;
- saját szavaival elmagyarázza a capta fogalmát, és megindokolja, miért pontosabb a bölcsészettudományokban, mint a data;
- egy megadott történeti forráson (pl. népszámlálás) azonosít legalább három olyan döntést, amely az adatot konstruálttá teszi;
- megkülönbözteti a három adattípust (forrásban lévő adat, adatbázisba rendezhető adat, szöveg mint adat), és mindegyikhez példát hoz;
- felsorolja az adat-életciklus öt fázisát, és mindegyikhez megfogalmaz egy kritikai kérdést.
Bevezetés
Napjainkra hatalmas mennyiségű történeti forrásanyag vált elérhetővé és kereshetővé különböző digitális gyűjteményekben – az Arcanum Digitális Tudománytárban, a Hungaricanán vagy az AdatbázisokOnline felületén.
A digitalizált szövegek és a hozzájuk rendelt metaadatok elemzése nagyban megkönnyíti a forrásokhoz való hozzáférést, de egyben új kihívásokat is támaszt. Lehetőséget ad ugyanis a big data, illetve big text jellegű megközelítés történettudományi kiterjesztésére – ehhez azonban a források újfajta megközelítése, feldolgozásukhoz pedig újfajta módszertan szükséges.
A digitális módszerek alkalmazása alapvető kérdéseket vet fel arról, hogyan viszonyulunk forrásainkhoz, milyen interpretációs döntéseket hozunk már az adatgyűjtés kezdeti fázisában, és milyen etikai következményekkel járnak ezek a döntések. A fejezet három kérdéskör mentén halad:
- Mi a különbség az adat és a forrás között, és miért fontos ez a megkülönböztetés?
- Milyen típusú adatokkal dolgozik a digitális történész, és milyen módszertani kihívásokat vetnek fel ezek?
- Hogyan kell kritikusan viszonyulni a saját adatainkhoz?
1. Forrás és adat: egy alapvető megkülönböztetés
1.1 Fogalmi különbségtétel
A hétköznapi nyelvhasználatban az „adat” és a „forrás” gyakran felcserélhető fogalmak. A digitális módszertanban azonban kritikus különbséget kell tennünk közöttük, mert ez alapvetően meghatározza a kutatásunk jellegét és értelmezési kereteit.
Definíció Fogalom: forrás (source)
A történeti dokumentum maga – levél, irat, újságcikk, fénykép –, amely információt hordoz a múltról. (Részletesen lásd a Mi a forrás? fejezetet.)
Definíció Fogalom: adat (data)
Strukturált információ, amelyet mi nyerünk ki a forrásból a kutatási kérdéseink és elméleti kereteink alapján. Az adat mindig interpretáció eredménye: kategorizálás és értékelés terméke.
A különbség nem pusztán fogalmi játék. Minden adat-előállítási folyamat döntések sorozatát jelenti: mit számítunk relevánsnak, milyen kategóriákat használunk, mit hagyunk figyelmen kívül, és kinek az érdekét szolgálja az adatgyűjtés módja.
Figyelje meg a párhuzamot: a Mi a forrás? fejezetben azt láttuk, hogy egy dokumentum akkor válik forrássá, amikor egy konkrét kérdéssel közeledünk hozzá. Ugyanez igaz az adatra is – csak itt a kérdés nemcsak kiválasztja, hanem egyenesen létrehozza azt, amivel dolgozunk.
1.2 Capta, nem data
Johanna Drucker azt javasolja, hogy a data helyett használjuk a capta kifejezést a bölcsészettudományokban.44 A különbségtétel nem csupán terminológiai precizitás kérdése, hanem ismeretelméleti állásfoglalás.
A data szó latinul azt jelenti: „adott”. Az etimológia azt sugallja, hogy az információ „ott van” a világban, passzívan várva a felfedezésre. Ez a felfogás
- elrejti az aktív interpretációs munkát,
- semlegességet és objektivitást sugall,
- természetessé teszi a kutató döntéseit,
- láthatatlanná teszi a hatalmi viszonyokat.
A capta ezzel szemben azt jelenti: „vett, választott”. A kifejezés kifejezetten elismeri, hogy
- az adatot mi konstruáljuk, nem „adja magát”,
- minden adat aktív válogatás eredménye,
- a kutatói döntéseknek politikai és etikai következményeik vannak,
- a kategóriák nem semlegesek, hanem értékeket tükröznek.
Definíció Fogalom: capta
Johanna Drucker fogalma: a bölcsészettudományi „adat” pontosabb megnevezése. Arra emlékeztet, hogy az adat soha nem „nyers”, hanem mindig már interpretációs kereteken keresztül feldolgozott – minden adatgyűjtési aktus egyben interpretációs aktus is.
Esettanulmány A népszámlálás mint konstruált adat
Vegyük az 1880-as magyarországi népszámlálást. Első látásra objektív statisztikai adat: számok, nevek, foglalkozások, háztartások. Közelebbről nézve azonban interpretációs döntések rendszere.
Ki számít „lakosnak”? Bejelentett lakóhellyel rendelkezők: igen. Vándorló életmódú közösségek: nem. Hajléktalanok: nem. Ideiglenesen tartózkodók: nem. Katonák, foglyok: kérdéses.
Milyen kategóriákat használtak?
- Nem: férfi / nő.
- Foglalkozás: előre definiált lista. De mi van a nem hivatalos munkákkal? A női háztartási munkával?
- Nemzetiség: „anyanyelv” alapján. De mi van a kétnyelvűekkel? A vegyes családokkal?
- Családi állapot: nős, hajadon, özvegy. De mi van az együttélő párokkal?
Mit számoltak? Életkort, foglalkozást, vallást, műveltséget.
Mit nem számoltak? Jövedelmet, vagyont, egészségi állapotot, társadalmi kapcsolatokat.
Ki gyűjtötte és miért? Az állami adminisztráció. Céljai: katonai toborzás, adóztatás, nemzetiségi politika. Az érintett közösségek nem vettek részt a kategóriák kialakításában.
A népszámlálás tehát nem „adja magát”, hanem egy adott politikai, közigazgatási és tudományos logika szerint konstruált adathalmaz. Amikor használjuk, reflektálnunk kell ezekre a döntésekre és hosszú távú hatásaikra.
Miért fontos ez Önnek? Mert ha egy dolgozatban azt írja, hogy „1880-ban X ember élt Y foglalkozásból”, valójában azt írja: „az akkori állam kategóriái és felvételi szabályai szerint X embert soroltak Y-ba”. A kettő nem ugyanaz – és a különbséget a dolgozatban jelölni kell.
2. Az adat-életciklus
Drucker öt tevékenységet azonosít, amelyek átívelnek a teljes digitális kutatási folyamaton. Mindegyikhez tartozik egy kritikai kérdés, amelyet fel kell tennünk.
| Fázis | Mit jelent? | A kritikai kérdés |
|---|---|---|
| 1. Közvetítés | Analóg anyagok digitális formában elérhetővé tétele, vagy digitálisan született anyagok létrehozása | Mit veszítünk a digitalizálás során? Ki dönt a prioritásokról? |
| 2. Adatformálás / modellezés | Értékek kivonása egy jelenségből; a komplex anyag redukciója számítási formátumra | Milyen kategóriákat használunk, és honnan származnak? Mit hagyunk ki? |
| 3. Feldolgozás / elemzés | Automatizált számolás, rendezés, elemzés | Milyen kulturális feltevéseket tartalmaznak az algoritmusok? |
| 4. Bemutatás | Vizualizáció, térkép, diagram, cikk, kiállítás | Milyen narratívát közvetít? Mit mutat és mit rejt el? |
| 5. Fenntarthatóság | Hosszú távú megőrzés és archiválás | Ki őrzi meg az adatot? Kinek az érdeke a megőrzés? |
Figyelem A feldolgozás a „fekete doboz”
Drucker figyelmeztetése szerint a feldolgozás gyakran a digitális bölcsész munkájának fekete doboza, mert nagy részét készen kapott eszközökkel végezzük, amelyek működése láthatatlan vagy érthetetlen a felhasználó számára.
Ebből három tanulság következik:
- Az algoritmusok nem objektívek. Minden algoritmus tükrözi azokat az értékeket és feltevéseket, amelyeket beleépítettek.
- Az automatizálás nem semleges. A hatékonyság gyakran elfedi a döntéseket és a torzításokat.
- A számítás nem helyettesíti az interpretációt.
Ez ugyanaz az elv, amit a Digitális bölcsészet fejezetben eszközkritikának neveztünk – itt csak az adat oldaláról nézzük.
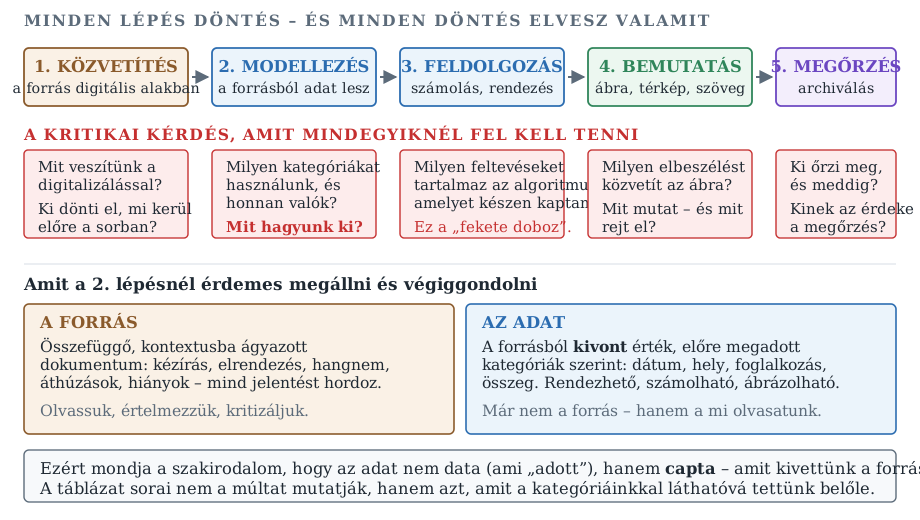
3. Három adattípus a történészi kutatásban
A történész háromféle adattal találkozik. Nem minden kutatás tartalmazza mindhármat, de a megkülönböztetés megértése kritikus a helyes módszertanhoz.
3.1 Forrásban lévő adat
Olyan információ, amely már adatként jött létre a forrás keletkezésekor. Két alfajtája van:
Strukturált adat – táblázatos formában létezik (sorok, oszlopok), számszerű vagy kategoriális értékeket tartalmaz, közvetlenül beilleszthető adatbázisba. Például: népszámlálási táblák, költségvetések, statisztikai kimutatások.
Strukturálatlan adat – szöveg, kép vagy hang formájában; nincs előre definiált struktúrája, „adatszerűvé” kell alakítani. Például: levelezés, feljegyzések, sajtóanyagok.
Példa Tipikus forrásban lévő adatok
Népszámlálások és népességi statisztikák; gazdasági statisztikák (árak, bérek, termelési adatok); költségvetések, számadások, könyvelési iratok; választási eredmények; halálozási és születési nyilvántartások; iskolai beiratkozási adatok; meteorológiai mérések; földmérési adatok.
Mélyebben A kvantitatív történettudomány rövid története
A 20. század elejéig a történetírás tisztán leíró volt, kvantifikáció nélkül, filológiai és szövegkritikai módszertannal.
Az Annales-fordulat (1920–30-as évek) hozta a paradigmaváltást: a történetírás szakított a szorosan vett filológiai módszertannal, és elkezdte kihasználni a mérésben rejlő elemzési lehetőségeket – elsősorban a gazdaság- és társadalomtörténetben, statisztikai adatsorok bevonásával.
Az 1970-es években Magyarországon is megindult a diskurzus. Felismerték, hogy a számítógép használata nemcsak olyan források feldolgozását teszi lehetővé, amelyekre manuálisan nem lenne mód, hanem egyben a forrásokból kinyerhető információk körét is bővíti.
A kvantitatív használatnak három típusa különíthető el: illusztratív használat (hagyományos narratíva, a statisztika illusztráció – ez a leggyakoribb); kliometrikus történetírás (közgazdasági modellek tesztelése történeti anyagon); retrospektív mérlegek (nemzetgazdasági statisztikákra épül, de lényeges szerepet tulajdonít a konkrét történeti eseményeknek is).
3.2 Adatbázisba rendezhető adat
Olyan információ, amelyet mi strukturálunk a forrásokból adatbázissá, a kutatási kérdéseinknek megfelelően. A forrásban nincs táblázatos formában: mi határozzuk meg a mezőket, kategóriákat, relációkat. Az adatmodell maga is interpretáció.
Tipikus formái:
- Prozopográfia – kollektív életrajz: sok személy strukturált adatainak gyűjtése és elemzése. Célja történelmi csoportok, hálózatok vagy társadalmi rétegek megismerése.
- Archontológia – hivatalviselők, tisztségek, adminisztratív pozíciók adatbázisa. Célja intézményi struktúrák és hatalmi viszonyok feltérképezése. (Működő magyar példa: az Állambiztonsági archontológia.)
- Hálózatelemzés – ki kapcsolódik kihez, mikor, milyen típusú kapcsolattal.
Példa Miből lehet adatbázist építeni?
Levelezés → feladó / címzett / dátum / helyszín / téma. Parlamenti képviselők → név / párt / mandátum / szavazatok / felszólalások. Színházi előadások → darab / rendező / színészek / helyszín / dátum / kritikák. Perek → felek / bírók / vádak / ítéletek. Tudományos publikációk → szerző / intézmény / téma / hivatkozások.
Az adatmodell megalkotása döntések sorozata. Amikor eldöntjük, mely mezők kerüljenek az adatbázisba, mi határozzuk meg, mi számít fontosnak:
- Milyen entitásokat veszünk fel? Csak személyeket – vagy intézményeket, eseményeket, helyeket, műveket is?
- Milyen mezőket rögzítünk? Név, születési év, foglalkozás – de miért nem mást?
- Milyen relációkat tartunk számon? Családi? Munkahelyi? Tanár–diák?
- Hogyan kategorizálunk? A foglalkozás előre definiált listából jön vagy szabad szöveg?
Figyelem Minden mezőválasztás egyszerre mutat meg és rejt el valamit.
Ha például az 1950-es évek magyar színésznőiről építünk adatbázist, a „végzettség” mező a képzettséget mutatja – de elrejti az informális tanulást. A „politikai hovatartozás” mező a karrierlehetőségeket magyarázza – de nem különbözteti meg a valós meggyőződést a kényszertől. A „szerepek száma” az aktivitást méri – de nem mondja meg, mekkora szerepekről volt szó.
Az adatmodell sosem semleges: mindig tükrözi a kutató döntéseit, értékeit és korlátait. Ezért kell a dolgozatban dokumentálni, milyen modellel dolgozott.
Az adatbázis-építés gyakorlati lépéseit az Adatbázisépítés saját adatokon fejezet mutatja be.
3.3 Szöveg mint adat
Nagy mennyiségű szöveg számítógépes elemzése – amit Franco Moretti távoli olvasásnak (distant reading) nevezett, szembeállítva a hagyományos „közeli olvasással” (close reading).
Definíció Fogalom: távoli olvasás (distant reading)
Olyan megközelítés, amely nem minden egyes szöveget olvas el egyenként, hanem nagy szövegmennyiségben keres mintázatokat statisztikai módszerekkel és számítógépes algoritmusokkal. Célja olyan kapcsolatok, párhuzamok, ismétlődő minták és ciklusok feltárása, amelyeket a korlátozott szoros olvasás nem képes felszínre hozni.
Miért van erre szükség? Mert a szövegmennyiség emberi léptékkel kezelhetetlen. 2010-ig egyedül a Google 15 millió könyvet digitalizált – a világon valaha megjelent összes könyv körülbelül 12 százalékát. Aki csak a 2000 után megjelent angol nyelvű könyveket akarná elolvasni, percenként 200 szavas tempóval, megszakítás nélkül 80 évig olvasna.
Figyelem A szövegelemző eszközök nem „értik” a szöveget
Matematikai modellek, amelyek statisztikai kapcsolatokat keresnek. Négy kritikus kérdést mindig fel kell tenni:
- Mit „számol” a gép? Szavak gyakoriságát, együttes előfordulását – de mi van az implicit jelentésekkel, a hallgatások jelentőségével?
- Kulturális és nyelvi torzítás. Az algoritmusok jellemzően angol nyelvű korpuszokon tanultak – mennyire működnek magyarul?
- A „fekete doboz” probléma. Hogyan és miért azonosít a gép egy témát?
- Az interpretáció felelőssége. A gép mintázatokat talál – de mi nevezzük el őket, mi értelmezzük, és mi vonjuk le a következtetéseket.
Bár a modellezés során elveszítjük magát a szöveget, az absztrakció új típusú összefüggéseket, folyamatokat és struktúrákat világíthat meg. A digitális forradalom új kutatási eszközöket ad – de ezek eszközök, nem célok.
Esettanulmány
Esettanulmány Egy anyakönyvi bejegyzésből hogyan lesz adat – és mi vész el közben?
Vegyünk egy 1873-as halotti anyakönyvi bejegyzést. Az eredeti irat egy kézzel írt sor, amelyben ez áll: „Kovács János, 43 éves, napszámos, kolerában, aug. 12.”
Ami adattá válik:
| Mező | Érték |
|---|---|
| név | Kovács János |
| életkor | 43 |
| foglalkozás | napszámos |
| halálok | kolera |
| dátum | 1873-08-12 |
Öt mező, öt tiszta érték. Ezer ilyen sorból már járványgörbe rajzolható, korfa készíthető, foglalkozási megoszlás számolható. Ez az adattá alakítás haszna: a sorok összeadhatóvá válnak.
Ami elveszik:
- A kézírás. Ki vezette a könyvet? Milyen ütemben, milyen gondossággal? A romló íráskép egy járvány tetőpontján önmagában is forrás.
- A bizonytalanság. A „43 éves” a bejelentő becslése lehetett. Az adatbázis cellájában viszont ez ugyanolyan biztosnak látszik, mint bármi más.
- A besorolás mögötti döntés. A „kolerában” a korabeli orvosi vagy laikus diagnózis, nem mai értelemben vett halálok. Aki ezt mai kategóriaként kezeli, visszavetíti a jelent a múltba.
- A kontextus. Az eredeti sor mellett és alatt más bejegyzések állnak. Hogy aznap hány halálesetet jegyeztek be, csak az eredeti lapon látszik.
A módszertani tanulság. Az adattá alakítás értelmezés, nem másolás – és minden értelmezés veszteséges. Ez nem érv ellene: e nélkül nem lehetne ezer bejegyzést egyszerre vizsgálni. De azt jelenti, hogy
- az adatbázis mellé dokumentáció kell, amely rögzíti, milyen döntések mentén készült (lásd Adatpublikálás);
- a bizonytalanságot külön mezőben érdemes rögzíteni, nem beleolvasztani az értékbe;
- az eredeti irathoz vissza kell tudni jutni – ezért kell minden rekordhoz a levéltári jelzet.
Ugyanez a probléma nagyban. Az AdatbázisokOnline kézírásfelismeréssel készült adatbázisai pontosan ezt csinálják gépi úton, több millió rekordon – és ott a bizonytalanság már nem emberi becslés, hanem valószínűségi érték.
Reflexiós feladatok
Feladat 1. feladat – Forrásból adat
Válasszon egy konkrét történeti forrást, amelyhez hozzáfér (lehet a Hungaricanáról, az ELP-ről vagy a saját szakdolgozati anyagából).
Írja le egy mondatban, mi a forrás.
Fogalmazzon meg két különböző kutatási kérdést hozzá.
Mindkét kérdéshez adja meg, milyen adatot nyerne ki belőle: milyen mezőket rögzítene egy táblázatban.
Egy bekezdésben mutassa be, miben tér el a két adatkészlet – és mit mond ez a forrás és az adat viszonyáról.
Elvárt formátum: két kis táblázat + egy bekezdésnyi (kb. 150 szavas) elemzés.
Feladat 2. feladat – Capta-elemzés
Keressen egy 19. vagy 20. századi magyar statisztikai kiadványt (népszámlálási kötet, iparstatisztika, iskolai kimutatás) valamelyik digitális gyűjteményben.
Nézze meg a kategóriarendszerét: milyen kategóriákat használ?
Azonosítson három olyan döntést, amely a kategóriák mögött áll (kit sorol hova, kit hagy ki, mit nem mér).
Mindegyikhez írja le egy mondatban, hogy ez a döntés mit tesz láthatóvá és mit rejt el.
Zárja azzal, hogy ha ma Ön gyűjtene adatot ugyanerről a jelenségről, mit csinálna másképp – és miért.
Elvárt formátum: kb. 300 szavas elemzés, a forrás pontos hivatkozásával.
Önellenőrző kérdések
1. Mi a különbség a forrás és az adat között?
Válasz megjelenítése
A forrás maga a történeti dokumentum, amely információt hordoz a múltról. Az adat strukturált információ, amelyet a kutató nyer ki a forrásból a saját kérdései és elméleti kerete alapján – tehát mindig interpretáció, kategorizálás és értékelés eredménye.
2. Miért javasolja Drucker a capta kifejezést a data helyett?
Válasz megjelenítése
Mert a data („adott”) azt sugallja, hogy az információ eleve ott van a világban, és passzívan várja a felfedezést – ezzel elrejti az aktív interpretációs munkát és a kutatói döntések értékterheltségét. A capta („vett, választott”) kifejezetten elismeri, hogy az adatot mi konstruáljuk.
3. Mi a három adattípus, amellyel a történész dolgozik?
Válasz megjelenítése
Forrásban lévő adat (amely már adatként jött létre – strukturált vagy strukturálatlan); adatbázisba rendezhető adat (amelyet mi strukturálunk a forrásból); szöveg mint adat (nagy szövegmennyiség számítógépes elemzése).
4. Mit jelent a távoli olvasás, és mi a korlátja?
Válasz megjelenítése
Nagy szövegmennyiségben keres mintázatokat statisztikai módszerekkel, ahelyett hogy minden szöveget egyenként elolvasnánk. Korlátja, hogy az eszközök nem „értik” a szöveget: csak statisztikai kapcsolatokat találnak, az elnevezés, az értelmezés és a következtetés a kutató felelőssége marad.
5. Miért nem semleges egy adatmodell?
Válasz megjelenítése
Mert minden mezőválasztás egyszerre mutat meg és rejt el valamit: a kutató dönti el, mely entitásokat, mezőket, relációkat és kategóriákat veszi fel. Ezek a döntések a kutatási kérdéseket, előfeltevéseket és korlátokat tükrözik.
Összefoglalás
Ebben a fejezetben elválasztottuk a forrás és az adat fogalmát, és láttuk, hogy az adat soha nem „nyers”: mindig a kutató kérdésén és kategóriáin keresztül jön létre. Ezt fejezi ki Drucker capta fogalma, amelyet az 1880-as népszámlálás példáján konkretizáltunk. Áttekintettük az adat-életciklus öt fázisát és a hozzájuk tartozó kritikai kérdéseket, végül elkülönítettük a három adattípust: a forrásban lévő, az adatbázisba rendezhető és a szövegként kezelt adatot.
A következő fejezetek konkrét adatbázisokat mutatnak be. Amikor ezeket használja, mindig tartsa fejben az itt tanult kérdést: ki, milyen kérdés alapján, milyen kategóriákkal állította elő azt, amit most találatként lát?
Kulcsfogalmak
adat (data) – Strukturált információ, amelyet a kutató a forrásból nyer ki a kutatási kérdései és elméleti keretei alapján; mindig interpretáció eredménye.
archontológia – Hivatalviselők, tisztségek és adminisztratív pozíciók adatbázisa; célja intézményi struktúrák és hatalmi viszonyok feltérképezése.
capta – Drucker fogalma az adat pontosabb megnevezésére: hangsúlyozza, hogy az adatot a kutató konstruálja, nem pedig „adott”.
distant reading (távoli olvasás) – Nagy szövegmennyiségben statisztikai módszerekkel mintázatokat kereső megközelítés, a szoros olvasás ellenpárja.
kliometria – Közgazdasági modellek tesztelése történeti anyagon.
prozopográfia – Kollektív életrajz: sok személy strukturált adatainak gyűjtése és elemzése egy csoport, hálózat vagy társadalmi réteg megismerése céljából.
strukturált adat – Táblázatos formában, előre definiált mezőkkel létező adat.
strukturálatlan adat – Szöveg, kép vagy hang formájában létező, előre definiált struktúra nélküli információ.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Ring Orsolya: Adat a történettudományban. ELTE BTK Történelem Segédtudományai Tanszék, 2026. 2. fejezet. https://ringorsolya.github.io/adat_tortenettudomany/
- Drucker, Johanna: Humanities Approaches to Graphical Display. Digital Humanities Quarterly 5. (2011) 1. sz. (A capta fogalmához.)
Ajánlott irodalom
- Moretti, Franco: Distant Reading. London – New York, Verso, 2013.
Linkek és eszközök
- Arcanum Digitális Tudománytár – https://adt.arcanum.com/hu/ – elérve: 2026. 08. 20.
- Hungaricana – https://hungaricana.hu/ – elérve: 2026. 08. 20.
- AdatbázisokOnline – https://adatbazisokonline.mnl.gov.hu/ – elérve: 2026. 08. 20.
- Ring Orsolya: Adat a történettudományban (online tankönyv) – https://ringorsolya.github.io/adat_tortenettudomany/ – elérve: 2026. 08. 20.
Mi az adatbázis?
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 60 perc |
| Előfeltétel | Adat a történettudományban |
| Verzió / dátum | v0.1 / 2026. augusztus |
Miről szól ez a fejezet?
A IV. rész eddigi fejezetei kész adatbázisokat mutattak be: a Hungaricanát, a Budapest Időgépet, az Állambiztonsági archontológiát. Mindegyiket kívülről néztük: mit lehet bennük keresni, mit nem.
Ez a fejezet a felület mögé néz. Mi az az adatbázis tulajdonképpen? Miért másképp viselkedik, mint egy Word-dokumentum vagy egy táblázat? És miért van az, hogy némelyik adatbázisban tud rákeresni két szempont kombinációjára, másikban nem?
A válasz szinte mindig az adatbázis szerkezetében van. Aki érti a szerkezetet, az meg tudja jósolni, mit fog tudni egy felület – és mit nem érdemes tőle várni.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- saját szavaival meghatározza az adatbázis fogalmát, és megnevezze a definíció három kulcselemét;
- megkülönböztesse a lapos, a hierarchikus, a hálós, a relációs és a NoSQL adatbázist, és mindegyikhez történeti vagy levéltári példát rendeljen;
- felismerje az adatredundanciát egy konkrét táblázatban, és megmagyarázza, miért okoz problémát;
- elmagyarázza az elsődleges és az idegen kulcs szerepét, és azonosítsa az 1:N, az N:M és az 1:1 kapcsolatot;
- megnevezze az adatintegritás tipikus sérüléseit, és megmondja, hogyan előzi meg őket egy adatbázis-kezelő.
Bevezetés
Definíció Fogalom: adatbázis
Strukturáltan tárolt, egymással kapcsolatban lévő adatok összessége, amelyek egy meghatározott célra szervezve, elektronikusan vannak tárolva.
A definícióban három szó hordozza a lényeget.
Strukturáltság. Az adatok nem összevissza, hanem meghatározott szabályok szerint vannak elrendezve: minden adatnak megvan a helye, minden adat típusa előre definiált (szöveg, szám, dátum), a kapcsolatok logikusan szervezettek, a hozzáférés szabályozott és gyors. Egy akadémiai tag adatai nem folyószövegben állnak, hanem strukturált mezőkben: név, születési év, foglalkozás, vallás, osztály, a megválasztás éve.
Tárolás. Az adatok elektronikusan, tartósan őrződnek meg, és bármikor visszakereshetők. Ide tartozik a tartósság (biztonsági mentés), a gyorsaság, a biztonság (jogosultságok, titkosítás) és a konzisztencia.
Kapcsolatok. Az adatok között logikai kapcsolatok vannak: egy személy több tisztséget tölthet be, egy tisztséghez egy megválasztási év tartozik, egy osztályhoz több tag, egy taghoz több publikáció. Ezek a kapcsolatok nem véletlenszerűek: a valós világ struktúráját tükrözik.
Tipp A harmadik pont a legfontosabb a történész számára. Amikor egy adatbázisban keres, valójában valakinek a valóságmodelljében keres. Ha az adatmodell nem tartalmazza azt a kapcsolatot, amire kíváncsi, hiába a jó keresőfelület – a kérdés nem tehető fel.
1. Miért van szükség adatbázisra?
1.1 Nagy adatmennyiség
A könyv mintaadatsora – a Magyar Tudós Társaság alapítói és első nemzedéke, 1825–1850 – ötven személyt tart nyilván tizenkét oszlopban. Ez még kényelmesen elfér egy táblázatkezelőben. Egy kutatás azonban ritkán áll meg itt: ha a 19. századi tagság egészét fel akarja dolgozni, és minden személy mellé fel akarja venni a megválasztásait, tisztségeit, publikációit és levelezőpartnereit, néhány hét alatt több ezer sornál és több tucat oszlopnál tart. Hogyan tartja nyilván, és hogyan keres benne?
| Megoldás | Mi a baj vele? |
|---|---|
| Papíron vezetett cédulák | nehéz keresni, lassú, nem rendezhető |
| Word-dokumentum | nincs rendezés és szűrés, nehézkes keresés |
| Strukturálatlan Excel | áttekinthetetlen, lassú, hibás adatok |
Adatbázisban ugyanez: gyors keresés bármelyik mező szerint, többszempontú rendezés, kombinált feltételek szerinti szűrés, statisztikák és összesítések másodpercek alatt.
1.2 Kapcsolatok
A mintaadatsorban egy személyhez több tisztség is tartozhat: Teleki József egyszerre elnök és rendes tag, Döbrentei Gábor titoknok és rendes tag. Egy osztályhoz viszont több személy tartozik. Ez a kettő együtt már nem fér bele egyetlen táblázatba anélkül, hogy adatot ne ismételnénk.
Egyetlen táblázatban ez így néz ki:
| Teljes név | Születési év | Vallás | MTA szerep | Választás éve |
|---|---|---|---|---|
| Teleki József | 1790 | református | elnök | 1830 |
| Teleki József | 1790 | református | rendes tag | 1830 |
| Döbrentei Gábor | 1785 | ev. | titoknok | 1830 |
| Döbrentei Gábor | 1785 | ev. | rendes tag | 1830 |
Figyelem Ha kiderül, hogy Teleki József születési éve pontosításra szorul, mindkét sorát javítani kell. Ha az egyiket elfelejtjük, az adatbázisban ugyanaz a személy két különböző születési évvel fog szerepelni – és onnantól kezdve nem lehet eldönteni, melyik az igaz. Ötven sornál ez még átlátható; ötszáznál már nem.
Adatbázisban Teleki József adatai egyszer szerepelnek (SZEMÉLYEK tábla), a tisztségei külön táblában (SZEREPEK), az osztályok megint külön táblában (OSZTÁLYOK). A születési év javítása egyetlen helyen elvégezhető. Ugyanezt a felbontást vezeti végig lépésről lépésre a Táblázattól az adatbázisig fejezet.
1.3 Adatintegritás
Definíció Fogalom: adatintegritás
Az az állapot, amelyben az adatok pontosak, konzisztensek és megbízhatóak.
Strukturálatlan adatkezelésben tipikusan a következő hibák fordulnak elő. A példák a könyv mintaadatsorából valók – nem szándékosan rontott adatok, hanem egy valódi, kézzel gyűjtött tábla valódi állapota:
- eltérő írásmód ugyanarra a dologra: a Vallás oszlopban a római katolikus felekezet hat alakban szerepel („római katolikus”, „katolikus”, „r. kat.”, „r.kat.”, „r.k.”, „rk”), az evangélikus kettőben („evangélikus”, „ev.”), a református szintén kettőben („református”, „ref.”);
- hiányzó adat: az MTA osztály oszlopban öt
rekordnál
—áll (az alapítók nem osztályhoz megválasztott tagok voltak); - egy cellába zsúfolt több adat: az MTA szerep oszlopban az „elnök, rendes tag” egyetlen szövegként áll, pedig két tisztség;
- duplikáció: ugyanaz a személyadat több sorban ismétlődik;
- elavult adat: az egyik helyen frissítették, a másikon nem.
Az adatbázis mindegyikre ad választ: típusellenőrzés (a „Születési év” mezőbe csak szám írható), kötelező mezők, kötött értékkészlet (a Vallás mező csak a felsorolt öt-hat felekezet valamelyikét veheti fel, így az „rk” fel sem vihető), referenciális integritás (csak létező osztályra lehet hivatkozni), egyedi kulcs (nem lehet két azonos azonosító), automatikus frissítés.
Mélyebben Miért érdekli ez a történészt, ha nem ő építi az adatbázist?
Mert a fenti hibák a használó oldalán találati hiányként jelentkeznek. Ha a mintaadatsorban a „római katolikus”-ra szűr, a harmincegy katolikus tag közül négyet kap meg – a többi „katolikus”, „r. kat.”, „r.kat.”, „r.k.” vagy „rk” alakban áll. Ha ebből a négyből von le felekezeti következtetést, súlyosan téved. A találati lista hiánya nem mindig forráshiány: néha adatminőségi probléma.
2. Adatbázis-típusok
2.1 Lapos (flat file) adatbázis
A legegyszerűbb forma: egyetlen táblázat, sorokkal és oszlopokkal. Minden sor egy rekord, minden oszlop egy mező. Nincs kapcsolat más táblákkal.
| Teljes név | Születési év | Halálozási év | Foglalkozás | Választás éve |
|---|---|---|---|---|
| Széchenyi István | 1791 | 1860 | politikus | 1825 |
| Teleki József | 1790 | 1855 | történetíró | 1830 |
| Szalay László | 1813 | 1864 | történész | 1836 |
Akkor működik jól, ha kicsi az adatmennyiség, nincs kapcsolat az adatok között, egyszerű listáról vagy ideiglenes adatgyűjtésről van szó.
Ne használjuk, ha kapcsolatok vannak az adatok között, ezernél több rekord van, az adatintegritás kritikus, vagy az adatok gyakran változnak.
Definíció Fogalom: redundancia
Ugyanannak az adatnak a többszöri, felesleges tárolása. Következményei: helypazarlás, nehézkes frissítés (több helyen kell módosítani) és az inkonzisztencia veszélye (egy helyet kihagyunk).
2.2 Hierarchikus adatbázis
Az 1960-as években születtek az első hierarchikus adatbázisok – a NASA Apollo programjában is használtak ilyet; a legismertebb az IBM IMS (1968).
A modell egy fa struktúra: van egy gyökér, minden elemnek egy szülője van (a gyökér kivételével), egy szülőnek több gyereke lehet. A mintaadatsor akadémiai osztálybeosztása maga is ilyen: az Akadémia alatt osztályok állnak, az osztályok alatt tagok.
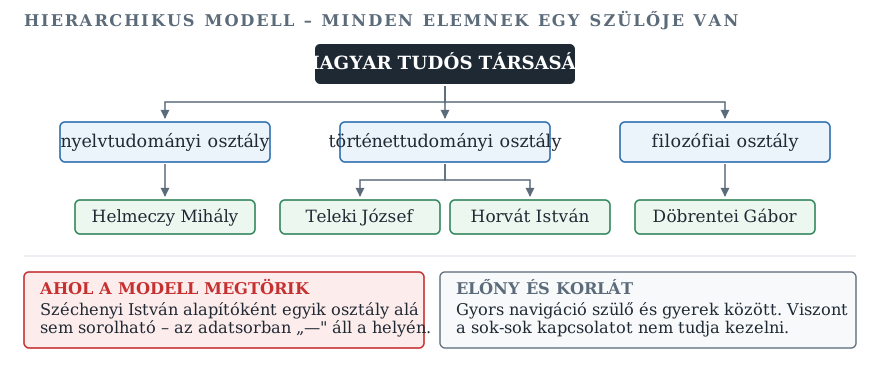
Előnyei: természetes modellezés (sok dolog eleve hierarchikus: szervezet, földrajz, tudományos osztálybeosztás), gyors navigáció szülő és gyerek között, beépített adatintegritás (a gyerek mindig tartozik valahova), hatékony tárolás.
Korlátai: merev struktúra (új szint beszúrása nehéz), a sok-sok kapcsolatot csak duplikálással tudja kezelni, a lekérdezéshez pontosan le kell írni a navigáció útját, és nincs egységes szabvány.
Figyelem A történeti valóság
ritkán fér bele egy fába. A mintaadatsor ötven rekordjából
ötnél — áll az MTA osztály helyén: az alapítók
(Széchenyi István, Vay Ábrahám, Andrássy György, Károlyi György) nem
osztályhoz megválasztott tagok voltak. Egy szigorú hierarchikus
modellben ezeket vagy kihagynánk, vagy kitalálnánk nekik egy osztályt –
mindkettő adatvesztés vagy adathamisítás. A relációs modell (2.4) épp
ezért engedi meg, hogy egy kapcsolat hiányozzék.
Tipp A hierarchikus modell nem halt ki: XML-adatbázisok formájában él tovább. Ilyen a TEI-kódolt történeti szöveg és az EAD (Encoded Archival Description) levéltári leírás is. Ha valaha EAD-fájllal találkozik, egy hierarchikus adatmodellt lát.
2.3 Hálós (network) adatbázis
A hierarchikus modell nem tudja kezelni a sok-sok kapcsolatot: egy színész több előadásban játszik, egy előadásban több színész játszik. Erre válaszolt a CODASYL bizottság 1969-ben a hálós modellel, amelyben egy elemnek több szülője is lehet.
A modell azonban túl bonyolultnak bizonyult: nehéz megtervezni és megérteni, egyszerű lekérdezéshez is sok programkód kellett, és nem volt szabványa. Az SQL egyszerűbben tudta ugyanazt.
Modern megfelelője a gráfadatbázis (Neo4j, Amazon Neptune): csomópontok az entitások, élek a kapcsolatok. Történeti alkalmazása a prozopográfia – például a 19. századi értelmiség kapcsolati hálója (vö. Adatbázisépítés saját adatokon haladó fejezetét).
2.4 Relációs adatbázis
1970-ben Edgar F. Codd, az IBM kutatója publikálta a relációs modellt. Ez lett a mai adatbázisok túlnyomó többségének alapja.
Az újdonság: az adatok táblákban (relációkban) állnak, a táblák matematikailag definiált kapcsolatokban vannak egymással, a lekérdezés pedig egy deklaratív nyelven (SQL) történik – vagyis azt írjuk le, mit akarunk, nem azt, hogyan keresse meg a gép.
Definíció Fogalom: elsődleges kulcs és idegen kulcs
Az elsődleges kulcs (primary key, PK) egyedileg azonosít minden rekordot a táblában; nem lehet üres, és nem változik.
Az idegen kulcs (foreign key, FK) egy másik tábla elsődleges kulcsára hivatkozik – ez hozza létre a két tábla közötti kapcsolatot.
SZEMÉLYEK tábla:
| Szemely_ID (PK) | Név | Születési év |
|---|---|---|
| 1 | Teleki József | 1790 |
| 2 | Döbrentei Gábor | 1785 |
SZEREPEK tábla:
| Szerep_ID (PK) | Szemely_ID (FK) | Szerep | Választás éve |
|---|---|---|---|
| 101 | 1 | elnök | 1830 |
| 102 | 1 | rendes tag | 1830 |
| 103 | 2 | titoknok | 1830 |
A Szemely_ID a SZEREPEK táblában idegen kulcs: a
SZEMÉLYEK tábla elsődleges kulcsára mutat. Így Teleki József adatai
egyszer szerepelnek, a tisztségei mégis hozzá vannak rendelve.
Kapcsolattípusok
| Típus | Jelentése | Példa |
|---|---|---|
| 1:N (egy a többhöz) | egy elemhez több másik tartozik | egy személy → több tisztség; egy osztály → több tag |
| N:M (sok a sokhoz) | mindkét irányban több | egy tag → több folyóirat, amelyben publikált; egy folyóiratban több tag publikált |
| 1:1 (egy az egyhez) | ritka, kölcsönösen egyértelmű | egy tag → egy akadémiai székfoglaló |
Az N:M kapcsolatot a relációs modell kapcsolótáblával oldja meg: a SZEMÉLYEK és a FOLYÓIRATOK közé beiktatunk egy PUBLIKÁCIÓK táblát, amely csak azonosítópárokat tartalmaz.
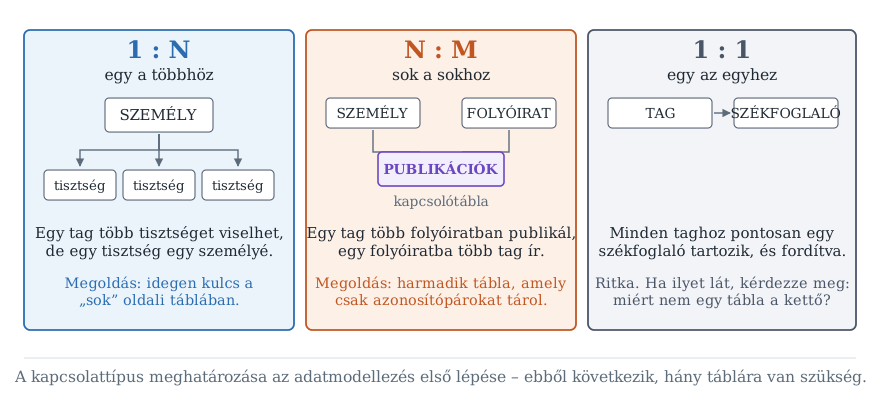
Normalizálás
Definíció Fogalom: normalizálás
Az a folyamat, amellyel az adatbázis szerkezetét úgy alakítjuk, hogy minimalizáljuk a redundanciát és maximalizáljuk az adatintegritást. A normálformák fokozatosan szigorodó szabályrendszerek; a gyakorlatban általában a 3. normálforma (3NF) elegendő.
Az első normálforma (1NF) szabálya az atomicitás: minden mező egyetlen, tovább nem bontható értéket tartalmaz.
Rossz (nem 1NF):
| Szemely_ID | Név | MTA szerep |
|---|---|---|
| 1 | Teleki József | elnök, rendes tag |
| 2 | Helmeczy Mihály | pénztárnok, levelező tag |
Ez pontosan a mintaadatsor MTA szerep oszlopa. Miért rossz? Mert nem lehet szűrni („kik voltak rendes tagok?“), nem lehet szerep szerint rendezni, és nem lehet statisztikát készíteni („hány levelező tagot választottak 1830-ban?”).
A helyes megoldás három tábla: SZEMÉLYEK, SZEREPEK, és egy referenciatábla a szereptípusokra.
A mintaadatsoron végigvezetve ugyanez így néz ki:
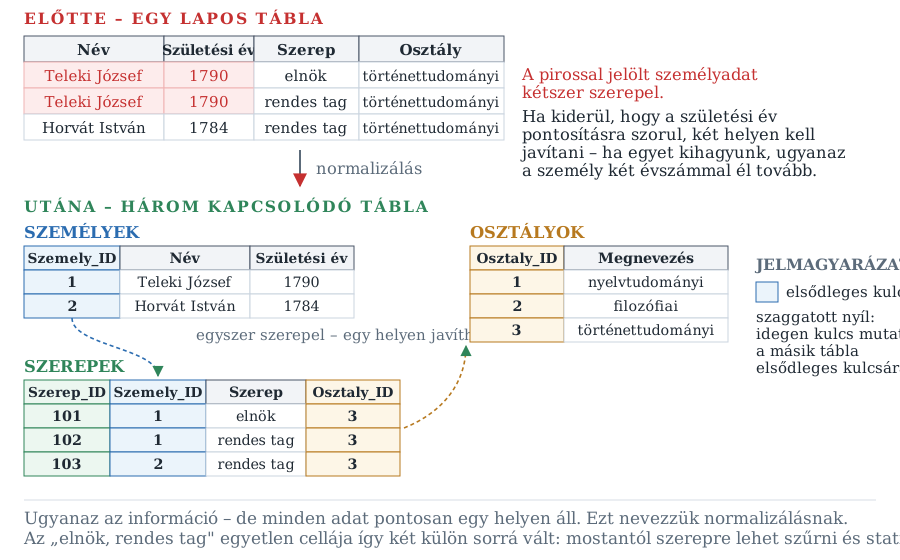
Mélyebben Referenciális integritás
Az a szabály, amely garantálja, hogy egy idegen kulcs mindig létező elsődleges kulcsra hivatkozik. Az adatbázis-kezelő ezt kikényszeríti: nem engedi olyan tisztség rögzítését, amelyhez nem tartozik létező személy, és nem engedi olyan személy törlését, akinek van rögzített tisztsége.
Két opció szokott kapcsolódni hozzá: a CASCADE UPDATE (a szülő kulcsának módosítása automatikusan átvezetődik a gyerekekre) és a CASCADE DELETE (a szülő törlésével törlődnek a gyerekek is). Történeti adatbázisban mindkettőt érdemes kikapcsolva hagyni: az elsődleges kulcsot elvileg sosem kellene megváltoztatni, a lánctörlés pedig egyetlen kattintással adatvesztést okozhat. Törlés helyett a soft delete ajánlott: egy „Aktív” mező értékét állítjuk „Nem”-re, így az adat megmarad, de a szokásos lekérdezésekben nem jelenik meg.
2.5 NoSQL adatbázisok
A 2000-es években olyan feladatok jelentek meg, amelyekre a relációs modell nem adott jó választ: több milliárd weboldal indexelése, milliárdnyi felhasználói profil, folyamatosan változó termékattribútumok. A közös bennük a hatalmas adatmennyiség, a másodpercenkénti százezres írásszám, a változó szerkezet (nem minden rekordnak ugyanazok a mezői) és az igény arra, hogy sok olcsó szerverre lehessen elosztani az adatot.
Definíció Fogalom: NoSQL
Gyűjtőfogalom a nem relációs adatbázis-modellekre. A rövidítés nem azt jelenti, hogy „nincs SQL”, hanem hogy Not Only SQL – nem csak az SQL létezik. Közös jellemzőik: rögzített séma helyett rugalmas szerkezet, vízszintes skálázhatóság és a szigorú konzisztencia helyett „végül konzisztens” (eventual consistency) működés.
A történeti kutatásban a NoSQL ritkán kerül elő közvetlenül; a leggyakoribb eset a born-digital iratok metaadatainak tárolása, ahol iratfajtánként más mezők kellenek.
2.6 Összefoglaló táblázat
| Típus | Mikor ideális? | Fő előnye | Fő hátránya |
|---|---|---|---|
| Lapos | kis lista | egyszerű | redundancia |
| Hierarchikus | fa struktúra (EAD, TEI) | gyors navigáció | merev |
| Hálós | (elavult; ma gráfadatbázis) | sok-sok kapcsolat | bonyolult |
| Relációs | az esetek többsége | SQL, adatintegritás | nehezen skálázható |
| NoSQL | Big Data | skálázható | nincs szigorú konzisztencia |
Tipp Levéltári és történeti nyilvántartási feladatokban az esetek túlnyomó többségében a relációs modell a helyes választás.
Gyakorlás: milyen kapcsolat?
A kapcsolattípus felismerése az adatmodellezés első lépése: ebből derül ki, hány táblára van szükség, és kell-e kapcsolótábla. Tíz eseten próbálhatja ki.
Feladat Milyen kapcsolat?
Döntse el minden párról, hogy 1:N, N:M vagy 1:1 kapcsolat áll-e fenn közöttük, és indokolja egy mondatban. Ahol N:M, ott nevezze meg, mi kerülne a kapcsolótáblába.
| # | A két entitás |
|---|---|
| 1 | levéltár — fond |
| 2 | szerző — könyv |
| 3 | képviselő — parlamenti ciklus |
| 4 | személy — a születési anyakönyvi bejegyzése |
| 5 | tüntetés — résztvevő szervezet |
| 6 | fond — doboz |
| 7 | folyóirat — lapszám |
| 8 | cikk — tárgyszó |
| 9 | település — az 1910-es népszámlálási adatsora |
| 10 | akadémiai tag — viselt tisztség |
Ökölszabály: ha mindkét irányban a „több” a válasz, kapcsolótábla kell.
Esettanulmány
Esettanulmány Miért lehet az archontológiában rangra keresni, a fondjegyzékben nem?
Térjen vissza az Állambiztonsági archontológia fejezethez. Ott azt láttuk, hogy a felület nemcsak névre, hanem beosztásra, szervezeti egységre és időszakra is kereshető, és hogy egy személy pályaíve összeáll a találatokból.
Ez nem a keresőmotor érdeme, hanem az adatmodellé. Az adatbázis mögött nem egy lapos névsor áll, hanem legalább három entitás – személy, szolgálati hely, beosztás –, közöttük pedig egy N:M kapcsolat, amelyet egy kapcsolótábla old fel: ki, hol, milyen beosztásban, mettől meddig. Minden egyes ilyen sor egy önálló rekord.
Egy hagyományos fondjegyzék ezzel szemben lapos tábla: fondonként egy sor. Ezért lehet benne jelzetre és időkörre keresni, de arra nem, hogy „mely fondokat kezelte ugyanaz a munkatárs” – ez az információ nincs modellezve.
A tanulság: a keresési lehetőségek határa az adatmodell határa. Ha egy felületen hiányzik egy keresési szempont, először azt kérdezze meg, hogy az adott összefüggés egyáltalán szerepel-e az adatmodellben.
Gyakorlati feladatok
Feladat 1. feladat – Redundancia felismerése (15 perc)
Az alábbi táblázat egy szeminárium kiselőadásainak nyilvántartása:
| Hallgató | Neptun | Szak | Előadás címe | Dátum | |
|---|---|---|---|---|---|
| Kiss Éva | ABC123 | kiss@… | történelem | Az 1848-as sajtó | 2026-03-04 |
| Kiss Éva | ABC123 | kiss@… | történelem | Kossuth Amerikában | 2026-04-15 |
| Tóth Béla | DEF456 | toth@… | történelem | A dualizmus vasútja | 2026-03-11 |
- Nevezze meg, mely adatok ismétlődnek feleslegesen.
- Bontsa két táblára úgy, hogy megszűnjön a redundancia. Jelölje meg, melyik mező lesz az elsődleges és melyik az idegen kulcs.
- Milyen kapcsolattípus áll fenn a két tábla között?
Feladat 2. feladat – Adatmodell visszafejtése (30 perc)
Válasszon egyet a könyvben tárgyalt adatbázisok közül (Hungaricana, Budapest Időgép, Tüntetések, demonstrációk 1988–1989).
- Nyissa meg a keresőfelületét, és sorolja fel, mely mezők szerint lehet szűrni.
- A szűrési lehetőségekből következtessen: mely entitások léteznek az adatbázisban, és milyen mezőik vannak?
- Talál-e olyan keresési szempontot, amelyet Ön hasznosnak tartana, de a felület nem kínál? Fogalmazza meg, milyen adatmodellbeli hiány állhat mögötte.
Az eredményt fél oldalban foglalja össze.
Feladat 3. feladat – Kapcsolattípusok (10 perc)
(Ez a feladat a Gyakorlás: milyen kapcsolat? szakaszban kattintható formában is elvégezhető.)
Döntse el, milyen kapcsolat áll fenn a felsorolt párok között (1:N, N:M vagy 1:1), és indokolja meg egy mondatban:
- szerző – könyv;
- akadémiai osztály – tag;
- képviselő – parlamenti ciklus;
- személy – anyakönyvi bejegyzés a születéséről;
- tüntetés – résztvevő szervezet.
Önellenőrző kérdések
1. Melyik három elem szerepel az adatbázis definíciójában?
Válasz megjelenítése
A strukturáltság (az adatok meghatározott szabályok szerint, előre definiált típusokkal rendezettek), a tárolás (elektronikus, tartós, visszakereshető) és a kapcsolatok (az adatok logikailag összetartoznak, és a valós világ struktúráját tükrözik).
2. Mi a redundancia, és miért probléma?
Válasz megjelenítése
Ugyanannak az adatnak a többszöri, felesleges tárolása. Három baj származik belőle: helypazarlás, nehézkes frissítés (több helyen kell módosítani), és inkonzisztencia veszélye, ha valamelyik helyet kihagyjuk – ekkor ugyanaz az entitás két különböző adattal fog szerepelni.
3. Mi volt Edgar F. Codd újítása 1970-ben?
Válasz megjelenítése
A relációs modell: az adatok táblákban állnak, a táblák matematikailag definiált kapcsolatban vannak egymással, a lekérdezés pedig deklaratív nyelven (SQL) történik. Ez rugalmasabb és egyszerűbb volt a korábbi hierarchikus és hálós modelleknél, ezért az 1980-as évekre kiszorította őket.
4. Mi a különbség az elsődleges és az idegen kulcs között?
Válasz megjelenítése
Az elsődleges kulcs a saját táblájában azonosít egyedileg minden rekordot (nem lehet üres, nem változik). Az idegen kulcs egy másik tábla elsődleges kulcsára hivatkozik, és ezzel kapcsolatot teremt a két tábla között.
5. Hogyan oldja meg a relációs modell a sok-sok (N:M) kapcsolatot?
Válasz megjelenítése
Kapcsolótáblával: a két tábla közé beiktat egy harmadikat, amely lényegében csak azonosítópárokat tárol. Például az akadémiai tagok és a folyóiratok közé a PUBLIKÁCIÓK táblát.
6. Mit jelent az atomicitás elve, és mi sérti meg leggyakrabban?
Válasz megjelenítése
Azt, hogy minden mező egyetlen, tovább nem bontható értéket tartalmaz. Leggyakrabban a vesszővel elválasztott felsorolás sérti meg egyetlen cellában (pl. „elnök, rendes tag” az MTA szerep mezőben). Ilyenkor nem lehet szűrni, rendezni és statisztikát készíteni.
7. Miért érdemes kikapcsolva hagyni a CASCADE DELETE opciót?
Válasz megjelenítése
Mert egyetlen törléssel láncreakciót indít: a szülő rekorddal együtt törlődik az összes hozzá kapcsolt gyerek rekord is. Nyilvántartásban ez elfogadhatatlan adatvesztési kockázat. Helyette a „soft delete” ajánlott: egy Aktív mezőt állítunk „Nem”-re, így az adat megmarad.
8. Miért fontos a történész számára az adatintegritás kérdése akkor is, ha ő maga nem épít adatbázist?
Válasz megjelenítése
Mert az adatminőségi hibák a használó oldalán találati hiányként jelentkeznek. Ha ugyanaz a személy két írásmóddal szerepel, a névre keresés csak az egyik rekordot hozza – és ezt a kutató könnyen forráshiánynak értelmezi, holott adatminőségi problémáról van szó.
Összefoglalás
Ebben a fejezetben megismerte az adatbázis fogalmát és három alkotóelemét, végigvette az öt fő adatbázis-típust a lapostól a NoSQL-ig, és megértette a relációs modell alapfogalmait: az elsődleges és idegen kulcsot, a kapcsolattípusokat, a normalizálást és a referenciális integritást.
A történész számára a legfontosabb tanulság nem technikai, hanem forráskritikai: az adatmodell határozza meg, milyen kérdés tehető fel. Egy adatbázis nem azért nem válaszol egy kérdésre, mert rossz a keresője, hanem mert az adott összefüggés nem szerepel a modelljében. Aki tudja, hogyan épül fel egy adatbázis, az meg tudja becsülni, mit várhat el egy felülettől – és azt is, mit nem szabad hiánynak olvasnia benne.
Kulcsfogalmak
adatbázis – Strukturáltan tárolt, egymással kapcsolatban lévő adatok összessége, amelyek egy meghatározott célra szervezve, elektronikusan vannak tárolva.
adatintegritás – Az az állapot, amelyben az adatok pontosak, konzisztensek és megbízhatóak; az adatbázis-kezelő típusellenőrzéssel, kötelező mezőkkel, egyedi kulcsokkal és referenciális integritással tartja fenn.
atomicitás – Az az elv, amely szerint minden mező egyetlen, tovább nem bontható értéket tartalmaz; az 1. normálforma követelménye.
elsődleges kulcs (primary key) – A táblán belül minden rekordot egyedileg azonosító mező; nem lehet üres, és nem változik.
gráfadatbázis – Csomópontokból (entitások) és élekből (kapcsolatok) álló adatbázis; a hálós modell mai megfelelője, prozopográfiai kapcsolathálók tárolására alkalmas.
hierarchikus adatbázis – Fa struktúrájú adatmodell, amelyben minden elemnek egy szülője van; ma XML-alapú formában (EAD, TEI) él tovább.
idegen kulcs (foreign key) – Egy másik tábla elsődleges kulcsára hivatkozó mező, amely kapcsolatot teremt a két tábla között.
kapcsolótábla – Két tábla közé iktatott harmadik tábla, amely az N:M kapcsolatot azonosítópárokra bontja.
lapos (flat file) adatbázis – Egyetlen táblából álló adatbázis kapcsolatok nélkül; kis, egyszerű listákhoz alkalmas.
NoSQL – Gyűjtőfogalom a nem relációs adatbázis-modellekre (Not Only SQL); rugalmas szerkezet és vízszintes skálázhatóság jellemzi.
normalizálás – Az adatbázis szerkezetének olyan átalakítása, amely minimalizálja a redundanciát és maximalizálja az adatintegritást.
redundancia – Ugyanannak az adatnak a többszöri, felesleges tárolása; helypazarláshoz, nehézkes frissítéshez és inkonzisztenciához vezet.
referenciális integritás – Az a szabály, amely garantálja, hogy az idegen kulcs mindig létező elsődleges kulcsra hivatkozik.
relációs adatbázis – Edgar F. Codd 1970-es modelljére épülő adatbázis, amelyben az adatok táblákban állnak, a táblák kulcsokkal kapcsolódnak, a lekérdezés pedig SQL-lel történik.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Ring Orsolya: Adatbázisépítés Excelben és Accessben. ELTE
BTK, 2026.
- fejezet („Mi az adatbázis?”) és 2. fejezet („Adatbázis típusok részletesen”). https://ringorsolya.github.io/adatbazis_tankonyv_01/
Ajánlott irodalom
- Codd, Edgar F.: A Relational Model of Data for Large Shared Data Banks. Communications of the ACM 13. (1970) 6. sz. 377–387. https://doi.org/10.1145/362384.362685
Linkek és eszközök
- Adatbázisépítés Excelben és Accessben (a fejezet forrása) – https://ringorsolya.github.io/adatbazis_tankonyv_01/ – elérve: 2026. 08. 20.
- EAD – Encoded Archival Description – https://www.loc.gov/ead/ – elérve: 2026. 08. 20.
Hungaricana Közgyűjteményi Portál
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 90 perc |
| Előfeltétel | Mi a szakirodalom?, Mi a forrás? |
| Verzió / dátum | v0.2 / 2026. augusztus |
Az eszköz alapadatai
| Eszköz neve | Hungaricana Közgyűjteményi Portál |
| URL | https://hungaricana.hu |
| Üzemeltető | Országgyűlési Könyvtár, partnerintézményekkel (ellenőrizendő) |
| Hozzáférés | Ingyenes, nyilvános |
| Regisztráció | Nem kötelező; csak mentett kereséshez és személyes gyűjteményhez szükséges |
| Tartalomtípus | Digitalizált könyv, hírlap, levéltári irat, térkép, fénykép, plakát |
| Időkörök | Kb. 16. század – 20. század közepe (gyűjteményenként eltérő) |
Miről szól ez a fejezet?
Európai megfelelője az Europeana: ami a Hungaricana a magyar közgyűjteményeknek, azt teszi az Europeana több mint kétezer európai intézménynek. A két felület működési elve azonban különbözik, és ez a különbség tanulságos – lásd az Europeana fejezet 1. szakaszát.
A Hungaricana az Arcanum öt felületének egyike – az, amelyik a közgyűjtemények anyagát szolgáltatja. A többiről (könyvek, periodikumok, lexikonok, térképek) az Az Arcanum adatbázisai fejezet szól; ott található az a döntési ábra is, amely megmutatja, melyik dokumentumtípushoz melyik felület való.
Ez a fejezet a Hungaricana Közgyűjteményi Portált mutatja be: egy ingyenes, online, magyar nyelvű forrásgyűjteményt, amely a magyar történész egyik leggyakrabban használt digitális munkaeszköze. Megismeri a portál gyűjteményeit, megtanulja, hogyan futtasson hatékony keresést, hogyan értékelje és hivatkozza a megtalált forrást, és hogy mikor érdemes inkább böngésznie, mintsem kulcsszóra keresnie.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- felismeri a Hungaricana portál főbb gyűjteménytípusait, és tudja, melyik kutatási kérdéshez melyik gyűjteményt érdemes választani;
- önállóan futtat egyszerű, idézőjeles és szűrt kereséseket, és a szűrőket logikus sorrendben szűkíti;
- egy Hungaricana-találatból Korall-stílusú lábjegyzetet és irodalomjegyzéki tételt készít, a perzisztens link megadásával;
- kritikailag értékeli a digitalizált forrás és az eredeti dokumentum közötti különbségeket, és tudja, mikor szükséges az eredetit megtekinteni;
- felismeri az OCR korlátait, és tudja, mikor érdemes böngészéssel keresni.
Bevezetés
Tegyük fel, hogy egy szemináriumi dolgozaton dolgozik az 1872–1873-as európai kolerajárvány magyarországi hatásairól, és különösen érdekli Eger városa. A téma irodalma viszonylag szűk; szeretne saját maga is forrásokat keresni: korabeli újságokat, hatósági jelentéseket, esetleg fényképeket vagy térképeket. Negyven évvel ezelőtt ezért hetekig járta volna a megyei levéltárat és a könyvtárakat. Ma a Hungaricana portálon néhány óra alatt jelentős mennyiségű digitalizált forrás közé jut, amelyek között szövegesen, kulcsszó alapján is kereshet.
Ez a fejezet végigvezeti Önt azon, mi a Hungaricana, milyen gyűjteményekből áll, hogyan érdemes benne keresni, és – ami talán a legfontosabb – hogyan ne tévessze össze a digitalizált találatot magával a forrással. A fejezet végén egy konkrét feladat keretében Ön is futtat majd egy keresést, és a találatot Korall-stílusú lábjegyzettel hivatkozza.
1. Mi a Hungaricana?
A Hungaricana Közgyűjteményi Portál (https://hungaricana.hu) magyar nyelvű, ingyenesen használható tartalomszolgáltatás, amely magyar közgyűjtemények – levéltárak, könyvtárak, múzeumok – digitalizált anyagait teszi egy helyen kereshetővé.45 A portál nem egyetlen homogén adatbázis: több, részben önálló, részben összekapcsolt gyűjtemény összefoglaló neve. Ez a szerkezet egyszerre erőssége és nehézsége: az erősség, hogy egyetlen kereséssel sokféle forrástípust talál; a nehézség, hogy egy találat értelmezéséhez tudnia kell, melyik gyűjteményből származik, és annak milyenek a sajátosságai.
A Hungaricana a 2010-es évek elején indult, és azóta folyamatosan bővül: új lapszámok, új levéltári fondok, új térképsorozatok kerülnek bele rendszeresen. Ez azt is jelenti, hogy egy néhány évvel ezelőtti tankönyvi leírás vagy egy korábbi keresés eredménye nem feltétlenül jeleníti meg a ma elérhető teljes anyagot. Ha tehát egy kutatási kérdéshez korábban nem talált forrást a portálon, érdemes újra próbálkozni.
A portál egyik megkülönböztető vonása, hogy magyar nyelvű, magyar közgyűjteményi anyagokra fókuszál, és a használat semmilyen feltételhez nem kötött: bárki megnyithatja, és bárhonnan elérheti. Ez teszi kifejezetten alkalmassá hallgatói munkára. (Egy másik nagy magyar adatbázis, az Arcanum Digitális Tudománytár ezzel szemben előfizetésalapú, és bár az ELTE hallgatói intézményen keresztül elérik, használata feltételhez kötött.)
A portál fontos jellemzője, hogy a feltöltött dokumentumok többségén optikai karakterfelismerés (OCR) futott, így nemcsak a metaadatban – a dokumentumról szóló adatban (szerző, cím, dátum) –, hanem magában a dokumentum szövegében is lehet kulcsszóra keresni. Ez óriási előny: a hagyományos katalóguskeresés csak addig segít, ameddig tudja, mit keres; a teljes szöveges keresés akkor is tud találatot adni, ha a kulcsszó csak egyetlen lap egyetlen oldalán szerepel. De az OCR egyúttal csapdát is rejt, amit a 3. szakaszban részletesen tárgyalunk.46
Definíció Fogalom: optikai karakterfelismerés (OCR)
Olyan automatikus eljárás, amely egy kép típusú dokumentumból (például egy szkennelt újságoldalból) gépi olvasásra alkalmas szöveget állít elő. A találat minősége a forrás állapotától és a betűtípustól függ; régebbi vagy rossz minőségű forrásoknál hibás karakterek (például „c” helyett „e”) torzíthatják a keresést.
2. A felület felépítése
A Hungaricana kezdőoldala a fő gyűjteményeket csempék formájában jeleníti meg. A felület tetején központi keresőmező található, amely az összes gyűjteményben egyszerre keres; alatta menüsor a tematikus szűkítéshez (Könyvek, Sajtó, Levéltár, Térképek, Képcsarnok és további gyűjtemények). A bejelentkezés (jobb felső sarok) opcionális – anélkül is teljes értékűen lehet keresni és böngészni, csak a mentett kereséseket és a személyes gyűjteményt nem tudja használni.
Az egyes gyűjtemények saját aloldallal és külön keresőfelülettel is rendelkeznek. Általában érdemes először a kezdőoldal központi keresőjével indítani, mert így rögtön látja, melyik gyűjteményben van releváns találat. Ha pedig már tudja, melyik gyűjteményben keres, akkor a gyűjtemény saját oldala finomabb szűrőket kínál (például konkrét folyóiratcím, konkrét levéltári fond).
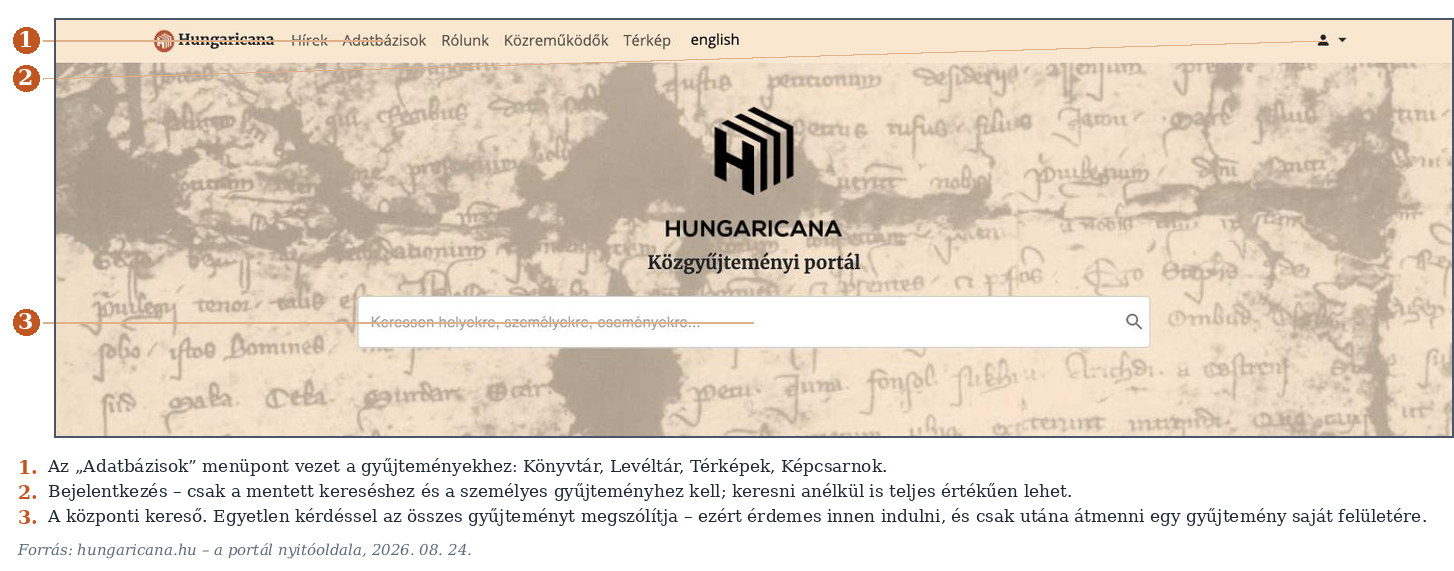
2.1 A főbb gyűjtemények
A Hungaricana legfontosabb gyűjteményei eltérő forrástípust kínálnak, és más kérdésekhez illenek. Egy adott kutatási kérdéshez gyakran többet is érdemes egymás után végignézni.
- Könyvek – monográfiák, évkönyvek, statisztikai kiadványok, levéltári segédletek, törvénytárak. Akkor érdemes itt keresni, ha egy adott témáról összefoglaló munkára vagy korabeli kiadványra van szüksége (például egy 19. századi vármegyei monográfiára).
- Sajtó – a 18. század végétől a 20. század közepéig megjelent magyar újságok, folyóiratok, hetilapok digitalizált lapszámai. A magyar helytörténeti, esemény- és közvélemény-történeti kutatás egyik legfontosabb forrása. Itt keres, ha az érdekli, hogyan írtak egy eseményről a kortársak.
- Levéltári dokumentumok – egyes közgyűjtemények (Magyar Nemzeti Levéltár, megyei levéltárak) digitalizált iratanyagai, jellemzően közgyűlési jegyzőkönyvek, anyakönyvek, kataszteri iratok. Itt különösen figyelni kell az iratok eredeti rendjére: fond, állag, sorozat, tétel.
- Térképek – történeti térképek, várostérképek, az osztrák–magyar kataszteri felmérés lapjai. Akkor különösen hasznos, ha térbeli folyamatokról ír (városszerkezet, birtokstruktúra).
- Képcsarnok / DKA (Digitális Képarchívum) – fényképek, képeslapok, plakátok, metszetek. A vizuális forrásokat itt érdemes keresnie.
- További gyűjtemények – például országgyűlési naplók, közlönyök. Ezeket általában akkor keresi meg, ha a központi kereső ide irányítja.
Tipp Gyűjteményválasztási stratégia
Ha nem tudja, hol kezdje, először mindig a kezdőoldal központi keresőjébe írja be a kulcsszót – a találatok gyűjteményenként vannak csoportosítva, így rögtön látja, melyikben van releváns anyag. Ezután váltson át a legrelevánsabb gyűjtemény saját felületére, ott ugyanis pontosabb szűrőket talál.
3. Keresés és böngészés
A Hungaricanán háromféle módon kereshet: kulcsszóra a teljes szövegben (OCR-alapú), metaadat alapján (szerző, cím, kiadási év, gyűjteményjelölet), illetve böngészéssel (egy adott folyóirat lapszámait sorba haladva). A három módszer eltérő helyzetekben hatékony, és érdemes mindhárommal megbarátkozni.
3.1 Egyszerű kulcsszavas keresés
Ez a leggyakoribb keresési mód. A kezdőoldal központi mezőjébe beírja a kifejezést, és Entert nyom. A portál minden gyűjteményben átfut, és a találatokat gyűjteményenként csoportosítja. A találati listán a gyűjteményfülek között válthat.
Pontosabb találathoz idézőjelbe teheti a kifejezést: a kolerajárvány keresés mindenhol talál, ahol a szó szerepel, viszont a „kolerajárvány Eger” pontos szókapcsolatként csak ott talál, ahol pontosan így szerepel a szöveg. (A magyar nyelvű forrásoknál ritka, hogy hosszú szókapcsolatok szóról szóra megismétlődnek, ezért az idézőjelet általában rövid, jellegzetes kifejezésekre érdemes használni: nevekre, intézménynévre, ritkább szavakra.)
A kereső nem érzékeny a kis- és nagybetű különbségére, így nem fontos, hogyan írja be a kulcsszót. A magyar ékezetekre azonban érzékeny: a kolera és a Kolera ugyanazt találja, de a kolerajarvany (ékezet nélkül) nem ugyanazt, mint a kolerajárvány.
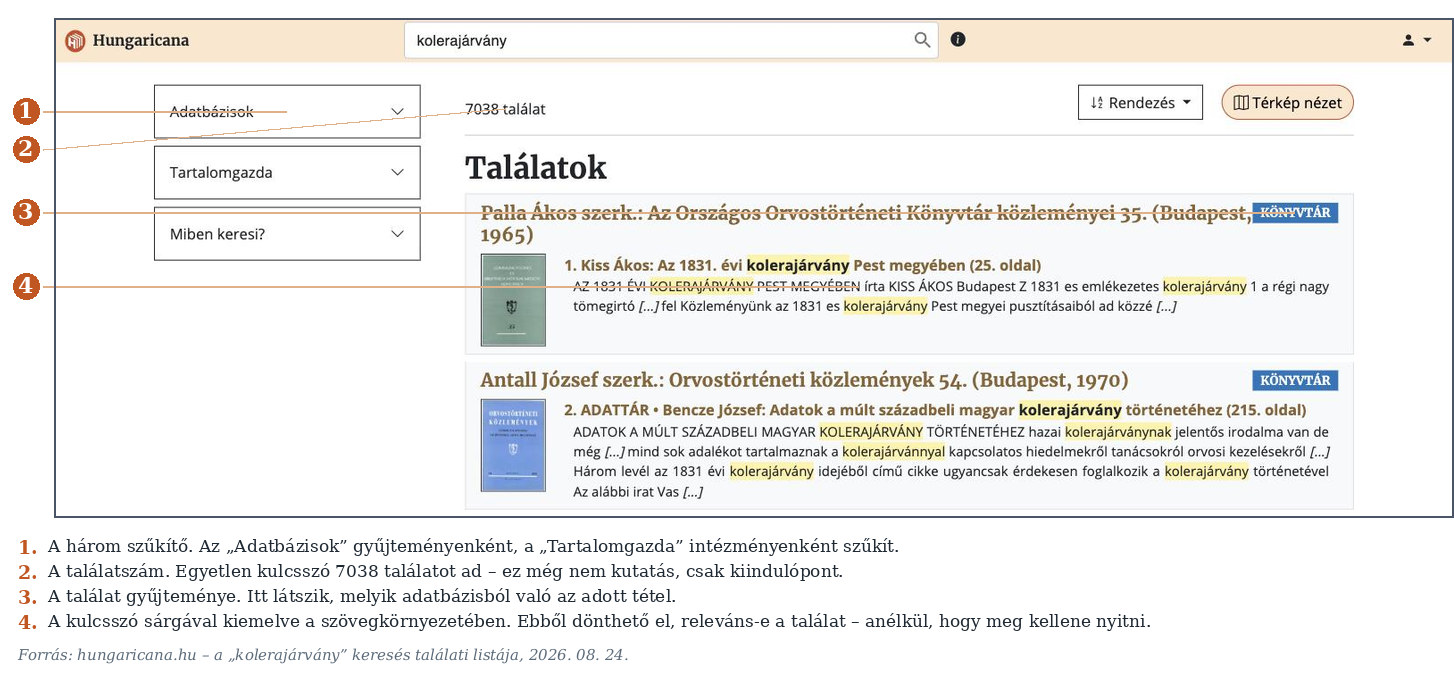
3.2 Szűrt keresés
Az igazi munka a találati listán kezdődik. Egyetlen, jó kulcsszó gyakran több ezer találatot ad – a kolerajárvány keresés például 7038-at –, ez pedig kezelhetetlen. A találati lista bal oldalán három szűkítő áll, mindegyik külön ablakot nyit:
- Adatbázisok: gyűjtemény szerint szűkít (Könyvtár – könyvtári dokumentumok, levéltári iratok, helyi lapok, múzeumi kiadványok stb.; Térképek; Levéltár). Ez a legfontosabb, mert minden gyűjtemény mellett ott áll, hány találat esik rá – vagyis a szűkítő egyben eligazít, hol érdemes keresni.
- Tartalomgazda: annak az intézménynek a szerinti szűkítés, amely az adott anyagot digitalizálta és szolgáltatja.
- Miben keresi?: a kiválasztott gyűjteményen belüli további szűkítés. Amíg nem választott gyűjteményt, ez üresen áll („Nincsenek megjeleníthető szűkítők”) – ezért érdemes az Adatbázisokkal kezdeni.
A szűkítés az Alkalmaz gombbal lép életbe, a Szűkítő törlése pedig visszaállítja a teljes listát. Ha jó sorrendben szűkít – a legtágabbtól a legszűkebb felé –, néhány lépésben kezelhető, mondjuk 20–100 találatos listához jut, amelyet már egyenként át tud nézni. Ez az alapja a komoly Hungaricana-kutatásnak.
Figyelem Külön időszak- és helyszűrő a közös találati listán nincs. Ha évkörre vagy egy konkrét lapra akar szűkíteni, ahhoz az adott gyűjtemény saját keresőfelületére kell átmennie (például a Könyvtár vagy a Levéltár aloldalára). A közös kereső arra való, hogy megmutassa, hol van anyag – a finomhangolás a gyűjtemény saját felületén történik.
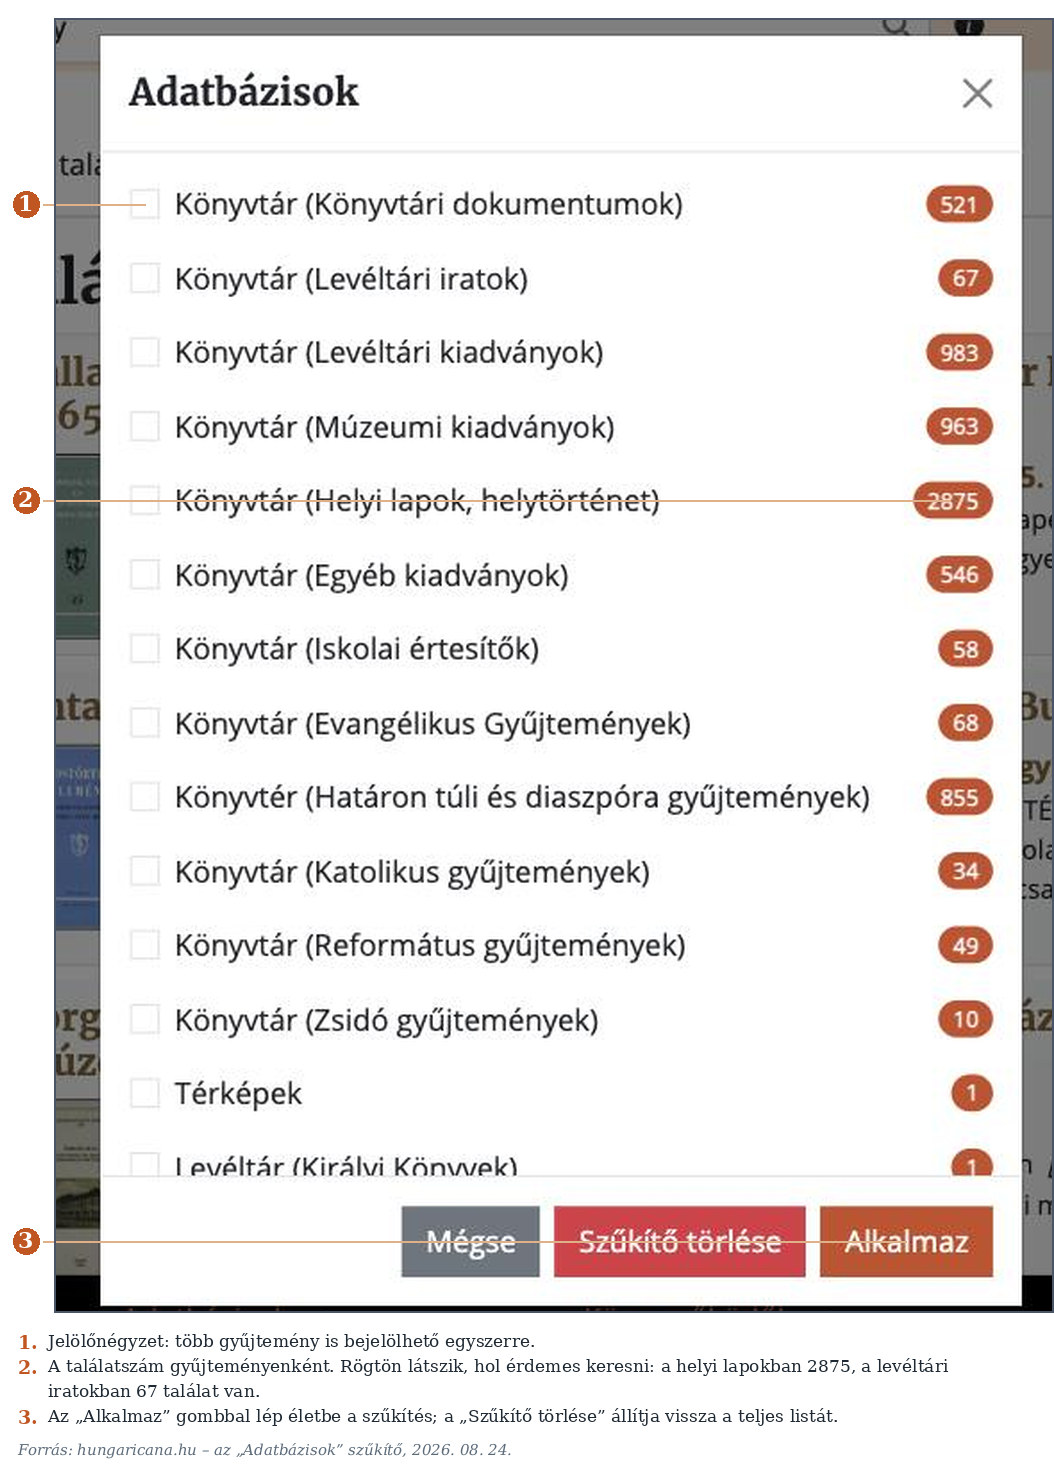
3.3 Böngészés
Egy adott folyóirat vagy iratsorozat oldalán végig tudja lapozni a lapszámokat, vagy a levéltári segédlet hierarchiáján (fond → állag → sorozat → tétel) lefelé haladva eljuthat egy konkrét irathoz. Ez a módszer lassabb, de nem függ az OCR minőségétől.
A böngészés három helyzetben kötelező vagy nagyon ajánlott:
- Ha a forrás 19. század előtti, gót betűs vagy kézzel írt, akkor a kulcsszavas keresés gyakran nem talál meg olyan dokumentumot sem, amelyben valójában szerepel a keresett szó – az OCR ezen a forrástípuson rosszul teljesít.
- Ha nincs konkrét kulcsszava, csak témája van – például egy folyóirat egy adott évfolyamát szeretné átnézni rovatok szerint, hogy lássa, milyen témákkal foglalkozott.
- Ha levéltári iratban keres, és tudja a jelzetet (fond/állag/sorozat) – ekkor érdemes a hierarchián keresztül lemenni az iratig, mert a metaadat-keresés gyorsabb és pontosabb, mint a teljes szöveges.
Mélyebben A keresés és az OCR-szöveg viszonya
A Hungaricana keresője az OCR által generált gépi szövegben keres, nem az oldalképen. Ez azt jelenti, hogy a találati lista pontossága az OCR pontosságától függ: ha az OCR „c”-t olvasott „e” helyett, a kulcsszó keresése nem találja meg az adott oldalt. Ennek korlátját nem lehet teljesen áthidalni, de néhány stratégia segít: (1) többféle alakot is kereshet (például kolera és cholera); (2) szűkítő szűrőket alkalmazhat, hogy a böngészéshez kezelhető halmazt kapjon; (3) szisztematikus böngészéssel kiegészítheti a kulcsszavas találatokat.
4. A találatok kezelése
Ha rákattint egy találatra, a portál átviszi az adott gyűjtemény
saját olvasófelületére (a könyvtári anyagnál a
library.hungaricana.hu címre), és megnyitja a dokumentumot
azon az oldalon, ahol a keresett szó áll. A jobb oldalon az
oldalkép látszik, a bal oldalon a kötet szerkezete (az
Oldalképek fülön a lapozható oldalak, a Tartalom fülön
a tartalomjegyzék), felül pedig a műveletek: keresés a köteten belül,
letöltés, oldalszám, nagyítás.
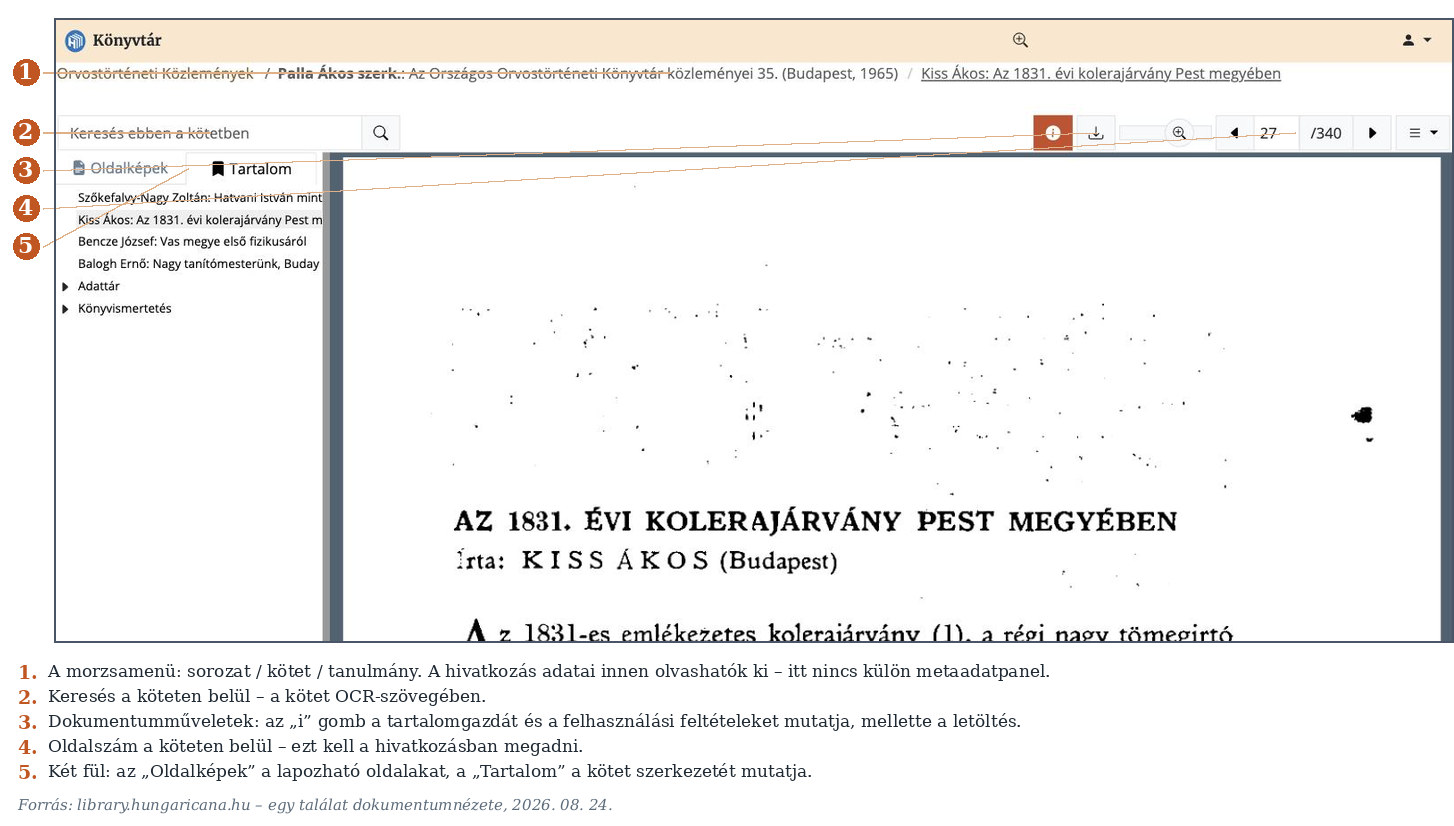
A találat oldalának három különösen fontos eleme van:
- A pontos hivatkozási adatok – sorozat, kötet, szerző, cím, oldalszám, illetve levéltári forrásnál a jelzet – a felső morzsamenüből és az oldalszámmezőből olvashatók ki. Külön metaadatpanel nincs: az „i” gomb csak a tartalomgazdát és a felhasználási feltételeket mutatja. Ezekre szüksége lesz a hivatkozás összeállításához.
- A perzisztens (állandó) link – a böngésző címsorában látható URL nem mindig stabil, de a „Megosztás” menüpont alatt található permalink hosszú távon érvényes. Ezt kell idéznie, nem a böngészési URL-t.47
- Az oldalkép letöltése – letöltheti JPEG/PNG-ben a saját jegyzeteihez. Vigyázzon: a letöltött kép is a digitalizált változat, nem az eredeti dokumentum. Ha publikálni akarja, ellenőrizze a portál szerzői jogi feltételeit.
Figyelem A találat nem azonos a forrással
A Hungaricanán talált oldalkép egy digitalizált másolat. A mellette megjelenő OCR-szöveg algoritmikus átirat – nem hivatkozható forrás. Mindig az oldalképet és a forrás eredeti bibliográfiai adatait (folyóirat, dátum, oldalszám, levéltári jelzet) idézze, és ha kritikus mondanivaló múlik egy szövegrészleten – például egy szó szerinti idézeten –, lehetőség szerint ellenőrizze az eredetit. A kettő közötti különbségről a Mi a forrás? fejezet 3. szakasza részletesebben szól.
5. Hogyan hivatkozzon Hungaricana-forrásra?
A Hungaricana csak közvetítő: a tényleges forrás egy konkrét folyóirat, könyv vagy levéltári irat. A hivatkozást a forrás eredeti adatai szerint kell összeállítani, és csak utána, kiegészítésként érdemes jelezni, hogy a digitalizált példányt a Hungaricanán érte el. A Korall hivatkozási rendje szerint:
Sajtótermék idézése. Lábjegyzetben első előforduláskor: „Heves Megyei Hírlap, 1873. augusztus 17. 3. (Hungaricana, https://hungaricana.hu/hu/…, elérve: 2026. 04. 12.)”. Az irodalomjegyzékben a folyóirat egészére hivatkozhat: „Heves Megyei Hírlap (1873). Eger.”
Könyv idézése. Lábjegyzetben: „Szerző Vezetékneve Keresztneve: Cím. Hely, Kiadó, Év. Oldalszám. (Hungaricana, https://…, elérve: ÉÉÉÉ. HH. NN.)”. Az irodalomjegyzékben a hagyományos formátum + a perzisztens link.
Levéltári irat idézése. Lábjegyzetben: „Magyar Nemzeti Levéltár Heves Vármegyei Levéltára, IV.401. fond, 2. állag, közgyűlési jegyzőkönyvek, 1873. évi 234. sz. (Hungaricana, https://…, elérve: ÉÉÉÉ. HH. NN.)”. Az irodalomjegyzékben a teljes intézmény + fond hivatkozása.
Tipp Ha elakad
- „A keresett szó biztosan szerepel a forrásban, de nincs találat.” → Valószínűleg OCR-hiba; próbálja a kulcsszó más alakjával, vagy böngésszen.
- „Túl sok találat, nem tudom kezelni.” → Szűkítsen a bal oldali szűrőkkel, gyűjtemény → időszak → cím sorrendben.
- „A találati listán nem látom az időszaki szűrőt.” → Ellenőrizze, hogy a gyűjtemény-szűrőt már beállította; az időszaki szűrő csak akkor érhető el, ha egyetlen gyűjteményre szűkítette a listát.
- „A perzisztens link is változott.” → Ritka, de előfordul; ekkor a metaadatok alapján újra megkeresheti a forrást, és új linket másol.
Esettanulmány
Esettanulmány Az 1873-as kolerajárvány Egerben
(A példa illusztratív: a keresési munkamenetet mutatja be. A konkrét lapszámok, oldalszámok és a perzisztens link a tényleges keresés alapján pótolandó.)
A kutatási kérdés a következő: hogyan reagált Eger városának közvéleménye és helyi hatósága az 1873-as kolerajárványra, és milyen intézkedéseket hozott? A kérdés helytörténeti, eseménytörténeti és közegészségügyi szempontból egyaránt értelmezhető.
A megfelelő gyűjtemény a Sajtó: az 1872–1873 körül megjelent helyi és regionális újságok lapszámai itt elérhetők. A levéltári források (megyei közgyűlési jegyzőkönyvek) szintén relevánsak, és ezek egy része szintén a portálon van; jelen esettanulmány azonban a sajtóforrásokra fókuszál, mert ezek a közvélemény-történet szempontjából elsődlegesek.
Első lépés. A kezdőoldal központi keresőjébe a kolera szót gépeljük be. A találati lista a Sajtó gyűjteményben több ezer találatot ad – ez túl sok, szűkíteni kell.
Második lépés. A bal oldali szűrőpanelben a gyűjteményt Sajtóra szűkítjük, az időtartományt 1872–1874-re, a megjelenési helyet pedig – ha ilyen szűrő elérhető – Egerre vagy Heves vármegyére. Így a találatok száma néhány tucatra csökken, amit már egyenként át lehet nézni.
Harmadik lépés. A listából kiválasztjuk a helyi lap 1873. augusztusi lapszámait, amelyek tematikusan közvetlenül a kérdéshez kapcsolódnak – a járvány Magyarországon ekkor érte el a csúcspontját.
Negyedik lépés. Egy konkrét lapszámban megtaláljuk a városi tanács intézkedéseiről szóló beszámolót, amely leírja a piactéri kút használatának korlátozását, a fertőtlenítési előírásokat és a tanácsi rendelkezések közzétételének módját. A perzisztens linket a Megosztás menüpont alól másoljuk.
Reflexió. Az OCR a kolera szót megbízhatóan megtalálta – a kor szempontjából modern betűtípus, viszonylag jó nyomásminőség. Érdemes azonban ellenőrizni a régies cholera alakot is, mert a 19. század közepén ez a helyesírás is használatban volt; további találatokat eredményezhet.
A találatok kritikai értékelésénél fontos szempont, hogy a helyi újság nézőpontja a városi vezetés perspektíváját tükrözi – a járvány által érintett szegényebb lakosság hangja ebből a forrásból nem rekonstruálható; ehhez más források (anyakönyvek, esetleg visszaemlékezések) kellenek, amelyek más gyűjteményekben érhetők el. Ez a reprezentativitás kérdése, amelyről a Mi a forrás? fejezet 4.3 szakasza szól.
Gyakorlati feladatok
Feladat 1. feladat (kötelező) – Saját Hungaricana-keresés
Válasszon egy konkrét helytörténeti vagy eseménytörténeti kérdést, lehetőleg a saját lakhelyéhez vagy szülővárosához kapcsolódóan. Lehet például egy 19. századi tűzvész, egy választás, egy ünnepi esemény, egy járvány, egy iskola alapítása.
Fogalmazzon meg egy legfeljebb két mondatos, konkrét kutatási kérdést.
Indokolja meg egy bekezdésben, hogy melyik Hungaricana-gyűjteményben kezdi a keresést, és miért.
Futtasson legalább két különböző keresést a kérdéséhez kapcsolódóan, eltérő kulcsszóval vagy eltérő szűrőkkel. Mindkét keresés esetében jegyezze fel a beírt kulcsszót és a használt szűrőket.
Válasszon ki egy releváns találatot, és mutassa be Korall-stílusú lábjegyzettel és egy mondatos magyarázattal, miért fontos a kérdéséhez.
Elvárt formátum: féloldalas (kb. 250–350 szavas) szöveg, plusz egy képernyőkép a kiválasztott találat részletes nézetéről.
Feladat 2. feladat (kiegészítő) – OCR-kritika
A 3. szakaszban szó volt arról, hogy az OCR torzítja a teljes szöveges keresést. Most ennek nézzen utána a gyakorlatban: válasszon ki egy 19. század közepi vagy korábbi forrást a Hungaricana Sajtó vagy Könyvek gyűjteményéből, és hasonlítsa össze az oldalképet az alatta megjelenített OCR-szöveggel.
Jelöljön meg három olyan szót, ahol az OCR egyértelműen hibásan ismerte fel a karaktert.
Egy bekezdésben írja le, milyen típusú hibák voltak (például „c” → „e”, ékezet eltűnése, betűk összeolvadása).
Fogalmazzon meg egy mondatot arról, hogy ez milyen következményekkel jár a kulcsszavas keresésre.
Elvárt formátum: egy bekezdésnyi (kb. 150 szavas) elemzés, plusz a forrás perzisztens linkje.
Önellenőrző kérdések
1. Milyen forrástípust keresne elsőként, ha egy 1880-as helyi választási kampány közvélemény-történetét írná, és miért?
Válasz megjelenítése
A Hungaricana Sajtó gyűjteményét, mert a helyi újságok a közvélemény és a politikai diskurzus elsődleges forrásai. Kiegészítésként a megyei levéltár közgyűlési jegyzőkönyvei is szóba jönnek, ha azok elérhetők a portálon.
2. Miért nem érdemes a Hungaricana OCR-szövegét közvetlenül idézni?
Válasz megjelenítése
Mert ez algoritmikus átirat, hibákkal; nem azonos a forrással. Az eredeti oldalképet és a hozzá tartozó bibliográfiai adatokat kell idézni; szó szerinti idézethez az oldalképen kell ellenőrizni a szöveget.
3. Mit jelent, ha egy 19. század előtti, gót betűs könyvben rákeres egy szóra, és a kereső nem talál semmit, holott biztosan szerepel benne?
Válasz megjelenítése
Az OCR a régies betűtípuson rosszul teljesít, ezért nem ismerte fel a kulcsszót. Ilyenkor érdemes a kötetet böngészéssel végignézni, vagy a kulcsszó alternatív alakjait (régies helyesírás, fonetikus változat) is kipróbálni.
4. Mire való a „Megosztás” menüpont alatti perzisztens link?
Válasz megjelenítése
A forrás stabil, hosszú távon érvényes URL-je, amelyet hivatkozásban idézni kell. A böngésző címsorában szereplő keresési URL időnként változik, a perzisztens link nem.
5. Mi a logikus sorrend, ha egy túlságosan tág találati listát szeretne kezelhetővé szűkíteni?
Válasz megjelenítése
A legtágabb kategóriától a legszűkebb felé haladva: először gyűjteményre (pl. Sajtó), majd időszakra (pl. 1873), majd címre (pl. egy konkrét folyóirat). Így néhány lépésben kezelhető listához jut.
Összefoglalás
Ebben a fejezetben megismerte a Hungaricana Közgyűjteményi Portál szerkezetét és a benne elérhető legfontosabb gyűjteményeket; megtanulta, hogyan kombináljon kulcsszavas, szűrt és böngészési keresést; látta, hogy a digitalizált forrás miért nem azonos az eredetivel; és Korall-stílusban hivatkozott egy konkrét találatot.
A portál tartalma átfedésben van más magyar adatbázisokéval – mindenekelőtt az Arcanum Digitális Tudománytáréval –, de a használati logikájuk és a hozzáférési feltételeik eltérnek. A különböző portálok tudatos kombinálása a magyar történeti kutatás egyik legfontosabb gyakorlati készsége.
Kulcsfogalmak
fond – Levéltári alapfogalom: egy iratképző szerv (például egy minisztérium, egy megyei közgyűlés) iratainak szervesen összetartozó egysége; a levéltári rendszerezés legfelső szintje. A teljes hivatkozáshoz a fond mellett az állag, a sorozat és a tétel is szükséges.
közgyűjtemény – Olyan intézmény (levéltár, könyvtár, múzeum), amely közfeladatként őriz és tesz hozzáférhetővé kulturális javakat.
metaadat – Egy dokumentumról szóló, strukturált leíró adat (szerző, cím, dátum, jelzet, terjedelem); a katalogizálás alapja.
OCR (optikai karakterfelismerés) – Kép típusú dokumentumból automatikusan előállított gépi szöveg; minősége a forrás állapotától, a betűtípustól és a szkennelési minőségtől függ.
perzisztens link – Egy digitális dokumentum stabil, hosszú távon érvényes webcíme. A keresési vagy böngészési URL gyakran változó, a perzisztens link nem.
teljes szöveges keresés – Olyan keresési mód, amely a dokumentum teljes szövegében (és nem csak a metaadatokban) keres. A Hungaricana esetében az OCR-szövegen alapul, ami egyúttal a hibaforrás is.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Hungaricana Közgyűjteményi Portál – „Rólunk” oldal. https://hungaricana.hu/hu/rolunk (elérve: 2026. 04. 12.)
Linkek és eszközök
- Hungaricana Közgyűjteményi Portál – https://hungaricana.hu – elérve: 2026. 04. 12.
- A Hungaricana súgója – https://hungaricana.hu/hu/segitseg – elérve: 2026. 04. 12.
- Arcanum Digitális Tudománytár – https://adt.arcanum.com – elérve: 2026. 04. 12.
- Magyar Nemzeti Levéltár – Adatbázisok – https://adatbazisokonline.mnl.gov.hu/ – elérve: 2026. 08. 20.
AdatbázisokOnline: a levéltári adatbázisok gyűjtőhelye
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 90 perc |
| Előfeltétel | Elektronikus Levéltári Portál (ELP), Mi az adatbázis? |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszköz alapadatai
| Eszköz neve | AdatbázisokOnline |
| URL | https://adatbazisokonline.mnl.gov.hu/ |
| Üzemeltető | Magyar Nemzeti Levéltár |
| Hozzáférés | Ingyenes, regisztráció nélkül kereshető |
| Regisztráció | Nem szükséges |
| Tartalomtípus | Segédadatbázisok: a levéltári iratokból kinyert, rekordokba rendezett, tételesen kereshető adat – anyakönyvek, összeírások, hadifogoly-nyilvántartások és sok más |
| Időkörök | A 18. századtól a 20. századig, adatbázisonként eltérően |
| Méret | 2026. 08.: 148 adatbázis, 6 610 651 rekord |
| Fontos korlát | Nem a levéltár hivatalos nyilvántartása, hanem feldolgozás – a hivatkozásban az eredeti irat jelzetét is meg kell adni (lásd A magyar levéltári rendszer) |
Miről szól ez a fejezet?
Az ELP fejezetben megtanulta, hogyan találja meg, hol van egy irat. Az AdatbázisokOnline a következő lépés: itt nem az iratról szóló leírást, hanem magát a feldolgozott tartalmat kapja meg – név szerint, tételesen, kereshetően.
A felület 2026 augusztusában 148 adatbázist, 6 610 651 rekordot és 12 973 106 szöveges oldalt, képet és hanganyagot tett kereshetővé. Ez a magyar levéltári anyag legnagyobb feldolgozott gyűjteménye.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- megkülönböztesse az AOL-t az ELP-től, a LIR-től és a Hungaricanától, és megmondja, melyiket mikor használja;
- eligazodjon az adatbázisok között a kategóriák és az A–Z lista segítségével;
- használja a felület keresőszintaxisát és a találatszűkítőket;
- értelmezze a névtér-beállítást, és megmondja, mikor érdemes bekapcsolni;
- az „MI magabiztosság küszöb” beállításából levonja a következtetést a gépi feldolgozás megbízhatóságáról;
- helyesen hivatkozzon egy AOL-találatra.
Bevezetés: melyik felület mire való?
A magyar levéltári online felületek könnyen összekeverednek, pedig más intézmények üzemeltetik őket, és másra valók.
| Felület | Üzemeltető | Mit ad? | Mikor használja? |
|---|---|---|---|
| AdatbázisokOnline | Magyar Nemzeti Levéltár | feldolgozott, tételes adat | „Szerepel-e X a forrásban?” |
| ELP | MNL és Budapest Főváros Levéltára | levéltári leírás és digitalizált iratképek | „Hol az irat, és meg tudom-e nézni?” |
| LIR | Állambiztonsági Szolgálatok Történeti Levéltára | az ÁBTL leírási egységei és személyrekordjai | „Mi van az állambiztonsági iratanyagban?” |
| Hungaricana | Arcanum, közgyűjteményi partnerekkel | közgyűjteményi anyag, köztük levéltári | „Digitalizálva van-e valahol?” |
Figyelem A LIR nem a Magyar Nemzeti Levéltár rendszere. Az Állambiztonsági Szolgálatok Történeti Levéltára üzemelteti, és kizárólag az ÁBTL saját őrzési körére (1944–1990) vonatkozik. Ez gyakori félreértés, mert a neve általánosnak hangzik.
A gyakorlati következmény: ha nem állambiztonsági iratot keres, a LIR-ben nem fog megtalálni semmit – nem azért, mert nincs, hanem mert nem ott van.
Az AdatbázisokOnline tehát nem az irat helyét és nem is a képét adja elsősorban, hanem a belőle kinyert, rekordokba rendezett tartalmat – például egy összeírás minden egyes nevét külön sorban.
1. Hogyan épül fel?
A nyitóoldalon egyetlen keresőmező áll, amely az összes adatbázisban keres egyszerre. Ez felfedezésre jó, de a komoly munka az egyes adatbázisokon belül folyik.
Az adatbázisok kétféleképpen böngészhetők: kategóriák és A–Z lista szerint. A kategóriák a nagy tematikus tömböket mutatják:
- Családtörténet és Helytörténet – összeírások, anyakönyvek, névtárak;
- Középkori gyűjtemény – oklevelek;
- Első világháború, Szovjetunióba elhurcoltak, Holokauszt forrásválogatás – 20. századi veszteség- és üldözéstörténeti adatbázisok;
- Pártiratok, Minisztertanácsi jegyzőkönyvek 1944–1965, Külügyminisztérium – államszocializmus kori kormányzati és pártiratok;
- Rendszerváltás vidéken, Digitális Roma levéltár, Reformáció 500 – tematikus gyűjtések.
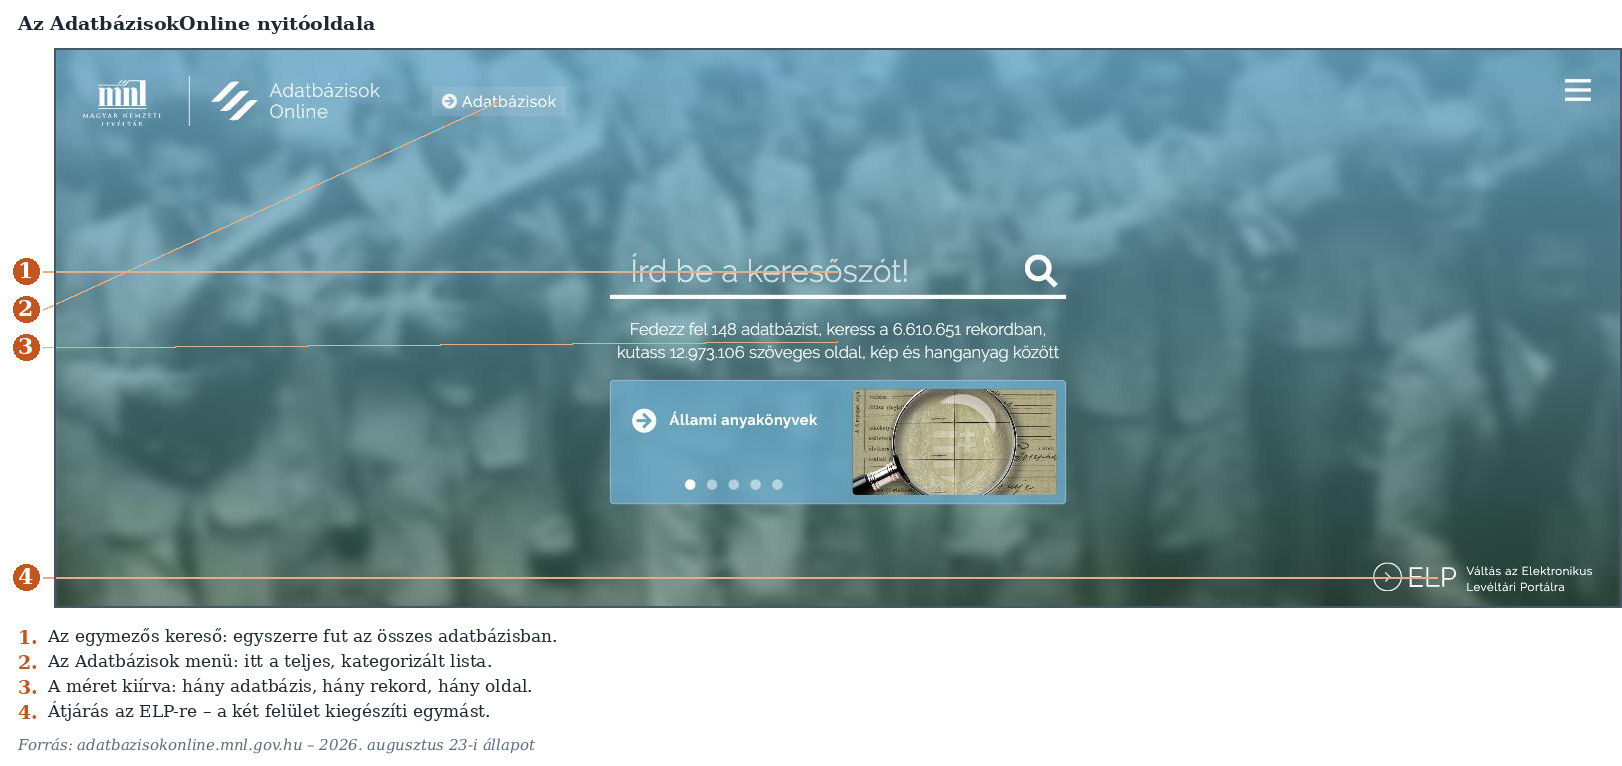
2. Keresés
2.1 Szintaxis
A felület a következő jeleket ismeri:
| Jel | Mit csinál? | Példa |
|---|---|---|
* |
tetszőleges számú karaktert helyettesít | magyar* → magyarok, magyaroknak, magyarság |
? |
egy betűt helyettesít | sz?n → szent, szán, színben |
" " |
pontos kifejezésre keres | "magyar" → a magyarok-ra nem talál |
- |
kizárja a találatot | -alma → kihagyja, amiben szerepel az alma |
Tipp Itt is érvényes, amit az Arcanum fejezetben mondtunk: magyar
szövegben csonkolással keressen. A levéltári anyagban ehhez még
két ok járul. Egyrészt a régi helyesírás (Szentgyörgy /
Szent-György / Szt. György), másrészt a latin
nyelvű összeírások ragozott alakjai.
2.2 Szűkítők
Minden adatbázisnak saját szűkítői vannak, amelyek az adatmodelljét tükrözik. Az 1715. évi országos összeírásnál például: Téka, Kötet (vármegye), Településcsoport (járás vagy uradalom).
Mélyebben A szűkítők elárulják az adatmodellt
Ez a fejezet legfontosabb módszertani megfigyelése, és közvetlenül a Mi az adatbázis? fejezetre épül.
Amikor egy AOL-adatbázisban azt látja, hogy „Téka – Kötet – Településcsoport”, akkor a levéltári őrzési egységek hierarchiáját látja: az eredeti iratok így vannak elrendezve. Amikor viszont az anyakönyvi adatbázisban „Település – Típus – Év” a szűkítő, akkor a feldolgozott tartalom logikáját.
A kettő különbsége azt is megmondja, mit lehet kérdezni. Ahol az őrzési egység a szűkítő, ott nehéz „minden Kovács nevű” típusú kérdést feltenni; ahol a tartalom, ott könnyű. A találati lista határa az adatmodell határa.
2.3 Névtér
A keresőben beállítható a névtér használata: „Ne használja a névteret”, illetve Személy, Testületi, Földrajzi.
Ez ugyanaz a megkülönböztetés, amelyet az Arcanum fejezet tulajdonnév-indexeknél tárgyaltunk: bekapcsolva nem betűsorra, hanem azonosított entitásra keres. Ha a keresett név gyakori, vagy településnévként és személynévként is előfordul, ez sokat javít a találati listán.
Figyelem A névtér is gépi és emberi munka eredménye, tehát hiányos lehet. Kétes esetben futtassa mindkét változatot – névtérrel és anélkül –, és vesse össze az eredményt.
2.4 A találatszám korlátja
A felület nagy találatszámnál jelzi: „Túl sok találat, 5000 került megjelenítésre.”
Figyelem Ez nem hiba, hanem technikai korlát – de módszertani következménye van. Ha végig akarja nézni a találatokat, a keresést szűkítenie kell (vármegyére, évre, típusra), és a részhalmazokat külön kell feldolgoznia. Aki az első ötezret nézi végig és abból von le arányokat, torzított mintán dolgozik.
3. Ami a gépi feldolgozásról szól: az anyakönyvi kísérlet
Az „Állami anyakönyvek kézírásfelismeréssel” adatbázis a felület legérdekesebb darabja, mert benne a gépi feldolgozás bizonytalansága látható és állítható.
Az adatbázis 2026 augusztusában 665 683 oldalt tartalmazott – születési (228 450), házassági (140 623) és halotti (296 610) anyakönyvi oldalakat, jelenleg főként Pest megyei településekről (Cegléd, Nagykőrös, Vác, Abony, Monor). Az 1895-ös kezdőév nem véletlen: Magyarországon ekkor vezették be az állami anyakönyvezést.
A különlegessége a szűkítők között van:
| Szűkítő | Mit jelent? |
|---|---|
| MI magabiztosság küszöb | csúszka (alapértelmezés: 30%): milyen biztos legyen a gép a felismerésben ahhoz, hogy a találat megjelenjen |
| Adatszegény oldal | igen/nem – a rendszer megjelöli azokat az oldalakat, amelyekről kevés adatot tudott kinyerni |
Mélyebben Miért kivételes ez a csúszka?
Mert a gépi bizonytalanságot a használó kezébe adja. A legtöbb rendszer elrejti ezt: vagy megmutat egy találatot, vagy nem, és Ön nem tudja, milyen biztos volt benne.
Itt viszont Ön dönt. Alacsony küszöb: sok találat, köztük sok téves – teljes kereséshez jó, amikor egy konkrét személyt keres és minden esélyt ki akar használni. Magas küszöb: kevesebb, de megbízhatóbb találat – statisztikai feldolgozáshoz jó, amikor arányokat számol.
Két dolog következik ebből. Az egyik gyakorlati: mindig írja le, milyen küszöbön dolgozott, különben az eredménye nem reprodukálható. A másik elvi: ez a csúszka teszi láthatóvá, amit a Digitalizálás és OCR és a Mesterséges intelligencia fejezet állít – hogy a gépi felismerés nem igen/nem válasz, hanem valószínűség. A kézírás-felismerés (HTR) természeténél fogva ilyen.
Figyelem A gépi átirat nem forrás – a felvett anyakönyvi kép az. Minden találatnál nézze meg az oldalképet, és onnan olvassa ki az adatot. A gépi felismerés a megtalálás eszköze, nem az adat forrása. Ez ugyanaz az elv, amelyet a Mi a forrás? fejezet a remediációról mond.
4. Hat adatbázis, amit érdemes ismerni
A 148-ból az alábbi hat különböző korszakot és forrástípust képvisel.
| Adatbázis | Korszak | Mire jó? |
|---|---|---|
| Collectio Diplomatica Hungarica | középkor | oklevelek (DL–DF) – a középkori kutatás alapja |
| Az 1715. és 1720. évi országos összeírás | 18. sz. eleje | az első országos összeírások; hely- és családtörténet alapforrása |
| Urbaria et Conscriptiones (E 156) | 16–19. sz. | urbáriumok és összeírások: birtok, jobbágyság, gazdaságtörténet |
| Libri Regii · Királyi Könyvek 1527–1918 | kora újkor – 20. sz. | királyi adományok, nemesítések, kiváltságok |
| Állami anyakönyvek (és kézírásfelismeréssel) | 1895– | személyi adatok: születés, házasság, halál |
| Második világháborús veszteségi adatbázis, Szovjetunióba elhurcoltak, Szovjet táborok magyar foglyai | 20. sz. | veszteség- és üldözéstörténet, személyi sorsok |
Tipp A listából a helytörténeti kérdésekre az 1715/1720-as összeírások és az Urbaria et Conscriptiones a legerősebb kiindulópont; családtörténetre az anyakönyvek és a Libri Regii; 20. századi személyi sorsokra a veszteségi és hadifogoly-adatbázisok. A teljes lista a felület A–Z oldalán érhető el.
5. Hogyan hivatkozzon rá?
Figyelem A hivatkozás a levéltári iratra mutat, nem az adatbázisra.
Az AOL találatai megadják az irat levéltári
azonosítóját – például
HU-MNL-PML-XXXIII.1.a.-187.-b-5. –, valamint az adatbázis
nevét és az oldalt. A hivatkozás ezekből épül fel:
[Levéltár és jelzet], [az irat megnevezése és éve], [oldal]. Elérhető: AdatbázisokOnline, [adatbázis neve], https://adatbazisokonline.mnl.gov.hu/ (elérve: 2026. 08. 21.)
Ha gépi felismeréssel készült adatbázisból dolgozik, jelezze a beállított magabiztossági küszöböt is – ez a reprodukálhatóság feltétele.
Esettanulmány
Esettanulmány Egy keresés végigvezetve: „Szabó” az 1715. évi országos összeírásban
Az alábbi munkamenet 2026. augusztus 21-én futott le; a számok ezt az állapotot rögzítik, és a keresés bárki által megismételhető.
1. lépés – a kiindulás. Nyissuk meg az Az 1715. évi országos összeírás (N 78) adatbázist. Keresés nélkül 7300 találat jelenik meg: ennyi az adatbázis teljes rekordszáma. A bal oldali szűkítők már itt is elárulják a szerkezetet: Téka, Kötet (vármegye), Településcsoport (járás vagy uradalom) – vagyis a levéltári őrzési rend, nem a tartalom.
2. lépés – az első keresés. Írjuk be az egyszerű
keresőmezőbe: Szabó. Eredmény: 1129 dokumentumban /
1129 érintett oldal. A szűkítők azonnal átszámolódnak, és most
már a találatokra vonatkoznak:
| Kötet (vármegye) | Találat |
|---|---|
| Zala | 88 |
| Bihar | 68 |
| Pest-Pilis-Solt | 67 |
| Zemplén | 60 |
| Baranya | 58 |
Ez már önmagában is adat: megmutatja, mely vármegyékben sűrűsödik a keresett név – legalábbis abban a formában, ahogy az összeíró leírta.
3. lépés – csonkolás. Cseréljük a keresést erre:
Szab*. Eredmény: 1394 dokumentum, vagyis
265 találattal több (+23%).
Honnan a különbség? A csonkolt alak megtalálja a Szabo
(ékezet nélküli), Szabóné, Szabad,
Szabolcs és hasonló alakokat is. Egy részük valódi nyereség
(ékezethiány, ragozott alak), másik részük fals találat
(Szabolcs megyenév). A csonkolás tehát nem ingyen
van – de a 265 találatból akár több tucat lehet olyan Szabó,
akit a pontos keresés kihagyott, mert az összeíró vagy az átíró máshogy
írta le a nevet.
4. lépés – egy rekord felépítése. Nyissunk meg egy találatot. Így néz ki:
| Mező | Érték |
|---|---|
| Jelzet | N78 - 8 - Szabolcs |
| Téka | 8 |
| Kötet | Szabolcs |
| Helység | Beszterecz |
| Lipszky-féle név | Besztercz |
| 1913-as név | Beszterecz |
| 1913-as megye | Szabolcs |
| Mai megye | Szabolcs-Szatmár-Bereg |
Itt van a fejezet legfontosabb tanulsága. A rekord ugyanarról a településről négy állapotot rögzít: az 1715-ös írásmódot, a Lipszky-féle repertórium (19. század eleji) alakját, az 1913-as helységnévtár szerinti nevet és megyét, végül a mai megyét. Az adatbázis készítői tehát elvégezték azt a helynév-azonosítási munkát, amely nélkül a 18. századi adat a mai térképen értelmezhetetlen lenne.
Hogy ez mennyit ér, egy másik találat mutatja meg:
| Mező | Érték |
|---|---|
| Jelzet | N78 - 30 - Kraszna |
| Helység | Petenye |
| 1913-as megye | Szilágy |
| Mai megye | Petenia, RO |
Ugyanaz a település 1715-ben Kraszna vármegyében, 1913-ban Szilágy vármegyében, ma pedig Romániában, Petenia néven. Aki csak a mai néven keresne, sosem találná meg; aki csak az 1715-ös alakot ismeri, nem tudná, hol keresse ma.
5. lépés – mit jelent ez a hivatkozásra? A találat
jelzete N78 - 30 - Kraszna; a hivatkozás ebből épül fel, az
adatbázis nevével és az elérés dátumával kiegészítve.
Nem a mai nevet írjuk a hivatkozásba, hanem az
összeírásban szereplő alakot – a mai megfelelőt legfeljebb
zárójelben.
Amit a keresés nem mond meg. A találat oldalszintű: azt jelenti, hogy az adott összeírási oldalon szerepel a keresett betűsor. Hogy hány Szabó nevű személy szerepel rajta, egy vagy öt, azt csak az oldalkép elolvasásával lehet megállapítani. Aki a 1129-et „1129 Szabó nevű adózóként” olvassa, súlyosan téved – ahogy a Mi az adatbázis? fejezet mondja: a találatszám nem a világ mennyisége, hanem a rekordoké.
Gyakorlati feladatok
Feladat 1. feladat – A három felület elhatárolása (15 perc)
Az alábbi öt kérdéshez döntse el, hogy az AOL, az ELP, a LIR vagy a Hungaricana a megfelelő kiindulópont, és indokolja egy mondatban.
- Melyik levéltár őrzi egy adott vármegye közgyűlési jegyzőkönyveit?
- Szerepel-e egy adott családnév az 1715. évi összeírásban?
- Meg tudom-e nézni otthonról egy konkrét irat digitalizált képét?
- Milyen dossziét nyitottak egy személyre 1975-ben az állambiztonsági szerveknél?
- Digitalizálva van-e valahol egy 19. századi megyei nyomtatvány?
Feladat 2. feladat – Az esettanulmány megismétlése más néven (30 perc)
Futtassa végig az esettanulmány öt lépését, de a Szabó helyett egy másik gyakori családnévvel (Kovács, Tóth, Varga, Molnár…).
- Hány találatot ad a pontos alak, és hányat a csonkolt?
- Mekkora a különbség százalékban? Nagyobb vagy kisebb, mint a Szabó esetében – és mi lehet ennek az oka?
- Nézzen meg tíz találatot a csonkolt keresésből, amelyek a pontos keresésben nem szerepeltek: hány közülük valódi nyereség, és hány fals találat?
- Keressen a találatok között olyan települést, amely ma az országhatáron kívül van. Írja le mind a négy névállapotát.
Feladat 3. feladat – Az adatmodell visszafejtése (25 perc)
Válasszon két AOL-adatbázist különböző kategóriákból.
- Nézze meg mindkettőnél, milyen szűkítők állnak rendelkezésre.
- Melyik adatbázis szűkítői tükrözik az őrzési egységeket, és melyiké a feldolgozott tartalmat?
- Fogalmazzon meg mindkettőhöz egy kérdést, amelyet meg lehet válaszolni vele, és egyet, amelyet nem – és indokolja, miért nem.
Feladat 4. feladat – A küszöb hatása (30 perc)
Nyissa meg az „Állami anyakönyvek kézírásfelismeréssel” adatbázist, és keressen rá egy gyakori családnévre.
- Jegyezze fel a találatszámot az alapértelmezett (30%-os) küszöbön.
- Emelje a küszöböt jelentősen, és jegyezze fel az új találatszámot.
- Nézzen meg öt találatot a magas és ötöt az alacsony küszöbről: nyissa meg az oldalképet, és ellenőrizze, tényleg ott van-e a keresett név.
- Írja le két mondatban: melyik beállítást használná egy konkrét személy felkutatásához, és melyiket egy statisztikai vizsgálathoz? Miért?
Önellenőrző kérdések
1. Mi a különbség az AOL, az ELP és a LIR között – és ki üzemelteti őket?
Válasz megjelenítése
Az AdatbázisokOnline a Magyar Nemzeti Levéltár felülete: a feldolgozott, tételes tartalmat adja (szerepel-e X a forrásban). Az ELP az MNL és Budapest Főváros Levéltára közös portálja: levéltári leírás és digitalizált iratképek. A LIR viszont nem az MNL rendszere, hanem az Állambiztonsági Szolgálatok Történeti Levéltáráé, és kizárólag az ÁBTL 1944–1990 közötti őrzési körére vonatkozik.
2. Mit árulnak el a szűkítők egy adatbázisról?
Válasz megjelenítése
Az adatmodelljét. Ha a szűkítők őrzési egységek (téka, kötet), akkor az iratok elrendezését tükrözik, és nehéz tartalmi kérdést feltenni. Ha a feldolgozott tartalom szerintiek (település, típus, év), akkor könnyű. A találati lista határa az adatmodell határa.
3. Mikor érdemes bekapcsolni a névteret?
Válasz megjelenítése
Ha a keresett név gyakori, vagy több szerepben is előfordul (például személynévként és településnévként egyaránt). Ilyenkor a névtér nem betűsorra, hanem azonosított entitásra keres, ami erősen csökkenti a zajt. Mivel a névtér is hiányos lehet, kétes esetben mindkét változatot érdemes lefuttatni.
4. Mit jelent az „MI magabiztosság küszöb”, és hogyan válasszon értéket?
Válasz megjelenítése
Azt szabályozza, mennyire legyen biztos a gép a kézírás felismerésében ahhoz, hogy a találat megjelenjen. Alacsony küszöb: sok találat, sok tévessel – konkrét személy felkutatásához jó. Magas küszöb: kevesebb, de megbízhatóbb – statisztikai feldolgozáshoz jó. A használt küszöböt mindig dokumentálni kell.
5. Miért probléma az ötezres megjelenítési korlát?
Válasz megjelenítése
Mert ha valaki az első ötezer találatot nézi végig és abból von le arányokat, torzított mintán dolgozik. A megoldás a keresés szűkítése (vármegyére, évre, típusra) és a részhalmazok külön feldolgozása.
6. Az 1715-ös összeírás rekordja négy névállapotot ad ugyanarról a településről. Miért fontos ez?
Válasz megjelenítése
Mert a település neve és hovatartozása 1715 óta többször megváltozott. A rekord megadja az összeírásbeli alakot, a Lipszky-féle (19. század eleji) nevet, az 1913-as helységnévtár szerinti nevet és megyét, valamint a mai megyét. Enélkül a 18. századi adat a mai térképen értelmezhetetlen lenne – és a határváltozás miatt külföldre került települést végképp nem lehetne azonosítani.
7. Mit jelent, hogy a találat oldalszintű?
Válasz megjelenítése
Azt, hogy az adott összeírási oldalon szerepel a keresett betűsor – nem azt, hogy hány személyre vonatkozik. Egy oldalon egy és öt Szabó nevű adózó is lehet. A találatszám a rekordok száma, nem a világ mennyisége; a tényleges adatot az oldalkép elolvasásával kell megállapítani.
8. Mire hivatkozik: az adatbázisra vagy az iratra?
Válasz megjelenítése
Az iratra: a levéltári jelzetre, az irat megnevezésére és az oldalra. Az adatbázist és az elérés dátumát az elérés útjaként adjuk meg. Gépi felismeréssel készült adatbázisnál a magabiztossági küszöböt is jelezni kell.
Összefoglalás
Az AdatbázisokOnline a Magyar Nemzeti Levéltár felülete, és a magyar levéltári anyag legnagyobb feldolgozott gyűjteménye: 148 adatbázis, több mint hatmillió rekord. Az ELP-től az különbözteti meg, hogy nem az irat helyét vagy képét, hanem a belőle kinyert tartalmat adja – tételesen, kereshetően; a LIR-től pedig az, hogy az utóbbi egy másik intézmény, az Állambiztonsági Szolgálatok Történeti Levéltárának rendszere, saját, szűk őrzési körrel.
Három dolgot érdemes megjegyezni. Az egyik, hogy a szűkítők elárulják az adatmodellt, és ezzel azt is, milyen kérdést lehet feltenni az adott adatbázisnak: ahol az őrzési egység a rendezőelv, ott nehéz tartalmi kérdést feltenni. A másik az „MI magabiztosság küszöb”: ez a csúszka a magyar levéltári felületek egyik legtanulságosabb eleme, mert a gépi bizonytalanságot a használó kezébe adja – és ezzel kimondja, amit a legtöbb rendszer elhallgat, hogy a gépi felismerés nem tény, hanem valószínűség.
A harmadik az esettanulmányból következik: a jó adatbázis nemcsak megtalál, hanem azonosít is. Az 1715-ös összeírás rekordjai négy névállapotot adnak ugyanarról a településről – ezt a helynév-azonosítási munkát valaki elvégezte, és enélkül a 18. századi adat a mai térképen értelmezhetetlen maradna.
Kulcsfogalmak
AdatbázisokOnline (AOL) – A Magyar Nemzeti Levéltár adatbázis-gyűjtő felülete: a levéltári iratokból feldolgozott, tételes és kereshető adat.
adatszegény oldal – A gépi feldolgozás jelzése arról, hogy egy oldalról kevés adatot sikerült kinyerni.
HTR (kézírás-felismerés) – Kézzel írt szövegek gépi olvasása; eredménye nem biztos átirat, hanem valószínűségi becslés.
magabiztossági küszöb – Beállítható érték, amely megszabja, mennyire legyen biztos a gépi felismerés ahhoz, hogy a találat megjelenjen; a kutatásban dokumentálandó paraméter.
névtér – Azonosított entitások (személy, testület, hely) nyilvántartása, amelyre betűsor helyett lehet keresni.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- AdatbázisokOnline (Magyar Nemzeti Levéltár) – a felület saját ismertetői, keresési súgója és adatbázis-leírásai; a fejezetben szereplő számok és példák a szerkesztő próbakereséseiből származnak – elérve: 2026. 08. 21.
Ajánlott irodalom
- Ring Orsolya: Történeti források kiadása a digitális világban – lehetőségek és gyakorlat. Magyar Tudomány 186. (2025) 10. sz. 2039–2050. https://www.akjournals.com/view/journals/2065/186/10/article-p2039.xml
Linkek és eszközök
- AdatbázisokOnline – https://adatbazisokonline.mnl.gov.hu/ – elérve: 2026. 08. 21.
- AdatbázisokOnline – összes adatbázis (A–Z) – https://adatbazisokonline.mnl.gov.hu/osszes-adatbazis – elérve: 2026. 08. 21.
- Magyar Nemzeti Levéltár – https://mnl.gov.hu/ – elérve: 2026. 08. 21.
Budapest Időgép
| Szerző(k) | Kulcsár Anna |
| Becsült feldolgozási idő | 45 perc |
| Előfeltétel | Mi a forrás?, Hungaricana |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszköz alapadatai
| Eszköz neve | Budapest Időgép |
| URL | https://www.hungaricana.hu/hu/budapest-idogep/ |
| Üzemeltető | Hungaricana Közgyűjteményi Portál |
| Hozzáférés | Ingyenes, regisztráció nem szükséges |
| Regisztráció | Nem szükséges |
| Tartalomtípus | Térképek, lakásívek, telekkönyvi betétek, tervrajzok, fényképek |
| Időkörök | 18. század közepe – 20. század második fele |
Miről szól ez a fejezet?
Ebben a fejezetben a Budapest Időgép adatbázisról lesz szó. A Budapest Időgép nem pusztán különböző korszakokból származó térképek keresését és böngészését teszi lehetővé, hanem ezekhez kapcsolódóan megismerkedhetünk a város kiépülésével, az egyes épületek és lakóik történetével az adatbázishoz rendelt rengeteg levéltári forrásnak köszönhetően. Így az oldal egyszerre használható város-, építészet- és társadalomtörténeti kutatásokhoz, valamint egyszerűen szórakoztató időtöltésként is.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- önállóan rákeres bizonyos épületekre és a hozzájuk kapcsolódó levéltári forrásokra;
- önállóan böngészik az időmetszetek között, és megállapítja, mely térképek mely területet fedik le;
- önállóan végez várostörténeti vagy családtörténeti kutatást az adatbázis anyagában;
- megkülönbözteti a georeferált és a vektorizált térképet, és tudja, melyik mit tesz lehetővé;
- helyesen hivatkozik egy térképre, illetve egy helyrajzi számhoz kapcsolódó levéltári forrásra.
Bevezetés
Tegyük fel, hogy egy szemináriumi dolgozat keretében a budapesti kávéházakkal foglalkozik a századforduló idején. Egy egyszerű kávéház kulcsszóra történő kereséssel azt fogja tapasztalni, hogy számtalan kávéház pontja jelenik meg az 1916-os vektorizált térképen. A találatokat szűkítendő kiválaszt néhány ismertebb kávéházat, például a Hadik Kávéházat, a New York Kávéházat és az Abbázia Kávéházat.
Kezdjük a Hadik Kávéházzal. A térképen megjelölt épületre kattintva feljön a kapcsolódó adatokat tartalmazó panel, amelyből kiderül, hogy a Fehérvári út 34., 36. szám alatt állt az épület, ki volt a tulajdonosa, és milyen intézmények tartoztak ehhez a címhez (Hadik Kávéház, Budapest 112. számú posta). Emellett külső hivatkozásokat is találunk, amelyek a különböző forrásokhoz vezetnek: lakcímjegyzék-adatbázis, közjegyzői okiratok, egyéb adatok. A lakcímjegyzék-adatbázisból kiderül, hogy az épület tulajdonosa 1916-ban dr. Palócz Ignác és felesége volt, míg a benne működő Hadik Kávéház tulajdonosa egy bizonyos Somló Vilmos.
A közjegyzői okiratok között megtaláljuk az épület helyrajzi számához kapcsolódó közjegyzői iratokat, így az épület korabeli lakóiról nyerhetünk további információkat.
A további adatokra kattintva a helyrajzi számhoz kapcsolódó levéltári iratokat összesítő oldalra jutunk. Itt megtaláljuk a különböző adatbázisokat, és utalást arra vonatkozóan, hogy ezek az adatbázisok mely közgyűjteményhez tartoznak. Emellett, amennyiben van online elérhető tartalom a keresett helyrajzi számra, úgy direkt linkkel közvetlenül elérhetjük ezeket az iratokat erről az oldalról. Végül ezen az oldalon egy külön blokkban találhatunk fotókat és képeslapokat a környékről. Ugyanezen lépéseken végigmenve a másik két kiválasztott kávéházról elérhető adatokat is beemelhetjük a kutatásba.
1. Mi a Budapest Időgép?
A Budapest Időgép alkalmazást a Hungaricana közgyűjteményi portál üzemelteti 2017 óta. A projektet Budapest Főváros Levéltára indította NKA-támogatással, majd 2018-tól a Fővárosi Szabó Ervin Könyvtár is csatlakozott. 2023-ban teljesen megújították az alkalmazást Pest, Buda és Óbuda egyesítésének 150. évfordulójára, amely szintén az NKA és a Főváros Önkormányzatának támogatásával valósulhatott meg. A mai felület a BFL, a FSZEK, az Óbudai Egyetem és az Arcanum Adatbázis Kft. együttműködésében üzemel, és egyre több interaktívan kereshető információt szolgáltat a főváros múltjából.
A Budapest Időgép alkalmazás interaktív térképeken keresztül enged betekintést Budapest és közvetlen környezete történetébe. Különböző időmetszetek között barangolhatunk gyakorlatilag a 18. század közepe és a 20. század második fele között. Akár a város kialakulását szeretnénk nyomon követni, akár egy-egy címet, épületet szeretnénk megkeresni a különböző korszakokban, az alkalmazás könnyű és szórakoztató segítséget biztosít a keresgéléshez.
Nagy előnye, hogy a benne található térképek georeferáltak, vagyis minden pontjuk megegyezik egy valós koordinátával; sőt hat kiemelt térkép vektorizált is, aminek köszönhetően az utcanevek kereshetővé is váltak (akár mai néven, akár korabeli néven). Emellett a térképeken kereshetők helyrajzi számok, intézmények, intézménykategóriák is.
Amennyiben az Adatok menü be van kapcsolva, a térképen láthatóvá válnak az egyes helyrajzi számok, amelyekre kattintva előhívható az ingatlan adatlapja. Ez az alkalmazás ugyanis nem pusztán térképek izgalmas böngészését teszi lehetővé, hanem mögötte a Hungaricana adatbázisa áll, így a térképeken szereplő helyrajzi számokhoz kapcsolódó digitális forrásanyagot is egyből tanulmányozhatjuk. Ezzel nemcsak a város kiépülését tudjuk koronként végigkövetni, de a különböző források segítségével várostörténeti, mikrotörténeti (egyes házak, lakók története) kutatásokat is indíthatunk az oldalról.
Összesen 29 térkép található az adatbázisban, ezek közül hat vektorizált (1937–1986), valamint megtalálhatók az 1944-es bombázások után készült légifotók is a városról.
A forrásokat illetően a Budapest Időgéphez öt adatbázis kapcsolódik:
- Telekkönyvi betétek adatbázisa (BFL),
- Lakás-adatszolgáltatási ívek, 1944 (BFL),
- Építészeti tervek (BFL),
- Közjegyzői okiratok (BFL),
- Budapesti cím- és lakásjegyzékek (FSZEK).
Ezenkívül az alkalmazásban használható az 1956-os forradalom áldozatainak térinformatikai adatbázisa, illetve néhány épület 3D-s rekonstrukciója is elérhető.48 Az egyes helyrajzi számokhoz tartozó adatlapok másik kiemelendő előnye, hogy a környékről készült fotók és képeslapok is egy helyen böngészhetők.
Definíció Fogalom: vektorizált térkép
A vektorizált térkép (vagy vektoros térkép) olyan digitális térkép, amely pontokból, vonalakból és geometriai formákból (vektorokból) épül fel. Ahelyett, hogy rögzített képpontokból (pixelekből) álló fotó lenne, a térképi elemeket (utak, épületek, határok) matematikai képletek tárolják, így ezek az elemek kereshetővé, szűrhetővé válnak.
Definíció Fogalom: georeferált térkép
A georeferált térkép olyan digitális vagy digitalizált térkép, amelynek minden pontja hozzá van rendelve a Föld egy valós koordináta-rendszeréhez (például EOV vagy WGS 84).
Definíció Fogalom: térinformatika (GIS)
A térinformatika (angolul Geographic Information System) olyan interdiszciplináris tudományterület és informatikai eszközrendszer, amely a földrajzi helyhez kötött, térbeli (térképészeti) és leíró adatokat gyűjti, tárolja és elemzi. Lényege, hogy összeköti az egyes koordinátákat és objektumokat a hozzájuk kapcsolódó leíró információkkal.
Definíció Fogalom: geokódolás
„A történeti adatok geokódolása az a folyamat, amely során a történeti adatokhoz (például eseményekhez […]) földrajzi koordinátákat rendelünk hozzá. A geokódolás lehetővé teszi a történeti adatok földrajzi helyének azonosítását és térbeli információval való bővítését, azaz megjelenítését a történeti térinformatikai rendszerben.”49
2. A felület felépítése
Az alkalmazás a Hungaricana felületéről és egyszerű keresőből (például Google-ból) is elérhető. A főoldalon az alapértelmezetten beállított térkép jelenik meg, felül a keresőmező található, amelyben helyrajzi számra, intézményre, különböző kategóriákra lehet keresni. A felület jobb oldalán található a mai cím kereső, így nem szükséges ismernünk a keresett helyszín korabeli megnevezését ahhoz, hogy megtaláljuk az adott térképen. Ez alatt a nagyítás/kicsinyítés, valamint a tájolás lehetősége szerepel. A térkép jobb alsó sarkában mindig megjelenik, hogy éppen melyik térképen keresünk.
A felület bal felső sarkában a Budapest Időgép logója található, amely kattintható – gyakorlatilag újra betölti az oldalt. A legfontosabb funkció a Rétegek, amelyre kattintva előhívható a térképek listája: itt tudunk váltani a különböző történelmi és vektorizált térképek között, valamint az Adatok menüpont alatt a helyrajzi számokat tudjuk szűrni és az 1956-os forradalom áldozatainak adatbázisát használni. Végül a 3D-épületek menüpont alatt találjuk azon épületek listáját, amelyekről már elérhető a 3D-modell a térképen.
A Rétegek alatt találjuk az Adatok megjelenítésének kapcsolóját (ki/be); ezt érdemes bekapcsolva tartani, hiszen így láthatjuk a térképre vetítve a kattintható helyrajzi számokat.
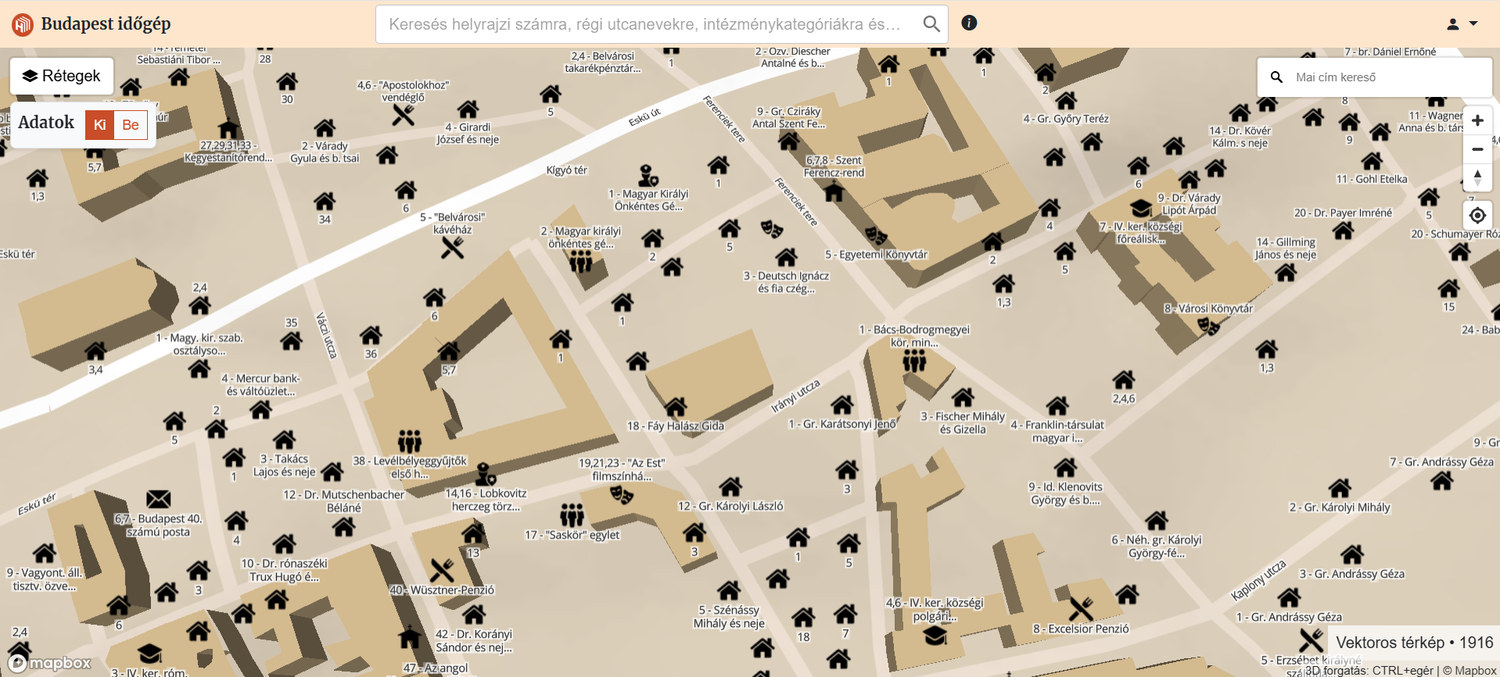
3. Keresés és böngészés
A főoldalon két keresőmező található, mindkettő egyszerű kulcsszavas keresést tesz lehetővé.
A fő keresőben helyrajzi számra, régi közterületnévre (út, utca, köz, tér), intézménynévre, kategóriára (oktatás, kultúra, egészségügy), de akár személynévre is kereshetünk. Ez utóbbira akkor lesz találat, ha egy adott helyrajzi számhoz tartozó lakcímjegyzékekben szerepel tulajdonosként az illető.
A másik keresési lehetőség a Mai cím kereső. Ide a mai címet beírva indíthatunk keresést, és a térkép odaugrik, ahol ez a cím (annak koordinátája) található. Így akkor is elnavigál az alaptérkép egy adott pontra, ha alatta nincs történelmi térképmetszet. Egy adott területet tehát végig tudunk nézni a meglévő térképeken úgy, hogy a képernyő mindig a pontunkra fókuszál, akár tartozik hozzá térképmetszet, akár nem. Kizoomolva láthatjuk, hogy az adott időpontból származó térképmetszetek mekkora területet fednek le, és ehhez képest hol található a mi pontunk.
Tipp Amennyiben először használjuk a felületet, érdemes először a rétegek közt végignézni, hogy a meglévő történelmi térképek mekkora területet fednek le – így tisztában leszünk azzal, hogy egy-egy korszakban milyen találatokra számíthatunk. Ehhez érdemes kizoomolni a térképből, hogy egyben lássuk a felületet, és a Rétegek menü előhívásával egyenként végigkattintani a térképeket, először még az Adatok kikapcsolásával.
4. A találatok kezelése
Mivel ez a felület nem egyszerűen egy adatbázisban tárolt információk lekérdezésére szolgál, hanem azok térképre vetítésére, interaktív megjelenítésére, ezért egy-egy keresés lefuttatása után nem kapunk megszokott találati listákat. Ehelyett a keresőszónak megfelelő találatok megjelennek a térképünkön.
Például ha a kórház szóra keresünk, és megfelelően kizoomolunk a térképből, egyszerre láthatjuk az összes pontot, amely megfelelt ennek a keresési feltételnek – vagyis az adatbázisban szereplő összes budapesti kórházat egyszerre látjuk.
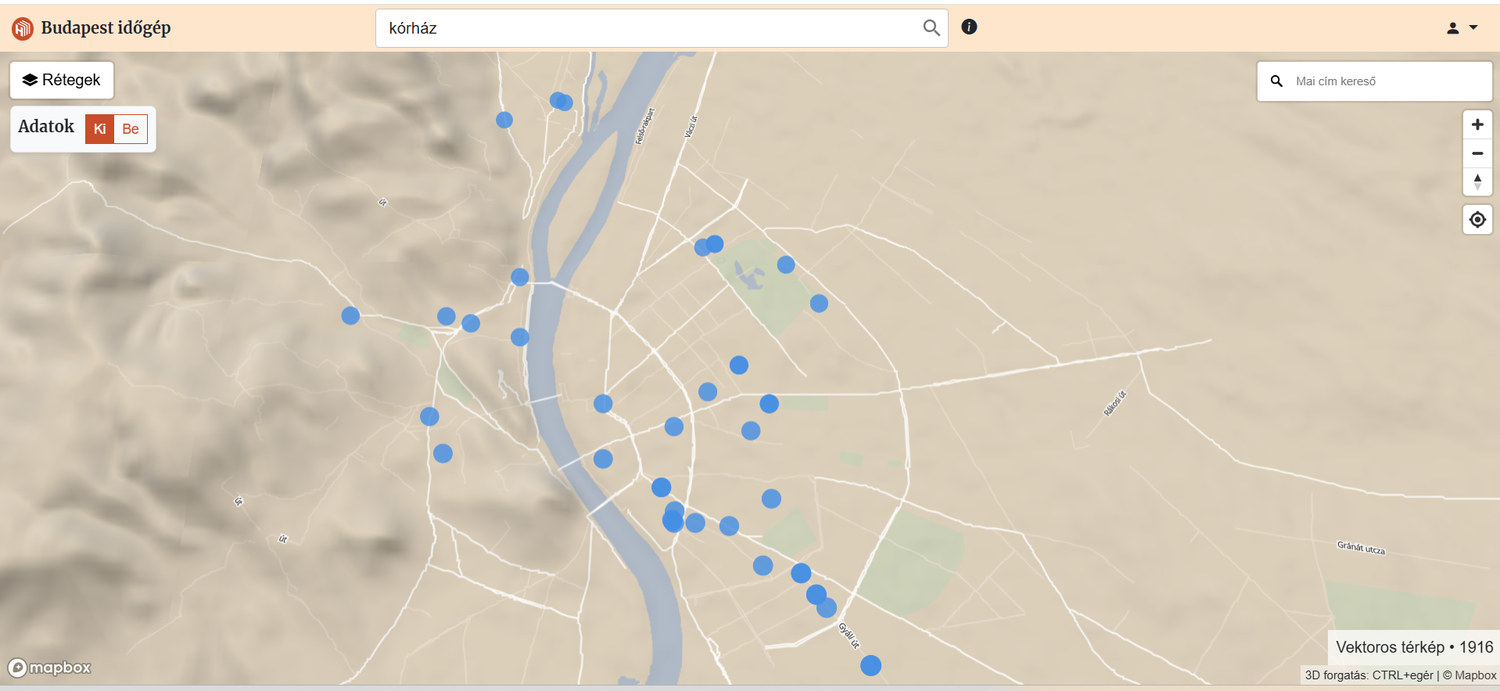
A keresésünket innen vagy szűkítjük (például Rókus Kórházra), vagy egyszerűen rábökhetünk bármelyik pontra, ha nem konkrét kórházra voltunk kíváncsiak, hanem csak böngészni szeretnénk.
Ha a Rókus Kórház példájánál maradunk, akkor a rétegeket lenyitva elkezdhetjük végigkattintgatni az elérhető térképeket, hogy lássuk, mikor találjuk meg először a kórházat az évszázadok során. Azt fogjuk látni, hogy maga a helyszín már az 1775-ös összesítő térképen megtalálható, azonban akkor még nem jelez kiemelkedő épületet itt a térkép. Már az 1785-ös térképen látjuk azonban a kápolnát és a hozzá tartozó épületegyüttest. A 19. századtól pedig gyakorlatilag folyamatosan követhetjük az épület és a környék változását egészen a 20. század második feléig. Sőt, az 1944-es légifotókon is jól kivehető az épületegyüttes.
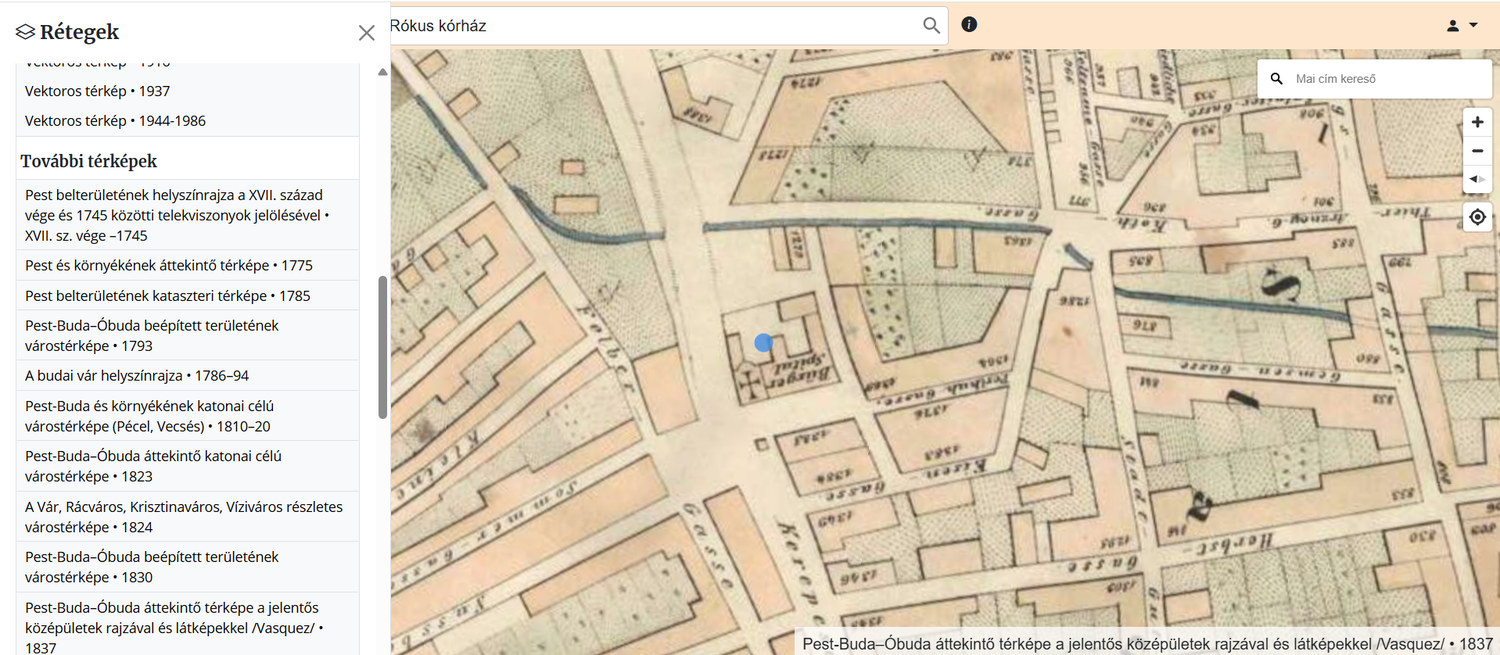
Tipp Amennyiben térben (3D-ben) szeretnénk
forgatni a térképeket, azt a Ctrl + egér/touchpad együttes
használatával tudjuk elérni.
5. Hogyan hivatkozzon erre a forrásra?
Ha magára a térképre szeretne hivatkozni, a térkép nevének megadásával teheti meg:
Rókus Kórház: Budapest nagyméretarányú kerületi térképsorozata (1944–1986), hrsz. 36434. Budapest Időgép. https://www.hungaricana.hu/hu/budapest-idogep/, elérve: ÉÉÉÉ. HH. NN.
Ha a helyrajzi számhoz tartozó forrásra szeretne hivatkozni, akkor a levéltári jelzettel hivatkozunk, majd jelezzük, hogy interneten elérhető forrást használtunk. Például a Rókus Kórház telekkönyvi betétekben szereplő irata esetén:
HU BFL – XV.37.c – 5688 – 36434. Az iratot digitalizált formában a Hungaricanán értem el, elérve: ÉÉÉÉ. HH. NN.
Esettanulmány
Esettanulmány Hogyan épült ki az ELTE BTK mai kampusza? Mikor szerezte meg az ELTE ezt a területet, és mi volt itt előtte?
A kutatásunkat kezdjük azzal, hogy a Mai cím keresőbe beírjuk a Múzeum körút 6. keresőkifejezést, hogy a térképen a megfelelő helyre navigáljon minket az alkalmazás. Alapértelmezetten az 1916-os vektoros térképet tölti be a rendszer; ezen máris láthatjuk, hogy a Természettudományi Intézetek kattintható ikonja van a területen. Ezzel majd később foglalkozunk. A Rétegek menüben a Történelmi térképek lenyitásával elérhetővé válik a 29 betöltött térkép; ezeket nézzük végig, hogy lássuk, hogyan változott a terület az évszázadok alatt.
Az 1745-ös és 1775-ös térképekről azt tudjuk meg, hogy a terület a pesti várfalon kívülre esett: az első térkép nem is ábrázolja a városfalon túli területet, míg a másodikon már látszanak épületek a városfalon kívül is – ez azonban csak áttekintő térkép, nem a pontos épületekre koncentrál. Azt már megtudhattuk, hogy a mai Vámház körút és Múzeum körút vonalában futott a középkori városfal (ennek részei a Múzeum körúti bérházak hátsó kertjében a mai napig állnak).
Ha tovább haladunk az időben, azt láthatjuk, hogy 1785-ben az Új Kapuval (Porta Nova) szemben nagy üres terület feküdt; 1793-ra azonban már nagyobb épületek vannak a telken, és kerteket találunk a területen. 1823-ra már botanikus kertet jelöl a térképünk. A 19. század első felében a terület két szélén beépítés jelenik meg (a mai Rákóczi út és a Bródy Sándor utcai oldalon), azonban a terület nagy részét végig botanikus kert foglalja el.
1867–1872 között eltűnik a botanikus kert, és a Bródy Sándor utcai tömbben megjelenik az Országház épülete, valamint az Astória felőli sarokban a Nemzeti Színház is (ez utóbbi már az 1854-es térképen is látható).
1882-re már a maihoz hasonló beépítést találunk a mai kampusz területén, azonban a „Kir. József-műegyetem” felirat fogad bennünket – hiszen a területen eredetileg a mai BME jogelődjének épült a jól ismert kampusz. A mai BME 1871–1934 között működött Királyi József Műegyetemként, és 1882-ben költözött a Múzeum körúti épületekbe; már ekkor szűkös volt azonban a helyszín az egyetem számára, ezért a mai történeti kampuszt a 20. század első éveiben vehette birtokba.
1908-ra már a M. kir. Egyetem épületeit jelöli a térkép, megjelenik a Természetrajzi Intézet. 1937-re a M. kir. Pázmány Péter Tudományegyetem bölcsészeti kara foglalja el a területet. A 20. század második felében a Bölcsész Kar ugyan elköltözött a kampuszról, és helyét a Természettudományi Kar vette át, azonban a Lágymányosi Kampusz megépülésével és a TTK kiköltözésével a BTK újra visszaköltözött a Múzeum körútra. Ez a váltás az alkalmazásban elérhető térképeken már nem látszik: a legkésőbbi (1944–1986-os) időmetszeten csak Egyetemként jelölik.
Láthatjuk, mennyi információt tudhattunk meg mindössze a térképek böngészése által – és még nem is néztük meg, milyen források kapcsolódnak a területhez tartozó helyrajzi számokhoz. Az adatokat bekapcsolva megjelennek a helyrajzi számok a felületen, és láthatjuk, hogy a 36558-as és 36559-es helyrajzi számok tartoznak a területhez (a 36558-ra vezet a fent említett Természettudományi Intézetek ikon is). Telekkönyvi betétek, közjegyzői okiratok és a budapesti cím- és lakásjegyzék adatbázisban vannak találatok, valamint építészeti tervek is kapcsolódnak a 36558-as számhoz (ez azonban digitálisan nem érhető el). Emellett néhány fényképet és egy képeslapot is találunk az épületekről.
Gyakorlati feladat
Feladat 1. feladat
Válassza ki az 1908-as térképet, és írja meg, mi állt a mai Múzeum körúton az East-West Business Center épületének helyén.
A Felsőerdősor utca 28. számon kik laktak? Mikor, kinek és mennyiért adják el az ingatlant?
Összesen hány tervrajz található az Időgépen a Magyar Nemzeti Múzeumról? Az
- találatnál ki volt az építész?
Kik laktak a Hadik Kávéház épületében 1954-ben? Soroljon fel legalább öt lakó nevét és foglalkozását! A feladat megoldásához használja az Időgépen keresztül elérhető cím- és lakásjegyzéket.
Önellenőrző kérdések
1. Mire jó a Budapest Időgép alkalmazás?
Válasz megjelenítése
Interaktív, szórakoztató módon nyújt betekintést Budapest múltjába: korabeli térképekre vetítve különböző levéltári forrásokat.
2. Mi az előnye a vektorizált térképeknek?
Válasz megjelenítése
A vektorizált térképeknél egy-egy adott objektum kereshető, és különböző többletinformációk, adatok rendelhetők hozzájuk.
3. Tudunk-e személynevekre is keresni a Budapest Időgépben?
Válasz megjelenítése
Igen – akkor kapunk találatot, ha az adott személy tulajdonosként szerepel egy helyrajzi számhoz tartozó lakcímjegyzékben.
4. Vannak-e fotók az adatbázisban szereplő épületekről?
Válasz megjelenítése
A belvárosból általában igen; a helyrajzi számhoz tartozó adatlapon külön blokkban jelennek meg a környékről készült fotók és képeslapok.
5. Hány vektorizált térkép érhető el az alkalmazásban?
Válasz megjelenítése
Hat, az 1937 és 1986 közötti időszakból. Összesen 29 térkép található az adatbázisban.
Összefoglalás
A fejezet feldolgozása és a feladatok, kérdések megoldása után láthatjuk, mennyi érdekes információt tudunk kinyerni egy első ránézésre „csak” szórakozásra való térképes megjelenítőből. Megtudhattuk, milyen különböző levéltári és könyvtári források kapcsolódhatnak egy-egy épülethez, amelyeknek köszönhetően megismerhetjük a város kiépülését, a bérházak lakóit és ügyes-bajos dolgaikat (közjegyzői iratok), sőt színházakra, fürdőkre és egyéb közintézményekre vonatkozó információkat is kereshetünk.
Kulcsfogalmak
geokódolás – Az a folyamat, amely során a történeti adatokhoz földrajzi koordinátákat rendelünk hozzá, lehetővé téve azok térbeli megjelenítését.
georeferált térkép – Olyan digitális vagy digitalizált térkép, amelynek minden pontja hozzá van rendelve a Föld egy valós koordináta-rendszeréhez (pl. EOV vagy WGS 84). A beszkennelt raszteres képet néhány jól azonosítható pont vagy objektum segítségével kell ráilleszteni egy georeferált alaptérképre.
mikrotörténet – Olyan történetírási irányzat és módszer, amely a makroszintű folyamatok helyett egy kisebb, jól behatárolható egységet – egyetlen eseményt, személyt, családot vagy közösséget – vizsgál nagy alapossággal.
térinformatika (GIS) – Interdiszciplináris tudományterület és informatikai eszközrendszer, amely a földrajzi helyhez kötött térbeli és leíró adatokat gyűjti, tárolja és elemzi.
vektorizált térkép – Olyan digitális térkép, amely pontokból, vonalakból és geometriai formákból épül fel; elemei kereshetők és szűrhetők.
várostörténet – A történettudomány és az urbanisztika interdiszciplináris ága, amely a városok keletkezését, fejlődését, térbeli szerkezetének változását, valamint a városi társadalom, gazdaság és igazgatás alakulását kutatja.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Kenyeres István: Budapest Időgép mint a történeti kutatás eszköze. Századok 157. (2023) 5. sz. 989–1003.
Ajánlott irodalom
- Kenyeres István: Budapest Főváros Levéltára stratégiai fejlesztési terve 2019–2023. Levéltári Szemle 69. (2019) 3. sz. 5–34.
- Kenyeres István: Budapest Főváros Levéltára szakmai fejlesztési koncepciója 2023–2028. Levéltári Szemle 73. (2023) 4. sz. 5–32.
Linkek és eszközök
- Budapest Időgép – https://www.hungaricana.hu/hu/budapest-idogep/ – elérve: 2026. 08. 09.
- Budapest Főváros Levéltára – https://bparchiv.hu/ – elérve: 2026. 08. 20.
- Fővárosi Szabó Ervin Könyvtár – https://www.fszek.hu – elérve: 2026. 08. 20.
Térbeli adatbázisok: amikor az adat egy helyhez tartozik
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 90 perc |
| Előfeltétel | Mi az adatbázis?, Budapest Időgép |
| Ajánlott utána | Kutatási eredmények vizualizálása – a térképes ábrázolásról |
| Verzió / dátum | v0.1 / 2026. augusztus |
Miről szól ez a fejezet?
Az eddigi adatbázisok többsége személyekről vagy iratokról szólt. Ez a fejezet arról a típusról, amelyben a rendező elv nem a személy és nem az irat, hanem a hely: egy cím, egy épület, egy helyrajzi szám, egy koordináta.
A térbeli adatbázis nem egyszerűen „adatbázis térképpel”. Más kérdéseket tesz megválaszolhatóvá, és más forráskritikai problémákat vet fel – erről szól a fejezet első fele. A második felében két konkrét felületet néz meg közelről: az ÁBTL Topotémáját és a Csillagos házak projektet.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- megkülönbözteti a térképet mint forrást a helyet mint adatmezőt, és megmondja, melyik kérdéshez melyik kell;
- elmagyarázza, mit jelent a georeferálás és a geokódolás, és mi a kettő között a különbség;
- megnevezi a helyhez kötés három tipikus hibaforrását (utcanév-változás, házszámváltozás, pontosság), és mindegyikre mond példát;
- eldönti egy térbeli adatbázisról, hogy pontadatot, területi adatot vagy útvonalat tartalmaz-e, és ennek megfelelően értelmezi a térképet;
- a Topotémában és a Csillagos házak felületén önállóan megkeres egy helyszínt, és értékeli a hozzá kapcsolt adatokat;
- megfogalmazza, milyen adatvédelmi és etikai kérdéseket vet fel a személyekhez kötött címadat közzététele.
Bevezetés
A történeti kutatásban a hely nem díszlet. Hogy egy család melyik utcában lakott, egy gyár melyik kerületben épült, egy megfigyelt lakás melyik házban volt – ezek nem illusztrációk a történethez, hanem magyarázó tényezők.
Figyelem A térkép a kutatásban kétféle szerepet játszhat, és a kettőt nem szabad összekeverni.
| Szerep | Mi ez? | Példa a kötetből |
|---|---|---|
| A térkép mint forrás | egy korabeli dokumentum, amely maga vizsgálandó: ki készítette, mit ábrázolt, mit hagyott ki | Arcanum Térképek katonai felmérései |
| A hely mint adatmező | egy adatbázis egyik mezője, amely helyet azonosít – és amely alapján a rekordok térképre vihetők | Budapest Időgép helyrajzi számai |
Az elsőnél a térképet olvassuk, a másodiknál a térkép eredmény: mi állítjuk elő az adatokból. Aki a saját, adatokból rajzolt térképét úgy kezeli, mint egy korabeli forrást, súlyos hibát követ el – a saját munkáját tekinti bizonyítéknak.
1. Két művelet, amit nem szabad összekeverni
Definíció Georeferálás és geokódolás
Georeferálás: egy digitalizált térkép pontjainak valós koordináta-rendszerhez illesztése. Ennek eredménye, hogy két különböző korú térkép egymásra fektethető. A kiindulópont egy kép.
Geokódolás: egy szöveges helymegjelölés – cím, településnév, helyrajzi szám – átalakítása koordinátává. Ennek eredménye, hogy egy táblázat sorai térképre vihetők. A kiindulópont egy adat.
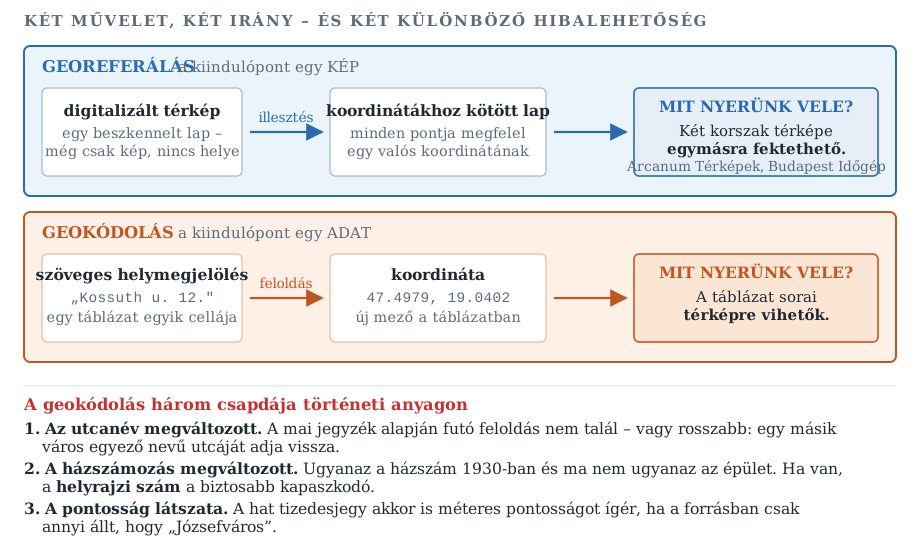
A kettő gyakran együtt jár: a Budapest Időgép georeferált – sőt hat térképe vektorizált – lapjain a helyrajzi számokhoz kapcsolt adatlapok jelennek meg. De a két művelet más hibákat termel, ezért érdemes szétválasztani.
Mélyebben A geokódolás három tipikus hibaforrása történeti anyagon
Az utcanév megváltozott. Egy 1930-as címjegyzékben szereplő utcanév ma más nevet visel – vagy több, egymást követő nevet is viselt közben. Ha a geokódolás mai utcanévjegyzék alapján fut, a történeti cím nem talál, vagy ami rosszabb: rossz helyre talál, mert egy másik város egyező nevű utcáját kapja meg.
A házszámozás megváltozott. Ez a ritkábban észrevett hiba. Egy utca számozását átrendezhették, telkeket összevonhattak vagy megoszthattak. Ugyanaz a házszám 1930-ban és ma nem ugyanaz az épület. Történeti anyagon ezért biztonságosabb a helyrajzi szám, mint a házszám – ha rendelkezésre áll.
A pontosság látszata. Egy koordináta hat tizedesjeggyel méteres pontosságot sugall, akkor is, ha a forrásban csak annyi állt, hogy „Józsefváros”. A térkép nem mutatja meg, mennyire bizonytalan a pont – a bizonytalanságot külön mezőben kell rögzíteni, ahogy azt az Adat a történettudományban fejezet is mondja.
Mindhárom hiba ugyanoda vezet: a térkép meggyőzőbb, mint az adat, amiből készült. Ez a vizualizáció alapvető etikai kérdése – lásd a vizualizációs fejezetet.
Tipp A helynévállapotok kérdése ugyanez nagyban. Az AdatbázisokOnline fejezetben látott példa – ahol ugyanaz a település négy különböző néven és két országban szerepelt – pontosan a geokódolás problémája: a szöveges helymegjelölés nem stabil azonosító. A megoldás ott is, itt is a helynévtár (lásd az Arcanum Kézikönyvtár helységnévtárait).
2. Milyen térbeli adat létezik?
Egy térbeli adatbázisról az első kérdés nem az, hogy „hol van”, hanem az, hogy milyen geometriájú adatot tartalmaz. Ez határozza meg, mit lehet vele csinálni – és mit nem.
| Típus | Mit rögzít? | Történeti példa | Mire jó? |
|---|---|---|---|
| pont | egy hely, egy koordinátával | egy épület, egy lakás, egy emléktábla | sűrűség, elhelyezkedés, közelség |
| terület (poligon) | egy határvonallal körülzárt terület | egy kerület, egy vármegye, egy plébánia | arányok, összehasonlítás, területi statisztika |
| útvonal (vonal) | egy nyomvonal | egy vasútvonal, egy felvonulás útja, egy menekülési útvonal | kapcsolat, mozgás, elérhetőség |
Figyelem Pontadatból nem lehet területi állítást tenni. Ha egy adatbázis száz épület címét tartalmazza egy kerületből, abból nem következik, hogy „a kerületben száz ilyen épület volt” – csak annyi, hogy száz ismert és azonosított épület van benne. A hiányzó pontok nem látszanak a térképen, és épp ez a veszélyes: a térkép a meglévő adatot mutatja, nem a valóságot.
Ez ugyanaz a reprezentativitási kérdés, amelyet a Mi a forrás? fejezet tárgyal – csak térben.
Mélyebben Miért nem elég a lista, ha van hely?
Ugyanaz az adat listaként és térképen más kérdéseket tesz feltehetővé.
A lista azt tudja megmutatni, hogy mi van benne: hány tétel, milyen kategóriákban, mikor. Rendezhető, szűrhető, számolható.
A térkép azt, hogy hogyan oszlik el: hol sűrűsödik, hol hiányzik, mi van egymás közelében. Olyan összefüggéseket tesz láthatóvá, amelyeket egy táblázatban végignézve senki nem venne észre – például hogy két, egymástól függetlenül gyűjtött adatsor ugyanazokban az utcákban torlódik.
De a térkép el is rejt. Ami sűrű, az feltűnő; ami szórt, az láthatatlan. A nagy pontsűrűség lehet valódi jelenség – és lehet az is, hogy ott dolgozott lelkesebben az adatgyűjtő. Mindig kérdezze meg: mi hiányzik erről a térképről, és miért?
Mélyebben Egy felület, amely maga válaszol erre a kérdésre: a Fortepan térképe
A Fortepan fotóarchívumnak van térképes felülete is: a helyhez köthető felvételek a helyükön jelennek meg. A felület megnyitásakor felugró ismertető négy mondatban elmondja mindazt, amit egy térbeli adatbázisról tudni kell.
Azt mondja, hogy a térképet „önkéntes szerkesztők munkájával építettük”; hogy a cél „elsősorban a budapesti fotóink” elérhetővé tétele volt; hogy „több tízezer fényképről van szó” – miközben a gyűjtemény egésze több mint kétszázezer kép; és hogy „természetesen lehetnek tévedéseink, ezeket igyekszünk javítani”. Végül hozzáteszi: aki „a teljes gyűjteményt szeretné látni”, az továbbra is a klasszikus felületen böngésszen.
Négy mondat, négy tanulság:
| A felület állítása | Amit ebből a kutató megtud |
|---|---|
| önkéntes szerkesztők építették | a geokódolás közösségi munka, nem intézményi adatrögzítés |
| elsősorban budapesti fotók | a sűrűség a szerkesztői figyelem eloszlása, nem a fényképezésé |
| több tízezer a kétszázezerből | a térkép a gyűjteménynek csak egy része |
| lehetnek tévedéseink | a pontok egy része bizonytalan – és ezt kimondják |
A Fortepan tehát pontosan azt teszi, amit ez a fejezet kér. Nem azt állítja, hogy a térképe a valóságot mutatja, hanem megmondja, mit mutat és mit nem. Egy adatbázis, amely kimondja a saját korlátait, használhatóbb, mint az, amelyik hallgat róluk – ugyanez a helyzet a Csillagos házaknál is.
3. Topotéma – a politikai rendőrség helyei a térképen
Az eszköz alapadatai
| Eszköz neve | Topotéma – Állambiztonsági helyeken |
| URL | https://topotema.hu/ (ismertető: https://www.abtl.hu/topotema/) |
| Üzemeltető | Állambiztonsági Szolgálatok Történeti Levéltára (ÁBTL) |
| Hozzáférés | Ingyenes, regisztráció nélkül használható |
| Regisztráció | Nem szükséges |
| Tartalomtípus | Épület-szócikkek, archív és mai fényképek, digitalizált iratrészletek, visszaemlékezés-részletek, filmek |
| Időkörök | 1944–1990 (a térkép időcsúszkájának határai) |
| Méret | „közel 100 helyszín”, több száz fotó, 7 helyszínhez kötődően 12 mozgókép (2026. 08.) |
A Topotéma nem hivatalos nyilvántartás és nem is szokásos értelemben vett levéltári adatbázis: az ÁBTL tudományos ismeretterjesztő honlapja, amely a magyar politikai rendőrség térhasználatát mutatja be. A rendezőelv itt tisztán a hely: minden rekord egy épület.
Ez a fejezet szempontjából azért érdekes, mert a Topotéma pontadatokat tartalmaz (lásd a 2. szakasz táblázatát), és mert a felület minden lényeges kérdést felvet, amelyet egy térbeli adatbázisnál fel kell tenni: mi került rá a térképre, milyen néven, és mi az, ami még nincs rajta.
3.1 Hat réteg – és ami közülük még nem készült el
A nyitóoldal bal oldalán hat tematikus réteg közül lehet választani. Ezek közül négy aktív, kettő halványan, kikapcsolva jelenik meg – ezek a tartalomfejlesztés következő szakaszai:
| Réteg | Állapot (2026. 08. 22.) | Mit fed le? |
|---|---|---|
| Az államvédelmi negyed | aktív | az 1945–1951 közötti Andrássy út 60. és környéke |
| Az Andrássy úton túl | aktív | a teljes 1944–1990 korszak fontosabb objektumai |
| Fontos elvtársak – védett objektumok | aktív | a pártvezetés személyi biztosításához kötődő helyszínek |
| Láthatatlan város – Nyíregyháza állambiztonsági helyei | aktív | egyetlen vidéki város teljes körű feltárása |
| Országos lefedettség | előkészületben | mind a 19 vármegye szervezetrendszere |
| Titkos villák | előkészületben | – |
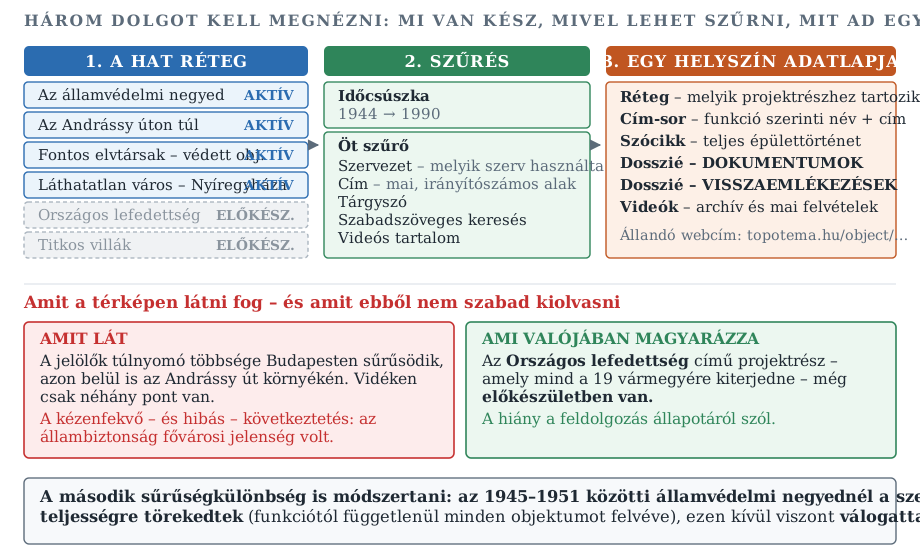
Figyelem A térkép a projekt állapotát mutatja, nem a múltat.
Aki ma megnyitja a Topotémát, azt látja, hogy a jelölők túlnyomó többsége Budapesten sűrűsödik, és az ország többi részén csak néhány pont van. Ebből könnyű – és hibás – volna arra következtetni, hogy az állambiztonság elsősorban fővárosi jelenség volt.
A valódi magyarázatot maga a honlap adja meg: az Országos lefedettség című projektrész, amely „mind a 19 vármegyére” kiterjedne, még előkészítés alatt áll. A vidéki pontok hiánya tehát a feldolgozás állapotáról szól, nem a politikai rendőrség földrajzáról.
Ez a fejezet legfontosabb gyakorlati tanulsága: egy térbeli adatbázis térképén mindig a projekt aktuális állapota látszik. Ezért kell minden térképnél megkeresni azt az oldalt, amely elmondja, mi készült már el.
3.2 Keresés: az időcsúszka és az öt szűrő
A térkép alatt egy időcsúszka húzódik 1944 és 1990 között; ezzel szűkíthető, mely helyszínek látszódjanak. Alatta öt szűrő található:
- Szervezet – melyik szerv használta az épületet (PRO, ÁVO, ÁVH, BM III. stb.);
- Cím – gépelés közben ajánlatot kínáló címlista;
- Tárgyszó – a szócikkekhez rendelt tematikus kulcsszavak;
- Szabadszöveges keresés – a szócikkek teljes szövegében;
- Videós tartalom – csak azok a helyszínek, amelyekhez film tartozik.
Mélyebben A címszűrő mai címeket ismer – és ez pontosan az 1. csapda.
Ha a Cím mezőbe beírja, hogy Andrássy,
a felület mai formájú, irányítószámos címeket ajánl föl: Budapest,
Andrássy út 60., 1062. Ez kényelmes – de érdemes végiggondolni, mit
jelent.
Az az épület a Topotéma által lefedett időszakban legalább három néven szerepelt a hivatalos iratokban. A helyszín saját adatlapján olvasható dokumentumcímek maguk őrzik ezt: az egyik irat „a Sztálin út 60.-ból a Jászai Mari térre való átköltözésről” szól, egy másik „A Magyar Ifjúság útja (Andrássy út) 60. számú épület alaprajzai és metszete (1957)” címet viseli.
Vagyis: a keresőfelület mai neve alatt korabeli iratok fekszenek, amelyekben a cím máshogy szerepel. Aki a korabeli utcanévre keres rá, nem talál semmit – nem azért, mert nincs adat, hanem mert az adatbázis a mai címet használja azonosítóként.
Ez a különbség nem hiba, hanem tervezői döntés: a mai cím stabil kapaszkodó a mai felhasználónak. De a kutatónak tudnia kell, hogy a hivatkozáshoz és a levéltári kereséshez a korabeli névalak kell.
3.3 Egy helyszín adatlapja
A térképen egy jelölőre kattintva rövid buborék jelenik meg – a
helyszín funkciója és mai címe –, benne a Részletek
hivatkozással. Ez vezet a tényleges adatlapra, amelynek állandó webcíme
van (topotema.hu/object/…), így hivatkozható.
Az adatlap felépítése:
| Rész | Mit tartalmaz? |
|---|---|
| Réteg megnevezése | melyik projektrészhez tartozik a helyszín |
| Cím-sor | a helyszín funkció szerinti megnevezése és a cím |
| Szócikk | több bekezdésnyi, hivatkozás nélküli, de szakértők által írt épülettörténet |
| Dosszié → DOKUMENTUMOK | digitalizált iratrészletek beszédes címekkel |
| Dosszié → VISSZAEMLÉKEZÉSEK | fogva tartottak és szemtanúk emlékezéseinek részletei |
| Videók | archív filmhíradó-részletek és mai épületbejárások |
Az Andrássy út 60. adatlapja
(topotema.hu/object/525) jó példa arra, mit tud egy ilyen
szócikk. Az épület történetét 1882-es felépülésétől követi: a 19.
századi magántulajdonoson át a szélsőjobboldali pártok 1937 utáni
beköltözéséig, a nyilas „Hűség Házáig”, majd 1945-től a politikai
nyomozószervekig, a későbbi külkereskedelmi vállalatokig és a 2002-ben
megnyílt Terror Háza Múzeumig. Vagyis a rekord nem az
„állambiztonsági korszakot” vágja ki a ház életéből, hanem a teljes
ingatlantörténetet adja.
Tipp A Dosszié rovat a legjobb belépő a levéltári anyaghoz. A dokumentumcímek („Az ÁVH vezetőjének parancsa…”, „Részlet Péter Gábor Rákosi Mátyásnak megküldött beszámolójából…”) megmutatják, milyen iratfajták keletkeztek egy ilyen helyszínről. Ez akkor is hasznos, ha Ön másik épületet kutat: a Topotémából megtanulható, mit érdemes keresni az ELP-ben.
Tipp Az Andrássy út 60. adatlapján két filmhíradó-részlet is szerepel (1945. október, Mafirt Krónika 10. és Heti Hírek 8.). Ha egy helyszínhez mozgókép tartozik, érdemes a Filmhíradók Online fejezetben leírt módon megkeresni a teljes híradószámot is: a Topotéma a részletet mutatja, a filmhíradó-adatbázis a kontextust.
3.4 Forráskritika: mi került be, és mi nem?
A Topotéma abban példaértékű, hogy maga mondja meg a válogatás elvét. Az ÁBTL ismertetője szerint az 1945 és 1951 közötti államvédelmi negyed esetében „teljességre törekedtünk”, tehát a környező utcák szatelit objektumait is felvették – „funkciótól függetlenül”, legyen szó irodáról, szálláshelyről, raktárról „vagy akár istállókról”. Ezen a téren és időszakon kívül, „Az Andrássy úton túl” menüben viszont „csak a fontosabb épületeket” vették számba: központi objektumokat, börtönöket, operatív technikai bázisokat, karhatalmi laktanyákat.
Figyelem Egy adatbázisnak két különböző sűrűsége is lehet. A Topotéma térképén az Andrássy út környéke azért olyan sűrű, mert ott teljességre törekedtek; a többi helyszín azért ritkább, mert ott válogattak. Aki a pontsűrűséget jelentésként olvassa, két különböző gyűjtési elvet hasonlít össze.
Ez a 2. szakasz „mi hiányzik a térképről?” kérdésének a legtisztább esete: itt a hiány nem véletlen, hanem dokumentált módszertani döntés – és éppen ezért tanulságos.
Két további megfigyelés, amely a felület használatakor magától adódik:
A tudás maga is ideiglenes. Az ismertető úgy fogalmaz, hogy az Andrássy út 60. környékén a politikai rendőrség „eddigi tudásunk szerint – még közel 70 ingatlant használt”. Ez a megszorítás nem szerénykedés: azt jelöli, hogy a helyszínlista a kutatás jelenlegi állásán alapul, és bővülhet.
Ugyanarról a felületről két leírás is létezik. Az ÁBTL honlapján olvasható ismertető szerint három menüpont „a közeljövőben várható” (köztük a Védett objektumok – fontos elvtársak és a Láthatatlan város: Nyíregyháza), miközben ezek a magán a Topotémán 2026 augusztusában már aktív rétegek. Az ismertető tehát a felületnél korábbi állapotot rögzít.
Mélyebben Miért nem kellemetlenség ez, hanem gyakorlat?
Két, ugyanattól az intézménytől származó oldal mást mond ugyanarról a szolgáltatásról – mert az egyik korábban készült, és nem frissült vele együtt. Ez a digitális források egyik legáltalánosabb jelensége.
Amit ilyenkor tenni kell: a felületet magát tekinteni elsődlegesnek, az ismertetőt másodlagosnak, és mindkettőnél feljegyezni a megtekintés dátumát. A hivatkozásban ezért szerepel mindig a letöltés napja – lásd a hivatkozásról szóló részt.
Az időbélyeg nem formaság: ez tesz különbséget aközött, hogy Ön téved, és aközött, hogy a forrás változott meg.
3.5 Adatvédelem: mikor személyes adat egy helyszín?
A Topotéma épületeket ír le, nem lakókat – az azonosított személyek pedig történeti szereplők (szervezetvezetők, fogva tartottak, akiknek visszaemlékezése nyomtatásban is megjelent). Ettől függetlenül érdemes végiggondolni a mintát: egy cím és egy funkció együtt személyes adattá válhat, ha az épületben ma is laknak, és a rekord olyan eseményt köt a címhez, amely azonosítható személyre mutat. Ez a mérlegelés a saját adatbázisépítésnél is kötelező – lásd az Adatkezelés és adatvédelem fejezetet.
4. Csillagos házak – egyetlen dátumra rögzített városi térkép
Figyelem Ez a szakasz a budapesti holokauszt történetének egy adatbázisát mutatja be. A felület módszertani példaként is tanulságos, de a benne szereplő címek mögött elhurcolt és meggyilkolt emberek élete áll. A fejezet ezért nem közöl a felületről személynevet és elérhetőséget, és arra kéri az olvasót, hogy a gyakorlati feladatok megoldásakor is ehhez tartsa magát.
Az eszköz alapadatai
| Eszköz neve | Csillagos házak 1944–2014 |
| URL | https://www.csillagoshazak.hu/ |
| Üzemeltető | OSA Archívum (Blinken OSA) |
| Hozzáférés | Ingyenes, regisztráció nélkül használható |
| Regisztráció | Csak közreműködéshez („Bejelentkezés”) |
| Tartalomtípus | Épületrekordok mai fényképpel, felhasználói visszaemlékezések („Reflexiók”), térképi rétegek |
| Időkör | Egyetlen időmetszet: 1944. június (a felület 2014-es megemlékezéssel kiegészülve) |
| Méret | 1445 ma is álló és 388 lebontott épület a térképen; a bevezető szöveg 1944 kijelölt házról tud (2026. 08.) |
| Licenc | CC BY-NC-ND 4.0 |
4.1 Miért éppen egyetlen dátum?
A legtöbb történeti adatbázis folyamatot rögzít: egy iratsorozatot, egy életutat, egy intézmény működését. A Csillagos házak nem ilyen. Egyetlen, jogszabállyal létrehozott állapotot rögzít – azt, hogy 1944 nyarán mely budapesti házakat jelölték ki kényszerlakhelyül.
A honlap saját összefoglalója szerint a zsidónak minősített magyarok 1944. április 5. óta voltak kötelesek sárga csillagot viselni; a június 16-i rendelet előírta, hogy a kijelölt házak bejárata fölé jól látható, „kanárisárga” Dávid-csillagot helyezzenek el; június 21. volt a beköltözés határideje. Az 1941-es népszámlálás alapján Budapest lakosságának mintegy 21%-a minősült zsidó származásúnak: 187 000 zsidó és további 35 000 kikeresztelkedett, akikre a rendelet vonatkozott – elméletileg 220 000 embert érintett az átköltöztetés.
Definíció Időmetszet (állapotfelvétel) mint adatmodell
Olyan adatbázis, amely nem a változást, hanem egyetlen időpont állapotát rögzíti. Előnye, hogy a rekordok egymással közvetlenül összevethetők, mert mindegyik ugyanarra a pillanatra vonatkozik. Hátránya, hogy a hogyan jutottunk ide és a mi lett utána kérdésre elvileg nem tud válaszolni – ahhoz másik forrás kell.
4.2 Mit tartalmaz, és honnan tudja?
A felület legfontosabb módszertani erénye, hogy a Házlista oldalán maga írja le, honnan származik a lista. Az adatbázis alapja a Fővárosi Közlöny 1944. június 16-i száma és a Budapesti Közlöny június 24-én megjelent, módosításokat közlő száma. Az utcák és házak beazonosításához a Fővárosi Szabó Ervin Könyvtár Budapest Gyűjteménye nyújtott segítséget.
Ez a néhány mondat pontosan az, amit egy adatbázistól el kell várni: melyik forrásból, milyen segédlettel, milyen döntések mentén készült a lista.
A térkép rétegei és a hozzájuk tartozó darabszámok (2026. augusztusi állapot):
| Réteg | Darab | Mit jelöl? |
|---|---|---|
| Ma is álló épület | 1445 | a kijelölt ház ma is áll |
| Lebontott épület | 388 | a ház már nem áll; a térképen a helye szerepel |
| Csillagos és „védett” ház | 98 | kettős státusz |
| „Védett ház” | 21 | semleges állam védelme alatt álló ház |
| Budapest határai 1944-ben | – | a korabeli közigazgatási határ |
| Gettó | – | az 1944 novemberében kijelölt terület |
| Június 21 | 113 | a 2014-es megemlékezéshez kapcsolódó helyszínek |
Feladat Számoljon utána – és ne rendezze el a különbséget.
A bevezető szöveg szerint „a Közlönyök alapján furcsamód épp 1944 csillagos házról tudunk, ezek közül ma kb. 1600 épület áll”. A térkép rétegei viszont 1445 álló és 388 lebontott épületet számolnak – ez együtt 1833.
Egyik szám sem hibás önmagában: a bevezető a projekt indulásakor, 2014-ben íródott, a rétegszámok pedig a jelenlegi adatállapotot tükrözik. A kérdés az, melyiket idézi Ön, és milyen dátummal. Írja le egy mondatban, melyik számot használná egy szemináriumi dolgozatban, és miért.
4.3 A kerületek: ahol a lista maga tanít közigazgatás-történetet
A Házlista mai kerületek szerint csoportosít, és a listából hiányzik a IV. kerület. Ennek oka nem az, hogy ott nem volt kijelölt ház, hanem az, hogy a lista készítői – ahogy maguk írják – „figyelembe vették a főváros 1945 utáni új közigazgatási beosztását”: a belvárosi 4. kerület önállósága megszűnt, és egybeolvadt az 5. kerülettel, a 13. kerület pedig kiegészült a korábbi 5. kerülethez tartozó Újlipótvárossal.
Vagyis a kerületszám 1944-ben és ma nem ugyanazt jelenti. Ugyanez igaz a város határaira is: a honlap külön rétegben rajzolja meg Budapest 1944-es határát, és a bevezető megjegyzi, hogy a mai Budapesthez tartozó Újpest, Pesterzsébet vagy Kispest lakóinak sorsa másként alakult, mint a fővárosiaké.
Figyelem A közigazgatási egység is változó azonosító. A geokódolás három csapdája mellé (utcanév, házszám, pontosság) ez a negyedik: a kerület, a község és a vármegye határai is mozognak. Egy „IV. kerületi” adat 1944-ben a Belvárost, ma Újpestet jelenti.
Ha egy adatbázis mai kerületek szerint rendez korabeli adatot, azt helyesen teszi – de csak akkor, ha meg is mondja. A Csillagos házak megmondja.
4.4 Egy ház adatlapja
A rekord szándékosan szűkszavú. A Házlistán minden tétel a mai címmel szerepel, alatta dőlt betűvel, zárójelben az 1944-es cím, ha az eltér – így:
| Mai cím | 1944-es cím a listában |
|---|---|
| Akácfa utca 43. (VII.) | (VII., Akáczfa utca 43.) |
| Asbóth utca 15. (VII.) | (VII., Éva utca 15.) |
| Bajcsy-Zsilinszky út 5. (VI.) | (VI., Vilmos császár út 5.) |
| Alkotás utca 6. (I.) | (XII., Gömbös Gyula út 6.) |
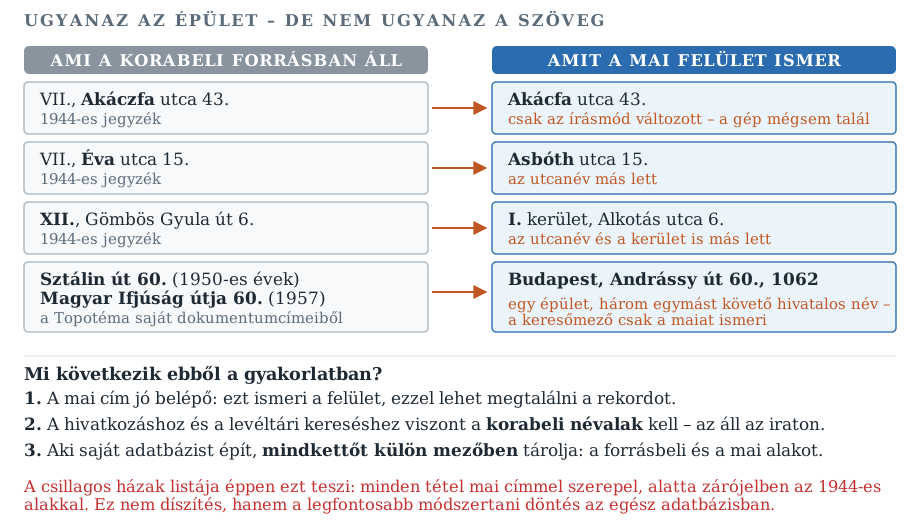
Ez a négy sor önmagában megtanítja a fejezet lényegét. Az első esetben csak az írásmód változott (Akáczfa → Akácfa) – egy szó szerinti egyeztetésre épülő geokódolás ezen már elhasal. A második és a harmadik esetben az utcanév más lett. A negyedikben a kerület is megváltozott, méghozzá a mai és a korabeli beosztás eltérése miatt.
A listában a piros színnel szedett címek nyílnak meg saját adatlappá; a fekete színnel szedettek nem – a honlap magyarázata szerint az elpusztult, lebontott ingatlanokról nem csatoltak fényképet.
Egy megnyíló adatlap tartalma:
- a mai cím kerülettel, alatta zárójelben az 1944-es cím;
- egy fénykép az épület mai állapotáról (utcaképi felvétel);
- ahol van, a 2014-es megemlékezés szervezőinek neve és elérhetősége;
- Reflexiók: dátumozott, névvel vállalt hozzászólások – köztük túlélők és leszármazottak visszaemlékezései arról, kik és milyen körülmények között költöztek az adott házba;
- felhívás: „Ismeri a ház történetét? Mesélje el!”
Mélyebben Egy nyitott adatbázis, amely a hiányát is vállalja
A Csillagos házak rekordja a Budapest Időgép adatlapjához képest feltűnően kevés: ott telekkönyvi betétek, lakásívek és tervrajzok kapcsolódnak egy helyrajzi számhoz, itt egy fénykép és néhány hozzászólás. Ez nem hiányosság, hanem a projekt természete: a Csillagos házak nyílt, közösségi gyűjtésre épülő megemlékezés, amely a rekordokat szándékosan hagyja üresen, hogy legyen hová írni.
A honlap készítői ezt ki is mondják: „Legnagyobb igyekezetünk ellenére a térkép még sok pontatlanságot tartalmaz” – az épületek korát sok esetben fénykép alapján kellett megbecsülniük, ezért „bizonyára több olyan ház is fölkerült a térképre, ami 1945 után épült”.
Egy adatbázis, amely kimondja a saját bizonytalanságát, megbízhatóbb, mint az, amelyik hallgat róla. A tudományos használatnak nem az az akadálya, hogy egy adat bizonytalan – hanem az, ha nem tudjuk, mennyire.
4.5 Mit tud ez az adatbázis, és mit nem?
Amire alkalmas. Megmutatja a kijelölt házak eloszlását a városban: hogy nem egy körülhatárolt negyedről van szó, hanem – ahogy a honlap fogalmaz – szétszórtan, az egész városban kijelölt épületekről. Ez az az állítás, amelyet listából nem lehetne kiolvasni, térképről viszont egy pillantással igen.
Amire nem alkalmas. Nem áldozati névsor, nem lakónyilvántartás, és nem mondja meg, hány ember költözött egy adott házba. A rekordok a házról szólnak, nem a lakóiról. Aki személyeket keres, más forrásokhoz kell forduljon – és ott a Családfakutatás fejezetben leírt adatvédelmi és etikai megfontolások lépnek életbe.
Ami a kettő között van. A Reflexiók rovat egyedi, névvel vállalt visszaemlékezéseket tartalmaz. Ezek forrásértékű szövegek – de nem levéltári iratok, hanem hetven évvel későbbi, önkéntesen közreadott emlékezések. Idézni lehet őket, de mindig azzal, ami valójában: kései, személyes emlékezésként, a közlés dátumával együtt.
Figyelem Adatvédelem: amit a felület közöl, és amit Ön továbbközöl, nem ugyanaz.
A honlap egyes adatlapjain magánszemélyek neve és e-mail-címe szerepel – 2014-es önkéntes szervezőké. Az, hogy egy adat egy nyilvános oldalon elérhető, nem jogosít fel a további közlésére: ez az az „elérhető ≠ szabadon felhasználható” megkülönböztetés, amelyet az Adatkezelés és adatvédelem fejezet tárgyal. A kötet ezért nem közöl innen nevet és elérhetőséget, és Öntől is ezt kéri.
A honlap tartalma egyébként CC BY-NC-ND 4.0 licenc alatt áll: nevezze meg a forrást, ne használja üzleti célra, és ne közöljön belőle átdolgozott változatot.
5. Gyakorlás: melyik csapda?
Nyolc helyzet. Mindegyikben valami félrevisz egy térbeli adatot – de nem ugyanaz. Döntse el, melyik hibaforrásról van szó.
Feladat Melyik csapda?
Döntse el minden helyzetről, melyik hibaforrásról van szó: utcanév vagy írásmód, házszámozás, közigazgatási beosztás, a pontosság látszata, vagy gyűjtőkör és feldolgozottság.
| # | A helyzet |
|---|---|
| 1 | Egy 1944-es jegyzékben VII., Akáczfa utca 43. áll; a mai geokódolás nem talál rá. |
| 2 | A korabeli irat Sztálin út 60.-at mond; a felület csak Andrássy út 60.-at ismer. |
| 3 | Egy 1944-es adat IV. kerületet jelöl; a kutató a mai IV. kerületben keresi. |
| 4 | Egy 1930-as címjegyzék házszáma óta az utcát átszámozták. |
| 5 | A forrás annyit mond: Terézváros; a táblázatba hat tizedesjegy kerül. |
| 6 | A Topotéma térképén vidéken alig van jelölő. |
| 7 | Egy csillagos ház nem szerepel a Topotémában. |
| 8 | A Fortepan térképén szinte csak budapesti fotók vannak. |
Esettanulmány
Esettanulmány Két cím, három adatbázis – és két hiányzó találat
A hely mint rendezőelv akkor mutatja meg az erejét, ha ugyanazt a címet több adatbázisban keressük meg. Az alábbi próbát a szerkesztő 2026. augusztus 22-én végezte el; ismételhető.
Első cím: Budapest, Andrássy út 60.
| Adatbázis | Találat | Mit ad? |
|---|---|---|
| Budapest Időgép | igen | georeferált térképeken az épület helye, kapcsolódó levéltári anyag |
| Topotéma | igen (object/525) |
teljes épülettörténet 1882-től, dokumentumok, visszaemlékezések, két filmhíradó-részlet |
| Csillagos házak | nem | a VI. kerületi listában Andrássy út 2., 8., 9., 10., 11., 12., 21., 32., 37., 40., 45., 77., 81., 84., 89. és 96. szerepel – 60. nem |
Második cím: Budapest, VII. kerület, Akácfa utca 43.
| Adatbázis | Találat | Mit ad? |
|---|---|---|
| Budapest Időgép | igen | a telek és környezete a különböző korú térképlapokon |
| Topotéma | nem | a helyszín nem szerepel az adatbázisban |
| Csillagos házak | igen | mai fénykép, az 1944-es cím (Akáczfa utca 43.), és egy túlélő 2014-es visszaemlékezése arról, hogy 1944 júniusában édesanyjával ide költöztek a nagyszülőkhöz |
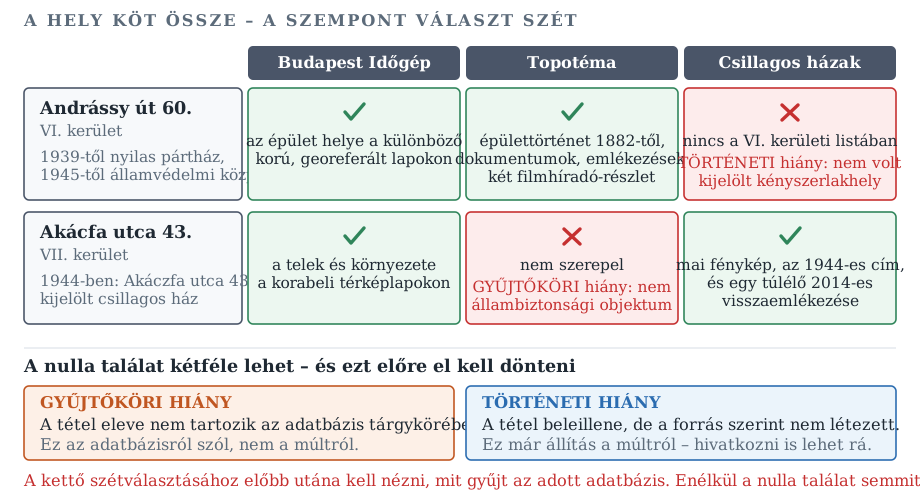
Mit tanít ez a próba?
1. A nulla találat nem semmi. Az Andrássy út 60. azért nincs a Csillagos házak listáján, mert 1944 júniusában nem kijelölt kényszerlakhely volt: a Topotéma szócikke szerint 1939-től a Nyilaskeresztes Párt „Hűség Háza” működött benne, ahol 1944 novembere és 1945 januárja között a pártszolgálatosok bántalmazták az elhurcoltakat. A két adatbázis nem ellentmond egymásnak – más szerepet rögzít ugyanarról a házról.
2. Az adatbázis hatóköre magyarázza a hiányt. Az Akácfa utca 43. azért nincs a Topotémában, mert az az állambiztonság által használt épületeket gyűjti. A hiány itt sem történeti állítás, hanem gyűjtőköri tény.
3. A hely köt össze, a szempont választ szét. Mindhárom adatbázis ugyanazt az azonosítót használja – egy budapesti címet –, de mindegyik más kérdésre gyűjt: a Budapest Időgép az ingatlan és a városszerkezet történetére, a Topotéma a politikai rendőrség térhasználatára, a Csillagos házak egyetlen 1944-es rendelet végrehajtására. Ezért lehet a hármat összekapcsolni, és ezért nem szabad összeolvasztani.
Tipp Ismételje meg egy saját címmel. A próba lényege nem a két konkrét cím, hanem a menete: (1) írja fel, mit gyűjt az adott adatbázis; (2) keressen rá a címre mai és – ha ismeri – korabeli névalakkal is; (3) a nulla találatnál mindig kérdezze meg, hogy gyűjtőköri vagy történeti hiányról van-e szó.
Gyakorlati feladatok
Feladat 1. feladat – Georeferálás vagy geokódolás? (10 perc)
Döntse el minden helyzetről, melyik műveletről van szó – és mi a művelet kiindulópontja.
- Egy 1873-as kataszteri térképet mai koordinátákhoz illesztenek.
- Egy 1200 soros táblázatban minden címhez koordinátát rendelnek.
- Két különböző korú várostérképet egymásra fektetnek.
- Egy anyakönyvi adatbázis településneveihez térképi pontot társítanak.
Feladat 2. feladat – Mi hiányzik a térképről? (20 perc, írásbeli)
Válasszon egy térképes megjelenítést a Budapest Időgépből vagy egy szabadon elérhető történeti térképalkalmazásból, és írja le:
- Milyen geometriájú adatot ábrázol (pont, terület, útvonal)?
- Hol sűrűsödnek a pontok, és mi lehet ennek az oka – valódi jelenség vagy az adatgyűjtés jellemzője?
- Melyik területről nincs adat, és miből következtet erre?
- Milyen állítást nem lehet erre a térképre alapozni?
Feladat 3. feladat – Egy cím három forrásban (30 perc)
Válasszon egy budapesti címet, amely Önt érdekli (például ahol lakik vagy tanul).
- Keresse meg a Budapest Időgépben: mi volt a helyén a 19. század végén, és mi az 1930-as években?
- Nézze meg, milyen forrásanyag kapcsolódik hozzá.
- Keresse meg ugyanezt a címet a Topotémában és a Csillagos házakban is. Ha valamelyikben nincs találat, döntse el: gyűjtőköri vagy történeti hiányról van-e szó?
- Írja le egy bekezdésben, mit tudott meg a helyről, amit korábban nem tudott – és mit nem tudott meg, pedig szeretett volna.
Feladat 4. feladat – Olvassa el a módszertani oldalt (20 perc, írásbeli)
Nyissa meg a Csillagos házak Házlista oldalát, és keresse meg azt a néhány bekezdést, amely a lista készítéséről szól.
- Melyik két forrásból állították össze a listát, és milyen keltezéssel?
- Milyen közigazgatási döntést hoztak a szerkesztők, és ez miért látszik meg a kerületek felsorolásán?
- Milyen bizonytalanságot ismernek be maguk a készítők?
- Fogalmazzon meg egy mondatot arról, miért növeli ez a beismerés az adatbázis tudományos használhatóságát – ahelyett, hogy csökkentené.
Feladat 5. feladat – Két leírás, egy felület (15 perc)
Nyissa meg egymás mellett a Topotéma saját felületét
(topotema.hu) és az ÁBTL róla szóló ismertetőjét
(abtl.hu/topotema).
- Sorolja fel, mely rétegek aktívak a felületen, és melyek jelennek meg kikapcsolva.
- Vesse össze ezt azzal, amit az ismertető „a közeljövőben várható” menüpontokként sorol fel. Talál eltérést?
- Melyiket tekintené elsődlegesnek egy hivatkozásban, és miért?
- Írja meg a saját hivatkozását a felületre, a megtekintés dátumával együtt.
Önellenőrző kérdések
1. Mi a különbség a georeferálás és a geokódolás között?
Válasz megjelenítése
A georeferálás kiindulópontja egy kép: egy digitalizált térkép pontjait illesztjük valós koordináta-rendszerhez, hogy a lapok egymásra fektethetők legyenek. A geokódolás kiindulópontja egy adat: egy szöveges helymegjelölést (címet, településnevet, helyrajzi számot) alakítunk koordinátává, hogy egy táblázat sorai térképre vihetők legyenek.
2. Miért biztonságosabb történeti anyagon a helyrajzi szám, mint a házszám?
Válasz megjelenítése
Mert a házszámozást átrendezhették, telkeket vonhattak össze vagy oszthattak meg: ugyanaz a házszám 1930-ban és ma nem feltétlenül ugyanaz az épület. A helyrajzi szám stabilabb azonosító – ha rendelkezésre áll.
3. Mit jelent a „pontosság látszata” a geokódolásban?
Válasz megjelenítése
Azt, hogy a koordináta több tizedesjeggyel méteres pontosságot sugall akkor is, ha a forrásban csak egy kerület vagy egy településnév szerepelt. A térkép nem mutatja a bizonytalanságot – ezért azt külön mezőben kell rögzíteni.
4. Miért nem lehet pontadatból területi állítást tenni?
Válasz megjelenítése
Mert a pontok csak az ismert és azonosított eseteket jelölik. Ami kimaradt az adatgyűjtésből, az nem látszik a térképen – a térkép a meglévő adatot mutatja, nem a valóságot. Ez a reprezentativitás kérdése, térben.
5. Mit rejt el egy térkép, amit egy lista nem?
Válasz megjelenítése
A szórt adatot. Ami sűrű, az feltűnő; ami szórt, az láthatatlan. Emellett a sűrűség oka is elrejtőzik: lehet valódi jelenség, de lehet az adatgyűjtés egyenetlensége is.
6. Miért sűrűbb a Topotéma térképe az Andrássy út környékén, mint máshol?
Válasz megjelenítése
Mert ott más gyűjtési elv érvényesült. Az 1945 és 1951 közötti államvédelmi negyed esetében a szerkesztők teljességre törekedtek, funkciótól függetlenül minden objektumot felvéve; ezen kívül viszont csak a fontosabb épületeket vették számba. A pontsűrűség tehát két különböző módszertani döntést tükröz, nem két különböző történeti valóságot. Ehhez járul, hogy az országos lefedettséget adó projektrész még előkészületben van.
7. Miért hiányzik a IV. kerület a Csillagos házak listájából?
Válasz megjelenítése
Mert a lista a mai kerületbeosztást követi. Az 1944-es belvárosi IV. kerület önállósága 1945 után megszűnt, és egybeolvadt az V. kerülettel – a mai IV. kerület pedig egészen máshol, Újpesten van. A kerületszám tehát maga is változó azonosító, akárcsak az utcanév és a házszám.
8. Mit jelent az, hogy egy adatbázisból hiányzó találat lehet gyűjtőköri és lehet történeti is?
Válasz megjelenítése
Gyűjtőköri a hiány, ha az adott tétel eleve nem tartozik az adatbázis tárgykörébe – egy csillagos ház nincs okkal a Topotémában. Történeti a hiány, ha a tétel a gyűjtőkörbe tartozna, de a forrás szerint nem létezett ilyen: az Andrássy út 60. azért nincs a Csillagos házak listáján, mert 1944 júniusában nem jelölték ki kényszerlakhelynek. A kettőt csak úgy lehet szétválasztani, ha előbb utánanézünk, mit gyűjt az adott adatbázis.
Összefoglalás
A térbeli adatbázisban a rendezőelv a hely: egy cím, egy épület, egy helyrajzi szám. Ez nem díszlet, hanem magyarázó tényező – és új kérdéseket tesz megválaszolhatóvá.
Két műveletet kell szétválasztani. A georeferálás egy digitalizált térképet illeszt koordináta-rendszerhez; a geokódolás egy szöveges helymegjelölést alakít koordinátává. A második három tipikus hibát termel történeti anyagon: megváltozott utcanevek, megváltozott házszámozás, és a pontosság látszata.
Az adat geometriája – pont, terület vagy útvonal – meghatározza, mit lehet vele állítani. Pontadatból nem következik területi állítás, és a térkép mindig a meglévő adatot mutatja, nem a valóságot.
A két bemutatott felület ugyanezt tanítja élesben. A Topotéma az ÁBTL tudományos ismeretterjesztő honlapja: közel száz épülethez ad szócikket, dokumentumot, visszaemlékezést és filmet. Térképe azért látszik budapestinek, mert az országos lefedettséget adó projektrész még előkészületben van – a térkép a projekt állapotát mutatja, nem a múltat. A Csillagos házak egyetlen időmetszetet rögzít: az 1944. júniusi kényszerlakhely-kijelölést, két közlöny alapján, mai kerületbeosztás szerint, a bizonytalanságok nyílt beismerésével.
Végül a legfontosabb: a hiányzó találat is információ. Az esettanulmány két címe azt mutatja, hogy ugyanaz a cím különböző adatbázisokban különböző okokból lehet jelen vagy hiányozhat – és a kettő között a gyűjtőkör ismerete tesz különbséget.
Kulcsfogalmak
georeferálás – Digitalizált térkép pontjainak valós koordináta-rendszerhez illesztése; kiindulópontja egy kép.
geokódolás – Szöveges helymegjelölés (cím, településnév, helyrajzi szám) átalakítása koordinátává; kiindulópontja egy adat.
vektorizálás – Térképi tartalom (utcavonalak, telekhatárok) rajzi elemekké alakítása, amelynek révén a térkép szövege és geometriája kereshetővé válik.
pontadat – Egyetlen koordinátával azonosított hely az adatbázisban; sűrűség és elhelyezkedés vizsgálatára jó, területi állításra nem.
helyrajzi szám – Az ingatlan hivatalos, közigazgatási azonosítója; történeti anyagon stabilabb hivatkozási alap, mint a házszám.
a pontosság látszata – Az a jelenség, amikor a koordináta több tizedesjeggyel méteres pontosságot sugall, holott a forrásban csak nagyvonalú helymegjelölés szerepelt.
időmetszet (állapotfelvétel) – Olyan adatmodell, amely nem folyamatot, hanem egyetlen időpont állapotát rögzíti; rekordjai közvetlenül összevethetők, de a változásról nem tud beszámolni.
gyűjtőkör – Annak meghatározása, hogy egy adatbázis mit vesz fel és mit nem; ismerete nélkül egy hiányzó találat nem értelmezhető.
csillagos ház – Az 1944. június 16-i fővárosi rendelettel kényszerlakhelyül kijelölt budapesti épület, amelynek bejárata fölé sárga Dávid-csillagot kellett elhelyezni; a beköltözés határideje 1944. június 21. volt.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Budapest Időgép – https://maps.hungaricana.hu/hu/BudapestTimeMachine/ – lásd a Budapest Időgép fejezetet.
- Fortepan Térkép – a felület megnyitáskor felugró saját ismertetője. https://fortepan.hu/hu/map/ (elérve: 2026. 08. 22.)
- Topotéma – Állambiztonsági helyeken. Állambiztonsági Szolgálatok Történeti Levéltára. https://topotema.hu/ (elérve: 2026. 08. 22.)
- Topotéma – Állambiztonsági helyeken. Az ÁBTL ismertetője. https://www.abtl.hu/topotema/ (elérve: 2026. 08. 22.)
- Topotéma: Államvédelmi központ, vizsgálati szervek, kémelhárítás, pincefogdák. Andrássy út 60. https://topotema.hu/object/525 (elérve: 2026. 08. 22.)
- Csillagos házak 1944–2014. OSA Archívum. https://www.csillagoshazak.hu/ (elérve: 2026. 08. 22.) – CC BY-NC-ND 4.0
- Csillagos házak: Mi ez? és Házlista (a lista forrásáról és készítéséről). https://www.csillagoshazak.hu/hazak (elérve: 2026. 08. 22.)
Ajánlott irodalom
Linkek és eszközök
| Név | URL | Mire jó? |
|---|---|---|
| Topotéma (ÁBTL) | https://topotema.hu/ | állambiztonsági helyszínek épület-adatbázisa |
| Topotéma – ismertető | https://www.abtl.hu/topotema/ | az ÁBTL leírása a honlapról |
| Csillagos házak | https://www.csillagoshazak.hu/ | a budapesti csillagos házak térbeli adatbázisa |
| Budapest Időgép | https://maps.hungaricana.hu/hu/BudapestTimeMachine/ | georeferált és vektorizált várostérképek adatlapokkal |
| Arcanum Térképek | https://maps.arcanum.com/hu/ | georeferált katonai felmérések |
| Fortepan Térkép | https://fortepan.hu/hu/map/ | önkéntesek által helyhez kötött fényképek térképen |
Állambiztonsági archontológia
| Szerző(k) | Kulcsár Anna |
| Becsült feldolgozási idő | 60 perc |
| Előfeltétel | Mi a forrás?, LIR |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszköz alapadatai
| Eszköz neve | Állambiztonsági archontológia |
| URL | https://www.abtl.hu/ords/archontologia/f?p=108:1 |
| Üzemeltető | Állambiztonsági Szolgálatok Történeti Levéltára (ÁBTL) |
| Hozzáférés | Ingyenes, regisztráció nem szükséges |
| Regisztráció | Nem szükséges |
| Tartalomtípus | Életrajzi adatok, portréfotók, szervezeti adatlapok |
| Időkörök | 20. század (legteljesebben 1962–1990) |
Miről szól ez a fejezet?
Ebben a fejezetben az ÁBTL Állambiztonsági archontológia adatbázisáról lesz szó. Az állambiztonsági szervezet 1962 utáni vezetőinek pályaképét mutatja be a rendszer; adatait elsősorban mikrotörténeti kutatásokhoz, családtörténethez, egy-egy személy hivatali pályafutásának vizsgálatához és szervtörténeti kutatásokhoz lehet használni.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- önállóan futtat egyszerű és szűrt kereséseket az adatbázisban;
- önállóan böngészik az életrajzok között, és megtalálja egy szervezeti egység vezetőit;
- önállóan végez szervtörténeti vagy családtörténeti kutatást az adatbázis anyagában;
- megindokolja, miért nyilvános adat egyes állambiztonsági alkalmazottak neve és születési adata, és megnevezi a vonatkozó jogszabályt;
- forráskritikai szempontból értékeli az önéletrajzokból származó életrajzi adatokat, és megnevezi a kontrollforrás fogalmát.
Bevezetés
Tegyük fel, hogy egy szemináriumi dolgozat keretében a Belügyminisztérium III. Főcsoportfőnökségének felépítésével és vezetőivel foglalkozik. Kezdjük a III. Főcsoportfőnökség szervezeti felépítésével: az Állambiztonsági archontológia adatbázisban nemcsak személyek pályaképeiben van lehetőség keresésre, hanem magának a szervezetnek a felépítését és a szervezeti egységeket is vizsgálni lehet.
A fenti példa esetében az összetett kereső funkcióval lekérdezhetők a Belügyminisztérium szervezeti egységei 1962 és 1990 között. Megismerhetjük a Belügyminisztérium alárendelt szervezeti egységeit, közöttük a BM III. Főcsoportfőnökséget, amelyre kattintva a szervezeti egységet bemutató adatlapra juthatunk. Az alárendelt szervezeti egységek között listázva megtalálhatjuk az összes szervezeti egységet, sőt ezek időbeli átalakulásai (névváltoztatásai) is nyomon követhetők. Itt találhatjuk például a III/III. Csoportfőnökséget, amely a belső reakció elhárításán dolgozott.
Minden szervezeti egység adatlapján megtaláljuk az adatbázisban hozzárendelt tisztségviselőket: csoportfőnököket, főcsoportfőnököket.
Az adatbázisból könnyen megállapíthatjuk, hogy például a BM III/III. Csoportfőnöksége 1962 és 1990 között működött, négy különálló osztályra tagozódott, vezetője (csoportfőnöke) 1962 és 1970 között Baranyai György volt. Egy szinttel feljebb lépve a III. Főcsoportfőnökségről megtudhatjuk, hogy szintén 1962 és 1990 között működött, Titkárságra, öt Csoportfőnökségre és kilenc Osztályra tagolódott. Vezetői 1962-től 1989-ig végigkövethetők: Galambos József, Rácz Sándor, Rácz Pál, Karasz Lajos, Földesi Jenő és Harangozó Szilveszter.
Ezekről a szereplőkről további életrajzi adatokat ismerhetünk meg, ha rákattintunk az adatlapjukra. Így például megismerhetjük a személyes adataikat (anyja neve, születési adatok), a végzettségeiket, beosztásaikat és a pályájuk során elért rendfokozatokat is. Végül egy, a történeti kutatás szempontjából nagyon fontos felsorolást kapunk azokról a forrásokról, amelyeket az archontológia összeállítása során felhasznált a levéltár. Itt fontos megjegyezni, hogy nem pusztán ÁBTL-es forrásokat találunk, hanem az MNL és a BFL gyűjteményéből származókat is.
1. Mi az Állambiztonsági archontológia?
Az Állambiztonsági archontológia adatbázist az ÁBTL üzemelteti és tartja fenn 2009 óta. Megvalósítására a Nemzeti Kulturális Alap Levéltári Kollégiumának támogatásával került sor. Ugyan a levéltár jogelődje, a Történeti Hivatal már 1997-ben megalakult, az állambiztonsági alkalmazottak személyi anyagai csak 2003 és 2006 között érkeztek be a levéltárba, igen rendezetlen állapotban. Többek között ezeknek az anyagoknak a feldolgozása és kutathatóvá tétele hívta életre az archontológiai adatbázist.
A feldolgozás nagyon aprólékos és hosszadalmas folyamat, melynek oka, hogy az adatbetöltést megelőzi az anyaggyűjtés, az előtanulmány készítése és az életpályák összeállítása. Ehhez a munkához felhasználták az ÁBTL-ben őrzött személyi gyűjtők anyagait és különböző állományparancsokat, a PRO, ÁVO, BM ÁVH és ÁVH iratait. Emellett az MNL OL-ban található MSZMP Politikai Bizottságának jegyzőkönyveit, a Belügyminisztérium iratait, az MDP Központi Szervei – Politikai Bizottság jegyzőkönyveit, valamint a BFL anyagából az MDP és MSZMP Budapesti Bizottságának iratait vizsgálták át.
Az adatbázisban jelenleg csak az 1962 utáni főcsoportfőnökségi rendszer időszakát dolgozta fel legteljesebben a levéltár. A személyi adatlapok csak az állambiztonsági szervezet vezetőinek pályaképére terjednek ki, ezért az önálló osztályok vezetőinél alacsonyabb beosztású állambiztonsági tisztek életrajzai nem találhatók meg az adatbázisban.
Figyelem A személyes és szenzitív adatokat törvények védik, ezek megismerése különböző időkorlátokhoz kötött, tehát nem nyilvános információk. Ezzel szemben a hivatásos alkalmazottak, a közszereplő operatív kapcsolatok, illetve a közszereplő hálózati személyek azonosításához szükséges adatai (név, anyja neve, születési idő és hely) nyilvános adatok.50 Ez tette lehetővé, hogy ebből az állományból az interneten bárki által szabadon kutatható archontológiai adatbázist hozzon létre a levéltár.
Az adatbázisban kereshető szervek esetében az Államvédelmi Hatóság (1949–1953) és annak szervezeti egységei, a BM ÁVH (1948–1949) és annak osztályai, valamint a Belügyminisztérium szervezeti felépítése kutatható. Ez utóbbi esetében ugyan már az 1950–1953-as időszakból is rendelkezik valamennyi adattal az adatbázis, legteljesebben az 1962–1990-es időszak vizsgálható.
Definíció Fogalom: archontológia
Az archontológia a történelem azon segédtudománya, amely a különböző tisztségviselők, hivatalnokok, uralkodók, egyházi vezetők hivatali névsorának összeállításával és életpályájuk kutatásával foglalkozik.
Definíció Fogalom: hivatásos alkalmazott
Az a személy, aki az állambiztonsági szervezetekkel hivatásos szolgálati viszonyban állt, ideértve a „titkos” és a „szigorúan titkos” állományú munkatársakat is.51
Definíció Fogalom: hálózati személy
Az a személy, aki az állambiztonsági szervezetek számára titokban, fedéssel és fedőnévvel jelentést adott, vagy ilyen jellegű beszervezési nyilatkozatot írt alá, vagy ilyen tevékenységért előnyben részesült.52
Definíció Fogalom: operatív kapcsolat
Az a személy, akit az állambiztonsági szervezetek „társadalmi kapcsolatként” vagy „alkalmi kapcsolatként” tartottak nyilván.53
2. A felület felépítése
Az archontológiai adatbázis bárki számára szabadon elérhető az interneten, azonban a publikálása óta eltelt közel húsz év folyamán a felhasználói felület meglehetősen elavulttá vált. A főoldalon egy tájékoztató jellegű szövegblokk kapott helyet, amely az adatbázisról tartalmaz hasznos információkat.
A bal felső sarokban az „Archontológia” címszó a főoldalra vezető link, míg a jobb felső sarokban az ÁBTL régi logója szerepel, amely az ÁBTL honlapjára (https://www.abtl.hu/) vezet. A másik külső link a menüsor alatt található NKA-logó, amely a Nemzeti Kulturális Alap (https://www.nka.hu/) honlapjára navigál.
Az oldal bal szélén kapott helyet a menüsor és az egyszerű keresősáv. A menüpontok közül a Bevezető szintén a főoldalon elhelyezett tájékoztató szövegre mutat. Az Életrajzok menüpont az adatbázisban szereplő személyek táblázatos listájához vezet, ahol ábécésorrendben lehet böngészni a találatokat. A névre kattintva érhetjük el a személy adatlapját, amelyen az életrajzi adatok mellett a pályakép is kirajzolódik előttünk. Végül az Impresszum menüpontban a projektben részt vevő levéltári, illetve fejlesztő kollégák felsorolását érhetjük el.
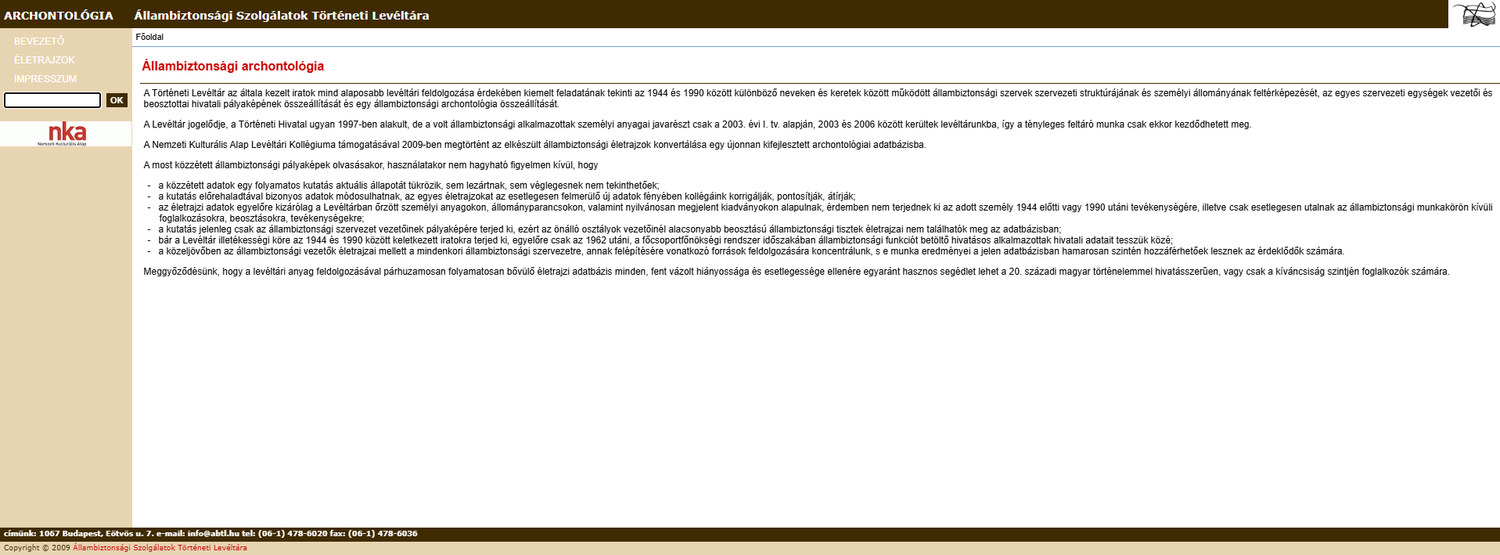
3. Keresés és böngészés
A főoldalon egyszerű keresőmező található, amely minden szöveges mezőben keres, így indíthatunk keresést nevekre, szervezetiegység-nevekre, évszámokra és kulcsszavakra egyaránt; ez mindenképpen táblázatos találati listát eredményez.
Tipp A főoldalon a keresőmező melletti OK gombra kattintva, vagy egy üres keresést elindítva lehet elérni a keresőoldalt. Itt lehet egyszerű, illetve összetett kereséseket lefolytatni.
3.1 Egyszerű keresés
A keresőoldalt elérve lehetőségünk van egyszerű, kulcsszavas keresést indítani. A főoldal keresőmezőjéhez hasonlóan itt is indíthatunk keresést nevekre, szervezetiegység-nevekre, évszámokra, kulcsszavakra egyaránt, valamint a keresőmező alatt ábécé szerint böngészhetünk is az adatok között.
Figyelem Az ábécé szerinti böngészés csak a találatok megnevezésében keres. Így például megtaláljuk a „B” betűnél Bogye Jánost és a Belügyminisztériumot is, de azt, hogy valaki „beosztott” volt, ily módon nem.
A kulcsszavas keresőben – mivel nemcsak a megnevezésben történik a keresés, hanem a kapcsolt metaadatokban is – a belügy keresőkifejezésre a találati listában megjelenik a Belügyminisztérium, de mellette például Németi József is, aki a Belügyminisztériumban miniszterhelyettesként dolgozott 1964 és 1970 között.
A keresés a Keresés gombra kattintva és Enterrel is elindul; az Új keresés gomb pedig törli a keresőkifejezésünket. A találatok számát a találati lista jobb felső sarkában jeleníti meg a rendszer, míg az oldalak közötti ugrásra a találati lista jobb alsó sarkában van lehetőség. A megjelenített találatok száma alapértelmezetten 15 darab, ennek változtatására nincs lehetőség.
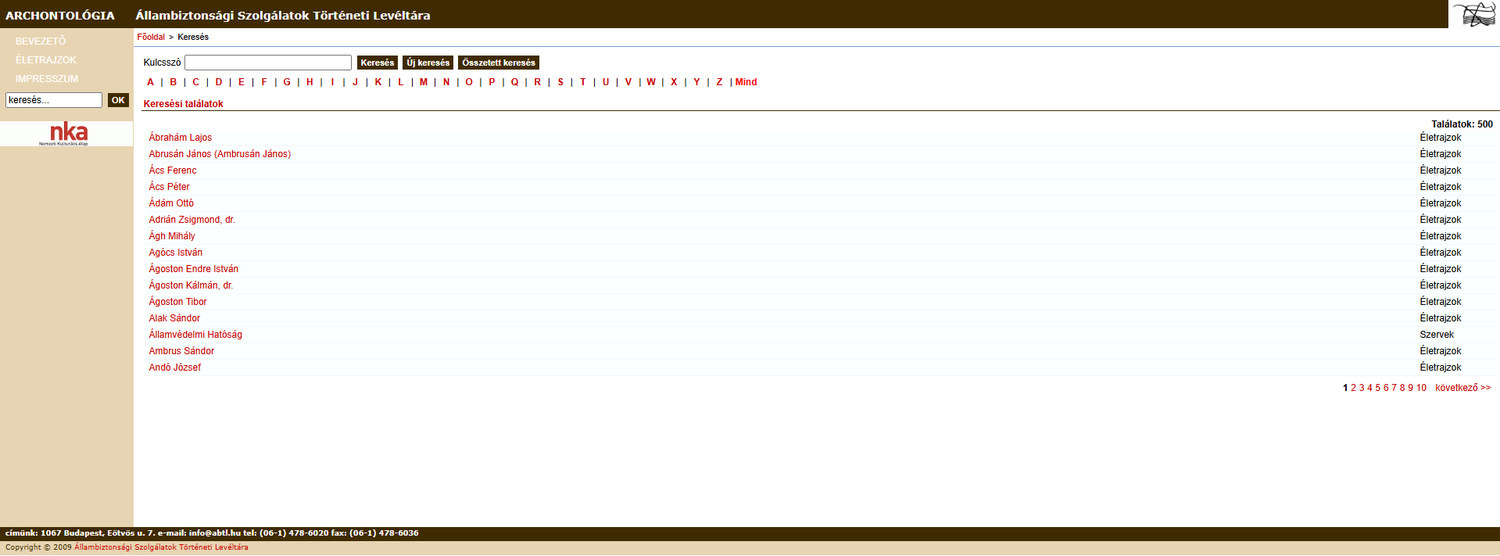
3.2 Szűrők és összetett keresés
A keresőoldalon a keresőmező melletti Összetett keresés gombra kattintva van lehetőségünk komplexebb keresések futtatására. Itt választhatunk, hogy Életrajzok, Szervek vagy Szervezeti egységek között szeretnénk keresni – egyszerre azonban csak az egyikben (multiselectre nincs lehetőség). A választásunk függvényében változnak a vonatkozó keresőmezők is. Tovább pontosíthatjuk a keresést az alábbi jelölőnégyzetek bepipálásával: Csak teljes szó, Kis- és nagybetű különböző, illetve Ékezetet vegye figyelembe.
Figyelem Az összetett keresőben a keresés
csak a Keresés gombbal indul el, és az ismert
helyettesítő karakterek (*, ?) nem
működnek. A találatok utólagos szűrésére nincs lehetőség – csak
további keresőkifejezések megadásával –, mert fazetták nincsenek az
adatbázisban.
Életrajzok
Az életrajzokra való keresést választva olyan metaadatokban tudunk keresni, mint a személy természetes azonosító adatai (anyja neve, születés ideje és helye, elhalálozás ideje és helye), a pályaképre vonatkozó információk (beosztás, végzettség), valamint a források. Az Egyéb keresőmezőben olyan többletinformációkra tudunk keresni, mint például a nyelvtudás vagy a párttagság kezdete.
A rendfokozat, végzettség, szerv/szervezeti egység és beosztás keresők lenyíló listás mezők, amelyek az adatbázisban szereplő adatokat ajánlják fel választásra, de automatikus kiegészítés (autocomplete) nem érhető el. A felugró ablakban lehetőség van végiggörgetni a lehetőségeket, és keresni is a metaadatok között. A keresőmezőket tartalmazó panel alatt itt is megtaláljuk az ábécé szerinti böngészés lehetőségét.
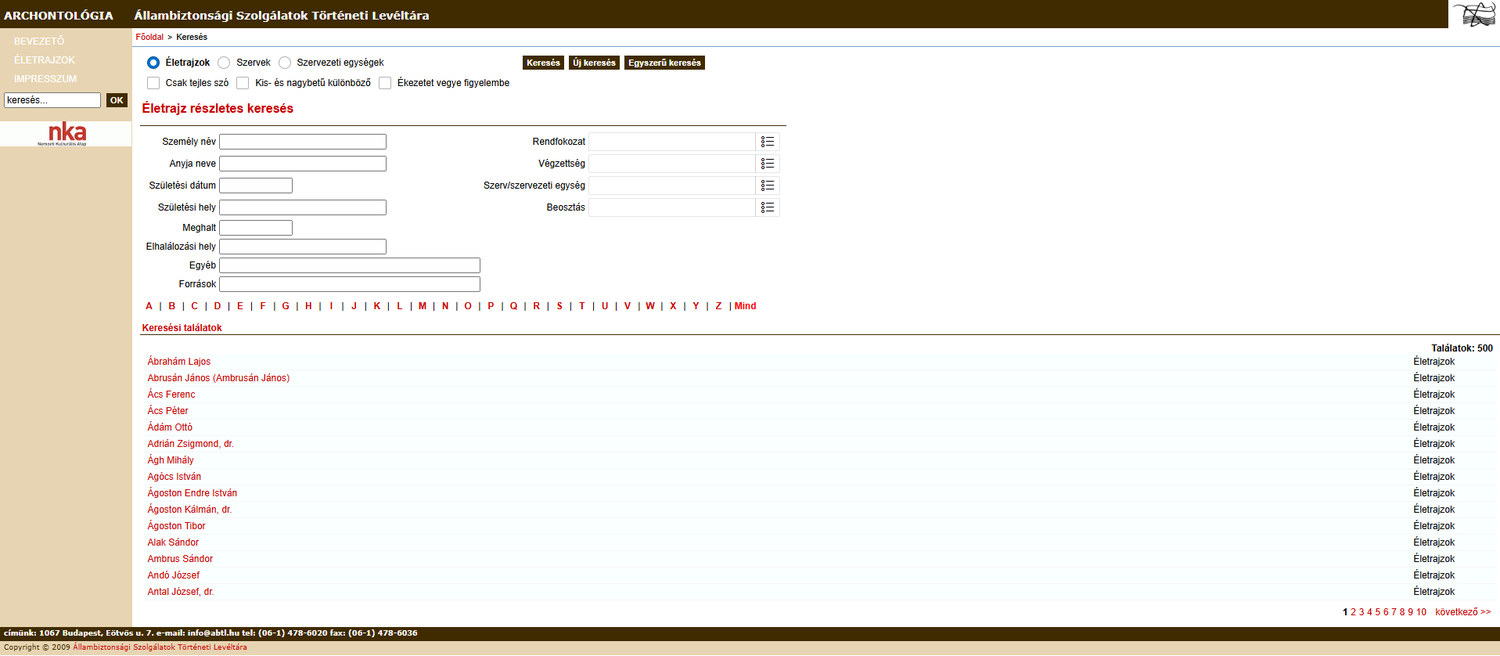
Szervek
A szervek keresőt választva az alábbi metaadatokban tudunk keresni: megnevezés, rövid név, típus, alapítva, megszűnt, leírás, forrás és egyéb. A típuskereső legördülő listás mező, amely azonban nem mindig ad találatot.
Már a keresőoldalra ugráskor megjeleníti számunkra a rendszer azt a három szervet, amelyet tartalmaz, így maga a keresőfelület kissé okafogyott. A keresőmezőket tartalmazó panel alatt itt is megtaláljuk az ábécé szerinti böngészés lehetőségét, azonban erre kattintva a teljes adatbázisban keres, tehát ismét személyneveket is kapunk.
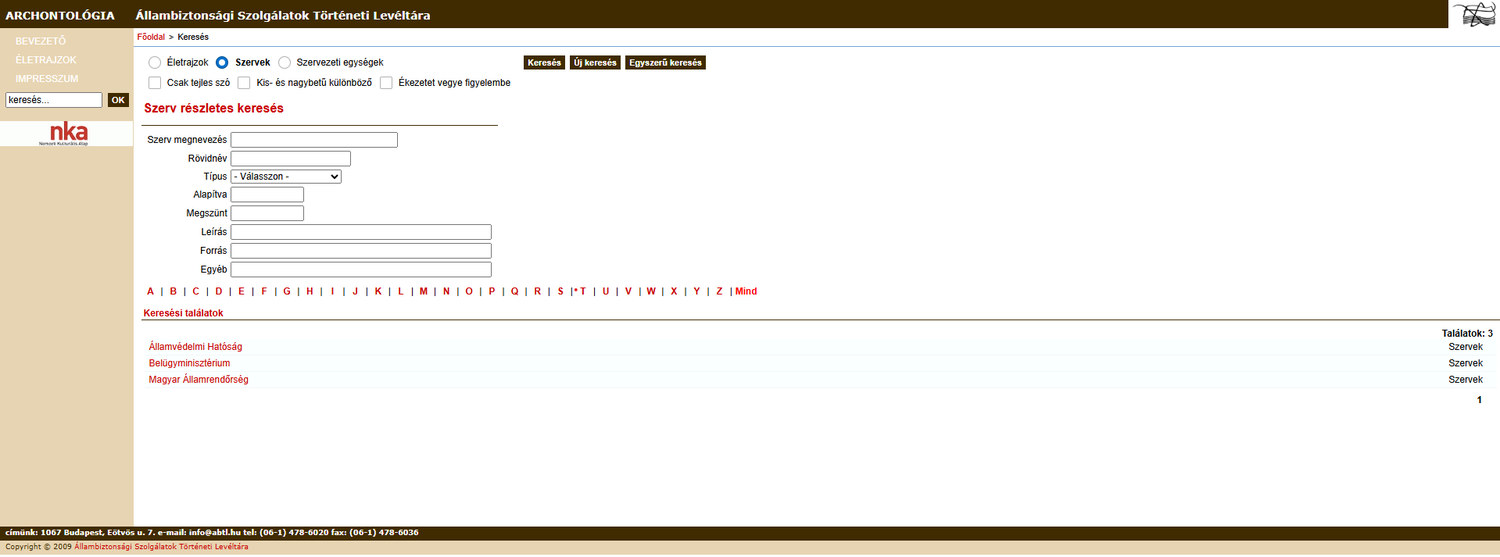
Szervezeti egységek
A szervezeti egységek keresőfelületén szintén számos metaadatban tudunk keresni: megnevezés, rövid név, leírás, forrás, egyéb.
Figyelem Több keresőmező nem működik megfelelően: például a szám és a funkció mezők hibára futnak akkor is, ha olyan keresőszót adunk meg, amelyről tudjuk, hogy létezik az adatbázisban.
A BM III/IV. Csoportfőnökség alosztályainak adatlapjáról kiderül, hogy a szám mezőben valójában a Rövid név adat jelenik meg, a funkció mezőben pedig olyan információkat találhatunk, mint a BM III/IV-1. osztály esetében: „Feladata változó, 1971 után az MNVK, majd a HM területén történő elhárítás”.
A Leírás mezőben főként a szervezeti egységre vonatkozó általános, leíró adatokat ismerhetünk meg: elnevezésre, feladatra vonatkozó információkat, vagy más szervezeti egységgel való összevonásra utaló adatokat.
Ennél a keresőfelületnél is automatikusan listázza a rendszer az összes (459) találatot, amelyek között lapozással tudunk navigálni; végigböngészhetjük az összes szervezeti egységet ábécésorrendben.
4. A találatok kezelése
A találati listában a névre, illetve a szervezeti egység nevére kattintva nyílik meg a személy vagy a szervezet adatlapja, amelyen pirossal kiemelve találjuk a keresőkifejezésünket. Attól függően, hogy személyre vagy szervre, illetve szervezeti egységre kerestünk, más adatlapra jutunk.
4.1 Személyek
A személy adatlapján a bal felső sarokban a személy nevét találjuk, alatta az azonosító adatait (anyja neve, született, meghalt), majd a végzettségre vonatkozó információkat, a rendfokozatokat, a foglalkozásokat és beosztásokat, végül a forrásokat.
Az adatlap bal felső sarkában helyezkedik el a fotó – akár több is az adott személyről –, amelyeket végig lehet lapozni. Az adatlap jobb felső és alsó sarkában helyezkednek el az Előző és Következő gombok, amelyekkel a személyek között lehet lépkedni.
Figyelem Az oldal lehetőséget biztosít az adatlap nyomtatására a Nyomtatható verzió gombra kattintva, azonban ez jelenleg nem működik.
4.2 Szervek
A szervek adatlapjánál sokkal szűkebb adatkészlettel találkozunk. Itt szintén az adatlap bal felső sarkában jelenik meg a szerv elnevezése, alatta a rövid neve, a típusa, a tisztségviselői és végül a szervezeti egységei.
A tisztségviselők és a szervezeti egységek mind kattinthatók, és átvezetnek az adott személy vagy szervezeti egység adatlapjára. (A Nyomtatható verzió gomb itt sem működik.)
4.3 Szervezeti egységek
A szervezeti egységek adatlapja nagyban hasonlít a szervek adatlapjára, azonban valamivel tágabb adatkészletet használ. Szintén az adatlap bal felső sarkában találjuk a szervezeti egység nevét, alatta a rövid nevét, funkcióját, alapításának és megszűnésének időpontját, a fölé- és alárendelt szerveket, szervezeti egységeket. Ez utóbbiak itt is kattinthatóak, és átvezetnek a megfelelő adatlapra, így hierarchikusan bejárható az adott szerv szervezeti felépítése.
Ezen az oldalon ismét lehetőség van az Előző és Következő gombra ugrásra, így végignézhetők az egy szinten lévő szervezeti egységek. A szervezeti egységeknél is szerepelnek a tisztségviselők beosztással és a hivatali idejükkel kilistázva (ahol ki van alakítva a kapcsolat az adatbázisban). Ezek a nevek szintén kattinthatók, és átvezetnek az adott személy adatlapjára.
Figyelem Forráskritika
Az adatbázisban található életrajzi adatok egy része a személyi gyűjtőkben talált önéletrajzokból származik. Az önéletrajzokkal kapcsolatban fontos szem előtt tartani, hogy szerepelhetnek bennük esetleges ferdítések, hangsúlyáthelyezések, bizonyos adatok elhallgatása annak érdekében, hogy az elérni kívánt beosztáshoz a legjobb esélyekkel induljon az illető.
Ezeknek az adatoknak az ellenőrzése és finomítása kontrollforrások felhasználásával lehetséges. Esetünkben a különböző parancsgyűjteményeken szereplő aláírás és beosztás párral nyomon követhető egy-egy személy hivatali pályája – de ez csak arra az időszakra terjed ki, amíg az illető a hivatalnál dolgozott. Az azt megelőző időszakra, például az iskolákra vonatkozó adatok felülvizsgálata nem képezte az archontológiai adatbázis célját és feladatát.
5. Hogyan hivatkozzon erre a forrásra?
Az adatbázisban talált adatokra az alábbi módon tud hivatkozni:
Bogye János (1931. 01. 17.) adatlapja. Állambiztonsági archontológia adatbázis. https://www.abtl.hu/ords/archontologia/, elérve: ÉÉÉÉ. HH. NN.
Tipp Ha elakad
Ha nem kap találatot a keresett kifejezésre, először ellenőrizze, hogy a keresőmezőkben nem maradt-e benne más keresőkifejezés is. Ilyenkor az Új keresés gombbal érdemes kitörölni az összes keresőkifejezést, és újra próbálkozni.
Esettanulmány
Esettanulmány Milyen társadalmi háttérrel érkeztek a BM III. Főcsoportfőnökség vezetői? Volt-e végzettségi elvárás a pozíció betöltésénél?
A kutatásunk arra irányul, hogy vajon lehet-e valamilyen hasonlóságot találni az 1962–1990 közötti BM III. Főcsoportfőnökséget vezető főcsoportfőnökök életpályájában. Ehhez az Állambiztonsági archontológia adatbázis összetett keresőjét fogjuk használni. Itt a szervezeti egységeket választjuk, és a megnevezés keresőmezőbe beírjuk a III. főcsoportfőnökség keresőkifejezést. A találatokból kiválasztva a számunkra relevánsat, meg is kapjuk a főcsoportfőnökök listáját. A kérdéses időszakban hat személy vezette a Főcsoportfőnökséget, mindegyikük adatlapja innen elérhető.
Azt a – nem meglepő – összefüggést találhatjuk, hogy mindannyian munkásként kezdték a pályafutásukat: volt köztük hentes, vasesztergályos, mezőgazdasági munkás, segédmunkás. Végzettségüket tekintve már tágabb a kép: van, aki egyetemi tanulmányokat is folytatott, van, aki csak különböző pártfőiskolákon sajátította el a szükséges tudást. Azt láthatjuk, hogy Rácz Pált kivéve mindannyian végeztek valamilyen – akár több – pártfőiskolát, így ez úgy tűnik, elvárásnak tekinthető.
Mindegyikükről elmondható, hogy egy hosszabb életpálya vége felé érték el ezt a pozíciót, amelyet minden esetben alacsonyabb osztályvezetői vagy helyettesi beosztások előztek meg. Néhányan főcsoportfőnökként mentek nyugdíjba; akik viszont folytatták a pályájukat, államtitkári szintet értek el – Rácz Pál például New Yorkban a magyar ENSZ-küldöttség vezetőjeként fejezte be a pályafutását. Rácz Pál egyébként is „kilóg” némileg a sorból, hiszen ő főleg külügyi vonalon mozgott, Külügyi Akadémiát végzett, és pályája nagy részében nagykövetségeken, illetve a Külügyminisztériumban dolgozott.
Azt láthatjuk tehát, hogy ilyen egyszerű kereséssel is számos érdekes adatra bukkanhatunk az Állambiztonsági archontológia adatbázisban. Ha valakit érdekelnek a mikrotörténeti kutatások, a személyes történelem, egy-egy ember életútja, az ilyen típusú adatbázisok nagyon hasznos adalékot szolgáltathatnak. Következő lépésként érdemes a felsorolt forrásoknak utánanézni, esetleg kikérni őket az adott levéltárból, hogy minél átfogóbb képet kaphassunk a keresett személyről.
Gyakorlati feladat
Feladat 1. feladat
Keresse meg az adatbázisban a kémelhárításért felelős szervezeti egységet.
Írja le ennek a szervezeti egységnek az alapadatait (mettől meddig létezett stb.).
Készítsen hierarchiaábrát a szervezeti egység hivatalon belüli elhelyezkedéséről (melyik szerven belül működött, milyen alá- és fölérendelt szervezeti egységei voltak).
Egy féloldalas (kb. 250 szavas) szövegben mutassa be a kémelhárítás 1974–1977 közötti csoportfőnökét.
Csatoljon képet a csoportfőnökről (ha van).
Írja le, hány levéltárból származó forrásokat sorol fel a csoportfőnök adatlapja, és csatoljon képernyőképet a forrásokról.
Önellenőrző kérdések
1. Mire jó egy archontológiai adatbázis?
Válasz megjelenítése
Mikrotörténeti kutatásokhoz, családtörténethez, egy-egy személy hivatali pályafutásának vizsgálatához és szervtörténeti kutatásokhoz használható.
2. Miért találunk az adatbázisban személyes adatokat?
Válasz megjelenítése
Mert a törvény nem védi a hivatásos alkalmazottak, a közszereplő operatív kapcsolatok, illetve a közszereplő hálózati személyek azonosításához szükséges adatait (név, anyja neve, születési idő és hely), ezért ezek nyilvános adatok. A törvény célja a történelmi múlt jobb megismerésének elősegítése volt.
3. Tudunk-e szervezeti egységekre keresni az adatbázisban?
Válasz megjelenítése
Igen: az összetett keresőben az Életrajzok és a Szervek mellett a Szervezeti egységek is választhatók.
4. Vannak-e fotók az adatbázisban szereplő személyekről?
Válasz megjelenítése
Igen, a személy adatlapjának bal felső sarkában, akár több is, lapozható formában.
5. Az adatbázisból megismert adatokat felhasználhatjuk-e a kutatásunk során?
Válasz megjelenítése
Igen, megfelelően hivatkozva ezek az adatok felhasználhatók. Az önéletrajzi eredetű adatokat azonban érdemes kontrollforrásokkal ellenőrizni.
Összefoglalás
A fejezet végén található feladatot elvégezve láthatjuk, milyen könnyen tudjuk használni az Állambiztonsági archontológia adatbázisát. Egyetlen feladatban képesek voltunk megkeresni egy szervezeti egységet az adatbázisban, megismerni annak a hierarchiában elfoglalt helyét, sőt a kapcsolódó személyi adatlapról egy életpálya-kutatást is el tudtunk végezni.
Ne feledje azonban a fejezet forráskritikai figyelmeztetését: az adatbázis egy része önéletrajzokon alapul, amelyek nem semleges dokumentumok. Az adatbázis kiindulópont, nem végpont – a következő lépés mindig a felsorolt eredeti források felkeresése.
Kulcsfogalmak
archontológia – A történelem azon segédtudománya, amely a tisztségviselők, hivatalnokok hivatali névsorának összeállításával és életpályájuk kutatásával foglalkozik.
hálózati személy – Az a személy, aki az állambiztonsági szervezetek számára titokban, fedéssel és fedőnévvel jelentést adott, vagy ilyen jellegű beszervezési nyilatkozatot írt alá, vagy ilyen tevékenységért előnyben részesült.
hivatásos alkalmazott – Az a személy, aki az állambiztonsági szervezetekkel hivatásos szolgálati viszonyban állt, ideértve a „titkos” és a „szigorúan titkos” állományú munkatársakat is.
kontrollforrás – Olyan további forrás, amellyel egy adat hitelessége ellenőrizhető (például parancsgyűjtemények aláírás–beosztás párjai az önéletrajzi adatok mellett).
mikrotörténet – Olyan történetírási irányzat és módszer, amely a makroszintű folyamatok helyett egy kisebb, jól behatárolható egységet vizsgál nagy alapossággal.
operatív kapcsolat – Az a személy, akit az állambiztonsági szervezetek „társadalmi kapcsolatként” vagy „alkalmi kapcsolatként” tartottak nyilván.
szervezettörténet – Egy adott intézmény, hivatal, vállalat vagy fegyveres testület belső struktúrájának, működési mechanizmusainak és felépítésének időbeli változását vizsgáló tudományterület.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- 2003. évi III. törvény az elmúlt rendszer titkosszolgálati tevékenységének feltárásáról és az Állambiztonsági Szolgálatok Történeti Levéltára létrehozásáról. https://net.jogtar.hu/jogszabaly?docid=a0300003.tv (utolsó elérés: 2026. 06. 10.)
- Cseh Gergő Bendegúz: A magyarországi állambiztonsági szervek intézménytörténeti vázlata, 1945–1990. Trezor 1. 1999.
- Cseh Gergő Bendegúz: A levéltári anyag feldolgozásának egy évtizede. Betekintő 2007/4. 1–11.
- Tóth Eszter: Iratbeszállítás, rendezés, segédletkészítés a levéltárban (1997–2012). Betekintő 2012/3. 1–11.
Linkek és eszközök
- Állambiztonsági archontológia – https://www.abtl.hu/ords/archontologia/f?p=108:1 – elérve: 2026. 06. 10.
- Állambiztonsági Szolgálatok Történeti Levéltára – https://www.abtl.hu/ – elérve: 2026. 08. 20.
- Nemzeti Kulturális Alap – https://www.nka.hu/ – elérve: 2026. 08. 20.
Tüntetések, demonstrációk 1988–1989
| Szerző(k) | Havasi-Mészáros Dániel |
| Becsült feldolgozási idő | 60 perc |
| Előfeltétel | Mi a forrás? |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszköz alapadatai
| Eszköz neve | Tüntetések, demonstrációk 1988–1989 |
| URL | https://tuntetes-archivum.hu |
| Üzemeltető | Állambiztonsági Szolgálatok Történeti Levéltára (ÁBTL) |
| Hozzáférés | Ingyenes, regisztráció nem szükséges |
| Regisztráció | Nem lehetséges |
| Tartalomtípus | Újság, levéltári irat, fénykép, videó |
| Időkörök | 1988–1989 |
Miről szól ez a fejezet?
Az Állambiztonsági Szolgálatok Történeti Levéltára (ÁBTL) a Történelemtanárok Egyletével (TTE) közösen abból a célból hívta életre ezt a honlapot, hogy bemutassa a rendszerváltást előidéző nagyobb megmozdulásokat. Ehhez kapcsolódóan az idővonal eseményeihez – sajnos nem mindhez – kérdések menüpont is készült.
Jelen fejezetben a Tüntetések, demonstrációk oldalon keresztül kívánjuk bemutatni, hogy milyen források maradhatnak fenn egy 20. század végi tömegeseményről.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- önállóan böngészi az oldal idővonalát és eseménylistáját, és megtalálja egy adott esemény forrásait;
- forrástípus szerint (dokumentum, kép, mozgókép) szűri egy esemény anyagát, és megkülönbözteti a „válogatott” és az „összes” forrás nézetet;
- felsorolja, milyen forrástípusok maradhatnak fenn egy 20. századi tömegeseményről, és mindegyikhez példát hoz az adatbázisból;
- egy adott eseményhez saját kutatási kérdést fogalmaz meg, és kiválasztja hozzá a releváns forrásokat;
- helyesen hivatkozik az oldalon közzétett levéltári iratra, sajtócikkre és beágyazott videóra.
Bevezetés
A könyv eddigi adatbázis-fejezetei kereshető rendszereket mutattak be: keresőmezőt, szűrőket, találati listát. Ez a fejezet másfélét: egy forrásközlő oldalt, amelyen nincs keresés, csak böngészés – 19 esemény, mindegyikhez szerkesztői válogatásban összeállított forráscsomaggal.
Ez a különbség nem technikai apróság. Egy keresőfelületen Ön dönti el, mit keres, és a rendszer felelőssége, hogy megtalálja. Egy forrásközlő oldalon a szerkesztők döntötték el, mi kerüljön egymás mellé – és éppen ez adja az értékét: az 1989. március 15-i tüntetéshez itt egyszerre látja az állambiztonsági iratot, a korabeli sajtócikket, a fényképet és a videót. Az ilyen összeállítás egy keresőfelületen soha nem állna elő magától.
A fejezet ezért kettős célt szolgál: megtanítja az oldal használatát, és egyben azt is bemutatja, milyen forrástípusok maradhatnak fenn egy 20. század végi tömegeseményről.
1. Mi a Tüntetések, demonstrációk 1988–1989?
A honlapot 2018. 06. 18-án indította el54 az Állambiztonsági Szolgálatok Történeti Levéltára, és azóta is a nevezett intézmény üzemelteti. Célja, hogy bemutassa azokat az 1988–1989 között tartott tömegtüntetéseket és megmozdulásokat (jelenleg 19 eseményt), amelyek hozzájárultak a rendszerváltozáshoz. Célközönsége minden, a téma iránt fogékony állampolgár, de elsődlegesen végzős középiskolások és történelem szakos egyetemisták. A honlapon a demonstrációkhoz köthető alábbi forrástípusok lettek közreadva: állambiztonsági iratok, korabeli sajtótermékek, fénykép- és videóanyagok, tárgyi emlékek fotói.55
Definíció Fogalom: idővonal
Olyan felhasználói felület, amely az eseményeket, tartalmakat vagy tevékenységeket időrendi sorrendben jeleníti meg.
2. A felület felépítése
Statikus weblapról van szó, amely 19 történést mutat be, így felépítése is meglehetősen egyszerű: egy nyitóoldalból és három fő menüpontból áll.
A főoldalon a fejléc alatt találhatók az alábbi menüpontok:
- idővonal,
- események,
- impresszum.
3. Keresés és böngészés
Mivel ez forrásközlő oldal, nincs lehetőség keresésre, csak böngészésre.
3.1 Az idővonal böngészése
Az Idővonal menüpontra kattintva a felület ugyanaz marad, csak az oldal hiperhivatkozása változik meg. Az idővonalon a rendszerváltáshoz kapcsolódó tüntetések eseményei szerepelnek. A legkorábbi feldolgozott esemény az 1988. március 15-ei demonstráció, míg az oldal utolsó eseménye az 1989. december 18-án tartott kiállás volt a Ceaușescu-rendszer ellen harcoló emberekért.
3.2 Az Események menüpont
Ebben a menüpontban ugyanazok az események szerepelnek, mint az idővonalon.
3.3 Egy adott esemény oldala
Akár az idővonalról, akár az Események menüpontból választunk egy eseményt, arra kattintva ugyanazon a lapon nyílik meg. Itt végigolvasható az adott esemény rövid ismertetése, ettől jobbra pedig az eseményhez tartozó források. Alapértelmezetten a válogatott források jelennek meg kronológiai sorrendben, amelyek között forrástípus (képek, dokumentumok, mozgóképek) alapján is lehet szűrni.
E szűrők mellett található egy kérdőjel ikon, amely a Történelemtanárok Egylete által megírt kérdéseket tartalmazza – amennyiben készültek azok. Az összes forrás szűrőt választva az eseményhez kapcsolódó összes forrás megjelenik, de ebben az esetben már nem lehet forrástípusra szűkíteni.
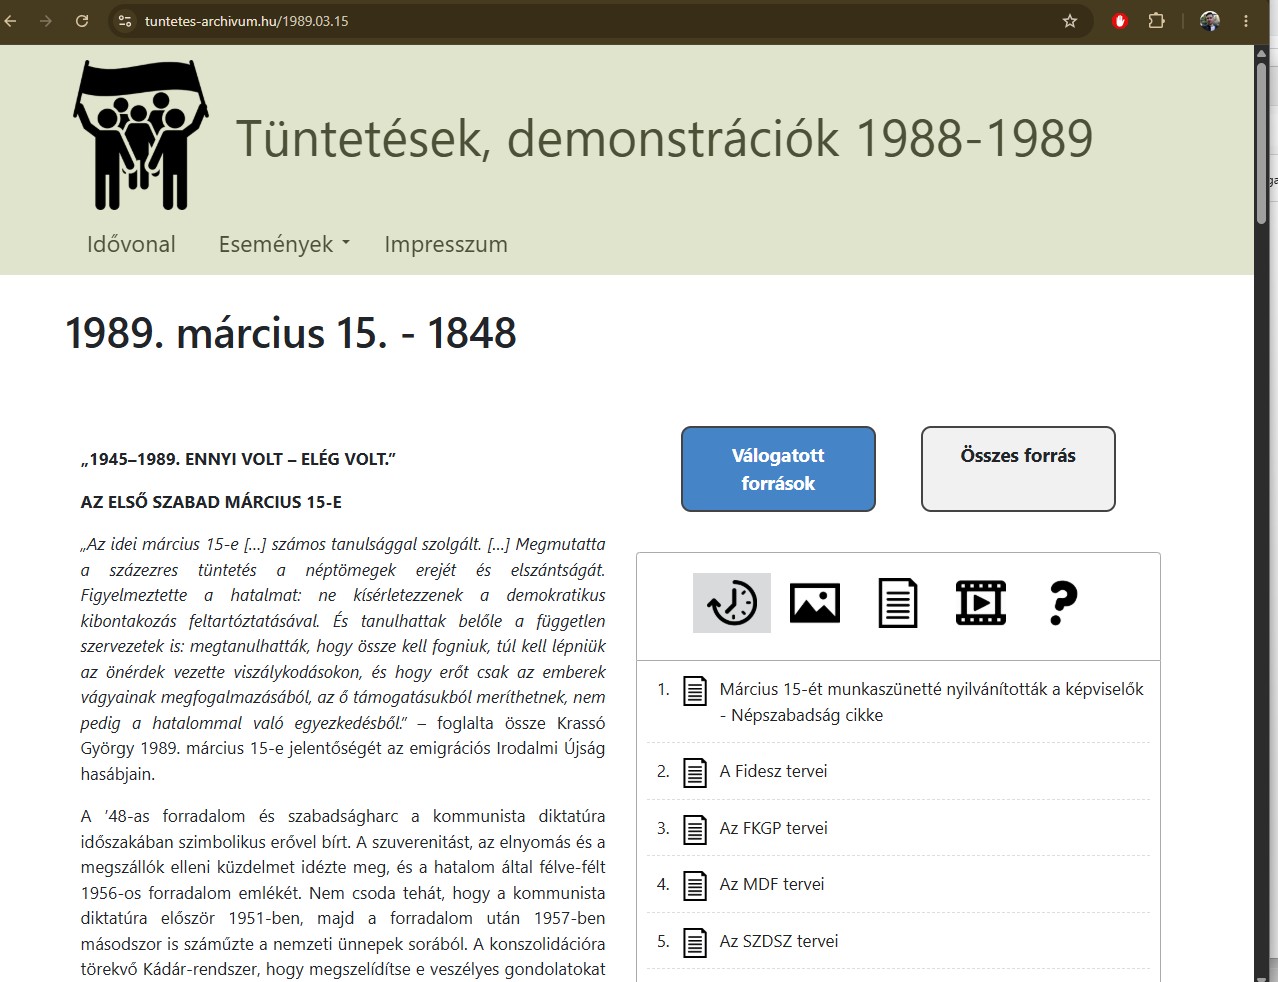
4. Egy esemény forrásai
Egy adott eseménynél, ha a válogatott forrásoknál kiválasztjuk a fotó forrástípust, megjelennek a fotók.
Ha ezt követően egy tetszőleges fotóra kattintunk, megnyílik a lapozható galéria. Itt az előre-hátra nyilakkal tudunk navigálni. Egy adott fotót le is tudunk tölteni, de akár külön lapon megnyitva (kép megnyitása új lapon) a kép hivatkozását kimásolva is megosztható.
Az iratok szűrőtípust választva megjelennek az írott források előképei.
Itt, ha egy adott dokumentumot kiválasztunk, az új lapon nyílik meg; annak URL-címe másolható és megosztható, de akár le is lehet tölteni az adott iratot.
A mozgóképek szűrőt használva a beágyazott videók előképei jelennek meg. Ezekre kattintva a mozgóképes tartalom új lapon nyílik meg, majd a videót az azt megosztó oldalon tudjuk lejátszani.
Figyelem A találat nem azonos a forrással
Az oldalon megjelenő irat egy digitalizált másolat: a hivatkozás alapja továbbra is az eredeti levéltári jelzet, illetve sajtócikknél a lap neve és megjelenési dátuma. Az oldal válogatott forrásokat közöl – vagyis szerkesztői válogatással dolgozik. Ha egy esemény teljes forrásbázisára van szüksége, az oldal kiindulópont, nem végpont.
5. Hogyan hivatkozzon erre a forrásra?
Az oldalon közzétett levéltári forrásokra a rajtuk feltüntetett jelzet megadásával lehet hivatkozni (például: ÁBTL – 2.7.1. – 45-78/3-13/1989.). Néhány esetben a levéltári jelzetek ma már pontosabbak: volt olyan irategyüttes, amely rendezésen esett át, de ezen az oldalon nem lett frissítve a tartalom.
Folyóiratokra a periodika nevével és megjelenési dátumának megadásával lehet hivatkozni (például: Népszabadság, 1988. december 21.). A beágyazott videós anyagokra pedig az adott videó URL-címével és az elérés dátumával.
Esettanulmány
Esettanulmány Mi volt az 1989. március 15-ei tüntetés célja?
Az 1989. március 15-ei budapesti megemlékezés a rendszerváltás előtti időszak egyik legjelentősebb nyilvános politikai eseményének tekinthető. A korszak kutatásában gyakran felmerülő kérdés, hogy milyen politikai célokat és követeléseket fogalmaztak meg az ellenzéki szervezetek a demokratikus átmenet küszöbén. Ennek vizsgálatához a Tüntetések, demonstrációk 1988–1989 online adatbázison közzétett forrásokat is érdemes használni. Az esettanulmány célja annak bemutatása, hogy az adatbázis segítségével miként azonosíthatók és elemezhetők az ellenzéki mozgalmak politikai üzenetei.
A kutatás első lépéseként megnyitottuk az 1989. március 15-ei eseményt, majd a forrástípusoknál a dokumentumokra szűrtünk. Itt kiválasztottuk „Az ellenzék 12 pontja” elnevezésű forrást (ÁBTL – 2.7.1. – 45-78/8-48/1989.), amely közvetlenül kapcsolódik a demonstráció politikai üzenetéhez.
Az iratot olvasva azonosítható, hogy több olyan követelést tartalmaz, amelyek a korszak demokratikus ellenzékének alapvető célkitűzéseit tükrözik. Több pontjában gyakorlatilag az 1848-as márciusi ifjak által megfogalmazott követeléseket fogalmazza meg újból. Néhányat említve: sajtószabadság biztosítása, valamint a Magyarországon állomásozó idegen haderő kivonása. A párhuzamot felfedezve tisztán látszik, hogy a demonstráció célja nem csupán történelmi megemlékezés volt, hanem a fennálló politikai rendszer reformja és a demokratikus átalakulás is.
Ezt követően a képekre szűrve olyan fényképeket kerestünk, amelyek a demonstráció vizuális üzeneteit mutatják be. Több felvételen megfigyelhetők a résztvevők által hordozott transzparensek és jelszavak, amelyek tartalmukban összhangban állnak az előbb vizsgált iratban lefektetett politikai követelésekkel. A szöveges és képi források együttes elemzése így megerősítette az előzetes megállapításokat.
Az esettanulmány rámutat arra, hogy a Tüntetések, demonstrációk 1988–1989 adatbázis nem csupán egyes események dokumentációját teszi elérhetővé, hanem lehetőséget biztosít különböző forrástípusok együttes vizsgálatára is. A példából látható, hogy egy jól körülhatárolt kutatási kérdés esetében elegendő lehet néhány forrás elemzése ahhoz, hogy érdemi következtetéseket vonhassunk le.
Gyakorlati feladat
Feladat 1. feladat – Az 1989. március 15-i demonstrációk forrásainak feltárása
A feladat célja, hogy megismerje a Tüntetések, demonstrációk 1988–1989 online adatbázis használatát, valamint azokat a forrástípusokat, amelyek egy 20. századi tömegesemény kapcsán az utókorra maradhatnak – és hogy ezeket értelmezve önálló következtetések levonására legyen képes.
Használandó oldal: Tüntetések, demonstrációk 1988–1989 – 1989. március 15.
a) Kutatási kérdés megfogalmazása. Fogalmazzon meg egy saját, az 1989. március 15-i eseményekhez kapcsolódó kutatási kérdést. Példák:
- Milyen követeléseket fogalmaztak meg az ellenzéki szervezetek?
- Hogyan jelent meg az 1956-os forradalom emléke az ünnepségeken?
- Milyen szerepet játszottak a különböző ellenzéki szervezetek a rendezvény megszervezésében?
- Milyen jelszavak és transzparensek jelentek meg a demonstrációkon?
b) Keresés végrehajtása. Az adatbázisban keressen legalább egy olyan forrást (dokumentumot, fényképet, videót), amely segít megválaszolni a választott kutatási kérdést. A keresés során: nyissa meg az esemény oldalát; a „Dokumentumok”, „Képek”, „Videók” vagy „Kérdések” szűrők segítségével böngéssze a rendelkezésre álló válogatott forrásokat; válasszon ki legalább egy releváns forrást; jegyezze fel a forrás címét (illetve, ha van, levéltári jelzetét) és típusát.
c) A találat bemutatása és értelmezése. Mutassa be röviden a kiválasztott forrást. Térjen ki az alábbi szempontokra: Mi a forrás címe? Milyen típusú forrásról van szó? Ki készítette vagy hozta létre? Milyen információkat tartalmaz? Hogyan segít megválaszolni az Ön által megfogalmazott kutatási kérdést?
d) Forrásmegjelölés. Hivatkozzon a felhasznált forrásokra az internetes tartalmakra vonatkozó szabályok betartásával.
Elvárt formátum: kb. féloldalas (200–300 szavas) szöveg hivatkozásokkal.
Önellenőrző kérdések
1. Milyen típusú források érhetők el a Tüntetések, demonstrációk 1988–1989 adatbázisban?
Válasz megjelenítése
Az adatbázisban többféle forrástípus található: dokumentumok, fényképek, videók, kronológiai adatok és az egyes eseményekhez kapcsolódó háttérinformációk.
2. Miért fontos a kutatás megkezdése előtt egy konkrét kutatási kérdés megfogalmazása?
Válasz megjelenítése
A kutatási kérdés segít meghatározni, hogy milyen forrásokat érdemes keresni, és lehetővé teszi a rendelkezésre álló információk célzott feldolgozását és értelmezését.
3. Milyen előnye van a különböző forrástípusok együttes használatának?
Válasz megjelenítése
A dokumentumok, fényképek és egyéb források együttes elemzése árnyaltabb képet ad a vizsgált eseményről, valamint lehetőséget biztosít az egyes információk kölcsönös ellenőrzésére és kiegészítésére.
4. Milyen információkat érdemes rögzíteni egy kiválasztott forrás bemutatásakor?
Válasz megjelenítése
A forrás címét, levéltári irat esetén annak jelzetét, típusát, keletkezésének körülményeit, tartalmának rövid összefoglalását, valamint azt, hogy miként kapcsolódik a kutatási kérdéshez.
5. Lehet-e keresni az oldalon?
Válasz megjelenítése
Nem: forrásközlő oldalról van szó, amelyen csak böngészésre van lehetőség – idővonalon vagy az Események menüponton keresztül.
Összefoglalás
Ebben a fejezetben megismerhette a Tüntetések, demonstrációk 1988–1989 online adatbázis alapvető használatát. Az esettanulmány és a gyakorlati feladat révén átfogó képet kaphatott arról, hogy egy 20. századi tömegesemény kapcsán milyen típusú források maradhattak fenn az utókor számára. A konkrét történeti kérdések megfogalmazása lehetővé tette a releváns források célzott feltárását, valamint azok tartalmi elemzését is.
A fejezet hangsúlyozta a kutatási kérdés megfogalmazásának jelentőségét, továbbá a különböző forrástípusok együttes alkalmazásának előnyeit. A megszerzett ismeretek hozzájárulnak a digitális történeti források tudatos és kritikus használatához.
Kulcsfogalmak
idővonal – Olyan felhasználói felület, amely az eseményeket időrendi sorrendben jeleníti meg.
forrásközlő oldal – Olyan digitális felület, amely nem kereshető adatbázis, hanem szerkesztői válogatásban, böngészhető szerkezetben tesz közzé forrásokat.
válogatott forrás – Az adott eseményhez a szerkesztők által kiemelt forrásanyag; megkülönböztetendő az „összes forrás” nézettől.
Felhasznált és ajánlott irodalom
Ajánlott irodalom
- Pap Péter István: Az ellenzéki március tizenötödike 1989-ben – Egy tüntetés anatómiája. Betekintő 13. (2019) 3. sz. 30–49. https://www.betekinto.hu/sites/default/files/betekinto-szamok/2019_3_pap.pdf – elérve: 2026. 09. 02. (A fejezet 4. szakaszában tárgyalt 1989. március 15-i tüntetés részletes feldolgozása.)
Linkek és eszközök
- Tüntetések, demonstrációk 1988–1989 – https://tuntetes-archivum.hu – elérve: 2026. 06. 11.
- Az oldal impresszuma – https://tuntetes-archivum.hu/impresszum – elérve: 2026. 06. 11.
- ÁBTL hír az oldal indulásáról – https://www.abtl.hu/hirek/elindult-a-tuntetesek-demonstraciok-1988-1989-oldal/ – elérve: 2026. 06. 11.
Családfakutatás: felületek és forráskritika
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 90 perc |
| Előfeltétel | Mi a forrás?, A magyar levéltári rendszer, AdatbázisokOnline |
| Ajánlott utána | Adatkezelés és adatvédelem – az élő személyek adatainak kezeléséhez |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszközök alapadatai
Ez a fejezet nem egy felületet mutat be, hanem egy kutatási utat, amelyen több szolgáltatás váltja egymást. A három legfontosabb adatai:
| Eszköz neve | MACSE-adattárak (Magyar Családtörténet-kutató Egyesület) |
| URL | https://macse.hu/ |
| Üzemeltető | Magyar Családtörténet-kutató Egyesület |
| Hozzáférés | Ingyenes |
| Regisztráció | Egyes adattárakhoz és a közösségi funkciókhoz ajánlott |
| Tartalomtípus | Közösségi indexek: anyakönyvi kivonatok, névváltoztatási adattár, temetői és egyéb adattárak; a Gudenus-féle Magyar Főnemességi Adattár 2026. 08-ban 106 030 személlyel |
| Időkörök | Túlnyomórészt a 18–20. század |
| Fontos korlát | Megtaláló eszköz, nem forrás. Az adatokat önkéntesek vitték be; a talált tételt mindig vissza kell ellenőrizni az eredeti anyakönyvön |
| Eszköz neve | MyHeritage |
| URL | https://www.myheritage.hu/ |
| Üzemeltető | MyHeritage Ltd. |
| Hozzáférés | Előfizetéses, ingyenes próbaidőszakkal; a keresés egy része regisztráció nélkül is fut |
| Regisztráció | Szükséges |
| Tartalomtípus | Nemzetközi rekordgyűjtemények, felhasználói családfák, DNS-teszt |
| Időkörök | Országonként és gyűjteményenként eltérő |
| Fontos korlát | A felhasználói fák nem hivatkozható források; a fizetős funkciókat a fejezet nem mutatja be, mert csak a nyilvános oldalt néztük meg |
| Eszköz neve | MNL anyakönyvi adatbázisai (az AdatbázisokOnline részeként) |
| URL | https://adatbazisokonline.mnl.gov.hu/ |
| Üzemeltető | Magyar Nemzeti Levéltár |
| Hozzáférés | Ingyenes, regisztráció nélkül |
| Regisztráció | Nem szükséges |
| Tartalomtípus | Állami anyakönyvek és más levéltári nyilvántartások tételesen kereshető adatai |
| Időkörök | Az állami anyakönyvezés 1895. október 1-jén indult; az azt megelőző időszak az egyházi levéltárakban keresendő (lásd A magyar levéltári rendszer) |
Miről szól ez a fejezet?
A családfakutatás a legnépszerűbb amatőr történeti tevékenység, és a történelemszakos hallgatók gyakran ezzel kerülnek először kapcsolatba a levéltári anyaggal. Ez jó – de van egy jellegzetes veszélye is.
A családfakutató felületek nagyon könnyűvé teszik, hogy valaki kész adatot kapjon: egy nevet, egy dátumot, egy felmenőt. Ez az adat azonban gyakran nem forrásból származik, hanem valaki más következtetéséből, amelyet ellenőrizetlenül másoltak tovább. A fejezet fő célja ezért nem az, hogy megtanítsa a felületeket használni, hanem hogy megmutassa, hol kezdődik a bizonyíték.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- megkülönböztesse a megtaláló eszközt, az anyakönyv digitális képét és az eredeti forrást, és megmondja, melyik mit bizonyít;
- felsorolja a magyar családfakutatás legfontosabb online felületeit, és megmondja, melyik mire való;
- ellenőrizzen egy indexből származó adatot az anyakönyvi képen;
- megnevezze a kereskedelmi genealógiai szolgáltatások adatvédelmi kockázatait, különös tekintettel az élő személyek adataira;
- szabályosan hivatkozzon egy anyakönyvi bejegyzésre.
Bevezetés: a magyar anyakönyvezés két korszaka
A családfakutatás forrásbázisát Magyarországon egy dátum vágja ketté.
1895 előtt az anyakönyvezést a felekezetek végezték: a plébániák, gyülekezetek és hitközségek vezették a születési (keresztelési), házassági és halotti (temetési) anyakönyveket. Ezek nyelve gyakran latin vagy német, írása kézírás, formája felekezetenként eltérő.
1895. október 1-jétől az állami anyakönyvezés kötelező: ettől kezdve állami anyakönyvvezetők vezetik a nyilvántartást, egységes, nyomtatott űrlapokon, magyarul.
Tipp Ez a kettősség szabja meg, hol keressen. 1895 utánra: állami anyakönyvek, levéltári és e-levéltári felületeken. 1895 előttre: egyházi anyakönyvek, felekezeti és mikrofilmes gyűjteményekben. Aki ezt nem tudja, ott keres, ahol nincs.
1. A forráshierarchia
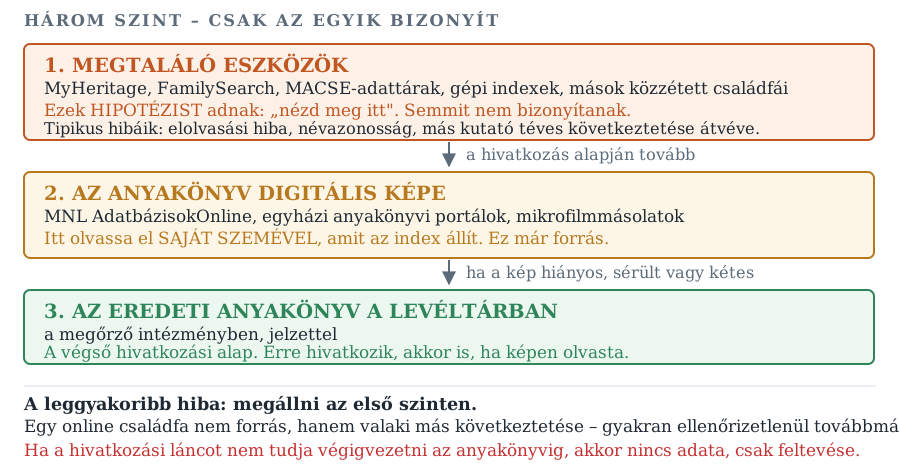
Figyelem Ez a fejezet legfontosabb ábrája. A családfakutatás jellegzetes hibája, hogy a kutató megáll az első szinten: talál egy adatot egy online családfán vagy egy indexben, és kész tényként kezeli.
Az index azonban valaki más olvasata: egy önkéntes vagy egy gép fejtette meg a kézírást, és tévedhetett. Az online családfa valaki más következtetése: lehet, hogy jó, de az is lehet, hogy két azonos nevű embert vont össze – és ezt azóta ötven másik felhasználó átmásolta.
A szabály: amit nem olvasott el a saját szemével az anyakönyvi képen, azt nem tudja, csak feltételezi.
2. Levéltári és intézményi felületek
Ezek a források – ide vezet a hierarchia.
| Felület | Mit ad? |
|---|---|
| AdatbázisokOnline – Állami anyakönyvek | 1895 utáni állami anyakönyvek digitalizált képei és indexei |
| AOL – Állami anyakönyvek kézírásfelismeréssel | gépi kézírás-felismeréssel keresővé tett anyakönyvi oldalak, állítható megbízhatósági küszöbbel |
| AOL – Mikrofilm anyakönyvek, Anyakönyvkereső | a mikrofilmezett anyag nyilvántartása: mi hol érhető el |
| ELP | egyéb digitalizált levéltári iratok |
| Hungaricana | közgyűjteményi anyag, köztük helytörténeti források |
| Egyházi anyakönyvi portálok | 1895 előtti felekezeti anyakönyvek |
Tipp A kutatás gyakorlati sorrendje szinte mindig ez: először a mikrofilm- vagy anyakönyv-nyilvántartásban nézze meg, hogy egyáltalán fennmaradt-e az adott település adott felekezetének adott évkörű anyakönyve. Sok kutatás azért fut zátonyra, mert a keresett kötet elpusztult – ezt jobb az elején megtudni.
Mélyebben A kézírás-felismerés mint családtörténeti eszköz
Az AdatbázisokOnline fejezetben láttuk: az anyakönyvi HTR-adatbázisban állítható az „MI magabiztosság küszöb”. Családfakutatásnál ennek konkrét haszna van.
Amikor egy konkrét személyt keres, érdemes a küszöböt alacsonyra venni: így több téves találatot kap, de kisebb az esélye, hogy a keresett bejegyzés kimarad, mert a gép bizonytalan volt a kézírásban. A téves találatokat úgyis kiszűri, amikor megnézi az oldalképet.
Fordítva viszont: ha statisztikát készítene – például egy település halálozási arányairól –, akkor magas küszöb kell, és a maradék hibával is számolni kell.
3. Közösségi adattárak: a MACSE
Definíció Fogalom: MACSE
A Magyar Családtörténet-kutató Egyesület honlapja, amely az amatőr családtörténet-kutatók által önkéntesen felajánlott adatokból épített adattárakat működtet. Nem intézményi forrásgyűjtemény, hanem közösségi indexelés eredménye.
A MACSE adattárai több forrástípust fednek le. A legfontosabbak:
- Anyakönyvi indexek – állami (polgári) és egyházi anyakönyvek indexelt adatai, valamint az anyakönyvkereső (mikrofilm-nyilvántartás);
- Gyászjelentések – a családtörténet egyik legjobb forrása, mert egyszerre ad dátumot és rokoni kapcsolatrendszert;
- Névváltoztatások – a magyarosított nevek kereséséhez nélkülözhetetlen;
- Sírkő és temető, Emlékművek, Tablóképek – helyszíni felmérésekből;
- Gudenus-adattár (Magyar Főnemességi Adattár) – 2026 augusztusában 106 030 személy adatával;
- Helységnévtár, Erdélyi névtár, Ismert személyek anyakönyvi adatai.
A kereső helyettesítő karaktereket ismer: a %
tetszőleges számú, a _ pontosan egy karaktert
helyettesít.
Tipp A névváltoztatási adattár a leginkább alulhasznált. Ha egy felmenő „eltűnik” egy időpontban, gyakran nem meghalt vagy elköltözött, hanem magyarosított. A 19. század végi és a 20. század eleji névmagyarosítási hullámok után ugyanaz a család két néven szerepel a forrásokban.
Figyelem A MACSE-adattár megtaláló eszköz, nem forrás. Az adatokat önkéntesek vitték fel, és az egyesület maga is jelzi, hogy javítási és törlési igény küldhető a projektvezetőnek. Egy adattári tétel tehát: erős nyom arról, hogy hol keressen – de a bizonyíték az anyakönyvi bejegyzés.
Ez nem a MACSE hibája, hanem a közösségi indexelés természete. Ugyanez érvényes minden hasonló gyűjteményre.
4. Kereskedelmi szolgáltatások: a MyHeritage
Definíció Fogalom: MyHeritage
Kereskedelmi genealógiai szolgáltatás: családfa-építő felület, több milliárd történeti rekord kereshetősége, automatikus egyeztetések más felhasználók fáival, valamint DNS-teszt. Ingyenes próbaidőszakot kínál, azután előfizetéses.
A szolgáltatás valóban hasznos lehet: nagy rekordállományt keres egyszerre, és az automatikus egyeztetések gyakran olyan kapcsolatra hívják fel a figyelmet, amelyre a kutató nem gondolt. De három dolgot tisztán kell látni.
4.1 Az egyeztetés hipotézis
Az automatikus „találat” azt mondja: ez a személy valószínűleg azonos azzal. Ez számítógépes valószínűségi becslés név-, hely- és dátumegyezés alapján. A 19. századi magyar falvakban a névazonosság rendkívül gyakori: egyetlen településen tucatnyi azonos nevű, közeli születésű ember élhetett.
Figyelem Az automatikus egyeztetés elfogadása nem kutatás, hanem döntés – amelyet ugyanúgy meg kell indokolni, mint bármely más történészi állítást. Az elfogadott egyeztetés bekerül a fájába, onnan mások átveszik, és néhány lépés múlva egy téves összevonás tucatnyi családfában él tovább, mindenféle forrás nélkül.
4.2 Amit felad cserébe
Figyelem A családfa élő emberek személyes adatait tartalmazza – olyanokét is, akik nem járultak hozzá.
Amikor felviszi a családfáját, nemcsak a saját adatait adja meg, hanem a szüleiét, testvéreiét, gyerekeiét, unokatestvéreiét: neveket, születési dátumokat, rokoni kapcsolatokat, néha fényképeket. Ők erről jellemzően nem tudnak.
Ez az Adatkezelés és adatvédelem fejezet alapkérdése: az élő személyek adatai személyes adatok, és a kezelésükhöz jogalap kell. A saját családfánk „magánügy” jellege nem szünteti meg azt a tényt, hogy egy külföldi kereskedelmi szolgáltató szerverére kerülnek.
Gyakorlati javaslat: élő személyeket a lehető legkevesebb adattal vegyen fel, és kérdezze meg őket. Sok szolgáltatás kínál „élő személyek elrejtése” beállítást – kapcsolja be.
Tipp Kutatásmódszertani javaslat. Ha kereskedelmi szolgáltatást használ, tekintse keresőnek: fogadja el, hogy hol érdemes megnézni, de az adatot mindig vezesse vissza az anyakönyvre, és a saját kutatási dokumentációját tartsa a szolgáltatáson kívül – saját fájlban, jelzetekkel. Így a kutatása akkor is megmarad és ellenőrizhető, ha az előfizetés lejár.
5. Hogyan hivatkozzon rá?
Figyelem A hivatkozás az anyakönyvi bejegyzésre mutat.
Egy szabályos anyakönyvi hivatkozás a következőket tartalmazza: a felekezet vagy az anyakönyvi kerület, a település, az anyakönyv típusa (születési, házassági, halotti), az év, a bejegyzés folyószáma vagy az oldalszám, végül az őrző intézmény és a jelzet.
[Település], [felekezet vagy anyakönyvi kerület], [típus] anyakönyv, [év], [bejegyzés száma / oldal]. [Őrző intézmény], [jelzet]. Elérhető: [a felület neve és URL-je] (elérve: ÉÉÉÉ. HH. NN.).
Amit nem ír a hivatkozásba: hogy a MyHeritage vagy a MACSE találta meg. Az a megtalálás útja, nem a forrás. (Ha egy közösségi adattár adatát átvette ellenőrzés nélkül, azt viszont jelezni kell – de akkor nem forrásra, hanem másodlagos adatra hivatkozik.)
Gyakorlati feladatok
Feladat 1. feladat – Index kontra kép (40 perc)
Válasszon egy 1895 utáni települést, amelynek anyakönyvei elérhetők az AdatbázisokOnline kézírásfelismeréses adatbázisában.
- Keressen rá egy gyakori családnévre, és válasszon ki öt találatot.
- Nyissa meg mindegyiknél az oldalképet, és olvassa el a bejegyzést.
- Hány esetben egyezik pontosan a gépi olvasat azzal, amit Ön lát? Hol tér el, és miért (kézírás, tinta, rövidítés, sérülés)?
- Írjon három mondatot arról, mit tanult ebből az indexek megbízhatóságáról.
Feladat 2. feladat – A hivatkozási lánc (30 perc)
Válasszon egy tetszőleges anyakönyvi bejegyzést, és állítsa össze hozzá a teljes hivatkozást az 5. szakasz mintája szerint.
- Milyen adatot kellett külön megkeresnie (jelzet, őrző intézmény)?
- Melyik felület adta meg, és melyiket kellett Önnek hozzátennie?
- Ellenőrizze: a hivatkozás alapján egy másik kutató meg tudná találni ugyanazt a bejegyzést? Ha nem, mi hiányzik?
Feladat 3. feladat – Adatvédelmi mérlegelés (írásbeli, 1 oldal)
Képzelje el, hogy elkezdi a saját családfáját egy kereskedelmi szolgáltatáson.
- Sorolja fel, mely élő személyek adatait vinné fel, és milyen adatokat.
- Melyiküket kérdezné meg előtte? Miért éppen őket?
- Mit tenne másképp, ha a kutatás eredményét publikálni is szeretné?
- Fogalmazzon meg három szabályt, amelyet magára nézve kötelezőnek tartana.
A feladat nem az, hogy elutasítsa vagy elfogadja a szolgáltatást, hanem hogy tudatos döntést hozzon, és azt meg tudja indokolni.
Feladat 4. feladat – Névváltoztatás nyomában (25 perc)
Keressen a MACSE névváltoztatási adattárában egy olyan névpárt (eredeti és felvett név), amely az Ön szűkebb régiójához kötődik.
- Melyik évben történt a névváltoztatás?
- Milyen kutatási nehézséget okozna, ha valaki nem tudna róla?
- Milyen más forrásból lehetne még kideríteni ugyanezt?
Önellenőrző kérdések
1. Mi történt 1895-ben, és miért fontos ez a családfakutatásban?
Válasz megjelenítése
1895. október 1-jétől kötelező az állami anyakönyvezés. Ez ketté vágja a forrásbázist: az azutáni időszakra állami anyakönyveket keresünk (levéltári és e-levéltári felületeken), az azelőttire egyházi anyakönyveket (felekezeti és mikrofilmes gyűjteményekben).
2. Mi a különbség a megtaláló eszköz és a forrás között?
Válasz megjelenítése
A megtaláló eszköz (index, online családfa, kereskedelmi egyeztetés) hipotézist ad: hol érdemes keresni. A forrás az anyakönyvi bejegyzés – amit a kutató a saját szemével elolvas a képen vagy az eredetin. Amit nem olvasott el, azt nem tudja, csak feltételezi.
3. Miért kockázatos elfogadni egy automatikus egyeztetést?
Válasz megjelenítése
Mert valószínűségi becslés név-, hely- és dátumegyezés alapján, a 19. századi magyar falvakban pedig a névazonosság rendkívül gyakori. Az elfogadott egyeztetés bekerül a családfába, mások átveszik, és a téves összevonás forrás nélkül él tovább tucatnyi fában.
4. Milyen adatvédelmi kérdést vet fel a saját családfa feltöltése?
Válasz megjelenítése
Élő személyek – szülők, testvérek, gyerekek, unokatestvérek – személyes adatait viszi fel, akik erről jellemzően nem tudnak és nem járultak hozzá. Az élő személyek adatai személyes adatok, kezelésükhöz jogalap kell, és egy külföldi kereskedelmi szolgáltató szerverére kerülnek.
5. Miért különleges a genetikai adat?
Válasz megjelenítése
Mert nem csak a tesztet elvégző személyről szól: információt hordoz a testvéreiről, szüleiről, gyermekeiről és távolabbi rokonairól is, akik nem adtak hozzájárulást. Nem lehet csak a sajátunkat megosztani.
6. Mennyire megbízható az etnikai becslés?
Válasz megjelenítése
Nem tény, hanem statisztikai becslés a szolgáltató referenciamintáihoz képest. A referenciaminták változásával az eredmény is változik, ezért történeti következtetést nem lehet rá alapozni.
7. Mire hivatkozik egy anyakönyvi adat esetén?
Válasz megjelenítése
Az anyakönyvi bejegyzésre: település, felekezet vagy anyakönyvi kerület, anyakönyv típusa, év, bejegyzés száma vagy oldal, őrző intézmény és jelzet – kiegészítve az elérés felületével és dátumával. Azt, hogy melyik szolgáltatás találta meg, nem a forrás része.
Összefoglalás
A családfakutatás ma három rétegben zajlik: megtaláló eszközök (kereskedelmi szolgáltatások, közösségi adattárak, gépi indexek), az anyakönyvek digitális képei, és az eredeti anyakönyvek a levéltárban. A fejezet fő állítása, hogy csak a harmadik szint bizonyít, a másik kettő odavezet – és hogy a leggyakoribb hiba az első szinten megállni.
A magyar forrásbázist 1895 vágja ketté: azelőtt egyházi, azután állami anyakönyvezés. A MACSE adattárai és az AdatbázisokOnline kézírásfelismeréses adatbázisa a két legerősebb magyar belépési pont; a kereskedelmi szolgáltatások nagy rekordállományt kínálnak, de az egyeztetéseik hipotézisek.
Végül, ami ezt a fejezetet minden más adatbázis-fejezettől megkülönbözteti: itt élő emberek adataival dolgozunk. A saját családfa nem csak a sajátunk. Ez nem jogi formalitás, hanem annak a kutatói felelősségnek a része, amelyről a Hogyan épül fel egy történeti kutatás? fejezet szólt.
Kulcsfogalmak
állami anyakönyvezés – 1895. október 1-jétől kötelező, állami anyakönyvvezetők által, egységes űrlapokon vezetett nyilvántartás.
egyházi anyakönyv – 1895 előtt a felekezetek által vezetett keresztelési, házassági és temetési nyilvántartás; nyelve gyakran latin vagy német.
index – Egy forrás adatainak kereshetővé tett kivonata; megtaláló eszköz, nem forrás.
MACSE – Magyar Családtörténet-kutató Egyesület; amatőr kutatók önkéntes adatfelajánlásaiból épített adattárakat működtet.
névváltoztatás (névmagyarosítás) – Hivatalos családnév-változtatás; ha a kutató nem tud róla, ugyanaz a család két néven, egymástól elszakadva jelenik meg a forrásokban.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- MACSE – Magyar Családtörténet-kutató Egyesület: adattárak és a Gudenus-adattár ismertetője – elérve: 2026. 08. 21.
- AdatbázisokOnline – anyakönyvi adatbázisok – elérve: 2026. 08. 21.
- MyHeritage – a szolgáltatás nyilvános ismertetője (előfizetés nélkül) – elérve: 2026. 08. 21.
Ajánlott irodalom
Linkek és eszközök
- MACSE – Magyar Családtörténet-kutató Egyesület – https://macse.hu/ – elérve: 2026. 08. 21.
- MACSE – Adattárak – https://macse.hu/society/adattarak.php – elérve: 2026. 08. 21.
- AdatbázisokOnline – https://adatbazisokonline.mnl.gov.hu/ – elérve: 2026. 08. 21.
- MyHeritage – https://www.myheritage.hu/ – elérve: 2026. 08. 21.
A táblázattól az adatbázisig: Excel és Access (haladó)
| Szerző(k) | Ring Orsolya |
| Szint | Haladó / választható – az oktató dönti el, része-e a kurzusnak |
| Becsült feldolgozási idő | 120 perc (géptermi gyakorlattal) |
| Előfeltétel | Mi az adatbázis? |
| Ajánlott utána | Adatbázisépítés saját adatokon – szintén haladó |
| Verzió / dátum | v0.1 / 2026. augusztus |
Figyelem Ez a fejezet haladó anyag – nem minden kurzuson kötelező.
A IV. rész fogalmi fejezetei – Adat a történettudományban és Mi az adatbázis? – minden történészhallgatónak szólnak: azt magyarázzák el, mi az adat, és mi történik egy adatbázis belsejében. Az adatfejezetek gyakorlati fele viszont, vagyis ez a fejezet és az Adatbázisépítés saját adatokon, géptermi munkát és szoftvert igényel – ezért ezt a kettőt az oktató súlyozza.
Olvassa el akkor, ha (1) az oktatója a kurzus részévé tette; (2) a szakdolgozatához maga gyűjt és rendez adatot; (3) vagy egyszerűen rendbe akarja tenni a saját táblázatait. Ha egyik sem áll fenn, nyugodtan lépjen tovább – a könyv további fejezetei nem építenek erre.
Miről szól ez a fejezet?
A történész előbb-utóbb táblázatot kezd építeni: képviselők listáját, anyakönyvi adatokat, egy sajtókorpusz cikkeit. A táblázat eleinte működik, aztán egy ponton összeomlik – lassú lesz, elromlanak a képletek, vagy kiderül, hogy nem lehet benne megkeresni azt, amit keresünk.
Ez a fejezet két kérdésre válaszol. Először: hogyan kell úgy megtervezni egy táblázatot, hogy később adatbázissá lehessen alakítani? Másodszor: mikor jön el az a pont, amikor a táblázatkezelő már nem elég, és mit érdemes utána használni?
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- megkülönböztesse a táblázatkezelő és az adatbázis-kezelő rendeltetését, és egy konkrét kutatási helyzetről indokolt döntést hozzon;
- megtervezze egy tábla mezőszerkezetét: helyes adattípust, mezőnevet és bontást választ;
- felismerje és kijavítsa egy hibás táblázat hat tipikus szerkezeti hibáját;
- elmagyarázza, hogyan és milyen kockázattal kapcsol össze két munkalapot az FKERES (VLOOKUP) függvény, és miben más ennél a relációs kapcsolat;
- ellenőrzőlista alapján előkészítsen egy táblázatot adatbázisba importálásra.
Bevezetés
Az Excel 1985-ben jelent meg, az Access 1992-ben. Mindkettő a Microsoft Office része, de különböző problémára készültek, és ez a különbség magyarázza a legtöbb későbbi bosszúságot.
Definíció Táblázatkezelő és adatbázis-kezelő
A táblázatkezelő (spreadsheet, pl. Excel, Google Sheets, LibreOffice Calc) számolásra, elemzésre és vizualizációra készült: rugalmas, vizuális számológép, ahol minden cella tartalmazhat értéket vagy képletet.
Az adatbázis-kezelő (RDBMS, pl. Access, MySQL, PostgreSQL, SQLite) adatok biztonságos tárolására és összekapcsolására készült: strukturált, szabályozott, adatintegritás-központú.
Az Excel erőssége a képlet (400-nál több beépített függvény), a grafikon, a pivot tábla és az azonnali indíthatóság – nem kell adatbázist tervezni, csak megnyitni és beírni. Az Access erőssége a több tábla közötti kapcsolat, az SQL-lekérdezés, az adatbeviteli űrlap és a referenciális integritás.
Tipp Nem konkurensek, hanem kiegészítik egymást. A tipikus kutatási munkamenet: Excel → adatgyűjtés és gyors bevitel; adatbázis → strukturálás, kapcsolatok, hosszú távú tárolás; Excel → exportálás, statisztika, grafikon.
1. Az adatstruktúra megtervezése
Az Excelben nem elég tudni, melyik gombot kell megnyomni. Előbb meg kell érteni, hogyan érdemes az adatokat elrendezni – még az első sor begépelése előtt.
1.1 A munkafüzet és a tábla anatómiája
Az Excel-fájl neve munkafüzet (workbook); ez több munkalapból (worksheet) áll. Jó ökölszabály: egy munkalap = egy jól körülhatárolt téma. Ne zsúfoljunk mindent egy lapra.
| Fogalom | Magyarul | Mit jelent? |
|---|---|---|
| row | sor | egyetlen rekord (egy fond, egy irat, egy személy) |
| column | oszlop | egyetlen mező (jelzet, év, terjedelem) |
| cell | cella | egy adat: sor és oszlop metszéspontja |
| header row | fejléc sor | az első sor: az oszlopok neve |
1.2 Adattípusok
Az Excel minden cellában megpróbálja felismerni az adat típusát. Ez automatikus, de nem mindig helyes.
| Típus | Példa történeti nyilvántartásból | Igazítás |
|---|---|---|
| szöveg | jelzet, fond neve, raktár helye | balra |
| szám | terjedelem (ifm), dobozszám | jobbra |
| dátum | keletkezési dátum, feldolgozás dátuma | jobbra |
| logikai | digitalizálva? (IGAZ/HAMIS) | középre |
Figyelem Az Excel a
megjelenést és a tényleges típust
külön kezeli. Az 1950 kinézhet számnak, de ha szövegként
tárolja, nem lehet vele számolni és nem lehet rá évhatár szerint szűrni.
A gyors ellenőrzés: az igazítás. A szám alapértelmezésben jobbra, a
szöveg balra igazodik. Ha egy évszámoszlop balra igazodik, valami baj
van.
1.3 Mezőtervezési elvek
a) Egy mező = egy információ (atomicitás).
Rossz:
| Terjedelem |
|---|
| 5 ifm |
| 3 doboz + 2 kötet |
Jó:
| Terjedelem_ifm | Doboz_db | Kötet_db |
|---|---|---|
| 5 | – | – |
| – | 3 | 2 |
Ha az egységeket összevegyítjük, nem lehet összesíteni, rendezni, szűrni.
b) A jelzet szöveg, nem szám. A XIX-A-1
vagy a 001 szöveg típusú, még ha számot tartalmaz is: a
vezető nulla számmá alakítva eltűnik, a kötőjeles alakot pedig az Excel
nem tudja számként kezelni. Ha az Excel mégis számnak venné, tegyünk elé
aposztrófot: '01.
Figyelem A szöveges rendezés más sorrendet
ad, mint a számszerű: betűrendben XXV-10
megelőzi a XXV-2-t, mert az „1” karakter
kisebb a „2”-nél. Ha számsorrendre van szükség, külön numerikus mezőt
kell felvenni.
c) Az évek külön mezőben, egész számként.
| Helyzet | Ajánlott típus | Miért? |
|---|---|---|
| kerek évszám (1950) | egész szám | lehet rá számolni és szűrni (pl. 1945 előtti tételek) |
| bizonytalan (1950?) | szöveg | a kérdőjel miatt nem lehet szám |
| tartomány (1950–1960) | két külön mező | csak így szűrhetünk időszakra |
d) A mértékegység az oszlop nevébe kerül, sosem a
cellába az értékkel együtt: Terjedelem_ifm oszlop, benne
5 – nem 5 ifm.
e) A kódolt értékekhez legyen zárt lista. Ha egy mező csak néhány értéket vehet fel, definiáljuk előre:
| Mező | Megengedett értékek |
|---|---|
| Digitalizálva | Igen, Nem, Részben |
| Állapot | Jó, Közepes, Rossz, Restaurált |
Ez lesz később az adatvalidáció (legördülő lista) alapja – és ez akadályozza meg, hogy ugyanaz az érték öt írásmódban kerüljön be.
1.4 Mezőnév-konvenciók
| Szabály | Rossz | Jó |
|---|---|---|
| ne legyen szóköz | Fond neve |
Fond_neve |
| ne legyen ékezet | Kezdő év |
Kezdo_ev |
| rövid, de értelmes | T |
Terjedelem_ifm |
| egységes stílus | FondNev, fond_jel |
Fond_neve, Fond_jelzet |
| egyedi az egész munkafüzetben | két Dátum oszlop |
Keletkezesi_datum, Feldolgozas_datuma |
Tipp Miért számít mindez, ha az Excel elfogadja a szóközt és az ékezetet? Mert az adat előbb-utóbb elhagyja az Excelt: adatbázisba, statisztikai programba vagy egy webes felületre kerül. A szóköz és az ékezet ott hibát okozhat, és utólag sokkal drágább javítani. Érdemes már az első sor begépelésekor tisztán tartani.
1.5 Hierarchikus adat lapos táblában
A levéltári és a legtöbb történeti anyag hierarchikus (levéltár → fondfőcsoport → fond → sorozat → doboz → irat). Egyetlen lapos táblában ez nem adható vissza teljesen; két járható út van:
1. megközelítés – a felső szint táblája. Minden sor egy fond. Egyszerű, könnyen kezelhető; cserébe a doboz szintű adatokat nem tároljuk.
2. megközelítés – az alsó szint táblája. Minden sor egy doboz, a fond adatai minden sorban megismétlődnek. Részletes, de redundáns (lásd Mi az adatbázis? 2.1).
Jó megoldás: két munkalap – Fondok és
Dobozok –, amelyeket a Fond_jelzet mező köt
össze. Ez már a relációs modell felé mutat.
1.6 Referenciatáblák
A kódolt értékeket érdemes külön munkalapra gyűjteni; ennek neve referenciatábla vagy segédtábla. Vegyük az Adatbázisépítés fejezet minta-adatsorának felekezeti oszlopát:
| Vallas_kod | Vallas_neve |
|---|---|
| RK | római katolikus |
| REF | református |
| EV | evangélikus |
Három haszna van: a fő táblában csak a rövid kódot tároljuk; ha a megnevezést később pontosítjuk, egyetlen helyen javítjuk; és ebből a listából húzzuk a legördülő menü értékeit – így eleve nem keletkezhet tíz különböző írásmód ugyanarra a három felekezetre.
Tipp A referenciatábla a legolcsóbb
adattisztítás: az, amelyiket nem kell elvégezni. Ha a bevitelnél
legördülő menüből lehet választani, a Vallás oszlopban soha nem
lesz rk és r. kat. egyszerre.
2. Mikor nem elég a táblázatkezelő?
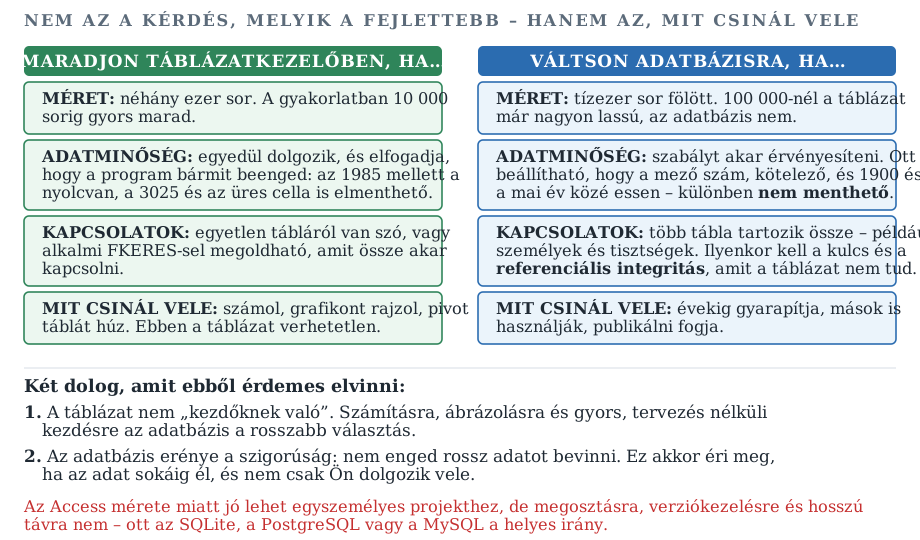
2.1 Méret és teljesítmény
| Szempont | Excel | Access |
|---|---|---|
| elvi felső határ | 1 048 576 sor | kb. 2 GB fájlméret |
| gyakorlatban | kb. 10 000 sor | millió fölött is |
| 1 000 sornál | gyors | gyors |
| 10 000 sornál | lassul | gyors |
| 100 000 sornál | nagyon lassú | gyors |
2.2 Adatintegritás
| Funkció | Excel | Access |
|---|---|---|
| mezőtípus | nincs valódi ellenőrzés | szigorú (szöveg, szám, dátum) |
| kötelező mező | nincs | Required = Yes |
| egyedi érték | nincs automatikusan | elsődleges kulcs |
| referenciális integritás | nincs | Enforce Referential Integrity |
| validáció | korlátozott (Data Validation) | Validation Rule + beviteli maszk |
Példa – születési év bevitele. Excelben elfogadásra kerül az
1985, de elfogadásra kerül a nyolcvan, a
3025 és az üres cella is. Adatbázisban beállítható, hogy a
mező szám típusú, kötelező, és értéke 1900 és a mai év között kell
legyen – ellenkező esetben a rekord nem menthető
el.
2.3 A kapcsolatok kezelése: FKERES kontra JOIN
Excelben több munkalap adatait az FKERES (angolul
VLOOKUP) függvénnyel lehet összekapcsolni. Maradjunk a minta-adatsornál:
legyen két munkalapunk, Szemelyek (a személy alapadatai) és
Szerepek (ki, mikor, milyen szerepet töltött be az
Akadémián). A Szerepek lap csak azonosítókat tárol, a nevet
az FKERES hozza be:
=FKERES( B2 ; Szemelyek!$A:$B ; 2 ; 0 )
          ↑        ↑             ↑   ↑
     ezt keresem   hol       hányadik  pontos
    (Szemely_ID)  keresem    oszlopból egyezés
Két alapszabály: az azonosító oszlop mindig az első
legyen a keresési tartományban, a tartományra pedig tegyünk
$ jeleket (Szemelyek!$A:$B), különben
másoláskor elcsúszik.
Előny: ha egy név írásmódját javítja, csak a
Szemelyek lapon kell átírni, a Szerepek lapon
automatikusan frissül.
Figyelem Az FKERES olvasásra jól működik, írásra törékeny.
- Ha valaki új oszlopot szúr be a
Szemelyeklap elejére, a képletben szereplő oszlopszám (2) nem követi az elmozdulást – a függvény attól kezdve rossz oszlopból olvas, némán. - A képlet minden cellában újraszámol, ezért nagy táblán lassú.
- Csak jobbra tud keresni: az azonosítótól balra lévő oszlop nem érhető el.
- Nincs integritás: be lehet írni nem létező
azonosítót, és a képlet csak
#HIÁNYZIKhibát ad – de a rekord bekerül.
Egy valós eset: egy új oszlop beszúrása után háromszáz sor FKERES-e romlott el egyszerre, mert megváltozott az oszlopsorrend.
Adatbázisban ugyanez egyetlen kapcsolat, amelyet nem kell soronként karbantartani:
SELECT Szerepek.Valasztas_eve, Szemelyek.Nev
FROM Szemelyek
INNER JOIN Szerepek
  ON Szemelyek.Szemely_ID = Szerepek.Szemely_ID;
Mélyebben Miért nem kell megtanulni az SQL-t ahhoz, hogy hasznunk legyen belőle?
Az Accessben (és a legtöbb hasonló programban) a lekérdezés grafikusan is összeállítható: a táblákat egérrel összehúzzuk, kijelöljük a kívánt mezőket, és a program írja meg helyettünk az SQL-t. A fenti kód pontosan azt jelenti, amit magyarul így mondanánk: „add össze a választás évét a személyek nevével, ott, ahol a két táblában ugyanaz a személyazonosító szerepel”.
A JOIN – összekapcsolás – ugyanaz a művelet, amit az
FKERES próbál utánozni, csak nem soronkénti képlettel, hanem a táblák
között egyszer definiált, tartós kapcsolattal.
2.4 Amit viszont az Excel jobban tud
Nem az Access a „fejlettebb”. A táblázatkezelő négy dologban verhetetlen: számítások és képletek; grafikonok; pivot táblák (interaktív, húzd-és-ejtsd összesítés); és a gyors, tervezés nélküli kezdés ad hoc elemzéshez.
Figyelem Az MS Access választása előtt olvassa el az Adatbázisépítés saját adatokon fejezet 5.1 pontját: az Access kisebb, egyszemélyes projekteknél jó választás, nagyobb vagy hosszú távra tervezett projekteknél azonban nem ajánlott, mert a megosztás, a verziókezelés és a hosszú távú fenntarthatóság mind problémás vele. Több felhasználós vagy publikálásra szánt projektnél SQLite, PostgreSQL vagy MySQL a megfelelő irány.
3. Átmenet: táblázatból adatbázisba
Az átvitel nem másolás-beillesztés. A táblázatkezelő rugalmas, bármit megenged; az adatbázis szigorú, csak tiszta, strukturált adatot fogad el.
3.1 Első lépés: adattisztítás
- Üres sorok eltávolítása. Az adatok közé ékelt üres sortól az importáló nem tudja, hol van vége a táblának. (Excelben: a Kezdőlap → Keresés és kijelölés → Irányított kijelölés → Üres cellák, majd a sorok törlése.)
- Az első sor legyen a fejléc – és csak az. Töröljük a fölötte lévő címet, dátumot, magyarázatot.
- Ne legyen egyesített cella. (Kezdőlap → Cellaegyesítés megszüntetése.)
- Ne legyen képlet, csak érték. Jelöljük ki a táblát, másoljuk, majd Irányított beillesztés → Értékek.
- Egy oszlop = egy adattípus, és az értékek legyenek konzisztensek.
Tipp Importálás előtti ellenőrzőlista
3.2 Második lépés: a szerkezet megtervezése
Ne importáljunk azonnal. Előbb gondoljuk végig: milyen entitások vannak, és milyen kapcsolatok közöttük? Minden entitás külön táblát kap.
A minta-adatsorban az entitások: személyek,
szerepek (ki mikor milyen tagsági szerepet töltött be)
és osztályok. A táblák: SZEMELYEK,
SZEREPEK, OSZTALYOK, valamint a kódolt értékek
referenciatáblái (VALLASOK,
FOGLALKOZASOK).
SZEMELYEK ──1:N── SZEREPEK ──N:1── OSZTALYOK
     │
     ├──N:1── VALLASOK
     └──N:1── FOGLALKOZASOK
Tipp Miért lett a szerep külön tábla?
Mert a lapos táblában kilenc rekordnál két szerep áll egyetlen cellában – például „alapító, igazgató tag” vagy „titoknok, rendes tag”. Ez az atomicitás klasszikus megsértése (lásd az 1.3 pontot).
Amíg egy cellában van, nem lehet rá szűrni, nem lehet megszámolni, hányan voltak igazgató tagok, és nem lehet évszámot rendelni az egyes szerepekhez. Egy személy–szerep–év hármas viszont mindezt megengedi. Ez az a pillanat, amikor a táblázat átfordul adatbázisba.
Tipp Rajzolja fel papíron a struktúrát, mielőtt bármit importálna. Egy rossz adatmodellt később sokkal drágább javítani, mint most tíz percet rajzolni.
3.3 Harmadik lépés: importálás és a kapcsolatok megadása
Az importálás a legtöbb adatbázis-kezelőben varázslóval megy (Accessben: Külső adatok → Új adatforrás → Fájlból → Excel). Két beállításra érdemes figyelni: jelöljük be, hogy az első sor tartalmazza az oszlopneveket, és ellenőrizzük a felajánlott adattípusokat.
A táblák importálása után kell megadni a kapcsolatokat (Accessben: Adatbázis eszközök → Kapcsolatok), és bekapcsolni a referenciális integritást. A lánc-frissítést és a lánc-törlést hagyjuk kikapcsolva.
3.4 Gyakori buktatók
| Tünet | Ok és megoldás |
|---|---|
| a dátumok elromlanak | rossz típusfelismerés – állítsuk kifejezetten dátum típusúra, és importálás után ellenőrizzük |
a vezető nullák eltűnnek (007 → 7) |
szám típusként importálódott – szöveg típus kell |
| az ékezetek megsérülnek | karakterkódolási hiba – UTF-8 kódolást használjunk |
| a redundancia átöröklődik | előbb normalizáljunk, csak utána importáljunk |
Esettanulmány
Esettanulmány Egy hibás tábla és a javítása
Az alábbi néhány sor abból származik, ahogy egy hallgató először gyűjtötte össze az akadémiai tagok adatait:
| Név | Élt | Szerep | Vallás |
|---|---|---|---|
| Széchenyi István gróf | 1791–1860 | alapító, alelnök | r. kat. |
| Vay Ábrahám | 1789–1855 | alapító, igazgató tag | református |
| Teleki József | 1790-1855 | elnök, rendes tag | ref. |
| katolikus |
Hat hiba van benne:
- a
Névoszlopban a név és a cím („gróf”) egy cellában van – ha rangokra akarunk szűrni, külön oszlop kell; - az
Éltoszlopban két évszám áll egy mezőben –Szuletesi_evésHalalozasi_evkell helyette; - a
Szereposzlopban két szerep van egy cellában (az atomicitás sérül) – ez már külön táblát kíván, mert egy személynek több szerepe is lehetett; - a
Vallásoszlopbanr. kat.,református,ref.éskatolikusszerepel – nem konzisztens kódolás; - van egy üres rekord (a negyedik sor);
- az évtartomány írásmódja következetlen:
1791–1860nagykötőjellel,1790-1855kiskötőjellel.
A javított szerkezet – két táblában, mert a harmadik hiba ezt kényszeríti ki:
SZEMELYEK
| Szemely_ID | Nev | Rang | Szuletesi_ev | Halalozasi_ev | Vallas_kod |
|---|---|---|---|---|---|
| 1 | Széchenyi István | gróf | 1791 | 1860 | RK |
| 2 | Vay Ábrahám | 1789 | 1855 | REF | |
| 3 | Teleki József | 1790 | 1855 | REF |
SZEREPEK
| Szerep_ID | Szemely_ID | Szerep | Ev |
|---|---|---|---|
| 1 | 1 | alapító | 1825 |
| 2 | 1 | alelnök | 1830 |
| 3 | 2 | alapító | 1825 |
| 4 | 2 | igazgató tag | 1830 |
| 5 | 3 | rendes tag | 1830 |
| 6 | 3 | elnök | 1830 |
Figyelje meg, hogy a javítás nem formázás kérdése volt. Minden egyes javítás egy elveszett kutatási lehetőséget adott vissza: a szétbontott rang szűrhető, a szétbontott évszámokból életkor számolható, a kódolt felekezet csoportosítható – a különálló szereptáblából pedig végre megválaszolható az a kérdés, hogy hányan és mikor töltöttek be igazgatói tisztséget.
Gyakorlati feladatok
Feladat 1. feladat – Mezőterv (20 perc)
Egy szemináriumi kutatáshoz a Vasárnapi Ujság 1867 és 1873 közötti könyvismertetéseit gyűjti össze.
- Sorolja fel, milyen mezőket venne fel. Minden mezőhöz adja meg a nevét (a névkonvenciók szerint) és az adattípusát.
- Legalább egy mezőnél mutassa be, hol sérülne az atomicitás, ha nem figyelnénk rá.
- Van-e olyan mező, amelyhez referenciatáblát készítene? Miért?
Feladat 2. feladat – Hibakeresés (15 perc)
Az esettanulmány mintájára javítsa a következő fejlécet, és indokolja meg minden változtatást:
Teljes név | Születési év |
MTA szerep | Választás éve
(Segítség: nézze meg a mta-alapitok-1825-1850.xlsx
fájlban, mi áll ezekben az oszlopokban. Az egyik fejléc a névkonvenciók
miatt problémás, egy másik pedig azért, mert a mögötte lévő adat nem
atomi.)
Feladat 3. feladat – Döntés (20 perc)
Az alábbi három helyzet mindegyikéről döntse el, hogy táblázatkezelő vagy adatbázis a megfelelő eszköz, és indokolja meg két-három mondatban:
- egy szakdolgozathoz 120 képviselő életrajzi adatait gyűjti, személyenként nyolc adattal;
- egy kutatócsoport három tagja párhuzamosan visz be adatot egy 40 000 tételes sajtókorpuszból, és minden cikkhez több szerző és több témakör tartozhat;
- egy szeminárium 14 hallgatójának jelenlétét és jegyeit vezeti.
Feladat 4. feladat – Az FKERES próbája (30 perc, gépteremben)
Készítsen egy munkafüzetet két munkalappal. Az elsőn
(Szemelyek) legyen egy Szemely_ID és egy
Nev oszlop öt sorral. A másodikon (Esemenyek)
legyen Esemeny_ID, Szemely_ID,
Datum, és egy Nev oszlop, amelyet FKERES-szel
tölt fel.
- Ellenőrizze, hogy a nevek helyesen jelennek meg.
- Most szúrjon be egy új oszlopot a
Szemelyeklap elejére. Mi történt a képletekkel? Miért? - Írjon három mondatot arról, mit tanult ebből arra nézve, hogy mekkora adatmennyiségig bízna rá kutatási adatot erre a megoldásra.
Önellenőrző kérdések
1. Mi a különbség az Excel és az Access alapfilozófiájában?
Válasz megjelenítése
Az Excel számolásra, elemzésre és vizualizációra készült rugalmas munkafelület, ahol minden cella szabadon szerkeszthető. Az Access relációs adatbázis-kezelő, amely adatok biztonságos tárolására és összekapcsolására készült: szerkezete kötött, és kikényszeríti az adatintegritást.
2. Miért tároljuk a jelzetet szövegként, nem számként?
Válasz megjelenítése
Mert a jelzet kötőjeleket és betűket tartalmazhat (XIX-A-1), amelyeket a program nem tud számként kezelni, és mert a vezető nulla (001) számmá alakítva eltűnik. Ha az Excel mégis számnak venné, aposztróffal kényszeríthetjük szöveggé: ’01.
3. Miért kell a kezdő és a záró évet két külön mezőben tárolni?
Válasz megjelenítése
Mert csak így lehet időszakra szűrni. Ha az évtartomány egyetlen szöveges mezőben áll („1944–1949”), a program nem tudja megállapítani, hogy ez a tartomány beleesik-e a keresett időszakba – a mező számára ez csak karaktersorozat.
4. Miért nem szabad az egységet („ifm”) a terjedelem cellájába írni?
Válasz megjelenítése
Mert az érték ettől szöveggé válik: nem lehet összeadni, átlagolni, nagyság szerint rendezni vagy határérték szerint szűrni. Az egység az oszlop nevébe (Terjedelem_ifm) vagy külön oszlopba való.
5. Milyen konkrét kockázata van az FKERES-nek több munkalap összekapcsolásakor?
Válasz megjelenítése
A képlet a keresési tartományon belüli oszlopszámra hivatkozik. Ha valaki új oszlopot szúr be a forrástábla elejére, a szám nem követi az elmozdulást, és a függvény némán rossz oszlopból olvas. Ezenkívül lassú nagy táblán, csak jobbra tud keresni, és nem akadályozza meg nem létező azonosító beírását.
6. Mi az a referenciatábla, és mire jó?
Válasz megjelenítése
Külön munkalapon (vagy táblában) tárolt segédtábla a kódolt értékekhez (pl. raktárépületek, állapotkódok). Három haszna: a fő táblában csak a rövid kód szerepel; az érték megváltozása egyetlen helyen javítandó; és belőle húzhatók a legördülő lista elemei, ami megelőzi az elgépeléseket.
7. Mit kell ellenőrizni egy táblázaton, mielőtt adatbázisba importáljuk?
Válasz megjelenítése
Hogy nincs üres sor; hogy az első sor a fejléc és csak az; hogy nincs egyesített cella; hogy nincs képlet, csak érték; hogy nincs cím vagy magyarázat a fejléc fölött; hogy minden oszlop egyetlen adattípust tartalmaz; és hogy az értékek írásmódja konzisztens.
8. Hány rekordnál kezd a gyakorlatban lassulni a táblázatkezelő?
Válasz megjelenítése
Az elvi felső határ ugyan több mint egymillió sor, a gyakorlatban azonban nagyjából tízezer sor fölött érezhetően lassul, százezer sornál pedig már nagyon lassú – főleg, ha képleteket is tartalmaz.
Összefoglalás
Ebben a fejezetben megtanulta, hogyan kell megtervezni egy tábla szerkezetét még az adatbevitel előtt: atomicitás, tudatos adattípus-választás, jelzet szövegként, évek külön mezőben, mértékegység az oszlopnévben, kódolt értékekhez referenciatábla, mezőnevek szóköz és ékezet nélkül. Megismerte a táblázatkezelő és az adatbázis-kezelő eltérő rendeltetését, az FKERES törékenységét a relációs kapcsolattal szemben, és az importálás előtti ellenőrzőlistát.
A fejezet legfontosabb üzenete időrendi: a szerkezeti döntéseket a begépelés előtt kell meghozni. Egy rosszul tervezett táblázat utólag javítható ugyan, de a hiányzó adat nem – ha valamit nem bontottunk szét felvitelkor, azt később csak a forrás újbóli átnézésével lehet pótolni.
Kulcsfogalmak
adatvalidáció – A bevihető értékek előzetes korlátozása (legördülő lista, értéktartomány, típuskényszer), amely megelőzi az elgépelést és a következetlen kódolást.
FKERES (VLOOKUP) – Táblázatkezelő függvény, amely egy azonosító alapján egy másik tartományból hoz be értéket; két munkalap összekapcsolására használják, de oszlopbeszúrásra törékeny.
JOIN (összekapcsolás) – Adatbázis-művelet, amely két táblát a közös kulcsmező mentén kapcsol össze; az FKERES tartós, karbantartást nem igénylő megfelelője.
munkafüzet és munkalap – A táblázatkezelő fájlja (munkafüzet) és annak egy-egy lapja (munkalap); ökölszabály: egy munkalap egy jól körülhatárolt téma.
referenciatábla (segédtábla) – A kódolt értékek külön tárolt listája, amelyből a legördülő menü és a hivatkozás dolgozik.
táblázatkezelő – Számolásra, elemzésre és vizualizációra tervezett program (Excel, Google Sheets, LibreOffice Calc); rugalmas, de nem kényszeríti ki az adatintegritást.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Ring Orsolya: Adatbázisépítés Excelben és Accessben. ELTE
BTK, 2026.
- fejezet („Excel vs Access – döntés a gyakorlatban”) és 4. fejezet („Excel alapok I – Adatstruktúrák”). https://ringorsolya.github.io/adatbazis_tankonyv_01/
Ajánlott irodalom
- Wickham, Hadley: Tidy Data. Journal of Statistical Software 59. (2014) 10. sz. 1–23. https://doi.org/10.18637/jss.v059.i10 (a „rendezett adat” elveinek klasszikus összefoglalása: egy oszlop = egy változó, egy sor = egy megfigyelés)
Linkek és eszközök
- A fejezet mintafájlja:
mta-alapitok-1825-1850.xlsx– a kötetadatok/mappájában (ugyanaz, mint az Adatbázisépítés fejezeté) - Adatbázisépítés Excelben és Accessben (a fejezet forrása) – https://ringorsolya.github.io/adatbazis_tankonyv_01/ – elérve: 2026. 08. 20.
- LibreOffice (ingyenes táblázatkezelő és adatbázis-kezelő) – https://hu.libreoffice.org/ – elérve: 2026. 08. 20.
Adatbázisépítés saját adatokon (haladó)
| Szerző(k) | Ring Orsolya |
| Szint | Haladó / választható – az oktató dönti el, része-e a kurzusnak |
| Becsült feldolgozási idő | 90 perc |
| Előfeltétel | Adat a történettudományban, Mi az adatbázis?, A táblázattól az adatbázisig, Állambiztonsági archontológia |
| Verzió / dátum | v0.1 / 2026. augusztus |
Figyelem Ez a fejezet haladó anyag – nem minden kurzuson kötelező.
A IV. rész fogalmi fejezetei mindenkinek szólnak: Adat a történettudományban és Mi az adatbázis? – ezek nélkül a könyv többi adatbázis-fejezete sem érthető.
A gyakorlati kettő más. Az előző fejezet (A táblázattól az adatbázisig) azt mutatja meg, hogyan ne rontsa el a saját táblázatát; ez pedig azt, hogyan tervez meg valaki egy adatbázist a nulláról: hogyan azonosít entitásokat, hogyan dönt a mezőkről, hogyan tisztít adatot, és milyen jogi-etikai kockázatokat vállal közben. Ez szakdolgozati vagy kutatási léptékű feladat, és géptermi munkát igényel.
Olvassa el akkor, ha (1) az oktatója a kurzus részévé tette; (2) a szakdolgozatához maga gyűjt adatot sok forrásból; (3) vagy egyszerűen érdekli, hogyan készül az, amit a IV. rész többi fejezetében kész felületként használt.
Ha egyik sem áll fenn, nyugodtan lépjen tovább – a könyv további fejezetei nem építenek erre.
Miről szól ez a fejezet?
A könyv IV. része eddig kész adatbázisok használatáról szólt (a szerkezetük mögötti fogalmakat a Mi az adatbázis?, a saját táblázat rendbetételét pedig az előző, A táblázattól az adatbázisig fejezet tárgyalta). Ez a fejezet az érem másik oldala: mi történik, ha Ön maga tervez adatbázist a saját forrásaiból. Végigvesszük a munkafolyamatot a kutatási kérdéstől az adattisztításig, és megnézzük, milyen döntések rejlenek egy adatmodell mögött.
A fejezetnek van egy közvetett haszna is: aki maga is épített már adatbázist, az sokkal jobban érti, milyen döntések állnak egy találati lista mögött – ez az eszközkritika gyakorlati alapja.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- eldönti egy konkrét kutatási helyzetről, hogy indokolt-e adatbázist építeni, és indokolja a döntést;
- megfogalmazza egy adatbázis kutatási keretét a három alapkérdés mentén (ki, milyen időszak, milyen kérdések);
- megtervez egy egyszerű relációs adatmodellt: entitásokat, attribútumokat és kapcsolatokat azonosít;
- felismeri és kezeli az adattisztítás négy tipikus problémáját;
- megnevezi az adatbázis-építés etikai és jogi kockázatait, és javaslatot tesz a kezelésükre.
Bevezetés
Az Adat a történettudományban fejezetben azt írtuk: az adatbázisba rendezhető adatot mi strukturáljuk a forrásokból, és az adatmodell maga is interpretáció. Ez a fejezet ezt bontja ki gyakorlatra.
Mikor érdemes egyáltalán adatbázist építeni?
Az adatbázis-megközelítés akkor indokolt, ha
- a vizsgált személyek vagy esetek száma meghaladja a néhány tucatot, és
- többváltozós adatokkal dolgozunk (nem egy-két jellemzővel személyenként), továbbá
- a kérdésünk összehasonlításra, arányokra vagy kapcsolatokra irányul.
Ha mindössze tizenöt személyről gyűjt öt adatot, egy jól vezetett táblázat is elég. Ha viszont ezerötszáz személyről tizenöt adatot, akkor táblázatban kezelhetetlenné válik.
A minta-adatsor
A fejezet gyakorlatai és esettanulmánya végig ugyanazon az adatsoron dolgoznak, hogy ne kelljen minden feladatnál új témába belegondolni:
mta-alapitok-1825-1850.xlsx– a Magyar Tudós Társaság alapítói és első nemzedéke, 50 rekord, 1825–1850. Összeállítva az MTA akadémikusi adattárából (akademikus.mtak.hu), az MTA 200 oldalából (mta200.hu) és a magyar Wikipédiából.
Tizenkét oszlopa van: Teljes név, Születési év, Halálozási év, Nem, Születési hely, Foglalkozás, Vallás, MTA szerep, MTA osztály, Választás éve, Forrás, Megjegyzés.
Figyelem Ez az adatsor szándékosan nem tiszta.
Ugyanaz a felekezet hat különböző írásmódban szerepel benne, a foglalkozások huszonhat különböző megnevezéssel. Nem hiba: pontosan így néz ki egy adatsor, amelyet több forrásból, kézzel gyűjtöttek össze – és a fejezet éppen ezzel dolgozik.
Figyelje meg a Forrás oszlopot is: szerepel benne a Wikipédia. Ez önmagában nem tiltott – kiindulásnak jó –, de a dolgozatba kerülő állítást vissza kell vezetni az akadémiai adattárra. A forrás rögzítése épp azért fontos, hogy később látható legyen, mely adat honnan való, és melyik szorul még ellenőrzésre.
1. A kutatási keret három kérdése
Az adatgyűjtés előtt három kérdést kell tisztázni – és leírni, mert később ehhez tér vissza.
1. Ki kerül az adatbázisba? A beválogatás kritériumai: pozíciók, intézmények, teljesítmény. A határokat pontosan rögzíteni kell, különben menet közben elmosódnak.
2. Milyen időszak? Az időhatárok konzisztens alkalmazása a koherencia feltétele. („Aki 1950 és 1960 között bármikor betöltötte a pozíciót” – vagy „aki 1955-ben töltötte be”? A kettő egészen más adatbázis.)
3. Mik a fő kutatási kérdések? Ezek határozzák meg az összegyűjtendő adatok körét. Adatot gyűjteni „minden esetre” nem lehet: a mezők számával exponenciálisan nő a munka.
Figyelem Ez a három kérdés ugyanaz, mint amit a Hogyan épül fel egy történeti kutatás? fejezetben a kutatási kérdés élesítéséről tanult – csak most a populáció és a mezőszerkezet szintjén kell megválaszolnia. Ha a kutatási kérdése homályos, az adatbázisa is az lesz.
2. Az adatmodell tervezése
Definíció Fogalom: relációs adatmodell
Olyan adatszerkezet, amely az információt több, egymással kapcsolatban álló táblába rendezi. Minden tábla egy entitástípust ír le (személy, intézmény, esemény), a táblák közötti kapcsolatok pedig azt, hogy ezek hogyan függenek össze.
Egy prozopográfiai adatbázis tipikus táblaszerkezete:
| Tábla | Funkció |
|---|---|
| Személyek | Személyazonosítás és alapadatok |
| Foglalkozások | Karriertrajektóriák időpontokkal |
| Intézmények | Iskolák, munkahelyek |
| Kapcsolatok | Interperszonális relációk, típussal |
| Kódtáblák | Feloldó táblák a standardizáláshoz (pl. vallás, foglalkozás) |
Tipp Miért nem elég egyetlen táblázat?
Mert egy személynek több foglalkozása lehet élete során, több iskolája, több kapcsolata. Ha ezt egy sorba akarja beszuszakolni, vagy oszlopokat kell sokszorozni („foglalkozás1”, „foglalkozás2”, „foglalkozás3”…), vagy egy cellába zsúfolni több értéket. Mindkettő kezelhetetlenné teszi az elemzést.
A megoldás: külön tábla a foglalkozásoknak, amelyben minden sor egy személy–foglalkozás–időszak hármas.
2.1 Az adatmodell mint interpretáció
Amikor eldöntjük, mely mezők kerüljenek be, mi határozzuk meg, mi számít fontosnak. Négy döntési pont:
- Milyen entitásokat veszünk fel? Csak személyeket – vagy intézményeket, eseményeket, helyeket, műveket is?
- Milyen attribútumokat rögzítünk? Név, születési év, foglalkozás – de miért éppen ezeket?
- Milyen relációkat tartunk számon? Családi? Munkahelyi? Tanár–diák? Levelezőpartner?
- Hogyan kategorizálunk? A foglalkozás előre definiált listából jön, vagy szabad szöveg? A társadalmi státuszt hogyan modellezzük?
Figyelem Minden mezőválasztás egyszerre mutat meg és rejt el valamit.
| Mező | Mit mutat? | Mit rejt el? |
|---|---|---|
| Név | azonosítás | névváltoztatások |
| Születési év | generáció, életkor | pontos dátum |
| Származási hely | térbeli mobilitás | családi gyökerek |
| Végzettség | képzettség | informális tanulás |
| Politikai hovatartozás | karrierlehetőségek | valós meggyőződés vs. kényszer |
Az adatmodell sosem semleges. Ezért kell a dolgozatban dokumentálni, milyen modellel dolgozott, és mit hagyott ki tudatosan.
3. Források és adatgyűjtés
Három forráskategória, eltérő megbízhatósággal és munkaigénnyel:
| Forrástípus | Előny | Hátrány |
|---|---|---|
| Lexikonok, almanachok | gyors | hiányos |
| Intézményi névsorok, nyilvántartások | megbízható | munkaigényes |
| Levéltári iratok, anyakönyvek, önéletrajzok | pontos | időigényes |
Tipp Rögzítse a forrást és a bizonytalanságot is.
Minden adatnál érdemes egy külön mezőben feltüntetni, honnan származik, és ha bizonytalan, azt is. Így később visszakövethető, mely megállapítás mennyire megalapozott – és az adatbázis maga is forráskritikailag értékelhető marad.
Ez az Állambiztonsági archontológia gyakorlata is: minden személy adatlapján szerepel a felhasznált források felsorolása.
4. Adatbevitel és adattisztítás
Az adatbevitel után jön a legmunkaigényesebb szakasz: az adattisztítás.
Nézzük meg a minta-adatsor Vallás oszlopát. Ötven rekord, és első ránézésre rendben van – csakhogy tíz különböző értéket tartalmaz:
| Nyers érték | Előfordulás |
|---|---|
rk |
10 |
katolikus |
9 |
református |
8 |
evangélikus |
8 |
r. kat. |
5 |
római katolikus |
4 |
r.k. |
2 |
ref. |
2 |
ev. |
1 |
r.kat. |
1 |
Tíz érték – három felekezet. A tisztítás feladata, hogy ez látszódjék is.
4.1 Négy tipikus probléma és kezelése
| Probléma | Példa a minta-adatsorból | Megoldás |
|---|---|---|
| Rövidítések | rk, r.k., r. kat.,
ref., ev. |
feloldás szabványosított szótár alapján |
| Kategorikus szórás | költő, poéta, író,
drámaíró, regényíró |
hasonló értékek kanonikus kategóriába vonása (Irodalmár) |
| Karakterkészlet-hibák | ô → ő, û → ű
(régi fájlokból örökölve) |
átkonvertálás kereséssel-cserével |
| Visszakövethetőség | – | az eredeti adat megőrzése új oszlopban (verziózás) |
Tipp Hogyan derüljön ki, hány érték van valójában?
Ne szemre olvassa végig az ötven sort. Készítsen az oszlopból gyakorisági kimutatást – Excelben pivot táblával, vagy egyszerűen úgy, hogy kimásolja az oszlopot, alkalmazza a Duplikátumok eltávolítása parancsot, és megszámolja, mi maradt.
Ez a fél perc az, ami megmutatja, hogy tíz értékkel áll szemben, nem hárommal.
Figyelem Soha ne írja felül az eredeti adatot.
A tisztított értéket új oszlopba tegye, az eredetit hagyja meg. Két okból: egyrészt a harmonizálási döntés később hibásnak bizonyulhat, másrészt a forráshűség megköveteli, hogy vissza lehessen nézni, mi állt eredetileg a forrásban.
Ez ugyanaz az elv, amit az OCR fejezetben a nyers OCR-szövegről és az oldalképről mondtunk: a feldolgozott változat nem helyettesíti az eredetit.
Tipp A 80 százalék elve
A finomításnak nincs természetes vége: mindig lehet még egy kategóriát összevonni. A gyakorlati tapasztalat szerint 80 százalékos tisztaságtól már értelmes elemzéseket lehet végezni. Aki a 100 százalékra vár, soha nem jut el az elemzésig.
Mélyebben Ötven rekord és negyvenezer – ugyanaz a munka, más nagyságrendben
A minta-adatsor ötven sorát egy délután alatt kézzel meg lehet tisztítani. Hogy mit jelent ez nagyban, arra jó példa az ElitData projekt: ott a foglalkozási oszlop 3956 bejegyzésében az eredeti mintegy 3400 különböző írásmód a tisztítás után 2390 egyedire csökkent.
Két dolog látszik ebből. Egyrészt: a probléma természete azonos, csak a mennyiség más – ugyanazokat a döntéseket kell meghozni. Másrészt: ott a tisztítás után is maradt 2390 érték. Nagy adatnál a cél nem a tökéletes kategóriarendszer, hanem az elemezhetőség.
5. Technikai megvalósítás
5.1 Hol tároljuk az adatot?
| Rendszer | Mikor ideális? |
|---|---|
| Táblázatkezelő (Excel, Google Sheets) | néhány száz rekord, egyetlen tábla, egyszemélyes munka |
| SQLite | egyszemélyes projekt, több tábla, egyszerű struktúra |
| PostgreSQL / Supabase | többfelhasználós, webes hozzáférés |
| MySQL | közepes projektek, széles támogatottság |
Figyelem Az MS Access kisebb, egyszemélyes projekteknél használható, nagyobb projekteknél azonban nem ajánlott – a megosztás, a verziókezelés és a hosszú távú fenntarthatóság mind problémás vele.
Az Excel és az Access gyakorlati összehasonlítását, a táblaszerkezet tervezési szabályait és az importálás lépéseit lásd A táblázattól az adatbázisig fejezetben.
5.2 Hogyan nézzük meg az adatot?
Egy kutatói felület jellemzően négy nézetet kínál, és mindegyik más kutatási kérdéshez való:
| Nézet | Mire használható? |
|---|---|
| Keresés és személyprofil | egyénekre vonatkozó információ összegyűjtése |
| Statisztikák | csoportos trendek és arányok feltárása |
| Hálózat | egy szereplő kapcsolatrendszere; intézményi kohorszok |
| Térkép | földrajzi minták, tanulmányi és migrációs útvonalak |
Figyelje meg, hogy ez ugyanaz a négy nézet, amelyet a Budapest Időgép (térkép) és az Állambiztonsági archontológia (keresés, profil, hierarchia) is kínál – csak most Ön van a felület mögött.
6. Mit lehet kezdeni a kész adatbázissal?
- Leíró statisztika – demográfiai és foglalkozási összetétel.
- Hálózatelemzés – kapcsolathálók, közösségek, endogámia.
- Longitudinális vizsgálat – időbeli változások évtizedek szerint.
- Térbeli elemzés – migrációs minták, regionális különbségek.
- Komparatív kutatás – összehasonlítás más adatbázisokkal.
Az eredmények bemutatásához lásd a Kutatási eredmények vizualizálása fejezetet.
7. Kihívások, etika, jog
7.1 Tipikus nehézségek
| Probléma | Javasolt stratégia |
|---|---|
| Az adatgyűjtés időigénye | minimális szintről indulni, később bővíteni |
| Forrásalapú adatheterogenitás | a forrás és a bizonytalanság rögzítése |
| Véget nem érő finomítás | 80 százalékos tisztaságtól már lehet elemezni |
| Technikai és szakmai kompetencia | interdiszciplináris csapatmunka |
| Fenntartás, hosszú távú kezelés | verziókezelés, dokumentáció, archiválás |
7.2 Etikai és jogi szempontok
- Élő személyekre vonatkozó adat. GDPR-megfelelőség szükséges (lásd az Adatkezelés és adatvédelem fejezetet).
- Forrásjog. Levéltári anyag digitalizálása jogi engedélyt igényelhet.
- Hozzáférés-szabályozás. El kell dönteni, hogy az adat a kutatói közösségnek vagy a nyilvánosságnak szól-e.
- Citálhatóság. DOI és ajánlott hivatkozási formátum szükséges az újrafelhasználáshoz (lásd az ORCID és DOI fejezetet).
8. A munkafolyamat összefoglalása
- A kutatási kérdések precíz megfogalmazása.
- A populáció definíciója és határainak rögzítése.
- A relációs adatmodell tervezése (entitások, attribútumok, kapcsolatok).
- A források összeállítása és a kódolási protokoll kialakítása.
- Adatbevitel az eredeti formában.
- Rendszeres tisztítás és harmonizálás – az eredeti megőrzésével.
- Az adatbázis technikai implementálása.
- Lekérdező és megjelenítő felületek.
- Elemzés, publikálás, hosszú távú archiválás.
Figyelem A folyamat iteratív. A tisztítási fázis hiányosságokat tárhat fel a modellben; az elemzés új adatgyűjtési szükségleteket vethet fel. Ne lineáris projektként tervezze, hanem körökben.
Esettanulmány
Esettanulmány Milyen felekezetű volt az Akadémia első nemzedéke?
A kérdés. A reformkori magyar tudományos élet felekezeti összetétele régi történeti kérdés. Az ötven fős minta-adatsoron ez egyetlen szemináriumi óra alatt megválaszolható – ha a válasz előtt elvégezzük a tisztítást.
1. lépés – a nyers adat. Készítsünk gyakorisági
kimutatást a Vallás oszlopból. Az eredmény a 4. szakaszban
látott tíz érték. Ha valaki innen olvas le következtetést, ezt látja: a
leggyakoribb egyetlen érték az rk 10
előfordulással, míg a református és az
evangélikus 8–8, vagyis együtt 16. Az
elhamarkodott olvasat: a protestánsok voltak többségben.
2. lépés – harmonizálás. Vonjuk össze a nyers értékeket kanonikus kategóriákba – új oszlopba, az eredeti megtartásával:
| Kanonikus kategória | Mely nyers értékekből | Rekord |
|---|---|---|
| Római katolikus | rk, katolikus, r. kat.,
római katolikus, r.k.,
r.kat. |
31 |
| Református | református, ref. |
10 |
| Evangélikus | evangélikus, ev. |
9 |
3. lépés – a válasz. 31 : 19. A római katolikusok abszolút többségben voltak – az elhamarkodott olvasat épp az ellenkezőjét sugallta.
Figyelem Ez a fejezet legfontosabb tanulsága.
A tisztítás nem kozmetika. Ebben a példában a tisztítatlan adat rossz választ adott egy valódi történeti kérdésre – és semmi nem jelezte, hogy baj van. A pivot tábla ugyanolyan magabiztosan kiírta a tíz sort, mint a hármat.
4. lépés – a másik oszlop. Ugyanez a Foglalkozással: 26 nyers érték hét kanonikus kategóriává áll össze.
| Kategória | Rekord |
|---|---|
| Tudós (történész, nyelvész, filozófus, matematikus, csillagász, fizikus…) | 18 |
| Irodalmár (költő, poéta, író, drámaíró, regényíró, szerkesztő…) | 15 |
| Politikus | 6 |
| Főnemes (főispán, főnemes) | 4 |
| Egyházi (pap, teológus) | 3 |
| Orvos | 2 |
| Jogász | 2 |
A kép önmagáért beszél: a tudósok és az irodalmárok együtt a testület kétharmadát adják. A négy főnemes viszont – Széchenyi, Vay, Andrássy, Károlyi – éppen az alapítók: kevesen vannak, de nélkülük nincs Akadémia. A gyakoriság és a jelentőség nem ugyanaz.
5. lépés – amit a számoláson kívül észre kell venni.
- A Nem oszlopban mind az ötven rekord értéke
Férfi. Egy oszlop, amelyben egyetlen érték szerepel, elsőre feleslegesnek látszik – pedig maga a válasz: az Akadémia első nemzedékében nem volt nő. - A Választás éve oszlopban 28 rekord az 1830-as évet viseli. Ez nem adathiba: ekkor alakult meg ténylegesen a testület.
- Az MTA osztály oszlopban a legnépesebb a
nyelvtudományi (18) – ami egybevág az Akadémia eredeti,
nyelvművelő küldetésével. Öt rekordnál
—szerepel: ők az igazgató tagok, akiknek nem volt osztályuk. A hiányt tehát nem kell adathibaként javítani.
Záró reflexió. Az egész elemzés két oszlopon és ötven soron futott. Nem a méret tette érdemivé, hanem az, hogy a kérdés előbb volt meg, mint a táblázat – és hogy a tisztítás előtti számot nem fogadtuk el válasznak.
Gyakorlati feladatok
Feladat 1. feladat – Adattisztítás a minta-adatsoron (30 perc, gépteremben)
Nyissa meg a mta-alapitok-1825-1850.xlsx fájlt, és
dolgozzon a Foglalkozás oszloppal. (A Vallás
oszlopot az esettanulmány már végigvitte – most a másikat.)
Készítsen gyakorisági kimutatást: hány különböző érték szerepel benne?
Vonja össze őket kanonikus kategóriákba. A tisztított értéket új oszlopba tegye, az eredetit hagyja meg.
Írja le, hány kategóriára csökkentette a huszonhatot, és mi alapján döntött.
Melyik besorolásnál bizonytalan? Nézze meg például a
történetíró, aphilologusés azesztétaértékeket: mindegyik egyértelműen egy kategóriába tartozik?Mit veszítünk azzal, ha a
költő, adrámaíróés aszerkesztőegyaránt Irodalmár lesz? Fogalmazzon meg egy kutatási kérdést, amelyre az összevont kategória már nem tud válaszolni.
Elvárt formátum: a kitöltött táblázat + kb. 150 szavas reflexió.
Feladat 2. feladat – Adatmodell tervezése papíron
A minta-adatsor egyetlen lapos tábla. Tervezze át relációs modellé.
Nevezzen meg legalább két entitást és a köztük lévő kapcsolatot. (Segítség: az MTA szerep oszlopban kilenc rekordnál két szerep szerepel egy cellában – például „alapító, igazgató tag”. Egy személynek több szerepe is lehetett, akár különböző években.)
Soroljon fel entitásonként 5–7 attribútumot.
Melyik oszlopból csinálna kódtáblát, és miért?
Mindegyik attribútumnál írja le egy-egy szóban, mit mutat meg és mit rejt el.
Zárja azzal, hogy melyik attribútumot hagyta ki tudatosan, és miért.
Elvárt formátum: egy ábra vagy vázlat a modellről + két táblázat + kb. 150 szavas indoklás.
Feladat 3. feladat – Bővítse az adatsort (45 perc)
Válasszon ki öt személyt a minta-adatsorból, és egészítse ki a rekordjukat egy új oszloppal: Iskola vagy Egyetem, ahol tanultak.
Keresse meg az adatot ellenőrizhető forrásból – az MTA akadémikusi adattárában (
akademikus.mtak.hu), és ha ott nincs, az Arcanum Újságokban vagy a Hungaricanán.Minden új adathoz rögzítse a forrást egy külön oszlopban.
Hány személynél nem találta meg az adatot? Írja le, mit jelent ez a populáció szempontjából: véletlenszerű a hiány, vagy összefügg valamivel (például azzal, hogy ki mennyire ismert)?
Elvárt formátum: az öt kiegészített sor + kb. 150 szavas reflexió a hiányokról.
Önellenőrző kérdések
1. Mikor indokolt adatbázist építeni táblázat helyett?
Válasz megjelenítése
Ha az esetek száma meghaladja a néhány tucatot, többváltozós adatokkal dolgozunk, és a kérdésünk összehasonlításra, arányokra vagy kapcsolatokra irányul.
2. Mi a három keretkérdés az adatgyűjtés előtt?
Válasz megjelenítése
Ki kerül az adatbázisba (beválogatási kritériumok); milyen időszakot fed le; és mik a fő kutatási kérdések, amelyek meghatározzák a gyűjtendő adatok körét.
3. Miért nem szabad felülírni az eredeti adatot tisztításkor?
Válasz megjelenítése
Mert a harmonizálási döntés később hibásnak bizonyulhat, és mert a forráshűség megköveteli, hogy visszanézhető legyen, mi állt eredetileg a forrásban. A tisztított érték új oszlopba kerül.
4. Mit jelent a „80 százalék elve”?
Válasz megjelenítése
Hogy nagyjából 80 százalékos adattisztaságtól már értelmes elemzéseket lehet végezni; a tökéletességre várva soha nem jutnánk el az elemzésig.
5. Mit jelent, ha egy oszlopban mind az ötven rekord ugyanazt az értéket tartalmazza?
Válasz megjelenítése
Nem feltétlenül azt, hogy az oszlop felesleges. A minta-adatsorban a
Nem oszlop mind az ötven rekordnál Férfi – és ez
maga a történeti megállapítás: az Akadémia első nemzedékében nem volt
nő. A hiányzó változatosság is adat.
6. Miért adhat rossz választ a tisztítatlan adat?
Válasz megjelenítése
Mert a gyakorisági kimutatás az írásmódokat számolja, nem a
kategóriákat. A minta-adatsor Vallás oszlopában a leggyakoribb
egyetlen érték az rk (10), miközben a hat különböző
írásmódú római katolikus tétel együtt 31 – vagyis abszolút többség. A
nyers adatból ennek az ellenkezője látszik, és semmi nem jelzi, hogy baj
van.
7. Miért mondjuk, hogy az adatmodell interpretáció?
Válasz megjelenítése
Mert a kutató dönti el, mely entitásokat, attribútumokat, relációkat és kategóriákat veszi fel – és minden ilyen döntés egyszerre tesz láthatóvá és rejt el valamit a vizsgált jelenségből.
Összefoglalás
Ebben a fejezetben végigvettük a saját adatbázis építésének teljes munkamenetét: a három keretkérdéstől az adatmodell tervezésén és a forrásválasztáson át az adattisztításig, a technikai megvalósításig és az etikai kérdésekig.
A legfontosabb üzenet ugyanaz, mint az Adat a történettudományban fejezeté: az adatmodell nem semleges. Amikor Ön eldönti, mely mezők kerüljenek az adatbázisba, egyben azt is eldönti, mi lesz látható és mi marad láthatatlan a kutatásában. Ezt a döntést dokumentálni kell – a dolgozat módszertani része nélkül az adatbázis nem értékelhető.
Az esettanulmány ezt egy konkrét számon mutatta meg: a minta-adatsor tisztítatlan felekezeti oszlopa az ellenkezőjét sugallta annak, ami a harmonizálás után kijött. A tisztítás tehát nem előkészület az elemzéshez – része az elemzésnek.
És van egy fordított haszna is: aki maga is épített adatbázist, az soha többé nem néz úgy egy találati listára, mintha az „a valóság” lenne.
Kulcsfogalmak
adattisztítás (harmonizálás) – Az adatbevitel utáni szakasz, amelyben az írásmódbeli, rövidítésbeli és kategorikus eltéréseket egységesítjük, az eredeti értékek megőrzése mellett.
attribútum – Egy entitás jellemzője, az adatbázis egy mezője (például születési év).
entitás – Az adatmodell egy önálló objektumtípusa (személy, intézmény, esemény, hely).
kódtábla – Feloldó tábla, amely a szabad szöveges értékeket szabványosított kategóriákhoz rendeli.
reláció – Két entitás közötti kapcsolat (például személy–intézmény, személy–személy).
relációs adatmodell – Több, egymással kapcsolatban álló táblába rendezett adatszerkezet.
verziózás – Az eredeti és a feldolgozott adat párhuzamos megőrzése a visszakövethetőség érdekében.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Ring Orsolya: Adat a történettudományban. ELTE BTK Történelem Segédtudományai Tanszék, 2026. 9. fejezet. https://ringorsolya.github.io/adat_tortenettudomany/
Linkek és eszközök
- A fejezet minta-adatsora:
mta-alapitok-1825-1850.xlsx– a kötetadatok/mappájában - MTA akadémikusi adattár – https://akademikus.mtak.hu/ – elérve: 2026. 08. 24.
- MTA 200 – https://mta200.hu/ – elérve: 2026. 08. 24.
- Ring Orsolya: Adat a történettudományban (online tankönyv) – https://ringorsolya.github.io/adat_tortenettudomany/ – elérve: 2026. 08. 20.
- Állambiztonsági archontológia (működő példa) – https://www.abtl.hu/ords/archontologia/f?p=108:1 – elérve: 2026. 08. 20.
Mesterséges intelligencia a történeti kutatásban
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 60 perc |
| Előfeltétel | Adat a történettudományban, Digitalizálás és OCR |
| Verzió / dátum | v0.1 / 2026. augusztus |
Miről szól ez a fejezet?
A mesterséges intelligencia ma a kutatás minden szakaszába beszivárog: keresésbe, fordításba, összefoglalásba, szövegírásba. Ez a fejezet nem azt mondja meg, hogy használja-e – hanem azt, hogy mire jó, mire nem, és milyen feltételekkel felelős a használata egy történeti kutatásban.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- saját szavaival elmagyarázza, mit csinál valójában egy nagy nyelvi modell, és miért félrevezető rá a „gondolkodik” szó;
- egy konkrét kutatási feladatról eldönti, hogy az MI-használat ajánlott, feltételes vagy kerülendő kategóriába esik-e, és indokolja a döntést;
- felismeri a hallucinációt egy MI által generált bibliográfiai tételen, és ellenőrzi azt a korábban tanult eszközökkel;
- alkalmazza az öt etikai alapelvet (transzparencia, validáció, felelősség, torzítástudatosság, kontextus) a saját munkájára;
- ismeri az ELTE történelem szakos hallgatóira vonatkozó MI-szabályozást;
- besorolja a saját feladatát a tiltott, a feltételesen megengedett és a dokumentálva megengedett használat közé;
- kitölti az MI-használati nyilatkozatot, és dokumentálja egy dolgozatban, hol és hogyan használt MI-t;
- megnevezi a kutatás azon lépéseit, ahol az MI a leginkább és ahol a legkevésbé megbízható;
- megkülönböztet legalább négy promptolási technikát, és tudja, miért kell a promptot dokumentálni.
Bevezetés
A Digitális bölcsészet fejezetben azt írtuk: a digitális eszközök nem helyettesítik a történészi kritikai gondolkodást. Az Adat a történettudományban fejezetben pedig azt, hogy minden algoritmus értékeket hordoz. A mesterséges intelligencia ennek a két állításnak a legélesebb próbája – mert olyan eszközről van szó, amely úgy tesz, mintha gondolkodna.
Ez a fejezet ezért nem eszközismertető. Nem azt sorolja fel, melyik alkalmazás mit tud – az úgyis változik hónapról hónapra. Azt mutatja meg, hogyan gondolkodjon róla.
1. Mi az MI, és mi nem?
A „mesterséges intelligencia” kifejezés félrevezető lehet. Pontosabb leírás:
Definíció Fogalom: nagy nyelvi modell (MI-alapú szöveggeneráló rendszer)
Statisztikai mintafelismerő rendszer, amely hatalmas szövegmennyiségen tanult, és valószínűségeket számol a következő szó, mondat vagy válasz előrejelzésére. Az outputja mindig valószínűségi becslés, nem tényleges tudás vagy megértés.
| Az MI nem | Az MI |
|---|---|
| nem „gondolkodik” | mintázatokat keres |
| nem „érti” a szöveget | valószínűségeket számol |
| nem rendelkezik tudatossággal vagy értékeléssel | statisztikai kapcsolatokat azonosít |
| nem képes valódi kreativitásra | a tréningadatok alapján „tanul” |
A működése két lépésre bontható. Tanulás: milliónyi szöveg feldolgozása, a nyelvi minták felismerése. Válaszadás: annak kiszámítása, mi a legvalószínűbb következő szó. Ezért igaz, hogy az eredmény mindig valószínűségi becslés.
Jó hasonlat rá a szuper könyvtáros: mindent látott, ami valaha megjelent, de nem érti a tartalmát. Tud mondani egy címet és egy összefoglalót – de nem tudja megmondani, igaz-e.
Figyelem A genAI nem Google kereső és nem is Wikipédia.
Ez a három dolog háromféleképpen működik, és a különbséget érdemes fejben tartani:
- a kereső dokumentumokat mutat, amelyek léteznek;
- a Wikipédia hivatkozott, közösségileg ellenőrzött szócikket ad;
- a generatív MI szöveget állít elő, amely lehet, hogy megfelel a valóságnak, és lehet, hogy nem.
Ugyanaz a modell egyetlen beszélgetésen belül is mondhat egymásnak ellentmondó dolgokat. Aki keresőként használja, rossz eszközt választott.
Ez ugyanaz a logika, amit az Adat a történettudományban fejezet 3.3 szakaszában a szövegelemző eszközökről mondtunk: matematikai modellek, amelyek statisztikai kapcsolatokat keresnek – nem értik a szöveget emberi értelemben.
Figyelem Az MI nem végzi el a forráskritikát.
A kurzus ismétlő feladatsora is így teszi fel a kérdést, és a válasz hamis: „a mesterséges intelligencia képes önállóan történelmi kontextusokat értelmezni forráskritika nélkül”.
Ahogy Drucker fogalmaz a digitális eszközökről általában: „A technológia nem gondolkodik helyettünk. Eszközöket biztosít, de az interpretáció felelőssége a kutatóé marad.”
2. Mikor hasznos az MI a történésznek?
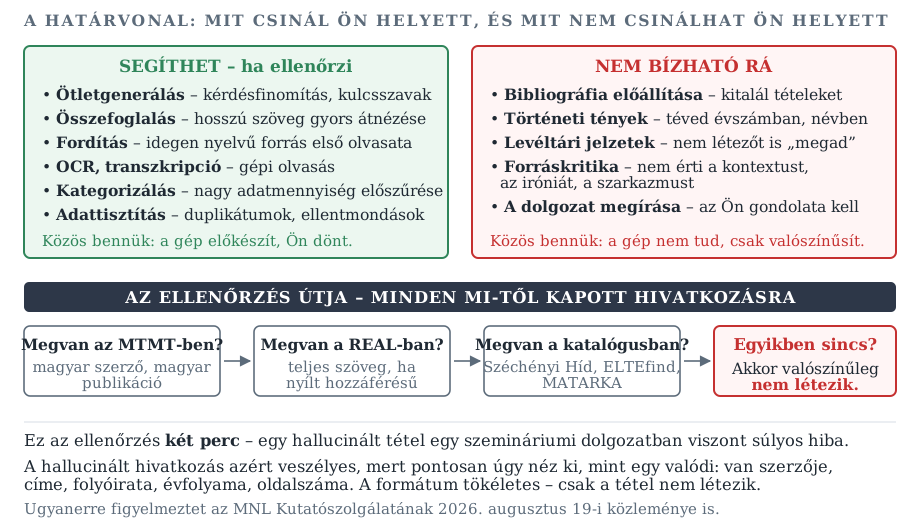
2.1 Lehetséges használati területek
- Ötletgenerálás. Kutatási kérdések finomítása, kulcsszavak javaslása. Ez jól kiegészíti a Hogyan épül fel egy történeti kutatás? fejezet kérdésélesítő feladatát.
- Összefoglalás. Hosszú szövegek gyors átolvasása – de mindig ellenőrizendő.
- Fordítás. Idegen nyelvű források első áttekintése.
- OCR és transzkripció. Nyomtatott vagy kézírásos dokumentumok gépi olvasása (lásd a Digitalizálás és OCR fejezetet).
- Kategorizálás. Nagy mennyiségű adat előszűrése – de a validálás kötelező.
- Adattisztítás. Duplikátumok, inkonzisztenciák keresése.
Figyelem Ez a lista arról szól, mire alkalmas az MI – nem arról, hogy Ön mit használhat.
A fenti felsorolás a technológia általános képességeit írja le. Hogy ebből egy BA-s történelemhallgató mit vehet igénybe egy beadandó dolgozathoz, azt nem ez dönti el, hanem a Történeti Intézet szabályzata, amelyet a 4. szakasz tárgyal. A kettő nem ugyanaz, és a különbség jelentős:
| A 2.1 pontjai | Mi vonatkozik rá BA szinten? |
|---|---|
| Ötletgenerálás, kulcsszavak | A „kezdeti tájékozódás” esete: előzetes írásbeli oktatói engedéllyel (4.2. pont), és nem helyettesíti a szakirodalmi kutatást |
| Összefoglalás | Szakirodalomra tilos, még ellenőrzéssel is (4.1. pont); elsődleges forrás összefoglalása szintén tilos |
| Fordítás | Oktatói engedéllyel megengedett, szakmai ellenőrzéssel; a pontosságért Ön felel (4.2. pont) |
| OCR és transzkripció | A szabályzat 4.1. pontja nem tiltja, de a 3.6. pont miatt nem publikált levéltári forrás nem tölthető fel MI-rendszerbe |
| Kategorizálás, adattisztítás | Saját kutatási adaton – a 4.1. pont tiltásai a szövegre és a szakirodalomra vonatkoznak, nem erre; a validálás így is kötelező |
Röviden: ebből a hat pontból BA-n egy sem használható szabadon. Mielőtt bármelyikhez nyúlna, olvassa el a 4. szakaszt, és ha kétsége van, kérdezze meg az oktatóját – írásban.
2.2 Problematikus vagy veszélyes használat
- Bibliográfia generálása. Az MI hallucinál: kitalál nem létező cikkeket és szerzőket, meggyőző formában.
- Tényszerű történeti adatok. Téved évszámokban, személynevekben, eseményekben.
- Forráskritika. Nem érti a kontextust, nem ismeri fel a szarkazmust vagy az iróniát.
- A végső szöveg megírása. Az MI nem helyettesítheti a kutató saját gondolatait.
Ez a szakasz arról szól, hogy mikor megbízhatatlan az eredmény. A 4. szakasz egy másik kérdésre válaszol: mit szabad – és ott kiderül, hogy a fenti lista több eleme az ELTE történelem BA-n nem csak kockázatos, hanem kifejezetten tilos, akkor is, ha Ön mindent leellenőriz.
Definíció Fogalom: hallucináció
Az a jelenség, amikor az MI valósnak látszó, de nem létező információt állít elő – például pontos formátumú, ám kitalált bibliográfiai tételt, hamis évszámot vagy nem létező levéltári jelzetet. Nem üzemzavar: a valószínűségi szövegelőrejelzés természetes következménye.
Figyelem A hallucinált hivatkozás a legveszélyesebb hibatípus
Miért? Mert pontosan úgy néz ki, mint egy valódi hivatkozás: van szerzője, címe, folyóirata, évfolyama, oldalszáma. A formátum tökéletes – csak a tétel nem létezik.
Szerencsére Ön már ismeri az ellenszert. Minden MI-től kapott hivatkozást ellenőrizzen le az MTMT-ben, a REAL-ban vagy a könyvtári katalógusban. Ha egyikben sincs meg, akkor nagy valószínűséggel nem létezik. Ez két perc – egy hallucinált tétel egy szemináriumi dolgozatban viszont súlyos hiba.
2.3 Végig a kutatás lépésein
A „mire jó / mire nem” kérdésre pontosabb választ kapunk, ha végigmegyünk azokon a lépéseken, amelyeket a Hogyan épül fel egy történeti kutatás? fejezet írt le. Minden lépésnél más az előny és más a korlát.
| A kutatás lépése | Amiben segíthet | Ahol elromlik |
|---|---|---|
| Kutatási kérdés, célkitűzés | Egy téma gyors áttekintése, a főbb események feltérképezése, fogalmak javaslása | Pontos kérdés nélkül felszínes és általános marad; nem tudja megkülönböztetni a valódi kutatási rést a már feltárt területektől |
| Források és szakirodalom azonosítása | Nagy szövegmennyiségben kulcsszavak, dátumok, nevek, akár kapcsolati hálók keresése | Nem ismeri fel a kontextust – a szarkazmust, az iróniát, a rejtett politikai utalást –, és nem érti a forrás keletkezési körülményeit |
| Historiográfiai áttekintés | Egy témakör kutatástörténetének gyors áttekintése, időbeli trendek | Csak azt „látja”, ami digitalizálva van; erős az angol nyelvű túlsúly; a legfrissebb kutatásokat nem ismeri. Kiindulópont, nem végpont. |
| Digitalizálás, OCR, képfelismerés | Nyomtatott és kézírásos szöveg olvasása; a képen látható öltözködés, építészet, tárgyak alapján datálási javaslat, képaláírás-ötlet | Nem ismeri a helyi viszonyokat, könnyen téved; propagandaképek elemzése felszínes vagy hiányos marad |
| Források kritikai értékelése | Előszűrés: stilisztikai anomáliák, esetleg hamisítványgyanú jelzése | Itt pótolhatatlan a történész. Politikailag érzékeny korszakokban – például az 1950-es évek pereinek iratainál – nem tudja elválasztani a propagandát a valóságtól, sem az elhallgatást a valós adattól |
| Adatok rendszerezése, elemzése | Nagy szövegmennyiség kategorizálása, idővonalak, hálózatelemzés | Csak azt látja, amit az adat tartalmaz: a szándékos elhallgatásokat és a forrásban rejlő elfogultságot nem tudja azonosítani |
| Interpretáció, kontextualizálás | Párhuzamos források összevetése, mintázatok, alternatív narratívák felvetése | Hajlamos a narratívák homogenizálására: elsimítja a disszonáns hangokat és az egyéni tapasztalatot |
Figyelem A hibák teljes listája – amire számítani kell
A hallucináció csak az egyik. A többi:
- tényadatok összekeverése – két valós dolog összemosása;
- anakronizmus – mai fogalom visszavetítése egy korábbi korszakra;
- ideológiai torzítás – a tréningadatok politikai súlypontjainak átvétele;
- a kontextus félreértése;
- nyelvi akadályok – magyar anyagon gyengébb, mint angolon;
- a felületes narratíva megerősítése – azt mondja vissza, ami a leggyakoribb, nem azt, ami a legpontosabb.
És a legnagyobb kockázat, amely nem a gépé, hanem a használóé: hogy elvész a forráskritika és a kritikai gondolkodás gyakorlása. Az MI kényelmes, gyors, és a válaszai látszólag logikusak és hihetőek. Éppen ez teszi veszélyessé.
Mélyebben RAG-rendszerek: miért hallucinál kevesebbet némelyik eszköz?
A RAG (Retrieval-Augmented Generation, visszakeresés-alapú generálás) két lépésben dolgozik. Először visszakeres: a kérdésre egy megadott dokumentumgyűjteményben – például egy publikációs adatbázisban vagy egy kurzusanyagban – megkeresi a releváns részeket. Azután generál: a megtalált dokumentumokból fogalmazza meg a választ, nem a modell „emlékezetéből”.
Ennek négy előnye van: pontosság (nem talál ki tényeket, mert konkrét forrásokból dolgozik), naprakészség (a legfrissebb betöltött anyaggal dolgozik), ellenőrizhetőség (hivatkozik a forrásokra) és testreszabhatóság (saját szövegkorpuszon is működhet).
Ez ugyanaz a logika, amit a 6. szakasz vezérelve mond: adjon szöveget, ne kérjen tényt. A RAG lényegében beépíti ezt a szabályt az eszközbe.
De: ha saját korpuszt tölt be, azzal adatot ad át. Hogy mi lesz a betöltött adattal, az a szolgáltató beállításain múlik – és a személyes adatokra a 4.4 szakasz tilalma akkor is érvényes, ha az eszköz „csak” visszakeres.
Mélyebben Melyik eszközt mire?
Az eszközök gyorsan változnak, ezért itt nem konkrét termékajánlás következik, hanem egy szempont: feladatfüggő, mit érdemes használni. A fejezet szerzője saját tapasztalata alapján a következőket emeli ki – ezt a saját feladatán mindenkinek érdemes újratesztelnie:
- összefoglalásra a hosszabb, folyó szöveget adó modellek váltak be;
- rövid, tényalapú válaszra azok, amelyek mindig mellékelnek forrást is – ezek ellenőrizhetőbbek, mert a hivatkozásra rá lehet kattintani;
- árnyalt, esszészerű kifejtésre azok, amelyek hosszabb kontextussal dolgoznak.
A történész szempontjából az a fontos, hogy melyik ad ellenőrizhető kimenetet. Egy forrásmegjelöléssel érkező, rövid válasz kevesebbet mond, de többet ér, mint egy hivatkozás nélküli, magabiztos esszé.
Mélyebben Digitális egyenlőtlenségek
Érdemes tudni, hogy ez nem tisztán módszertani kérdés. A jobb modellek jellemzően előfizetéshez kötöttek, és nem mindenkinek van rá pénze; az egyetemi előfizetések köre változik. Ehhez jön a nyelvi egyenlőtlenség: ugyanaz a modell magyarul rendszerint gyengébben teljesít, mint angolul.
Ebből két dolog következik. Egyrészt méltányossági kérdés, hogy a tehetősebb hallgatónak jobb eszköz áll-e rendelkezésére. Másrészt – és ez az Ön szempontjából a gyakorlati tanulság – a magyar történeti témában tapasztalt gyengébb teljesítmény nem az Ön hibája, hanem a technológia korlátja. Ne próbálja meg jobb kérdésekkel kikényszeríteni azt, amit a modell nem tud.
3. Etikai alapelvek
Tipp Öt alapelv az MI felelős használatához
Transzparencia – Mindig dokumentáljuk, mit használtunk MI-ra és hogyan.
Validáció – Soha ne fogadjunk el MI-outputot ellenőrzés nélkül.
Felelősség – A kutató felel az eredményért, nem az MI.
Torzítástudatosság – Az MI tükrözi a tréningadatok torzításait: az angolszász, nyugati, mainstream perspektívák túlsúlyát.
Kontextus – Az MI nem érti a történeti kontextust és a kulturális árnyalatokat.
A torzítástudatosság magyar viszonylatban külön figyelmet érdemel. A modellek túlnyomórészt angol nyelvű korpuszokon tanultak; a magyar történelem eseményeiről, személyeiről és intézményeiről lényegesen kevesebb és gyakran gyengébb minőségű adatot láttak. Ebből következik, hogy magyar történeti témában gyakoribb és magabiztosabb tévedéseket produkálnak, mint például brit vagy amerikai kérdésekben.
Mélyebben Hogyan dokumentáljuk az MI-használatot?
A transzparencia elve akkor működik, ha konkrét. Egy dolgozat módszertani részében vagy lábjegyzetében érdemes megadni:
- melyik eszközt használta (megnevezés, verzió, ha ismert);
- mikor (a modellek változnak, a dátum a reprodukálhatóság része);
- mire pontosan (fordítás? összefoglalás? kulcsszójavaslat?);
- hogyan ellenőrizte az eredményt.
Például: „A 3. fejezet német nyelvű forrásrészleteinek első nyersfordításához MI-alapú fordítót használtam (2026. március); a fordításokat a szövegben felhasznált minden idézet esetében az eredeti alapján ellenőriztem és javítottam.”
4. Mit szabad? Az ELTE szabályozása
Az MI-használat nem magánügy és nem ízlés kérdése. 2025 őszétől az ELTE-n írott szabály mondja meg, mit szabad egy beadandó dolgozatban – és a megsértése ugyanolyan megítélés alá esik, mint a plágium.
A szabály három szinten épül egymásra, és mindig a szűkebb az irányadó.
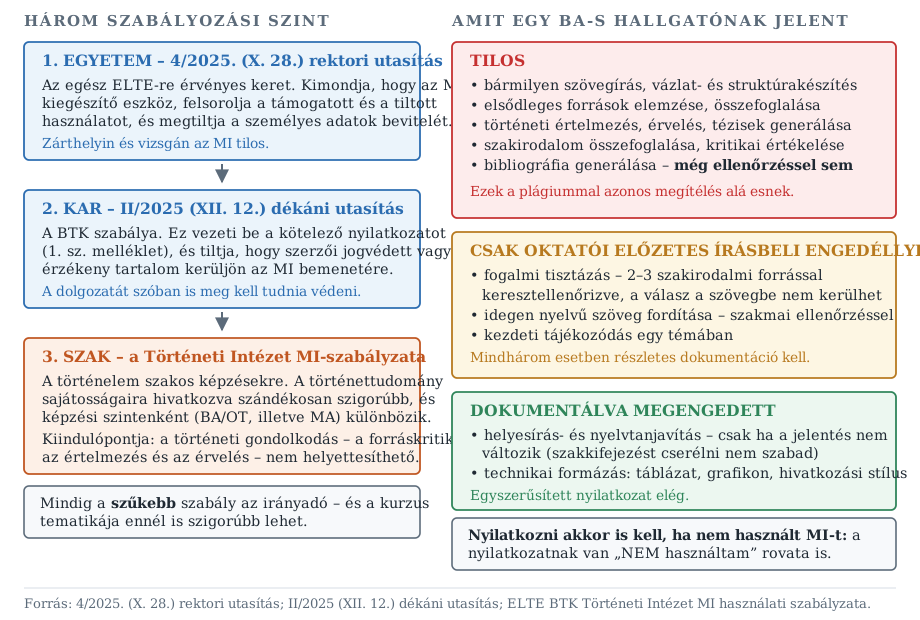
4.1 Az első szint: a rektori utasítás
A 4/2025. (X. 28.) rektori utasítás az egész egyetemre érvényes keret. Fontos látni, hogy ez nem tiltó, hanem engedő szabály: az Egyetem „a legteljesebb mértékben támogatja az MI alapú megoldások és alkalmazások felelős és etikus használatát”, méghozzá a hallgatói munka minden szakaszában. Ugyanakkor kimondja, hogy az MI-eszközök „kiegészítő, támogató szerepben (pl. kutatási asszisztensként, tanulótársként)” alkalmazhatók, és „nem léphetnek az önálló hallgatói munka helyébe” (3.1–3.2. pont).
Amit érdemes fejben tartani belőle:
- Az MI használata nem kötelező (3.3. pont). Ön dönti el, él-e vele, és azt is, melyik eszközzel. Ez fordítva is igaz: senkit nem érhet hátrány azért, mert szabályosan használt MI-t (3.8. pont).
- Zárthelyi dolgozaton és vizsgán tilos – ezek önálló munkavégzés eredményei (6.2. pont).
- Tilos az MI-t szerzőként feltüntetni. Az utasítás indoklása pontos: a szerzőség „a szellemi alkotásért való felelősséget” is jelenti, amit egy MI-rendszer nem tud viselni (4.1. pont).
- A hallgató felel „a szövegben szereplő tévedésekért”, a következtetések megalapozottságáért, valamint „a források és a hivatkozások valóságtartalmáért” (3.12. pont). Vagyis a hallucinált hivatkozás nem az MI hibája lesz, hanem az Öné.
- Az utasítás technológiasemleges (2.4. pont): nem eszközöket sorol fel, hanem használati módokat szabályoz. Attól, hogy egy alkalmazás új, vagy hogy „csak” egy böngészőbe épült segéd, még ugyanúgy MI-eszköz.
Mélyebben Mit tekint az utasítás MI-eszköznek?
A 2.3. pont szerint MI-eszköz minden olyan megoldás, amely „képes tartalmat generálni, átalakítani, kivonatolni, fordítani, strukturálni, elemezni, osztályozni, értékelni vagy ezekhez segítséget nyújtani a tanulmányi és kutatási feladatok bármely fázisában, függetlenül a megoldás szolgáltatójától és hozzáférhetőségétől”.
A Történeti Intézet szabályzata ehhez hozzáteszi, mi nem MI-eszköz: a hagyományos helyesírás-ellenőrző, a szótár alapú egyszerű fordítóprogram, valamint a statisztikai szoftverek és adatbázis-kezelők (2.1. pont). Tehát az Excel-táblázata vagy a szövegszerkesztő piros aláhúzása miatt nem kell nyilatkoznia.
4.2 A második szint: a BTK dékáni utasítása
A II/2025 (XII. 12.) dékáni utasítás a Bölcsészettudományi Karra vonatkozik, és három dolgot tesz hozzá a rektori kerethez.
(1) Bevezeti a kötelező nyilatkozatot. A dékáni utasítás 1. sz. melléklete a „Nyilatkozat mesterségesintelligencia-eszköz felhasználásáról”, amely a szakdolgozat és a diplomamunka kötelező eleme. Más beadandó munkánál akkor kell mellékelni, ha a tárgy tematikája előírja – ezért érdemes a tematikát az első héten elolvasni.
(2) Megmondja, mi nem lehet az MI bemenete. A hallgató „nem alkalmazhat bemenetként olyan dokumentumokat és multimédiás tartalmakat, amelyeket szerzői jog véd”, sem érzékeny adatokat, sem nem megbízható MI-szolgáltatásból szerzett, szerzői jogvédett tartalmakat. Szerzői jogvédett tartalmat csak megbízható MI-szolgáltatás keretében – az utasítás példái: az egyetemi Teams, a Copilot – használhat bemenetként, és akkor is csak a tanulás és a kutatás segítésére, „a hallgatói mű szövegének megalkotására nem”.
Ez a gyakorlatban komoly korlát. Egy PDF-ben letöltött, jogvédett tanulmány feltöltése egy nyilvános MI-alkalmazásba – hogy foglalja össze – a dékáni utasítás szerint nem megengedett bemenet.
(3) Kimondja a szóbeli védhetőség követelményét. „A hallgató felelőssége […] arra is kiterjed, hogy benyújtott írásművét képes legyen szóban is megvédeni.” Ez a legjobb önteszt, amit egy dolgozatra el lehet végezni: ha valamit nem tud elmagyarázni a saját szavaival, az a rész nem az Öné.
Figyelem Az értékelhetetlenség
A dékáni utasítás nem „pontlevonást” helyez kilátásba. Ha a bírálónak tudományetikai vétséget kell megállapítania – plágiumot, vagy az MI-eszköz dokumentálatlan, illetve tiltott használatát –, akkor a hallgató tudományos munkáját értékelhetetlennek kell minősítenie.
Mi az a „megbízható MI-szolgáltatás”?
A dékáni utasítás egyetlen zárójeles példát ad rá: „pl. egyetemi Teams, Copilot”. Érdemes pontosan érteni, mit jelent ez – mert a hallgatók rendszerint túl sokat olvasnak ki belőle.
A szabály nem egy eszközt engedélyez, hanem egy környezetet. A különbség nem az, hogy melyik modell okosabb, hanem hogy hol landol a bemenet: az egyetem szerződéses keretében, egyetemi fiókkal használt szolgáltatásban, vagy egy nyilvános felületen, ahová bárki bejelentkezhet.
Amit felold. Egy jogvédett tanulmányt nem tölthet fel egy nyilvános MI-alkalmazásba, az egyetemi Teamsen belül viszont felhasználhatja – de az utasítás ott is hozzáteszi, hogy csak „a tanulási és kutatási folyamat segítésére”, és „a hallgatói mű szövegének megalkotására nem”.
Figyelem Amit a megbízható környezet NEM old fel
Ez a fejezet legkönnyebben félreérthető pontja. A gondolatmenet, amely tévút: „ez az egyetemi Teams, tehát ide mindent bevihetek.”
| Amit be akar vinni | Nyilvános MI | Egyetemi Teams / Copilot |
|---|---|---|
| Jogvédett tanulmány, könyvrészlet | tilos | megengedett – tanulás és kutatás segítésére |
| Személyes adat | tilos | továbbra is tilos |
| Nem publikált levéltári forrás, kéziratos dokumentum | tilos | továbbra is tilos |
| Oral history interjú átirata | tilos | továbbra is tilos |
| Publikálatlan kutatási eredmény | tilos | továbbra is tilos |
A Történeti Intézet szabályzatának 3.6. pontja ugyanis nem a szolgáltató szerint tesz kivételt, hanem egyetlen módon: a témavezető vagy kutatásvezető kifejezett írásos engedélyével. A rektori utasítás 4.3. pontja pedig a személyes adatoknál az egyetemi adatvédelmi és adatkezelési szabályzatnak való megfelelést kívánja meg – nem azt, hogy melyik felületet használja.
És ami szintén változatlan: a 4.3 szakasz BA-szintű tiltásai (szövegírás, vázlat, forráselemzés, szakirodalom-összefoglalás, bibliográfia), valamint a nyilatkozattételi kötelezettség. Attól, hogy egyetemi eszközt használ, a használat nem lesz dokumentálatlan.
Egy mondatban összefoglalva: a megbízható környezet azt bővíti, amit be szabad vinni – nem azt, amit szabad vele csinálni.
Tipp Honnan tudja, hogy tényleg a védett környezetben van?
Onnan, hogy melyik fiókkal van bejelentkezve. Ugyanaz a Copilot-felület egyetemi fiókkal más jogi helyzetben van, mint magánfiókkal – ez utóbbi egyszerűen a nyilvános szolgáltatás. Belépés előtt nézze meg a fiók nevét, és ha bizonytalan, kezelje nyilvánosnak.
Ez a különbségtétel az egyetlen ok, amiért ez az alszakasz egyáltalán a tankönyvben van. Az eszközök nevei és felületei félévente változnak; a kérdés – hol landol a bemenet, és ki fér hozzá? – nem.
Ugyanez a logika érvényes az Oral history fejezet gépi leiratozásra vonatkozó szakaszára is: egy interjúfelvétel személyes adatot tartalmaz, ezért a megbízható környezet önmagában azt sem teszi feltölthetővé.
4.3 A harmadik szint: a Történeti Intézet szabályzata
Az ELTE BTK Történeti Intézete a történelem szakos képzésekre külön szabályzatot adott ki. Ez a fejezet szempontjából a legfontosabb dokumentum, mert saját bevallása szerint „a történettudomány sajátosságaira tekintettel szigorúbb rendelkezéseket tartalmaz” a felette álló két utasításnál.
A szigor indoka egyetlen mondatban áll a szabályzat elején, és pontosan az, amiről ez az egész könyv szól:
„A történeti gondolkodás nem helyettesíthető: A forráskutatás, forráskritika, értelmezés, érvelés és narratívaalkotás alapvető készségek, amelyek fejlesztése nem kerülhető meg mesterséges intelligencia használatával.”
A szabályzat négy alapelve: a történeti gondolkodás nem helyettesíthető – átláthatóság – fokozatosság (a BA és az MA szintre más szabályok vonatkoznak) – felelősség.
A fokozatosság elve azt jelenti, hogy alapképzésben szigorúbbak a szabályok, mint mesterszakon. Ennek megvan a maga logikája: a BA az a szint, ahol ezeket a készségeket meg kell szerezni. Aki az elsajátításuk közben adja ki őket egy gépnek, az nem időt spórol, hanem a képzés lényegét hagyja ki.
Figyelem Ami BA és OT szinten kifejezetten TILOS
A szabályzat 4.1. pontja szerint:
- bármilyen MI-használat szövegírásra, vázlatkészítésre – bekezdés, fejezet, mondat, érvelési lánc, sőt a dolgozat struktúrájának generálása is;
- forráselemzés, forráskritika MI-készítése – elsődleges források elemzése, összefoglalása, hitelességük gépi értékelése, a történeti kontextus MI általi rekonstruálása;
- történeti értelmezés, érvelés MI-formulázása – magyarázatok, ok-okozati elemzések, tézisek és ellenérvek generálása;
- szakirodalom összefoglalása, kritikai értékelése MI-vel;
- bibliográfia generálása MI-vel – „még ellenőrzéssel sem”.
Ez az utolsó pont az, ami sokakat meglep. A 2.2 szakaszban azt írtuk: a hallucinált hivatkozást ellenőrzéssel ki lehet szűrni. Igaz – de BA szinten a szabályzat ennél tovább megy, és magát a generálást tiltja. A szakirodalom felkutatása ugyanis nem adminisztratív segédmunka: az a kutatás egyik érdemi része, és a 2. rész fejezeteinek épp ez a tárgya.
Tipp Ami BA szinten oktatói engedéllyel megengedett
A 4.2. pont három ilyen esetet ismer. Mindhárom előzetes, írásbeli oktatói engedélyhez és teljes dokumentációhoz kötött:
| Használat | A kötelező feltétel |
|---|---|
| Fogalmi tisztázás – egy történeti fogalom első magyarázata | Minimum 2-3 szakirodalmi forrás keresztellenőrzése; az MI válasza a végleges szövegbe nem kerülhet bele |
| Idegen nyelvű szöveg fordítása | Szakmai ellenőrzés; a pontosságért a hallgató felel |
| Kezdeti tájékozódás egy témában | Nem helyettesíti a szakirodalmi kutatást |
A „nem kerülhet bele a végleges szövegbe” megkötés a legfontosabb. Az MI ezekben az esetekben belépő lehet egy témába, nem pedig alapanyag a dolgozathoz.
Tipp Ami BA szinten dokumentálva megengedett
A 4.3. pont szerint két dolog:
a) Nyelvtani és helyesírási ellenőrzés (proofreading). Megengedett a helyesírási és nyelvtani hibák, az írásjelek javítása, sőt az egyszerű mondathibáké (például a félreérthető szórendé) is – de csak akkor, ha a jelentés nem változik. Nem megengedett viszont szavak cseréje, „különösen tekintettel a szakkifejezésekre”, ha azok új jelentést adnak, és nem megengedett tartalom hozzáadása vagy elvétele.
b) Technikai formázás. Táblázatok, grafikonok formázása, hivatkozási stílusok formázása.
Ilyenkor egyszerűsített dokumentáció elég: mire használta, milyen eszközzel, plus a mondat, hogy „A tartalom NEM változott, csak nyelvtani és helyesírási hibákat javítottam.”
Gyakorló: tiltott, feltételes vagy megengedett?
Tíz eset, mindegyik alapképzésre (BA, OT) vonatkozik. Sorolja be őket a Történeti Intézet szabályzatának három kategóriájába.
Feladat Tiltott, feltételes vagy megengedett?
Sorolja be az alábbi tíz esetet – mindegyik alapképzésre vonatkozik.
| Mit csinál a hallgató? | Besorolás |
|---|---|
| Megíratja a bevezetőt, aztán átfogalmazza | Tiltott |
| Kijavíttatja a vesszőhibákat, a tartalom nem változik | Dokumentálva megengedett |
| Bibliográfiát generáltat, majd minden tételt ellenőriz | Tiltott |
| Német forrásrészletet fordíttat, majd szakmailag ellenőrzi | Csak oktatói engedéllyel |
| Összefoglaltatja a kötelező szakirodalmat | Tiltott |
| Megformáztatja a táblázatokat és a hivatkozási stílust | Dokumentálva megengedett |
| Fogalmat tisztáztat, két forrással ellenőrzi, a választ nem teszi a szövegbe | Csak oktatói engedéllyel |
| Vázlatot és fejezetcímeket generáltat | Tiltott |
| Feltölti egy publikálatlan levéltári irat fotóját kézírás-kiolvasásra | Tiltott |
| Általános tájékozódást kér egy új témában | Csak oktatói engedéllyel |
Két csapda: a bibliográfiánál az ellenőrzés nem old fel tiltást, a levéltári iratnál pedig nem a képzési szint dönt, hanem a 3.6. pont adatvédelmi tilalma. És bármelyik kategóriába esik: nyilatkozni mindig kell.
Mélyebben És mesterszakon?
A szabályzat MA szinten feltételesen megengedi azt is, ami BA-n tiltott vagy engedélyhez kötött: a szakirodalmi keresések finomítását és kulcsszavak generálását (minden eredmény emberi validálásával), a digitalizált források kezdeti csoportosítását (témavezetői engedéllyel, módszertani leírással és a korlátok tárgyalásával), a fordítást és a technikai segítséget. A tiltás ugyanakkor MA-n is áll a történeti narratíva és érvelés generálására, a forráskritikára, a szakdolgozati fejezetek megírására, a historiográfiai vita szintetizálására és a validálatlan bibliográfiára.
Cserébe MA-n több a kötelező reflexió: minden egyéb használati esetnél le kell írni az MI korlátait a konkrét feladatban, az észlelt problémákat és hallucinációkat, a validálás módját és a hozzáadott érték értékelését.
Ha tehát Ön most BA-s, és később mesterszakra megy, a szabályok nem eltűnnek, hanem átalakulnak: a tiltásból dokumentált, kritikailag reflektált használat lesz. Ez is a fokozatosság elve.
4.4 Adatvédelem: amit soha nem tehet be egy MI-be
Ez a szakasz akkor is érvényes, ha egyébként minden más szabálynak megfelel – és ez a fejezet legkeményebb pontja. A Történeti Intézet szabályzatának 3.6. pontja szerint szigorúan tilos MI-rendszerbe bevinni:
- nem publikált levéltári források, kéziratos dokumentumok szövegét;
- személyes adatokat a GDPR értelmében;
- oral history interjúk átirataiban szereplő személyes adatokat;
- még nem publikált kutatási eredményeket.
Kivétel csak a témavezető vagy a kutatásvezető kifejezett írásos engedélye esetén van. A szankció itt nem pontlevonás: az adatvédelmi előírások megsértése súlyos fegyelmi vétség.
Ugyanezt a tilalmat a rektori utasítás 4.3. és 6.4. pontja is kimondja, hozzátéve az indokot: „a legnagyobb platformok az esetek többségében nem kezelik bizalmasan a megosztott információkat vagy a személyes adatokat”.
Figyelem Miért éppen a történészhallgatót érinti ez ennyire?
Mert a mi forrásaink jellemzően pontosan ilyenek. Egy kutatótermi jegyzet egy még nem publikált iratról, egy anyakönyvi bejegyzés fotója, egy családtagról készült interjú átirata, egy 1950-es évekbeli személyzeti dosszié – ezek mindegyike beletartozik a tiltott bemenetek közé.
„Csak lefordíttattam”, „csak összefoglaltattam”, „csak legépeltettem” – a szabályzat szempontjából ezek nem mentségek, mert a tilalom a bevitelre vonatkozik, nem arra, hogy mit kért a géptől.
Arról, hogy pontosan mi minősül személyes és mi különleges adatnak, és mikor szűnik meg az élő személy adatainak védelme, az Adatkezelés és adatvédelem fejezet szól.
4.5 A nyilatkozat
A dokumentálás nem utólagos formaság, hanem a szabályos használat feltétele: a rektori utasítás 5.2. pontja szerint „a támogatott használat csak dokumentálás mellett jogszerű”.
A BTK nyilatkozata (dékáni utasítás 1. sz. melléklet) így épül fel:
- a hallgató neve, szakja, az írásmű címe;
- annak igazolása, hogy megismerte a plágium fogalmát, a HKR 74/A–C. §-át, a rektori és a dékáni utasítást;
- kijelentés, hogy az MI-eszközöket kizárólag segédeszközként használta a kutatásához, és „MI által generált szövegrészeket nem vettem át”;
- egy táblázat, amely négy dolgot kér: milyen céllal? milyen módon? mely MI-eszközt használtam? a dolgozat mely részében? – ahol a szakos szabályozás előírja, a második oszlopban a promptolás pontos dokumentálása is megadandó;
- annak tudomásulvétele, hogy az MI-tartalom átvétele, a dokumentációs kötelezettség elmulasztása és a valótlan tartalmú nyilatkozat egyaránt a plágiummal azonos megítélés alá esik.
A Történeti Intézet ehhez saját, minden beadandó feladathoz kötelező nyilatkozatot ír elő (6.1. pont), amelynek van egy fontos rovata:
Tipp Akkor is nyilatkozzon, ha nem használt MI-t.
Az intézeti nyilatkozat két kipipálható sora közül az egyik így szól: „NEM használtam mesterséges intelligencia alapú eszközt.” A nyilatkozat tehát nem a bűnösök vallomása, hanem minden dolgozat kísérőlapja. Ha nem használt MI-t, ezt kell megjelölnie – nem pedig a nyilatkozatot elhagynia.
Ha viszont használt, a dokumentációnak négy dologra kell kitérnie: milyen célra, milyen eszközzel, hogyan ellenőrizte az eredményt (a validálás módja), és milyen problémákat, korlátokat tapasztalt – plusz az oktatói engedélyre, ha kellett hozzá.
Vegye észre, hogy ez majdnem szó szerint ugyanaz a négy kérdés, amit a 3. szakasz Mélyebben doboza a transzparenciáról mondott. Nem véletlen: a szabályzat itt egy jó kutatási szokást emel kötelező formába.
4.6 Ha valaki megsérti
A Történeti Intézet szabályzata három súlyossági fokot különböztet meg (8.1–8.3. pont):
| Fokozat | Idetartozik |
|---|---|
| Súlyos – a plágiummal azonos megítélés | MI-szöveg sajátként való benyújtása; forráselemzés, értelmezés, érvelés MI-generálása dokumentáció nélkül; hamis bibliográfiai hivatkozás; hamis nyilatkozat; az adatvédelmi előírások súlyos megsértése |
| Közepes | a dokumentációs kötelezettség elmulasztása; az MI-output nem megfelelő kritikai értékelése; oktatói engedély nélküli, de nem tiltott használat |
| Enyhe | formailag hiányos dokumentáció; a nyilatkozat apróbb formai hibái |
Egyetemi szinten a tiltott használat a HKR 74/A–74/B. § szerinti jogsértő magatartással esik egy megítélés alá, és a 74/C–74/D. § szerinti jogkövetkezményeket vonja maga után; súlyos esetben fegyelmi eljárást.
5. Mit mondanak a közgyűjtemények?
Nem csak az egyetem foglal állást. A forrásokat őrző intézmények is figyelmeztetnek – éppen arra a hibatípusra, amelyről a 2. szakasz szólt.
Figyelem A Magyar Nemzeti Levéltár Kutatószolgálatának közleménye
2026. augusztus 19-én az MNL Kutatószolgálata közleményt adott ki, amelyben felhívja a kutatók figyelmét arra, hogy a mesterséges intelligencia „gyakran szolgáltat téves vagy valótlan információkat, ezért az általa adott válaszok nem tekinthetőek önmagukban hiteles forrásnak”.
A közlemény kéri a kutatókat, hogy elsődlegesen a hivatalos levéltári nyilvántartásokat és segédleteket használják – az Elektronikus Levéltári Portált és az AdatbázisokOnline felületét –, és hogy az MI-eszközöktől kapott információkat minden esetben vessék össze ezekkel.
Ez a figyelmeztetés nagyon is konkrét jelenségre válaszol: a nyelvi modellek valósnak látszó, de nem létező levéltári jelzeteket állítanak elő. Egy jelzet formailag mindig helyesnek fog tűnni – ellenőrizni csak a nyilvántartásban lehet.
Forrás: MNL Kutatószolgálat, „Közlemény a mesterséges intelligencia használatáról a kutatás során”, 2026. 08. 19.
Tipp Nézze meg a saját kurzusa szabályait is. A 4. szakasz három szintje a minimum – a kurzus tematikája ennél szigorúbb (vagy egy MI-tárgyú kurzuson megengedőbb) lehet, és a rektori utasítás 3.6. pontja szerint ezt a tárgyleírásban közölni kell.
Ha egy feladatnál nem világos, mi megengedett, kérdezze meg az oktatót, és a választ kérje írásban – a feltételes használatokhoz amúgy is előzetes írásbeli engedély kell. A hallgatáson múló félreértés a hallgatót terheli.
6. Gyakorlati fogások, amelyek csökkentik a kockázatot
Az MI-t nem az teszi használhatóvá, hogy okosabb kérdést tesz fel neki, hanem az, hogy olyan feladatot ad neki, amelynek az eredményét ellenőrizni tudja.
| Kockázatos használat | Biztonságosabb változat |
|---|---|
| „Sorolj fel öt tanulmányt a filoxéráról.” | „Ez a bekezdés a filoxéráról szól – javasolj kulcsszavakat, amelyekkel kereshetek rá a MATARKA-ban.” |
| „Mikor volt a filoxéravész Magyarországon?” | „Ebben a beillesztett szövegben mely évszámok szerepelnek a filoxérával kapcsolatban?” |
| „Foglald össze a szakirodalmat.” | „Foglald össze ezt a tanulmányt, amelyet beillesztettem.” |
| „Írd meg a bevezetőt.” | „Itt a bevezetőm – hol nem világos az érvelés?” |
Tipp A vezérelv: adjon szöveget, ne kérjen tényt. Ha a modell a saját „emlékezetéből” válaszol, hallucinálhat. Ha viszont Ön adja oda a szöveget, és abból kell dolgoznia – összefoglalnia, fordítania, kigyűjtenie –, akkor az eredmény ellenőrizhető: ott van mellette az eredeti.
Figyelem A jobb oszlop nem engedély
A táblázat jobb oldala arra válaszol, hogyan lesz egy MI-válasz ellenőrizhetőbb. Nem arra, hogy mit szabad. A kettő nem ugyanaz, és a különbség itt látszik a legjobban:
- a „Foglald össze ezt a tanulmányt” kockázatilag jó megoldás – de a szakirodalom MI-összefoglalása BA szinten tiltott (4.3 szakasz), és a jogvédett PDF feltöltése egy nyilvános szolgáltatásba a dékáni utasításba is ütközik (4.2 szakasz);
- a „hol nem világos az érvelésem?” a szövegen dolgozik, nem helyette – de ha a válasz nyomán az MI-vel íratja át a bekezdést, az már szövegírás, tehát tiltott;
- a MATARKA-kulcsszavak kérése önmagában védhető, a találati listát viszont a keresőfelületen kell előállítani, nem az MI-vel.
Mindig előbb a 4. szakaszt nézze meg (szabad-e), és csak utána ezt (hogyan csináljam jól).
6.1 Hogyan írjunk promptot?
Ez a szakasz nem azért van itt, hogy „jobb válaszokat” kapjon. Két gyakorlati oka van. Az egyik, hogy a rosszul feltett kérdés a félrevezető válasz leggyakoribb forrása. A másik, hogy a BTK nyilatkozata – ahol a szakos szabályozás előírja – a promptolás pontos dokumentálását kéri: ha nem tudja, mit írt be, nem tudja kitölteni a nyilatkozatot sem.
Definíció Fogalom: prompt
Az a konkrét bemenet vagy lekérdezés, amelyet a modellnek adunk, hogy választ generáljon vagy feladatot végezzen el. A prompt engineering ennek az utasításnak a megszerkesztése: olyan formába öntése, amelyet a modell értelmezni és végrehajtani tud.
Egy jó prompt három tulajdonsága: világos – specifikus – strukturált.
A gyakorlatban hét, egyre erősebb technika létezik. Érdemes végigpróbálni őket ugyanazon a feladaton, mert a különbség szemmel látható:
| Technika | Mit tesz hozzá |
|---|---|
| Utasítás nélküli prompt | Csak a téma. A leggyengébb: a modell találgat, mit szeretnénk |
| Direkt utasítás | Megmondja, mit csináljon: foglald össze, fordítsd le, sorold fel |
| Kontextus megadása | Elmondja, kinek és mihez készül. Egy BA-szemináriumra más kell, mint egy előadásra |
| Szerepkör (persona) definiálása | Megadja, kinek a szemszögéből válaszoljon. Ez érezhetően megváltoztatja a szóhasználatot: szakkifejezéseket hoz be a körítés helyett |
| Formátum specifikálása | Táblázat? Öt pont? Kétszáz szó? Enélkül a modell választ helyettünk |
| Lépésenkénti gondolkodás | Kéri, hogy indokolja meg a lépéseit. Így legalább látható, hol téved |
| Példák megadása | Megmutatja, milyen kimenetet várunk. A legerősebb – és a legritkábban használt |
Példa Ugyanaz a feladat, három megfogalmazásban
Feladat: „Magyarázza el Descartes állításának jelentését: »Gondolkodom, tehát vagyok.«”
- Persona nélkül – strukturált válasz, de sok benne a körítés: bevezetés, háttér, összefoglalás.
- Persona prompttal – például: „Ön egy 80 éves, tekintélyes filozófiaprofesszor, aki egész életét Descartes tanulmányozásának szentelte. Hangneme világos, türelmes.” A válasz szűkszavúbb lesz, és szakkifejezéseket használ.
- „Gyermeki” prompttal – „…nem egyetemi hallgatókhoz beszélsz, hanem egy kíváncsi ötéveshez…” A válasz hasonlatokra és metaforákra vált.
A tanulság nem az, hogy melyik a legjobb, hanem hogy ugyanaz a kérdés háromféle szöveget hoz – vagyis a kimenet legalább annyira az Ön megfogalmazásáról szól, mint a témáról. Ezért kell dokumentálni.
Figyelem A jó prompt nem old fel tiltást.
Attól, hogy jól megfogalmazza a kérdést, a szövegíratás még szövegíratás marad, a bibliográfia-generálás pedig bibliográfia-generálás. A promptolás technikája azoknál a használatoknál számít, amelyek egyébként megengedettek – és ott a nyilatkozat része lesz.
Reflexiós feladatok
Feladat 1. feladat – Hallucinációvadászat
Kérjen egy MI-eszköztől öttételes bibliográfiát egy szűk magyar történeti témában (például: „a magyarországi kolerajárványok társadalomtörténete”).
Ellenőrizze mind az öt tételt az MTMT-ben, a REAL-ban és az ELTE könyvtári katalógusában.
Készítsen táblázatot: tétel – létezik-e – ha nem, mi volt hibás benne (szerző, cím, folyóirat, évszám, oldalszám).
Írjon egy bekezdést arról, mi tűnt fel: miből lehetett volna gyanút fogni az ellenőrzés előtt?
Elvárt formátum: öt soros táblázat + egy bekezdésnyi (kb. 150 szavas) reflexió.
Feladat 2. feladat – Besorolás
Az alábbi hét feladat mindegyikéről döntse el, hogy az MI-használat ajánlott, feltételes (validálással) vagy kerülendő – és indokolja egy mondattal.
- Egy 1900-as német nyelvű újságcikk nyersfordítása.
- Egy szemináriumi dolgozat bevezetőjének megírása.
- Kétszáz levéltári tétel címének tematikus előszűrése.
- Egy kézírásos napló átírása.
- Annak eldöntése, hogy egy korabeli cikk ironikus-e.
- Egy adatbázis duplikátumainak felderítése.
- Egy konkrét levéltári jelzet megadása.
Elvárt formátum: hétsoros táblázat (feladat – besorolás – indoklás).
Kiegészítés (a 4. szakasz elolvasása után): vegyen fel egy nyolcadik oszlopot is – mit mond erről a Történeti Intézet szabályzata BA szinten: tiltott, feltételesen megengedett vagy dokumentálva megengedett? Hasonlítsa össze a két besorolást. Melyik feladatnál tér el a kockázati és a szabályozási ítélet, és miért?
Feladat 3. feladat – A nyilatkozat kitöltése
Vegye elő a legutóbbi szemináriumi dolgozatát (vagy egy most készülőt), és töltse ki hozzá a dékáni utasítás 1. sz. melléklete szerinti nyilatkozatot – a négyoszlopos táblázattal együtt: milyen céllal? milyen módon? mely MI-eszközt? a dolgozat mely részében?
Ha nem használt MI-t, jelölje meg a „NEM használtam” sort – és írja le egy mondatban, mit ellenőrzött végig, mielőtt ezt aláírta volna. (Használt-e fordítót? Böngészőbe épített segédet? Összefoglaló funkciót?)
Ha használt, töltse ki a táblázatot, majd nézze meg a 4.3 szakasz listáit: a leírt használat melyik kategóriába esik? Ha a tiltott oszlopba, mit kellett volna másképp csinálnia?
Írjon le két mondatot arról, mit tanult a kitöltésből a saját munkamódjáról.
Elvárt formátum: kitöltött nyilatkozatminta + kb. 100 szavas reflexió.
Feladat 4. feladat – Melyik szabály az erősebb?
Az alábbi négy helyzetben más-más szabályozási szint mond valamit. Döntse el, mit tehet, és nevezze meg, melyik dokumentum melyik pontjára hivatkozik.
- A kurzus tematikája engedi az MI-t a házi dolgozat vázlatához, a Történeti Intézet szabályzata viszont tiltja a vázlatkészítést.
- Egy jogvédett angol tanulmányt szeretne feltölteni egy nyilvános MI-alkalmazásba, hogy lefordítsa – az oktató a fordítást engedélyezte.
- Egy még nem publikált levéltári irat átiratát szeretné átolvastatni, hogy megtalálja benne a dátumokat.
- Az MI kijavította a dolgozata vesszőhibáit, és Ön ezt nem tartotta említésre méltónak a nyilatkozatban.
Elvárt formátum: négy rövid bekezdés, mindegyikben legalább egy konkrét hivatkozás a szabályozásra.
Feladat 5. feladat – Találja meg a hibát
Válasszon egy magyar történeti témát, amelyről Ön már tud valamit – például egy tanult korszakot vagy egy forrást, amelyet szemináriumon feldolgoztak.
Kérjen róla egy körülbelül háromszáz szavas összefoglalót egy MI-eszköztől. Mentse el a promptot is, szó szerint.
Olvassa végig, és jelöljön meg minden állítást, amely téves, pontatlan, anakronisztikus vagy indokolatlanul általánosító.
Minden jelölt helyhez írjon egy mondatot: mi a helyes, és honnan tudja (konkrét forrás).
Végül fogalmazza meg egy bekezdésben: mi volt az a hibatípus, amelyet a legnehezebb volt észrevenni – és miért?
Elvárt formátum: a prompt + a megjelölt szöveg + kb. 150 szavas reflexió.
Megjegyzés: ez a feladat kifejezetten az MI kimenetének kritikai elemzéséről szól, ezért a 4.3 szakasz tiltásai nem érintik – a keletkező szöveg nem a dolgozat része, hanem a vizsgálat tárgya. A nyilatkozatban ezt is fel kell tüntetni.
Feladat 6. feladat – Ugyanaz a kérdés hétféleképpen
Válasszon egy fogalmat a könyv Szószedetéből, és kérdezzen rá egy MI-eszköztől a 6.1 szakasz technikái közül négy különbözővel: utasítás nélkül, direkt utasítással, kontextus megadásával és szerepkör definiálásával.
Mentse el mind a négy promptot és mind a négy választ.
Készítsen táblázatot: technika – a válasz hossza – szakkifejezéseket használ-e – tartalmaz-e ellenőrizhető hivatkozást – van-e benne tárgyi hiba.
Írja meg egy bekezdésben, melyik változat volt a legkönnyebben ellenőrizhető – és hogy ez ugyanaz-e, mint amelyik a legjobban hangzott.
Elvárt formátum: négysoros táblázat + kb. 120 szavas reflexió.
Önellenőrző kérdések
1. Mit csinál valójában egy nagy nyelvi modell?
Válasz megjelenítése
Statisztikai mintafelismerést: hatalmas szövegmennyiségen tanult, és valószínűségeket számol a következő szó vagy mondat előrejelzésére. Az outputja mindig valószínűségi becslés, nem tudás vagy megértés.
2. Igaz-e, hogy az MI képes önállóan történelmi kontextusokat értelmezni forráskritika nélkül?
Válasz megjelenítése
Nem, ez hamis. Az MI nem érti a történeti kontextust, nem ismeri fel az iróniát vagy a szarkazmust, és nem végzi el a forráskritikát – ez a kutató feladata marad.
3. Mi a hallucináció, és hol a legveszélyesebb?
Válasz megjelenítése
Valósnak látszó, de nem létező információ előállítása. A bibliográfiánál és a faktikus adatoknál (évszám, név, jelzet) a legveszélyesebb, mert a hibás tétel formailag tökéletesnek látszik.
4. Miért téved az MI gyakrabban magyar történeti kérdésekben?
Válasz megjelenítése
Mert a tréningadatokban az angolszász, nyugati, mainstream perspektívák vannak túlsúlyban; a magyar történelem eseményeiről és személyeiről kevesebb és gyakran gyengébb minőségű adatot látott.
5. Mit jelent a transzparencia elve a gyakorlatban?
Válasz megjelenítése
Azt, hogy a dolgozatban dokumentáljuk: melyik eszközt, mikor, pontosan mire használtuk, és hogyan ellenőriztük az eredményt.
6. Melyik három szabályozási szint vonatkozik egy ELTE-s történelem BA-s hallgatóra, és melyik az irányadó, ha eltérnek?
Válasz megjelenítése
- a 4/2025. (X. 28.) rektori utasítás az egész egyetemre, (2) a II/2025 (XII. 12.) dékáni utasítás a BTK-ra, (3) az ELTE BTK Történeti Intézet MI használati szabályzata a történelem szakos képzésekre. Mindig a szűkebb, szigorúbb szabály az irányadó – és a kurzus tematikája ennél is szigorúbb lehet.
7. Igaz-e, hogy BA szinten szabad bibliográfiát generáltatni MI-vel, ha utána minden tételt leellenőriz?
Válasz megjelenítése
Nem. A Történeti Intézet szabályzatának 4.1. pontja BA és OT szinten a bibliográfia MI-generálását „még ellenőrzéssel sem” engedi. A szakirodalom felkutatása a kutatás érdemi része, nem segédmunka.
8. Mit tilos szigorúan bevinni egy MI-rendszerbe?
Válasz megjelenítése
Nem publikált levéltári források és kéziratos dokumentumok szövegét, személyes adatokat, oral history interjúk átirataiban szereplő személyes adatokat, valamint még nem publikált kutatási eredményeket. Kivétel csak a témavezető vagy kutatásvezető kifejezett írásos engedélyével van. A tilalom a bevitelre vonatkozik – az sem mentség, ha „csak” fordítást vagy összefoglalást kért.
9. Kell-e nyilatkozni annak, aki egyáltalán nem használt MI-t?
Válasz megjelenítése
Igen. A Történeti Intézet nyilatkozatának van egy „NEM használtam mesterséges intelligencia alapú eszközt” rovata; ezt kell megjelölni. A nyilatkozat minden beadandó feladat kísérőlapja.
10. Mit old fel a „megbízható MI-szolgáltatás” – például az egyetemi Teams –, és mit nem?
Válasz megjelenítése
Egyetlen dolgot old fel: a szerzői jogvédett tartalom bemenetként való használatát, azt is csak a tanulás és a kutatás segítésére, nem a dolgozat szövegének megalkotására. Nem oldja fel a személyes adatok, a nem publikált levéltári források, az interjúátiratok és a publikálatlan eredmények bevitelének tilalmát, nem oldja fel a BA-szintű tiltásokat, és nem mentesít a nyilatkozattétel alól. Röviden: azt bővíti, mit szabad bevinni – nem azt, mit szabad vele csinálni.
11. Elég-e egy MI-detektor találata ahhoz, hogy egy dolgozatot elmarasztaljanak?
Válasz megjelenítése
Nem. Az intézeti szabályzat szerint az MI-detektor szoftverek nem használhatók kizárólagos bizonyítékként – az értékelés alapja mindig szakmai, konkrét példákkal. Ráadásul hallgatói munkát szabadon elérhető online AI-detektorba feltölteni tilos, mert az sérti a hallgató szerzői jogát.
Összefoglalás
Ebben a fejezetben tisztáztuk, mit csinál valójában egy MI-rendszer: statisztikai mintafelismerést és valószínűségi előrejelzést – nem gondolkodást és nem megértést. Ebből következik, hogy hol hasznos (ötletgenerálás, fordítás, összefoglalás, OCR, előszűrés, adattisztítás) és hol veszélyes (bibliográfia, faktikus adatok, forráskritika, a végső szöveg megírása). Öt etikai alapelvet fogalmaztunk meg, és láttuk, miért érdemes magyar történeti témában különösen óvatosnak lenni.
Ezután áttértünk arról, hogy mi kockázatos, arra, hogy mit szabad. Az ELTE-n három egymásra épülő szabály él: a rektori utasítás, a BTK dékáni utasítása és a Történeti Intézet szabályzata – ez utóbbi szándékosan a legszigorúbb, mert BA szinten éppen azok a készségek épülnek, amelyeket az MI kivenne a hallgató kezéből. Ezért BA-n tiltott a szövegírás, a vázlatkészítés, a forráselemzés, a történeti értelmezés, a szakirodalom összefoglalása és a bibliográfia generálása; oktatói írásbeli engedéllyel lehetséges a fogalmi tisztázás, a fordítás és a kezdeti tájékozódás; dokumentálva megengedett a helyesírás-ellenőrzés és a technikai formázás. Minden esetben nyilatkozni kell – akkor is, ha nem használt MI-t. És soha nem kerülhet MI bemenetére nem publikált levéltári forrás, személyes adat, interjúátirat vagy publikálatlan eredmény.
A fejezet legfontosabb mondata ugyanaz, mint a könyv egészéé: a digitális eszközök nem helyettesítik a hagyományos történészi munkát – kiegészítik, kiterjesztik és új kérdéseket tesznek lehetővé. De minden digitális döntés interpretációs döntés, és minden algoritmus értékeket hordoz. A kritikus reflektivitás nem opcionális.
Feladat A félév végi csoportmunka MI-feladata
A kurzus záró csoportos prezentációjának egyik pontja: „Próbálják ki, hogy tudják-e alkalmazni a mesterséges intelligenciát a kutatásukban bármely ponton (pl. keresés, szövegalkotás, prezentálás), és számoljanak be róla, hogy hasznosnak találták-e.”
A beszámolóban térjenek ki arra is, hogy mit ellenőriztek, és mit találtak hibásnak.
Két megkötés a 4. szakasz alapján: a kipróbálás nem terjedhet ki a dolgozat vagy a prezentáció szövegének megíratására, és nem vihetnek be az MI-be nem publikált forrást vagy személyes adatot. A beszámolóhoz nyilatkozat tartozik – lásd a 4.5 szakaszt.
Kulcsfogalmak
feltételesen megengedett használat – Olyan MI-használat, amely csak meghatározott feltételek – BA szinten az oktató előzetes írásbeli engedélye, teljes dokumentáció és kritikai értékelés – mellett engedélyezett.
hallucináció – Az a jelenség, amikor az MI valósnak látszó, de nem létező információt (például bibliográfiai tételt vagy levéltári jelzetet) állít elő.
megbízható MI-szolgáltatás – Az egyetem szerződéses keretében, egyetemi fiókkal használt MI-környezet (a dékáni utasítás példája: az egyetemi Teams, Copilot). Csak a szerzői jogvédett tartalom bemenetként való használatát oldja fel; a személyes adatokra és a képzési szintű tiltásokra vonatkozó szabályokat nem érinti.
MI-használati nyilatkozat – A beadott írásműhöz csatolt, aláírt dokumentum, amelyben a hallgató számot ad arról, használt-e MI-eszközt, és ha igen, milyen céllal, milyen módon, melyiket és a dolgozat mely részében. A szakdolgozat kötelező eleme; a valótlan tartalmú nyilatkozat a plágiummal azonos megítélés alá esik.
prompt – Az MI-nek adott utasítás vagy kérdés, amely meghatározza a kívánt kimenetet. Ahol a szakos szabályozás előírja, a nyilatkozatban a promptolást is pontosan dokumentálni kell.
prompt engineering – Az utasítás olyan megszerkesztése, amelyet a generatív modell értelmezni és végrehajtani tud; jellemzői: világos, specifikus, strukturált.
RAG (visszakeresés-alapú generálás) – Olyan MI-megoldás, amely előbb egy megadott dokumentumgyűjteményben keres, és csak azután fogalmaz választ a megtalált szövegekből; ezért kevesebbet hallucinál és hivatkozni is tud a forrásaira.
nagy nyelvi modell – Statisztikai mintafelismerő rendszer, amely nagy szövegmennyiségen tanult, és valószínűségeket számol a következő szó előrejelzésére.
transzparencia (MI-használatban) – Annak dokumentálása, hogy a kutató melyik eszközt mire és hogyan használta, és miként ellenőrizte az eredményt.
tiltott használat – A szabályzat által kifejezetten megtiltott MI-használat, amely a plágiummal azonos megítélés alá esik.
tréningadat-torzítás (bias) – Az a jelenség, hogy az MI a tanítóadatok egyenetlenségeit (nyelvi, kulturális, perspektivikus túlsúlyokat) tükrözi és felerősíti.
validálás (validáció) – Az MI által generált eredmény emberi ellenőrzése és hitelesítése független, megbízható forrásból; az MI-használat kötelező kísérőlépése.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- 4/2025. (X. 28.) rektori utasítás a mesterséges intelligencia oktatásban történő használatáról az Eötvös Loránd Tudományegyetemen. Budapest, 2025. október 28.
- II/2025 (XII. 12.) sz. dékáni utasítás: Az ELTE Bölcsészettudományi Karának hallgatói MI-használatra vonatkozó szabályozása. 1. sz. melléklet: Nyilatkozat mesterségesintelligencia-eszköz felhasználásáról.
- Mesterséges intelligencia használati szabályzat. ELTE BTK Történeti Intézet, történelem szakos graduális képzések.
- Ring Orsolya: Adat a történettudományban. ELTE BTK Történelem Segédtudományai Tanszék, 2026. 2.6. alfejezet. https://ringorsolya.github.io/adat_tortenettudomany/
- Ring Orsolya: Hatékony segédeszköz vagy a félreértelmezések forrása? AI-eszközök lehetőségei és korlátai a kutatásban. Előadás, ELTE BTK Történelem Segédtudományai Tanszék, 2026. 03. 11.
Linkek és eszközök
- Mesterségesintelligencia-eszköz felhasználásának szabályozása a Bölcsészettudományi Karon (a három dokumentum letölthető innen) – https://www.btk.elte.hu/MI-eszkoz-felhasznalasanak-szabalyozasa-a-BTK-n – elérve: 2026. 08. 23.
- Szabályozta az ELTE a mesterséges intelligencia használatát az oktatásban (egyetemi hír, 2025. 11. 20.) – https://www.elte.hu/szabalyozta-az-elte-a-mesterseges-intelligencia-hasznalatat-az-oktatasban – elérve: 2026. 08. 23.
- Ring Orsolya: Adat a történettudományban (online tankönyv) – https://ringorsolya.github.io/adat_tortenettudomany/ – elérve: 2026. 08. 20.
- Transkribus (kézírásfelismerés) – https://www.transkribus.org/ – elérve: 2026. 08. 20.
Kutatási eredmények vizualizálása
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 90 perc |
| Előfeltétel | Adat a történettudományban |
| Verzió / dátum | v0.1 / 2026. augusztus |
Az eszközök alapadatai
| Eszköz neve | Datawrapper |
| URL | https://www.datawrapper.de/ |
| Üzemeltető | Datawrapper GmbH |
| Hozzáférés | Ingyenes alapverzió; böngészőben fut, programozás nem kell |
| Regisztráció | Nem kötelező a kipróbáláshoz („no account needed”); a mentéshez igen |
| Tartalomtípus | Statikus és interaktív diagramok, táblázatok, térképek – publikációra kész kimenettel |
| Munkamenet | Az adattal indul: feltöltés → ellenőrzés → ábratípus kiválasztása |
| Eszköz neve | Flourish |
| URL | https://flourish.studio/ |
| Üzemeltető | Canva UK Operations Ltd (a Flourish-t 2018-ban alapították, 2022 óta a Canva tulajdona) |
| Hozzáférés | Ingyenes alapverzió, fizetős csomagokkal; böngészőben fut |
| Regisztráció | Szükséges |
| Tartalomtípus | Interaktív és animált vizualizációk: idősorok, hálózatok, mozgó ábrák, „story” formátum |
| Munkamenet | A sablonnal indul: sablonválasztás → az adat behelyettesítése |
Miről szól ez a fejezet?
Az adat önmagában nem érv. Akkor válik azzá, ha úgy mutatjuk meg, hogy az olvasó lássa benne az összefüggést. Ez a fejezet arról szól, hogyan válasszon ábratípust a kutatási kérdéséhez, milyen eszközzel készítse el, és milyen hibákat kerüljön el – mert a vizualizáció ugyanúgy állítás, mint egy mondat, és ugyanúgy lehet félrevezető.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- egy kutatási kérdés típusából levezeti a megfelelő ábratípust;
- felismeri és megnevezi a hat leggyakoribb félrevezető vizualizációs mintát;
- eldönti, hogy egy adott feladathoz a Datawrapper vagy a Flourish az alkalmas eszköz, és indokolja a választást;
- elvégzi a „30 másodperces tesztet” egy saját ábrán, és a visszajelzés alapján javítja azt;
- publikálás előtt végigmegy a vizualizáció-etikai ellenőrző listán.
Bevezetés
„Minden vizualizáció narratíva.”
Ez a mondat az Adat a történettudományban fejezet negyedik életciklus-fázisára utal: a bemutatásra. Ott azt írtuk, hogy minden kutatási prezentáció egy narratíva szerint strukturált, és még a legegyszerűbb ábra is döntéseket testesít meg arról, mi a fontos és mi nem, mit kell felfedni és mit elrejteni.
A történeti kutatás vizualizációs igényei két nagy csoportra oszlanak.
Publikációs grafika – tanulmány, szakdolgozat, monográfia figurája. Nyomtatásban is olvasható, fekete-fehérben is értelmezhető, egyértelmű, statikus, reprodukálható.
Interaktív, beágyazott felület – online kiegészítő, honlap, konferencia-előadás képernyője. A felhasználó maga szűrhet; van animáció, mozgó idősor, kattintható adatpont.
A kettő nem egymás versenytársa, hanem kiegészítője: ugyanabból az adatból mindkettő elkészíthető, más célra.
1. Az ábraválasztás logikája
Mielőtt bármit feltöltenénk bármelyik platformra, tisztáznunk kell, mi a vizualizáció kérdése. Ugyanarra az adatra többféle jó ábra készülhet – de rossz ábraválasztás mellett még a leggondosabb finomítás sem segít.
1.1 Kérdéstípus → ábratípus
| A kutatási kérdés típusa | Ajánlott ábra |
|---|---|
| Megoszlás néhány (3–7) kategórián | vízszintes sávdiagram (bar chart) |
| Megoszlás sok (8+) kategórián | vízszintes sávdiagram vagy treemap |
| Időbeli változás egy számon | vonaldiagram (line chart) |
| Időbeli változás több kategórián | halmozott területdiagram |
| Rangsor időben mozogva | „bar chart race” |
| Két változó kapcsolata | pontdiagram (scatter plot) |
| Egyváltozós eloszlás | hisztogram |
| Földrajzi koncentráció | choropleth (területszínezéses) térkép |
| Pont jellegű földrajzi adat | szimbólumtérkép |
| Entitások közötti hálózat | hálózati ábra (force-directed) |
| Áramlás A-ból B-be | Sankey-diagram |
| Hierarchikus kategóriák | treemap vagy sunburst |
Példa Ugyanaz az adat, két kérdés, két ábra
Vegyük az Állambiztonsági archontológia esettanulmányát: a BM III. Főcsoportfőnökség hat vezetőjét.
Kérdés 1: „Milyen végzettséggel rendelkeztek?” – Ez megoszlás néhány kategórián: vízszintes sávdiagram.
Kérdés 2: „Hogyan követték egymást a pozícióban?” – Ez időbeli kérdés: idővonal vagy Gantt-jellegű sávábra, ahol minden vezető egy vízszintes sáv a hivatali ideje szerint.
A második ábra ugyanabból az adatból egészen mást mutat meg: az átfedéseket, a hivatali idők hosszát, a rendszer stabilitását vagy instabilitását.
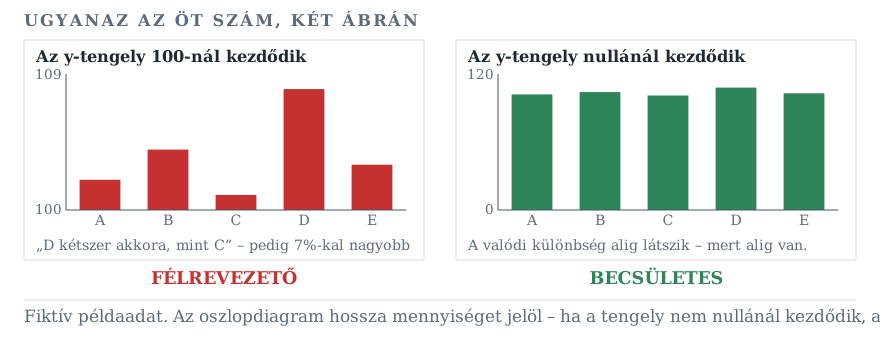
1.2 Mit kerüljünk?
Figyelem Négy ábratípus, amit szinte soha ne használjon
- Kördiagram háromnál több szeleten. Az arányokat az emberi szem rosszul becsli szögből. Ha megoszlásról van szó: sávdiagram.
- 3D-s oszlop vagy torta. Kozmetikai torzítás, semmi előnyt nem ad – a háttérben lévő oszlopok optikailag kisebbnek tűnnek.
- Kettős y-tengely két különböző skálán. Ritkán indokolt, és majdnem mindig megtévesztő.
- Szófelhő kvantitatív kérdésre. Nemcsak a szám, hanem a betűhossz is befolyásolja a megjelenő méretet.
1.3 A 30 másodperces teszt
Tipp Készítse el az ábrát, majd tegye le, és egy csoporttársa nézze meg harminc másodpercig. Utána tegyen fel neki három kérdést:
- Mit ábrázol?
- Mi a figura egy fő állítása?
- Melyik adatpont vagy kategória a legfontosabb?
Ha a válaszok eltérnek attól, amit Ön gondolt, akkor vagy az ábratípus nem jó, vagy a finomításon múlik. Ez az eljárás sokkal olcsóbb, mint utólag kicserélni a figurát egy már leadott dolgozatban.
2. Két eszköz: Datawrapper és Flourish
Mindkettő böngészőben fut, és nem igényel programozást. Ingyenes alapverziójuk akadémiai használatra elegendő.
| Szempont | Datawrapper | Flourish |
|---|---|---|
| Fő profil | hírlapi, tudományos grafika | interaktív „story”, adatújságírás |
| Regisztráció | ingyenes, e-maillel | ingyenes alapverzió + fizetős |
| Export | PNG; SVG és PDF fizetős csomagban | PNG, beágyazott iframe |
| Interaktivitás | mérsékelt (tooltip, szűrő) | erős (animáció, lapozás, scrollytelling) |
| Sablonok | kb. 20, konzervatív | 40+, gazdag (hálózat, Sankey, bar chart race) |
| Térkép | choropleth, szimbólum, lokátor | choropleth, pont, projektált, 3D |
| Tanulási görbe | enyhe | közepes |
| Ideális használat | cikkábra, statikus ábrázolás | online kiegészítő, prezentáció |
Tipp Melyikkel kezdje?
A legtöbb esetben a Datawrapper az első próba: gyors, egyszerű, publikációra alkalmas kimenetet ad. Ha az adatnak animációt, történetvezetést, komplex hálózatot vagy mozgást szánna, akkor érdemes a Flourish-ra váltani.
Fontos különbség a két felület logikájában: a Datawrapper az adattal indít (feltöltés → ellenőrzés → ábratípus), a Flourish viszont a sablonnal (sablon kiválasztása → adat betöltése → oszlopok hozzárendelése).
Mélyebben A lépésenkénti munkamenet
Mindkét eszköz teljes, kattintásszintű munkamenete – regisztrációtól a publikálásig, egy magyar prozopográfiai mintaadaton – megtalálható a forráskötetben: Ring Orsolya: Adat a történettudományban, 14.4. és 14.5. alfejezet.
Ott olvasható a Datawrapper négy lapjának (Upload data → Check &
describe → Visualize → Publish & embed) végigjátszása, valamint a
Flourish hálózati ábrájának felépítése két CSV-ből
(nodes.csv és edges.csv).
2.1 Amit soha ne hagyjon ki: a címkézés
Az akadémiai figuránál mind a négy mezőt érdemes kitölteni:
- Cím – ne az adat leírása, hanem az állítás. Nem „Felekezeti megoszlás”, hanem „A tagság kétharmada római katolikus volt”.
- Leírás – egy mondatos magyarázat, például a harmonizálási döntésekről.
- Forrás – a felhasznált adat eredete.
- Jegyzet – az elemszám (n), az adatgyűjtés időpontja, módszertani megjegyzés.
3. Vizualizáció-etika
A jó eszköz nem véd meg a rossz vizualizációtól.
| Probléma | Miért baj? |
|---|---|
| Csonkolt y-tengely | apró különbségek drámainak látszanak |
| Kategóriák ábécésorrendben | elfedi a nagyság szerinti rangsort |
| 3D-s oszlopdiagram | a háttérben lévő oszlopok optikailag kisebbnek tűnnek |
| Aránytalan ikonméret | ha a sugár kétszeres, a terület négyszeres – négyszeres számérzet |
| Szín-szemantika figyelmen kívül hagyása | piros = „rossz”, zöld = „jó”; felekezeti vagy politikai ábrán komoly félreolvasáshoz vezet |
| Hiányzó forrás és elemszám | az olvasó nem tudja, mennyire bízhat a figurában |
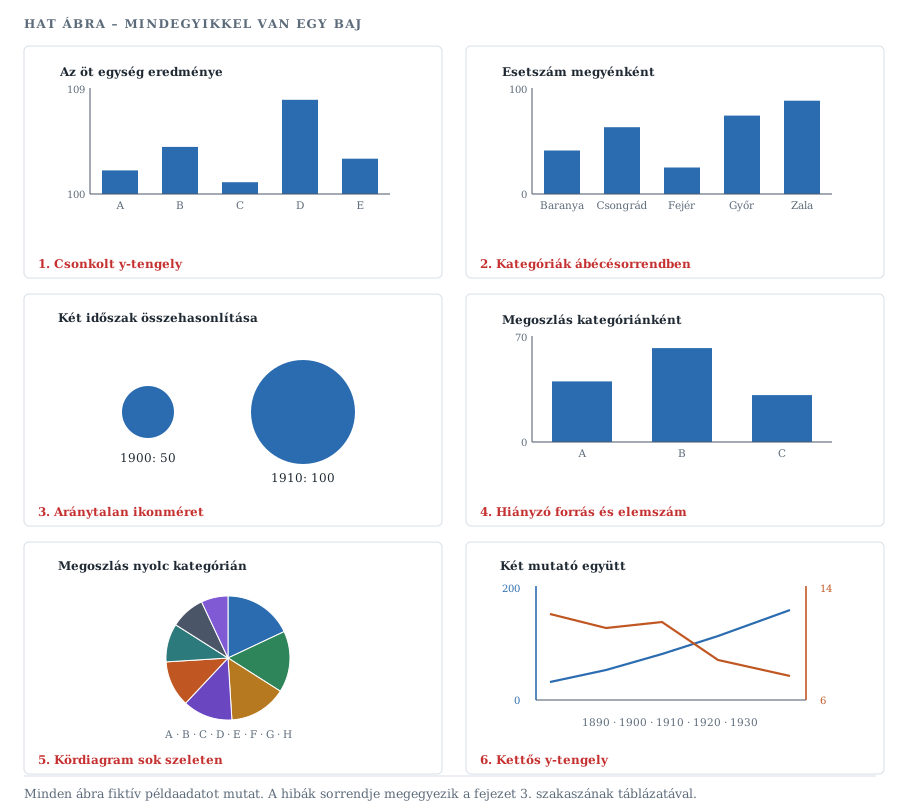
A Datawrapper több ilyet alapból kizár (nem enged 3D-t, a forrássort kötelezően kitölteti); a Flourish szabadabb, ezért a kutatóra nagyobb felelősséget hárít.
Figyelem Ellenőrző kérdések publikálás előtt
- Egyértelmű-e a grafikon címéből, mire kell figyelni?
- Szerepel-e a forrás, az n (elemszám) és az adatgyűjtés időpontja?
- Fekete-fehér fénymásolatban is értelmes marad-e?
- Egy olvasó, aki az adatot nem ismeri, mi alapján félreértené?
- Mi az, amit a vizualizáció elfed – időbeli változás egy pillanatkép mögött, nemi aránytalanság, regionális eltérés?
Gyakorlás: mi a baj ezzel az ábrával?
Hat ábra, mindegyikkel egy baj. A hibák a fenti táblázatból valók. Nézze meg az ábrát, döntse el, mi a probléma – utána megnézheti, hogyan javítható.
Feladat Mi a baj ezekkel az ábrákkal?
A 3. ábra hat diagramot mutat. Mindegyikhez rendelje hozzá a hibát a fenti táblázatból, majd írja le egy mondatban, hogyan javítaná.
4. A vizualizáció mint kutatási munkafolyamat
A vizualizáció nem csak a kutatás végén hasznos. Tipikus projektmenet:
1. Feltáró szakasz. A kutató gyorsan készít 5–10 vázlatgrafikont ugyanarról az adatról, más-más nézőpontból (felekezet, foglalkozás, évtized, régió). Ezek nem publikálásra készülnek, hanem a kutatási kérdés finomítására.
2. Publikációs szakasz. Kiválasztjuk azt a 2–3 figurát, amely a dolgozatban szerepelni fog, és ezeket végigvisszük a fenti etikai ellenőrző listán. Ha interaktív online kiegészítőt is szeretnénk, egy-két kulcsfigurát átviszünk Flourish-ba.
Ez a folyamat iteratív – hasonlóan ahhoz, ahogy a Hogyan épül fel egy történeti kutatás? fejezetben a kutatás tervezéséről mondtuk.
Gyakorlati feladatok
Feladat 1. feladat – Ábratípus-választás
Az alábbi öt kutatási kérdéshez válasszon ábratípust, és egy mondattal indokolja a választást. Mindegyiknél nevezze meg azt is, melyik ábratípus lenne rossz választás, és miért.
- Hogyan oszlott meg az ELTE BTK hallgatóinak létszáma szakonként 2020-ban?
- Hogyan változott ugyanez 2000 és 2020 között?
- Hol születtek a magyar akadémikusok a 19. században?
- Ki kivel levelezett egy szerzői körben?
- Van-e kapcsolat a születési év és az első publikáció éve között?
Elvárt formátum: ötsoros táblázat (kérdés – ajánlott ábra – indoklás – kerülendő ábra).
Feladat 2. feladat – Saját ábra és 30 másodperces teszt
Válasszon egy kis adatsort a könyv korábbi fejezeteinek valamelyik adatbázisából (például az MTMT-ből egy szerző publikációinak évenkénti száma, vagy az archontológiából a főcsoportfőnökök hivatali ideje).
Készítsen belőle ábrát Datawrapperben. Töltse ki mind a négy címkemezőt (cím, leírás, forrás, jegyzet).
Végezze el a 30 másodperces tesztet egy csoporttársával. Jegyezze fel a három kérdésre adott válaszát.
Javítsa az ábrát a visszajelzés alapján, és írja le egy bekezdésben, mit változtatott és miért.
Elvárt formátum: a két ábra (javítás előtt és után) PNG-ben, plusz kb. 200 szavas reflexió.
Feladat 3. feladat – Félrevezető ábra elemzése
Keressen a sajtóban vagy a közösségi médiában egy olyan grafikont, amely a fejezet 3. szakaszában felsorolt hibák valamelyikét elköveti.
Csatolja az ábrát (képernyőkép), a forrás megjelölésével.
Nevezze meg, melyik hibatípusról van szó.
Írja le, mit sugall az ábra, és mit mutatna, ha a hibát kijavítanánk.
Elvárt formátum: kb. 200 szavas elemzés a képernyőképpel.
Önellenőrző kérdések
1. Milyen ábrát választana, ha nyolc kategória megoszlását kell bemutatnia?
Válasz megjelenítése
Vízszintes sávdiagramot vagy treemapet – kördiagramot semmiképp, mert három szeletnél többnél az arányokat a szem rosszul becsli.
2. Mi a baj a csonkolt y-tengellyel?
Válasz megjelenítése
Az apró különbségeket drámainak mutatja, mert a nullától eltérő tengelykezdéssel a sávok vagy oszlopok arányai félrevezetővé válnak.
3. Mikor válasszunk Flourish-t Datawrapper helyett?
Válasz megjelenítése
Ha animációra, történetvezetésre (scrollytelling), komplex hálózati ábrára vagy mozgó rangsorra van szükség – tehát interaktív online kiegészítőhöz vagy prezentációhoz. Publikációs, statikus figurához a Datawrapper az egyszerűbb és szigorúbb választás.
4. Mit ellenőriz a 30 másodperces teszt?
Válasz megjelenítése
Azt, hogy az ábra magától beszél-e: egy külső szemlélő fél perc alatt felismeri-e, mit ábrázol, mi a fő állítása, és melyik adatpont a legfontosabb.
5. Mi legyen a figura címe?
Válasz megjelenítése
Lehetőleg maga az állítás, ne csak az adat leírása – például „A tagság kétharmada római katolikus volt” a „Felekezeti megoszlás” helyett. Emellett kötelező a forrás, az elemszám és az adatgyűjtés időpontja.
Összefoglalás
Ebben a fejezetben azt láttuk, hogy a vizualizáció nem díszítés, hanem állítás – és mint minden állítás, lehet pontos vagy félrevezető. Először az ábraválasztás logikáját vettük végig: a kutatási kérdés típusa határozza meg az ábratípust. Aztán megismertük a két legelterjedtebb, kódolást nem igénylő eszközt, és azt, mikor melyiket érdemes választani. Végül hat félrevezető mintát azonosítottunk, és összeállítottuk a publikálás előtti ellenőrző listát.
A legfontosabb tanulság a 30 másodperces teszt: ha egy külső szemlélő fél perc alatt nem azt olvassa ki az ábrából, amit Ön mondani akart, akkor nem az olvasóval van a baj.
Kulcsfogalmak
choropleth térkép – Területszínezéses térkép, amely egy mennyiséget földrajzi egységenként színárnyalattal jelenít meg.
csonkolt tengely – Nem nullától induló értéktengely; a különbségeket felnagyítja, ezért gyakori félrevezetési forma.
data-ink ratio – Tufte fogalma: a valódi adatot hordozó és az összes felhasznált grafikai elem aránya; minél magasabb, annál tisztább az ábra.
Sankey-diagram – Áramlást ábrázoló ábratípus: azt mutatja, hogy egy kategóriából mennyi kerül át egy másikba.
scrollytelling – Görgetéssel vezetett, lépésenként épülő vizuális narratíva.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Ring Orsolya: Adat a történettudományban. ELTE BTK Történelem Segédtudományai Tanszék, 2026. 14. fejezet. https://ringorsolya.github.io/adat_tortenettudomany/
Ajánlott irodalom
- Tufte, Edward R.: The Visual Display of Quantitative Information. 2. kiadás. Cheshire, CT, Graphics Press, 2001. (A klasszikus: minimalizmus, data-ink ratio.)
- Cairo, Alberto: The Truthful Art. Berkeley, New Riders, 2016. (Az adatújságírás módszertanának alapkönyve.)
- Knaflic, Cole Nussbaumer: Storytelling with Data. Hoboken, Wiley, 2015. (Pragmatikus, üzleti fókuszú, de akadémiai figurára is átültethető.)
Linkek és eszközök
- Datawrapper – https://app.datawrapper.de – elérve: 2026. 08. 20.
- Datawrapper Academy (tutoriálok) – https://academy.datawrapper.de/ – elérve: 2026. 08. 20.
- Datawrapper Blog – https://blog.datawrapper.de/ – elérve: 2026. 08. 20.
- Flourish – https://app.flourish.studio – elérve: 2026. 08. 20.
- Flourish Help – https://help.flourish.studio/ – elérve: 2026. 08. 20.
- Ring Orsolya: Adat a történettudományban (online tankönyv) – https://ringorsolya.github.io/adat_tortenettudomany/ – elérve: 2026. 08. 20.
Adatkezelés és adatvédelem
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 45 perc |
| Előfeltétel | Mi a forrás? |
| Verzió / dátum | v0.1 / 2026. augusztus |
Miről szól ez a fejezet?
A kutatás során személyes adatokkal is dolgozunk – levéltári iratokban, adatbázisokban, saját jegyzeteinkben. Ez a fejezet tisztázza, mi minősül személyes adatnak, hogyan védi ezt a magyar jog, és milyen gyakorlati eszközökkel óvhatja saját és mások adatait: jelszókezeléssel, kétfaktoros azonosítással, valamint a felhőalapú munka tudatos használatával.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- meghatározza a személyes adat fogalmát, és megkülönbözteti tőle a különleges és a bűnügyi adatot;
- megnevezi a személyes adatok védelmének magyar jogi alapjait;
- beállít egy jelszókezelőt és a kétfaktoros azonosítást a kutatáshoz használt fiókjain;
- felsorolja a felhőalapú munka előnyeit a kutatásban, és megnevez legalább két kockázatot;
- eldönti egy konkrét kutatási helyzetről, hogy a kezelt adat védelmet igényel-e.
Bevezetés
Ez a fejezet elsőre kilóg egy kutatásmódszertani tankönyvből: mi köze a jelszókezelésnek a történettudományhoz?
Több, mint gondolnánk. A könyv korábbi fejezeteiben végig azzal találkoztunk, hogy a levéltári rendszerek korlátozzák, ki mit láthat: a LIR-ben kétfaktoros azonosítás kell a belépéshez, és eltérő jogosultsági szinteken más-más találatot kapunk; az Állambiztonsági archontológia csak azért lehet nyilvános, mert a törvény bizonyos adatokat kivesz a védelem alól. Ezek a korlátok nem technikai szeszélyek – abból a jogi keretből következnek, amelyet ez a fejezet mutat be.
A másik oldal pedig a saját munkánk. Amikor egy anyakönyvi kivonatot lefotóz, egy interjút rögzít vagy egy 20. századi levéltári iratról másolatot kap, Ön válik adatkezelővé. Ez a fejezet ahhoz ad gyakorlati fogódzót, hogy ezt felelősséggel tegye.
1. Mi a személyes adat?
Definíció Fogalom: személyes adat
Személyes adatnak minősül egy természetes személlyel kapcsolatba hozható minden adat, valamint az adatból levonható, az érintettre vonatkozó következtetés. E körbe tartozik például egy személy neve, címe, iratainak azonosítószáma, e-mail-címe, bármely rá vonatkozó információ vagy ezek kombinációja.
A személyes adatokon belül megkülönböztetünk két alcsoportot is: a különleges és a bűnügyi adatokat. A különleges adatok körébe az olyan szenzitív adatok tartoznak, amelyek az adatalany etnikai, faji származására, politikai, vallási vagy világnézeti meggyőződésére utalnak, valamint ezek mellett a genetikai, a biometrikus és az egészségügyi adatok is.
Tipp Ez a fogalmi keret magyarázza a LIR és az Állambiztonsági archontológia fejezetekben látott hozzáférési korlátozásokat: ott azért nem látszik minden rekord mindenkinek, mert az iratok személyes és különleges adatokat tartalmaznak.
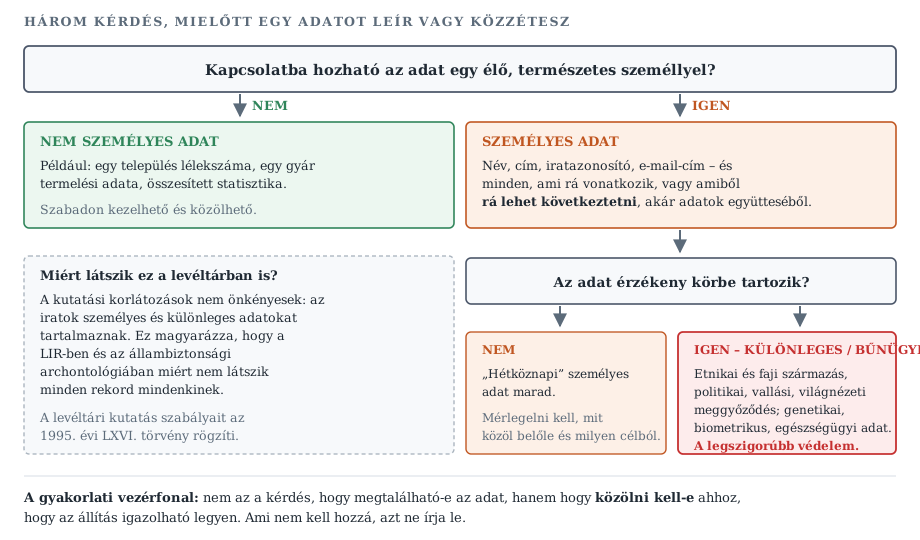
2. A jogi keret
A személyes adatok védelmét az Alaptörvény VI. cikk (3) bekezdése fogalmazza meg: ez alapján mindenkinek joga van a személyes adatai védelméhez. A részletes törvényi szabályozást az információs önrendelkezési jogról és az információszabadságról szóló 2011. évi CXII. törvény tartalmazza.
3. Saját adataink védelme
Személyes adataink védelméről mi magunk gondoskodhatunk leginkább. Ennek egyik fontos eleme, hogy a különböző eszközökre és alkalmazásokba történő bejelentkezéshez biztonságos jelszavakat használunk, és azokat biztonságosan tároljuk – ennek hiányában személyes adataink kerülhetnek illetéktelen kezekbe.
3.1 Jelszavak
A jelszavakat különböző módon hozhatjuk létre, de mindig azt érdemes szem előtt tartani, hogy azok kellően bonyolultak, így nehezen megfejthetők legyenek.
Figyelem Bár a bonyolult jelszavak megjegyzése nehéz lehet, mindenképp kerülendő, hogy jelszavainkat papíron rögzítsük – különösen, ha az egyértelműen kapcsolatba hozható azzal a felülettel, amelynek feloldására szolgál.
3.2 Jelszókezelő
Definíció Fogalom: jelszókezelő
Olyan alkalmazás, amely titkosított formában tárolja a jelszavainkat, így azokhoz illetéktelenek (ideális esetben) nem férhetnek hozzá. Előnye, hogy csupán egyetlen úgynevezett mesterjelszót kell fejben tartanunk – azt, amellyel hozzáférhetünk magához a jelszószéfhez.
A jelszókezelők típusairól, előnyeikről és hátrányaikról részletes összefoglaló található a Nemzeti Kibervédelmi Intézet oldalán.
3.3 Kétfaktoros azonosítás
Definíció Fogalom: kétfaktoros azonosítás
Biztonsági beállítás, amely úgy segít a felhasználói fiók megóvásában, hogy a jelszó mellett egy második védelmi vonal is védi a fiókot: ezt egy telefonra letölthető hitelesítő alkalmazás biztosítja. A rendszer az alkalmazás által generált biztonsági kódot is megköveteli a belépéshez. Ezáltal, ha a jelszavunk illetéktelen kezekbe kerül, nem lehet vele jogosulatlanul bejelentkezni a védett rendszerekbe.
Tipp A LIR fejezet 5. szakasza konkrét példa arra, hogyan működik ez a gyakorlatban egy levéltári rendszerben: az ÁBTL vagy a Központi Azonosítási Ügynökön (KAÜ) keresztüli belépést, vagy autentikátoralkalmazással történő kétfaktoros azonosítást ír elő – éppen a rendszerben tárolt személyes és szenzitív adatok miatt.
4. Felhőalapú munka a kutatásban
A felhőalapú rendszerek alapja az internet. A felhőszolgáltatások lényege, hogy az adatokat nem kell helyhez kötött szervereken, gépeken tárolni: minden a felhőben van, azaz internetkapcsolat mellett bármikor és bárhonnan elérhető. Minden alkalommal, amikor Google Drive-ot vagy OneDrive-ot használunk, felhőalapú tárhelyszolgáltatást veszünk igénybe.
A felhőalapú munka előnyei a kutatás során:
- Mivel ezek a szolgáltatások nem helyhez kötöttek, az itt tárolt adatokat bármely internetkapcsolattal rendelkező eszközről elérhetjük. Ha otthon és az egyetemi vagy könyvtári számítógépen is dolgozunk, nem szükséges ugyanabból a dokumentumból mindegyiken külön változatot tárolni.
- A legtöbb szolgáltatás ingyenes tárhelyet biztosít, amely szükség esetén térítés ellenében tovább bővíthető.
- Minimális annak a veszélye, hogy elveszítjük az adatainkat, például ha meghibásodik a számítógépünk. Ráadásul lehetséges a verziók visszaállítása: egy szerkesztett szöveg korábbi állapotához is bármikor visszatérhetünk.
- Közösen végzett munka esetén segíti az együttműködést. Szerkeszthetünk közösen dokumentumot, a dokumentumhoz kapcsolt megjegyzéseken keresztül kommunikálhatunk egymással.
- Egy felhőalapú tárhelyen megosztott közös mappában tárolhatunk például beszkennelt forrásokat vagy könyvek elektronikus változatát, amelyekhez egyszerre mindenki hozzáférhet.
Figyelem A felhőben tárolt kutatási anyag akkor is személyes adatokat tartalmazhat, ha ez elsőre nem tűnik fel: egy anyakönyvi kivonat fényképe, egy interjú hangfelvétele, egy 20. századi levéltári irat másolata mind ilyen. A megosztási beállításokat ezért mindig ellenőrizze, és ne tegyen nyilvánosan elérhetővé olyan mappát, amelyben ilyen anyag van. Levéltári másolatoknál a levéltár kiadási feltételei is kötelezőek.
5. Amit soha ne tegyen MI-eszközbe
Az előző szakasz logikája – az adat akkor is személyes, ha nem tűnik fel – sehol nem élesebb, mint az MI-eszközöknél. Ott ugyanis az adat nem egy megosztott mappában marad, hanem egy külső szolgáltató rendszerébe kerül be.
Ez nem ajánlás, hanem szabály. A 4/2025. (X. 28.) rektori utasítás 4.3. és 6.4. pontja, valamint az ELTE BTK Történeti Intézet MI használati szabályzatának 3.6. pontja szerint tilos MI-rendszer bemeneteként felhasználni:
- a személyes adatokat és ezek különleges kategóriáit;
- a nem publikált levéltári forrásokat, kéziratos dokumentumok szövegét;
- az oral history interjúk átirataiban szereplő személyes adatokat;
- a még nem publikált kutatási eredményeket;
- a titoktartási szerződés alatt keletkezett vagy üzleti titoknak minősülő adatokat.
Kivételt csak a témavezető vagy a kutatásvezető kifejezett írásos engedélye jelent. Az intézeti szabályzat szerint az adatvédelmi előírások megsértése súlyos fegyelmi vétség.
Figyelem A tilalom a bevitelre vonatkozik
Nem arra, hogy mit kért a géptől. Egy anyakönyvi bejegyzés lefordíttatása, egy interjúátirat összefoglaltatása vagy egy kutatótermi fotó „legépeltetése” ugyanúgy bevitel, mint bármi más – és ugyanúgy tilos.
Az MI-használat teljes szabályozását, a nyilatkozattételi kötelezettséggel együtt, a Mesterséges intelligencia a történeti kutatásban fejezet 4. szakasza tárgyalja.
Esettanulmány
Esettanulmány Egy szakdolgozat, amelyben élő emberek szerepelnek
Egy hallgató témája egy 1980-as évekbeli üzem munkásainak élettörténete. A kutatás során háromféle anyaghoz jut hozzá – és mindhárom más kezelést kíván.
1. Levéltári személyzeti iratok. A levéltári fejezetben látott védelmi idő vonatkozik rájuk. Az érintettek egy része ma is él, tehát a hallgató jó eséllyel csak tudományos célú kutatásra hivatkozva, írásbeli nyilatkozattal fér hozzájuk – és a megismert személyes adatokkal nem bánhat szabadon.
2. Saját interjúk. Ha a hallgató megszólaltat egykori munkásokat, ő maga válik adatkezelővé. Ez azt jelenti, hogy hozzájáruló nyilatkozat kell, az interjúalanyt tájékoztatni kell arról, mire használja a felvételt, és rendelkeznie kell arról is, meddig őrzi meg.
3. Korabeli üzemi újság. Ez nyilvánosságra hozott anyag: a benne megjelent nevek kezelése egészen más megítélés alá esik, mint a személyzeti akta. De itt is felmerül egy kérdés: aki 1985-ben szerepelt egy üzemi lap címoldalán, nem járult hozzá ahhoz, hogy negyven évvel később egy kereshető adatbázisba kerüljön.
A három szint együtt. A hallgató dolgozatában mindhárom anyag szerepel, tehát a legszigorúbb szabály szerint kell eljárnia annál a személynél, akiről többféle forrásból is van adata. Épp ez a kockázat: külön-külön ártalmatlan adatok összekapcsolva azonosítanak.
Figyelem Az összekapcsolás az, amitől érzékennyé válik az adat. Egy név önmagában kevés; egy név + munkahely + lakcím + egészségügyi adat együtt viszont már azonosít és sérthet. A kutatás során ezért nem az egyes adatokat, hanem az adatösszességet kell mérlegelni.
Mit tegyen a hallgató?
- Már a kutatás elején döntse el, kell-e névvel dolgoznia. Sok kérdés megválaszolható álnevekkel vagy kódokkal.
- Az azonosító adatokat külön fájlban tartsa a kutatási adatoktól, és csak egy kulcs kösse össze őket.
- A dolgozatban ne közöljön többet, mint amennyi az állítás alátámasztásához kell. A kutatás és a közlés két külön mérlegelés.
- Az adatkezelés végén törölje azt, amire már nincs szüksége – ez is része a felelős adatkezelésnek.
Gyakorlati feladat
Feladat 1. feladat – Saját digitális higiénia
Telepítsen egy jelszókezelőt, és vigye fel bele legalább három, a kutatáshoz használt fiókja adatait (pl. egyetemi fiók, Zotero, Google).
Kapcsolja be a kétfaktoros azonosítást legalább egy fiókján, és írja le lépésenként, mit kellett tennie.
Nézze át a felhőtárhelyén lévő kutatási mappáit: van-e köztük olyan, amelyben személyes adatot tartalmazó forrásmásolat van? Ellenőrizze a megosztási beállításokat.
Elvárt formátum: kb. 200 szavas beszámoló, képernyőkép nélkül (a biztonsági beállításokról ne készítsen képernyőképet).
Önellenőrző kérdések
1. Mi minősül személyes adatnak?
Válasz megjelenítése
Minden természetes személlyel kapcsolatba hozható adat, valamint az adatból levonható, az érintettre vonatkozó következtetés – például név, cím, azonosítószám, e-mail-cím, vagy ezek kombinációja.
2. Mi tartozik a különleges adatok körébe?
Válasz megjelenítése
Az etnikai, faji származásra, politikai, vallási vagy világnézeti meggyőződésre utaló adatok, valamint a genetikai, biometrikus és egészségügyi adatok.
3. Melyik törvény szabályozza részletesen a személyes adatok védelmét Magyarországon?
Válasz megjelenítése
Az információs önrendelkezési jogról és az információszabadságról szóló 2011. évi CXII. törvény; az alapjogi rendelkezést az Alaptörvény VI. cikk (3) bekezdése tartalmazza.
4. Mi a mesterjelszó?
Válasz megjelenítése
Az az egyetlen jelszó, amellyel a jelszókezelő alkalmazáshoz (a „jelszószéfhez”) hozzáférünk; a többi jelszót az alkalmazás titkosítva tárolja.
5. Miért nem elég önmagában a jelszó?
Válasz megjelenítése
Mert ha kiszivárog, azzal bárki beléphet. A kétfaktoros azonosítás egy második védelmi vonalat ad: a hitelesítő alkalmazás által generált, időhöz kötött kód nélkül a jelszó önmagában nem elég a belépéshez.
6. Beteheti-e egy MI-eszközbe egy még nem publikált levéltári irat átiratát, ha csak lefordíttatni szeretné?
Válasz megjelenítése
Nem. A rektori utasítás és a Történeti Intézet szabályzata is tiltja a nem publikált források, a személyes adatok, az interjúátiratok és a publikálatlan kutatási eredmények bevitelét MI-rendszerbe. A tilalom a bevitelre vonatkozik, nem arra, hogy mit kérünk az eszköztől; kivétel csak a témavezető kifejezett írásos engedélyével van.
Összefoglalás
Ebben a fejezetben tisztáztuk, mi a személyes adat, és mi különbözteti meg tőle a különleges adatot; megismertük a magyar jogi keretet; és három gyakorlati eszközt vettünk sorra a saját adataink védelmére: az erős jelszót, a jelszókezelőt és a kétfaktoros azonosítást. Végül a felhőalapú munka előnyeit és kockázatait tekintettük át, és külön megnéztük, mit tilos MI-eszköz bemeneteként felhasználni.
Az adatvédelem nem külön téma a kutatásmódszertanban, hanem annak szerves része: a levéltári hozzáférési szintektől (lásd a LIR fejezetet) a saját kutatási anyagunk tárolásáig ugyanaz az elv érvényes – a személyes adat védelme nem opcionális.
Kulcsfogalmak
bűnügyi adat – A személyes adatok egyik alcsoportja.
felhőalapú tárhely – Interneten keresztül elérhető tárolószolgáltatás, amely helyfüggetlen hozzáférést, verziókövetést és közös munkát tesz lehetővé.
jelszókezelő – Alkalmazás, amely titkosított formában tárolja a jelszavainkat; egyetlen mesterjelszóval nyitható.
kétfaktoros azonosítás – A jelszó mellé második védelmi vonalat állító eljárás, jellemzően hitelesítő alkalmazás által generált kóddal.
különleges adat – Szenzitív személyes adat: etnikai, faji származásra, politikai, vallási vagy világnézeti meggyőződésre utaló, illetve genetikai, biometrikus és egészségügyi adat.
mesterjelszó – Az a jelszó, amellyel a jelszókezelő tartalmához hozzáférünk.
személyes adat – Természetes személlyel kapcsolatba hozható minden adat, valamint az adatból levonható, az érintettre vonatkozó következtetés.
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Magyarország Alaptörvénye, VI. cikk (3) bekezdés. https://net.jogtar.hu/jogszabaly?docid=a1100425.atv
- 2011. évi CXII. törvény az információs önrendelkezési jogról és az információszabadságról. https://net.jogtar.hu/jogszabaly?docid=a1100112.tv
- 4/2025. (X. 28.) rektori utasítás a mesterséges intelligencia oktatásban történő használatáról az Eötvös Loránd Tudományegyetemen, 4.3. és 6.4. pont.
- Mesterséges intelligencia használati szabályzat. ELTE BTK Történeti Intézet, 3.6. pont.
Linkek és eszközök
- Nemzeti Kibervédelmi Intézet – jelszavakról – https://nki.gov.hu/it-biztonsag/kiadvanyok/segedletek/jelszo-vilagnap-2020/ – elérve: 2026. 08. 20.
- Nemzeti Kibervédelmi Intézet – jelszókezelőkről – https://nki.gov.hu/it-biztonsag/kiadvanyok/segedletek/a-jelszokezelokrol-2/ – elérve: 2026. 08. 20.
Adatok publikálása, dokumentáció, etika
| Szerző(k) | Ring Orsolya |
| Becsült feldolgozási idő | 90 perc |
| Előfeltétel | Adatkezelés és adatvédelem, A táblázattól az adatbázisig |
| Ajánlott hozzá | Adatbázisépítés saját adatokon – haladó |
| Verzió / dátum | v0.1 / 2026. augusztus |
Miről szól ez a fejezet?
Az előző fejezetek adatgyűjtésről, adatbázis-építésről és vizualizációról szóltak. Most az utolsó – és gyakran alulbecsült – lépés következik: mi történik az adattal a kutatás után. Megnézzük, miért érdemes publikálni, mit jelentenek a FAIR alapelvek, hogyan kell dokumentálni egy adatbázist, milyen licencet válasszunk, és hol húzódnak az adatvédelmi és etikai határok.
Tanulási célok
Tanulási célok A fejezet végére Ön képes lesz arra, hogy…
- saját szavaival elmagyarázza a FAIR négy alapelvét, és mindegyikhez példát hoz történeti adatra;
- összeállít egy README-t egy kisebb saját adatsorhoz, kódkönyvvel együtt;
- indokolt licencválasztást tesz egy adatpublikációhoz;
- eldönti egy konkrét kutatási helyzetről, hogy a GDPR hatálya alá esik-e, és megnevezi a lehetséges jogalapot;
- végigmegy egy adatpublikációs ellenőrző listán a közzététel előtt.
Bevezetés: miért publikáljunk egyáltalán?
Tudományos reprodukálhatóság. Az állítások csak akkor ellenőrizhetők, ha a forrásadatok hozzáférhetők. Enélkül mások teljes adatgyűjtést kell hogy elvégezzenek ahhoz, hogy megnézzék, igaza volt-e Önnek.
Közpénzből finanszírozott kutatás. A támogatási szerződések (NKFIH, Horizon Europe) szinte mindig előírják a nyílt adatpublikálást, általában a FAIR alapelvek szerint.
Tudománytörténeti értékőrzés. Egy gondosan felépített adatbázis évtizedek múlva is forrásértékű marad. Melléklet nélkül publikálva viszont „halott”: az eredmény megmarad, az alapja elvész.
Közösségi építkezés. Nyíltan közzétett adatokra mások ráépítenek, szélesítik a korpuszt, más kérdéseket vizsgálnak, más adatbázisokkal összekapcsolják.
1. FAIR – a nyílt adatpublikálás négy alapelve
Definíció Fogalom: FAIR alapelvek
A 2016-ban közzétett FAIR Guiding Principles for scientific data management and stewardship rövidítése; ma az EU és a fő finanszírozók alapkövetelménye.
| Betű | Jelentés | Történeti adatra értelmezve |
|---|---|---|
| F – Findable | megtalálható | tartós azonosító (DOI), részletes metaadat, indexált repozitórium |
| A – Accessible | hozzáférhető | nyílt URL, szabványos protokoll, szükség szerinti hitelesítés |
| I – Interoperable | interoperábilis | nyílt formátum (CSV, JSON, TEI-XML), szabványos vokabulárium |
| R – Reusable | újrahasználható | világos licenc, részletes dokumentáció, provenance-információ |
Figyelem A FAIR nem azonos a teljesen nyílt hozzáféréssel.
Szenzitív adat is lehet FAIR: a hozzáférés ilyenkor korlátozható, de a megtalálhatóság, az interoperabilitás és az újrahasználhatóság formálisan biztosított marad. Vagyis a rekord létezéséről és tartalmáról lehet tudni akkor is, ha maga az adat csak kérésre, ellenőrzött feltételek mellett érhető el.
2. Hol publikáljunk?
| Repozitórium | Profil | Előnye |
|---|---|---|
| Zenodo | általános, CERN-üzemeltetés | ingyenes, DOI, verziókezelés, GitHub-integráció |
| Figshare | általános, kereskedelmi | felhasználóbarát, hosszú távú archiválás |
| OSF | projektfókuszú | teljes kutatási projekt kezelése, preregisztráció |
| Harvard Dataverse | társadalomtudomány | kiforrott metaadat-szabványok (DDI) |
| CLARIN | nyelvtechnológia, humán | TEI-XML, korpuszszabványok |
| Hungaricana | magyar kultúrtörténet | nemzeti közgyűjteményi hálózat |
| GitHub | verziókezelés | nem hivatalos adatrepozitórium; DOI-ért Zenodóval kell integrálni |
Tipp Ökölszabály. Kisebb-közepes prozopográfiai vagy forrásközlő adatbázisra a Zenodo a legszélesebb körben elfogadott. Nyelvtechnológiai vagy TEI-XML korpuszra a CLARIN. Preregisztrált kutatásra az OSF.
2.1 Egy tipikus publikálás Zenodón
- Regisztráció a
zenodo.orgoldalon – ORCID-dal javasolt, az automatikus profilintegráció miatt. - Feltöltés: fájlok beküldése (CSV, XLSX, JSON, PDF-dokumentáció, README).
- Metaadat-kitöltés: szerzők ORCID-del, cím, leírás, kulcsszavak, dátum, nyelvek, kapcsolódó publikációk DOI-jai.
- Licencválasztás (lásd a 4. szakaszt).
- Közzététel: a Zenodo állandó DOI-t ad
(
10.5281/zenodo.XXXXXXX). - A DOI beillesztése a tanulmányba – lábjegyzetben vagy külön „Data availability statement” szakaszban.
A Zenodo támogatja a verziókezelést: későbbi kiegészítéskor új verzió hozható létre saját DOI-val, de közös „concept DOI”-hoz tartozik.
3. A README mint műfaj
A README (README.md vagy README.txt) a
repozitórium gyökerébe kerül. Nélküle a legjobb adat is
használhatatlan – az olvasó nem tudja, mit jelentenek az
oszlopok, hogyan gyűjtötték őket, mit lehet velük csinálni.
3.1 Mit tartalmazzon?
- Rövid leírás – 3–5 mondat: mi van az adatban, milyen kérdésre készült, mely időszakra és területre vonatkozik.
- Szerzők és hozzájárulás – név, intézmény, ORCID, szerep (adatgyűjtés / tisztítás / elemzés / dokumentáció).
- Az adatbázis szerkezete – fájllista, mindegyikhez rövid magyarázat és rekordszám.
- Kódkönyv (data dictionary) – oszloponként: típus, lehetséges értékek, magyarázat.
- Források – mely elsődleges és másodlagos forrásokból származik az adat.
- Adatgyűjtés módszertana – hogyan válogattuk ki az eseteket, mit tettünk a bizonytalan adatokkal.
- Harmonizálási döntések – a tisztítás elvei.
- Ismert hiányosságok – mit nem tudunk az adatról, hol vannak szisztematikus torzítások.
- Verzióhistória – mi változott az egyes verziók között.
- Licenc és preferált citálási forma.
- Kapcsolat.
Példa Egy kódkönyv-részlet
| Oszlop | Típus | Értékek | Magyarázat |
|---|---|---|---|
szemely_id |
egész szám | 1–1870 | egyedi azonosító |
nev |
szöveg | szabad szöveg | „Vezetéknév Keresztnév” |
szul_ev |
egész szám | 1880–1935 | születési év; üres = ismeretlen |
vallas |
szöveg | rk, ref, ev, izr | kódtábla a vallasok.csv-ben |
Enélkül a vallas oszlop rk értéke semmit
sem jelent egy külső olvasónak.
3.2 Négy gyakori hiba
Figyelem - „Önmagáért beszélő”
oszlopnevek. A status vagy tipus
oszlop kódrendszere nélkül az adat használhatatlan. - A
harmonizálási döntések dokumentálásának hiánya. Öt év múlva Ön
maga sem fogja tudni, miért lett „R. k.”-ból „Római katolikus”. -
A „hiányzik” kódolásának elmulasztása. Üres cella,
n.a., NULL, -, ? –
legalább tudni kell, melyik volt melyik. - Verzióhistória
hiánya. Több verziónál az olvasó nem tudja, mi változott.
3.3 Gépi metaadat
A README emberi olvasóra szabott; a gépi feldolgozáshoz strukturált metaadat kell. A leggyakoribb szabványok: Dublin Core (általános, 15 mező – lásd a Digitális forráskiadás fejezetet), DDI (társadalomtudományi adathalmazok), TEI P5 (kritikai forráskiadások, szövegkorpuszok), DataCite (a DOI-kiadásnál elvárt).
A gyakorlatban kézzel nem kell XML-t írni: a repozitóriumok webes űrlapon kérdezik be a mezőket, és a háttérben generálják a megfelelő fájlt.
4. Licencek
A licenc jogilag szabályozza az újrahasználást.
| Licenc | Feltétel | Mikor? |
|---|---|---|
| CC0 1.0 | semmi (közkincs) | közkincsből származó adat, nincs szerzői jogi érdekünk |
| CC-BY 4.0 | attribúció kötelező | akadémiai publikálás – a leggyakoribb választás |
| CC-BY-SA 4.0 | attribúció + azonos licenc | ha a ráépítéseknek is nyíltnak kell maradniuk |
| CC-BY-NC 4.0 | attribúció + nem kereskedelmi | óvatosság a kommercializálástól |
| ODbL | attribúció + SA, adatbázis-specifikus | tiszta adatbázislicenc (az OpenStreetMap ezt használja) |
Tipp Ha nincs speciális ok a korlátozásra, a CC-BY 4.0 a standard. Az NC (nem kereskedelmi) és az ND (nem származtatható) akadémiai adatnál inkább hátráltat, mint segít: megakadályozza tankönyvek, aggregátorprojektek és publikációs platformok általi felhasználást.
Fontos: a Creative Commons licencek adatra és szövegre valók, nem kódra. Szoftverhez MIT, Apache 2.0 vagy GPL licenc való.
5. GDPR a történeti kutatásban
A GDPR a természetes személyek személyes adataira vonatkozik. Történeti kutatásban két fő eset különíthető el.
5.1 Elhunyt személyek
A GDPR kifejezetten kimondja, hogy nem terjed ki elhunyt személyek adataira (27. preambulumbekezdés). Egy 19. századi vagy korábbi prozopográfia alapvetően GDPR-mentes. A tagállami jog azonban ezt kiegészítheti:
- Magyarországon az Infotv. nem szabályozza külön az elhunytak adatait, de a kegyeleti jog (Ptk.) alapján a hozzátartozók a személyhez fűződő jog sérelme esetén felléphetnek. Ez különösen érzékeny adatokra vonatkozik (szexualitás, betegség, bűncselekmény).
- Más tagállamokban (például Dánia, Olaszország) a GDPR kifejezetten kiterjeszthető elhunytak adataira – nemzetközi publikálásnál ezt mérlegelni kell.
5.2 Élő személyek
A kortárs prozopográfia általában a GDPR hatálya alá esik. Két tipikus jogalap:
Tudományos kutatás (GDPR 89. cikk): tudományos, statisztikai vagy levéltári célú feldolgozás megengedett megfelelő biztosítékok mellett – adatminimalizálás, álnevesítés, hozzáférés-szabályozás, intézményi etikai engedély.
Hozzájárulás (GDPR 6. cikk (1) a)): a személy írásos, tájékozott hozzájárulása. Nagy mintánál ritkán praktikus, de interjú- vagy életútkutatásnál standard.
Figyelem Kortárs adaton soha ne publikáljon név + cím + születési dátum kombinációt nyílt adathalmazként. Az ilyen adat álnevesítve (azonosítóval, a neveket külön tartva, hozzáférés-szabályozottan) publikálandó.
5.3 Különleges (szenzitív) kategóriák
A GDPR 9. cikke szigorúbb védelmet ír elő az alábbi adatokra: faji vagy etnikai hovatartozás, politikai vélemény, vallási vagy filozófiai meggyőződés, szakszervezeti tagság, genetikai és biometrikus adat, egészség, szexuális élet vagy orientáció.
Történeti kutatásban a vallási hovatartozás és a politikai vélemény vagy párttagság rendszeresen előkerül. Elhunyt személyeknél ez nem GDPR-probléma; élőknél igen, és intézményi etikai engedély is szükséges lehet.
6. Kutatói etika – ami túlmutat a jogon
Figyelem Kegyeleti érzékenység. Egy elhunyt személy családjának fájhat a részletes, negatív tónusú karrierfeltárás, még ha jogilag rendben is van. Különösen érzékeny a Horthy-, a Rákosi- és a Kádár-rendszer: az érintettek ma többnyire elhunytak, de leszármazottaik élnek, és a párttagság vagy a besúgói múlt feltárása súlyos kegyeleti következménnyel járhat.
Ez közvetlenül érinti az Állambiztonsági archontológia és a LIR fejezetekben tárgyalt adatokat.
Archivális szerződések. Ha levéltári anyagból gyűjtött, az intézmény szerződése rendszerint tartalmaz felhasználási klauzulát – például hogy a digitalizált kép nem publikálható, csak az abból kinyert adat. Ezt pontosan be kell tartani.
Élő kutatói közösség. Ha egy témán többen dolgoznak párhuzamosan, a korai publikálás kisajátíthatja a területet. Etikus gyakorlat a korai adat megosztása a közösséggel az elemzés közben.
Attribúció. Ha az adat egy részét más kutató gyűjtötte, vagy korábbi publikációból vette, névvel meg kell említeni – akkor is, ha formális engedély nem volt kötelező.
7. Hosszú távú megőrzés
A publikálás nem azonos az archiválással. Egy ingyenes kereskedelmi szolgáltatás tíz év múlva már nem biztos, hogy létezik.
- Intézményi repozitórium. Az egyetemek (ELTE EDIT, MTA REAL) disszertációkat és mellékleteiket őrzik; az intézmény garantálja a megőrzést.
- OAIS-szabványú letéti szolgáltatás (például a Zenodo a CERN adatkezelésével) – formális hosszú távú megőrzési ígérettel.
- Formátumfüggetlenség. A
.docxvagy.xlsxhúsz év múlva nehezen olvasható; a.csv,.xml,.json,.txtgyakorlatilag örök. A Word mellett CSV- vagy TEI-XML-változat is szükséges. - Több helyen. Egy repozitórium és egy verziókezelő, vagy intézményi és kereskedelmi. A LOCKSS elve: Lots of Copies Keep Stuff Safe.
8. Publikálási ellenőrző lista
| Lépés | Kérdés |
|---|---|
| 1. Nyers + harmonizált adat | Mindkét verzió elérhető? Egyértelmű, melyik melyik? |
| 2. README | Minden oszlopnak van magyarázata? A harmonizálási döntések dokumentáltak? |
| 3. Metaadat | Szerzők, dátum, kulcsszavak, kapcsolódó DOI-k kitöltve? |
| 4. Licenc | Megfelelő licenc választva? Adatra és kódra külön? |
| 5. Forrásattribúció | Minden forráshivatkozás pontos? A korábbi gyűjtők említve? |
| 6. Adatvédelem | Van-e élő személy? Ha igen, álnevesítve vagy hozzáférés-szabályozva? |
| 7. Repozitórium | Kiválasztva? Megfelel a finanszírozó előírásainak? |
| 8. DOI | A kiadott DOI beillesztve a tanulmányba? |
| 9. Verziózás | Ha később változni fog, van verziózási terv? |
| 10. Biztonsági másolat | Van saját gépen vagy intézményi felhőben? |
A lista végigmenése néhány óra munka – de a kutatás társadalmi értékét sokszorosára emeli.
Esettanulmány
Esettanulmány Ugyanaz az adatsor, két állapotban
Egy hallgató szakdolgozatához összeállít egy táblázatot: 1200 sor, egy vármegye 1873-as kolerahalálozásairól, anyakönyvekből gyűjtve. A dolgozat elkészül. Mi történjen az adatsorral?
A) A szokásos vég. A fájl neve
kolera_vegleges_JAVITOTT2.xlsx, és a hallgató laptopján
marad. Öt év múlva:
- senki nem tudja, melyik oszlop mit jelent (
hal_ok2,tel_kod); - nem derül ki, melyik anyakönyvekből származik – nincs jelzet;
- nem tudni, mi volt üres cella és mi „nincs adat”;
- a fájl formátuma addigra elavult, a laptop pedig elveszett.
B) A publikálható változat. Ugyanaz az adat, négy különbséggel:
- Nyílt formátum:
.csv, nem.xlsx– szoftvertől függetlenül olvasható. - README mellette: mit tartalmaz, mikor és hogyan gyűjtötték, mit jelent minden oszlop, mit jelent az üres cella, milyen döntések születtek a kétes esetekben.
- Forrásmegjelölés soronként: minden rekordhoz levéltári jelzet – így bárki visszaellenőrizheti.
- Repozitóriumban elhelyezve, azonosítóval (DOI) és licenccel – így hivatkozható és jogilag egyértelmű.
Mi a különbség a két állapot között? Ugyanannyi munka fekszik bennük. A különbség a dokumentációban van – és abban, hogy a második változat önmagában is tudományos teljesítmény: hivatkozható, újrahasznosítható, és a hallgató publikációs listájára is felkerülhet.
Figyelem Amit nem szabad publikálni. Ha az adatsorban élő személyek azonosítható adatai vannak, a nyílt közzététel jogsértő lehet. Ilyenkor az adatot anonimizálni kell, vagy csak a leíró statisztikát és a metaadatokat publikálni, magát az adatsort pedig korlátozott hozzáféréssel elhelyezni. Erről szól az Adatkezelés és adatvédelem fejezet.
A gyakorlati tanács: a README-t ne a végén írja meg, hanem a kutatás elején kezdje el, és menet közben vezesse. Ami a gyűjtés közben magától értetődő döntésnek látszik, az fél év múlva megfejthetetlen lesz.
Gyakorlati feladatok
Feladat 1. feladat – README készítése
Vegye elő azt a kis adatsort, amelyet az Adatbázisépítés fejezet 1. feladatában tervezett (vagy készítsen egy 15–20 soros minitáblázatot bármilyen forrásból).
Írjon hozzá README-t a fejezet 3.1 pontjának szerkezete szerint.
A kódkönyvben minden oszlophoz adja meg a típust, a lehetséges értékeket és a magyarázatot.
Külön szakaszban írja le, mit nem tud az adatról, és hol lehetnek szisztematikus torzítások.
Elvárt formátum: kb. 500 szavas README (Markdown vagy sima szöveg) + a táblázat.
Feladat 2. feladat – Jogi és etikai döntés
Az alábbi négy helyzetről döntse el, (a) a GDPR hatálya alá esik-e, (b) milyen jogalapon dolgozhatna, (c) milyen etikai megfontolás merül fel, és (d) milyen formában publikálná az adatot.
- Egy 1780-as úrbéri összeírás jobbágyneveinek adatbázisa.
- Az 1950-es évek járási tanácselnökeinek archontológiája.
- Egy 2015-ös civil szervezet aktivistáiról készült interjúsorozat.
- Egy 1930-as évekbeli iskolai anyakönyv, amely a tanulók vallását is tartalmazza.
Elvárt formátum: négysoros táblázat + kb. 150 szavas összegző reflexió.
Önellenőrző kérdések
1. Mit jelent a FAIR négy betűje?
Válasz megjelenítése
Findable (megtalálható – tartós azonosító, metaadat), Accessible (hozzáférhető – nyílt URL, szabványos protokoll), Interoperable (interoperábilis – nyílt formátum, szabványos vokabulárium), Reusable (újrahasználható – világos licenc, dokumentáció, provenance).
2. Igaz-e, hogy a FAIR = teljesen nyílt hozzáférés?
Válasz megjelenítése
Nem. Szenzitív adat is lehet FAIR: a hozzáférés korlátozható, de a megtalálhatóság, az interoperabilitás és az újrahasználhatóság formálisan biztosított marad.
3. Melyik licenc a standard akadémiai adatpublikáláshoz, és miért nem az NC?
Válasz megjelenítése
A CC-BY 4.0. A nem kereskedelmi (NC) és a nem származtatható (ND) kikötés akadémiai adatnál inkább hátráltat: megakadályozza tankönyvek, aggregátorprojektek és publikációs platformok általi felhasználást.
4. Kiterjed-e a GDPR az elhunyt személyek adataira?
Válasz megjelenítése
A GDPR maga nem terjed ki rájuk (27. preambulumbekezdés), de a tagállami jog kiegészítheti. Magyarországon a kegyeleti jog alapján a hozzátartozók felléphetnek, különösen érzékeny adatok esetén.
5. Miért nem elég a Word-fájl a hosszú távú megőrzéshez?
Válasz megjelenítése
Mert a zárt, alkalmazásfüggő formátumok húsz év múlva nehezen olvashatók. A CSV, XML, JSON és TXT formátumok gyakorlatilag időtállók, ezért a Word vagy Excel mellett ilyen változatot is közzé kell tenni.
Összefoglalás
Ebben a fejezetben a kutatási folyamat záró lépését vettük végig. Láttuk, miért tudományos kötelezettség az adatok publikálása, és megismertük a FAIR négy alapelvét. Végigvettük, hol publikáljunk, hogyan dokumentáljunk (README és kódkönyv), milyen licencet válasszunk, és hol húzódnak a GDPR, a kegyeleti jog és a kutatói etika határai. Végül összeállítottuk a közzététel előtti ellenőrző listát.
A fejezet legfontosabb üzenete: az adat dokumentáció nélkül nem adat, hanem számsor. Aki nem írja le, mit jelentenek az oszlopai és milyen döntések alakították őket, az néhány év múlva a saját munkáját sem fogja tudni használni – másokról nem is beszélve.
Kulcsfogalmak
álnevesítés (pszeudonimizálás) – Olyan eljárás, amelynek során a személyes azonosítókat azonosítóra cseréljük, és a feloldókulcsot elkülönítve, védetten tároljuk.
DOI – Digitális objektumazonosító; az adatpublikáció állandó, hivatkozható címe (lásd az ORCID és DOI fejezetet).
FAIR alapelvek – Megtalálható, hozzáférhető, interoperábilis, újrahasználható – a nyílt adatpublikálás négy követelménye.
kegyeleti jog – A Ptk. által védett jog, amely alapján a hozzátartozók felléphetnek elhunyt személy személyhez fűződő jogának sérelme esetén.
kódkönyv (data dictionary) – Az adatbázis oszlopainak leírása: típus, lehetséges értékek, jelentés.
LOCKSS – Lots of Copies Keep Stuff Safe: a több helyen tárolás megőrzési elve.
README – A repozitórium gyökerében álló dokumentáció, amely nélkül az adat nem értelmezhető.
repozitórium (adatrepozitórium) – Kutatási adatok tartós megőrzésére és közzétételére szolgáló szolgáltatás (pl. Zenodo, Dataverse, CLARIN).
Felhasznált és ajánlott irodalom
Felhasznált irodalom
- Ring Orsolya: Adat a történettudományban. ELTE BTK Történelem Segédtudományai Tanszék, 2026. 15. fejezet. https://ringorsolya.github.io/adat_tortenettudomany/
- Wilkinson, Mark D. et al.: The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data 3. (2016) 160018. https://doi.org/10.1038/sdata.2016.18
- Az Európai Parlament és a Tanács (EU) 2016/679 rendelete (GDPR), 6., 9. és 89. cikk, valamint 27. preambulumbekezdés.
Linkek és eszközök
- Zenodo – https://zenodo.org/ – elérve: 2026. 08. 20.
- Zenodo súgó – https://help.zenodo.org/ – elérve: 2026. 08. 20.
- Open Science Framework (OSF) – https://osf.io/ – elérve: 2026. 08. 20.
- Harvard Dataverse – https://dataverse.harvard.edu/ – elérve: 2026. 08. 20.
- CLARIN – https://www.clarin.eu/ – elérve: 2026. 08. 20.
- Creative Commons licencválasztó – https://chooser-beta.creativecommons.org/ – elérve: 2026. 08. 20.
- DMPTool (adatkezelési terv sablonok) – https://dmptool.org/ – elérve: 2026. 08. 20.
- MTA REAL repozitórium – https://real.mtak.hu/ – elérve: 2026. 08. 20.
Szószedet
A szószedet a fejezetek „Kulcsfogalmak” szakaszaiból épül fel, automatikusan. Minden tétel mellett feltüntetjük, melyik fejezetben vezettük be.
(
- (adatbázis-)rekord
-
Az adatbázis önálló, egyedi azonosítóval ellátott információs egysége, amely egy adott személyre, partnerre vagy leírási egységre vonatkozó strukturált adatokat és metaadatokat tartalmaz. Nem tévesztendő össze az ISAD(G) szabvány irat (record) fogalmával. (ISAD(G) fogalomtár) (→ Levéltári Információs Rendszer (LIR))
- (levéltári) kutatás
-
„A levéltári anyag tanulmányozása, abból adatok kigyűjtése tudományos vagy más cél érdekében.” A levéltár a levéltári anyagot nyilvántartása, tudományos igényű rendszerezése és tájékoztatási célú segédletek (vagy segédadatbázisok) készítése útján teszi kutatásra alkalmassá, és így bocsátja a kutatók rendelkezésére. (Levéltári fogalomtár alapján) (→ Levéltári Információs Rendszer (LIR))
A
- a pontosság látszata
-
Az a jelenség, amikor a koordináta több tizedesjeggyel méteres pontosságot sugall, holott a forrásban csak nagyvonalú helymegjelölés szerepelt. (→ Térbeli adatbázisok: amikor az adat egy helyhez tartozik)
- academic social network (tudományos közösségi háló)
-
Kereskedelmi online platform kutatók kapcsolatépítésére és publikációmegosztásra; nem repozitórium. (→ Academia.edu és ResearchGate)
- adat (data)
-
Strukturált információ, amelyet a kutató a forrásból nyer ki a kutatási kérdései és elméleti keretei alapján; mindig interpretáció eredménye. (→ Adat a történettudományban)
- adatbázis
-
Strukturáltan tárolt, egymással kapcsolatban lévő adatok összessége, amelyek egy meghatározott célra szervezve, elektronikusan vannak tárolva. (→ Mi az adatbázis?)
- AdatbázisokOnline (AOL)
-
A Magyar Nemzeti Levéltár adatbázis-gyűjtő felülete: a levéltári iratokból feldolgozott, tételes és kereshető adat. (→ AdatbázisokOnline: a levéltári adatbázisok gyűjtőhelye)
- adatintegritás
-
Az az állapot, amelyben az adatok pontosak, konzisztensek és megbízhatóak; az adatbázis-kezelő típusellenőrzéssel, kötelező mezőkkel, egyedi kulcsokkal és referenciális integritással tartja fenn. (→ Mi az adatbázis?)
- adatlap (interjúé)
-
Az interjú alapadatait rögzítő dokumentum: ki, mikor, hol, milyen kutatás keretében készítette, kivel. Enélkül az interjú nem datálható és nem kritizálható forrásként. (→ Oral history: az elbeszélt emlékezet mint forrás)
- adatszegény oldal
-
A gépi feldolgozás jelzése arról, hogy egy oldalról kevés adatot sikerült kinyerni. (→ AdatbázisokOnline: a levéltári adatbázisok gyűjtőhelye)
- adattisztítás (harmonizálás)
-
Az adatbevitel utáni szakasz, amelyben az írásmódbeli, rövidítésbeli és kategorikus eltéréseket egységesítjük, az eredeti értékek megőrzése mellett. (→ Adatbázisépítés saját adatokon (haladó))
- adatvalidáció
-
A bevihető értékek előzetes korlátozása (legördülő lista, értéktartomány, típuskényszer), amely megelőzi az elgépelést és a következetlen kódolást. (→ A táblázattól az adatbázisig: Excel és Access (haladó))
- aggregátor
-
Nemzeti vagy szakmai gyűjtőpont, amely intézmények digitalizált anyagának leíró adatait összegyűjti, ellenőrzi, gazdagítja és továbbadja egy közös portálnak. (→ Europeana: európai közgyűjtemények egy felületen)
- algyűjtemény
-
Gyűjteményen belüli mappa a Zoteróban, a tételek finomabb tematikus bontására. (→ Hivatkozáskezelés: a Zotero)
- állami anyakönyvezés
-
1895. október 1-jétől kötelező, állami anyakönyvvezetők által, egységes űrlapokon vezetett nyilvántartás. (→ Családfakutatás: felületek és forráskritika)
- álnevesítés (pszeudonimizálás)
-
Olyan eljárás, amelynek során a személyes azonosítókat azonosítóra cseréljük, és a feloldókulcsot elkülönítve, védetten tároljuk. (→ Adatok publikálása, dokumentáció, etika)
- Arcanum Kézikönyvtár
-
Az Arcanum ingyenes online gyűjteménye lexikonokból, szótárakból, helységnévtárakból és történeti alapművekből; szövege kézi szedésű és korrektúrázott. (→ Az Arcanum tudományos gyűjteményei)
- Arcanum Újságok (ADT)
-
Magyarország legnagyobb digitális periodika-adatbázisa; a keresés díjtalan, a megjelenítés előfizetéses. Napilapok mellett tudományos folyóiratokat is tartalmaz. (→ Az Arcanum tudományos gyűjteményei)
- archontológia
-
Hivatalviselők, tisztségek és adminisztratív pozíciók adatbázisa; célja intézményi struktúrák és hatalmi viszonyok feltérképezése. (→ Adat a történettudományban)
-
A történelem azon segédtudománya, amely a tisztségviselők, hivatalnokok hivatali névsorának összeállításával és életpályájuk kutatásával foglalkozik. (→ Állambiztonsági archontológia)
- arckeresés
-
Gépi arcfelismerésen alapuló keresés sajtófotókon és illusztrációkon. (→ Digitalizált sajtó és térkép: az Arcanum forrásgyűjteményei)
- atomicitás
-
Az az elv, amely szerint minden mező egyetlen, tovább nem bontható értéket tartalmaz; az 1. normálforma követelménye. (→ Mi az adatbázis?)
- attribútum
-
Egy entitás jellemzője, az adatbázis egy mezője (például születési év). (→ Adatbázisépítés saját adatokon (haladó))
- autentikáció (azonosítás)
-
Olyan biztonsági folyamat, amelynek során ellenőrzik, hogy egy entitás valóban az-e, akinek vagy aminek mondja magát. Célja, hogy a rendszerekhez és szolgáltatásokhoz csak az arra feljogosítottak férhessenek hozzá. Leggyakoribb formája az egyfaktoros azonosítás (felhasználónév és jelszó); a kétfaktoros azonosításnál egy további hitelesítési elem is belép. (NKI fogalomtár) (→ Levéltári Információs Rendszer (LIR))
- autopszia
-
A forráskritika elve, amely szerint a kutató lehetőleg eredetiben, és nem közvetítésen keresztül vizsgálja a forrást. (→ Mi a forrás?)
B
- bejátszás
-
Egy filmhíradó-számon belüli önálló híradás; a Filmhíradók Online-on ez az adatbázis rekordegysége. (→ Filmhíradók Online: a mozgókép mint forrás)
- belső kritika
-
A forráskritika része, amely a forrás tartalmi hitelességét és megbízhatóságát vizsgálja: mit állít, honnan tudhatta a szerző, milyen érdek vagy nézőpont torzíthatja. (→ Mi a forrás?)
- bibliográfia
-
Egy adott témához köthető szakszerű irodalomjegyzék. (→ Magyar Tudományos Művek Tára (MTMT))
- born-digital forrás
-
Olyan forrás, amely eleve digitális formában jött létre, és nem volt korábbi analóg verziója. (→ Digitalizálás és optikai karakterfelismerés (OCR))
-
Olyan forrás, amely már eleve digitális formában jött létre, és nem volt korábbi analóg verziója (pl. e-mail, közösségimédia-bejegyzés). (→ Mi a forrás?)
- bűnügyi adat
-
A személyes adatok egyik alcsoportja. (→ Adatkezelés és adatvédelem)
C
- capta
-
Drucker fogalma az adat pontosabb megnevezésére: hangsúlyozza, hogy az adatot a kutató konstruálja, nem pedig „adott”. (→ Adat a történettudományban)
- CC BY-SA
-
Creative Commons „Nevezd meg! – Így add tovább!” licenc: szabad felhasználás a forrás megnevezésével, az átdolgozás pedig azonos licenc alatt adható tovább. (→ Fortepan: közösségi fotóarchívum)
- choropleth térkép
-
Területszínezéses térkép, amely egy mennyiséget földrajzi egységenként színárnyalattal jelenít meg. (→ Kutatási eredmények vizualizálása)
- cikkszegmentálás
-
A beszkennelt újságoldal cikkekre bontása: az olvasási sorrend helyreállítása, a címek és képaláírások felismerése. (→ Digitalizált sajtó és térkép: az Arcanum forrásgyűjteményei)
- cikkszintű index
-
Olyan adatbázis, amely nem a kiadvány egészét, hanem az egyes cikkeket írja le; a MATARKA a folyóiratok tartalomjegyzékéből építi. (→ Cikkszintű és nemzetközi keresés)
- Copyright Not Evaluated
-
Jogállapot-jelzés, amely azt közli, hogy a szolgáltató nem vizsgálta meg a szerzői jogi helyzetet; nem tiltás, hanem a bizonytalanság jelzése. (→ Europeana: európai közgyűjtemények egy felületen)
- Creative Commons licenc
-
Szabványos felhasználási engedélycsalád (CC0, CC BY, CC BY-SA, CC BY-NC), amely előre rögzíti, mit tehet a felhasználó a művel. (→ Europeana: európai közgyűjtemények egy felületen)
- csillagos ház
-
Az 1944. június 16-i fővárosi rendelettel kényszerlakhelyül kijelölt budapesti épület, amelynek bejárata fölé sárga Dávid-csillagot kellett elhelyezni; a beköltözés határideje 1944. június 21. volt. (→ Térbeli adatbázisok: amikor az adat egy helyhez tartozik)
- csonkolás
-
Keresési technika, amelyben karakterhelyettesítő jelekkel (
*,?,!) egyszerre több szóalakra keresünk; a helyesírási változatok és az OCR-hibák kezelésének fő eszköze. (→ Szaktárs: magyar szakkönyvek egy felületen) -
Keresési fogás, amellyel a szótő után tetszőleges karakterek állhatnak (
*); magyar szövegben a toldalékolás miatt szinte mindig szükséges. (→ Az Arcanum tudományos gyűjteményei) - csonkolt tengely
-
Nem nullától induló értéktengely; a különbségeket felnagyítja, ezért gyakori félrevezetési forma. (→ Kutatási eredmények vizualizálása)
D
- data-ink ratio
-
Tufte fogalma: a valódi adatot hordozó és az összes felhasznált grafikai elem aránya; minél magasabb, annál tisztább az ábra. (→ Kutatási eredmények vizualizálása)
- digitális bölcsészet
-
Interdiszciplináris terület, amely a digitális eszközök és technikák használatát jelenti a bölcsészettudományi kutatásokban. (→ Digitális bölcsészet és digitális történettudomány)
- digitális forráskiadás
-
Történeti dokumentumok tudományos igényű, kritikai jegyzetekkel és metaadatokkal ellátott, kereshető digitális közzététele. (→ Digitális forráskiadás)
- digitális kulturális örökség
-
A kulturális örökség digitális formában megőrzött és hozzáférhetővé tett része, illetve az ezt célzó tevékenység. (→ Digitális bölcsészet és digitális történettudomány)
- digitális kutatói példány
-
Az ÁBTL-ben használt kifejezés: az iratok azon digitális másolati példánya, amelyet kutatók számára készítettek elő. Az egyik fajtáját magánkutatók részére állítják össze – ebben nemcsak a védendő különleges adatokat, hanem a védelem alá eső személyes adatokat is anonimizálják. A másik a tudományos kutatói példány, amelyben csak a védendő különleges (egészségi állapotra, kóros szenvedélyre és szexuális életre vonatkozó) információkat takarják ki. (→ Levéltári Információs Rendszer (LIR))
- digitális történettudomány
-
A digitális bölcsészet történeti kutatásra szakosodott ága; eredményei többek között digitális archívumok, adatvizualizációk, interaktív térképek. (→ Digitális bölcsészet és digitális történettudomány)
- digitalizált forrás
-
Olyan forrás, amelyet eredetileg analóg formában (papíron, tárgyként) hoztak létre, és utólag digitalizáltak (szkennelés, OCR, metaadatozás). (→ Mi a forrás?)
- digitalizált kiadás vs. digitális kiadás
-
A digitalizált kiadás egy nyomtatott kiadvány elektronikus másolata; a digitális kiadás a digitális közeg logikája szerint készül, és nem reprodukálható maradéktalanul nyomtatásban. (→ Digitális forráskiadás)
- dinamikus szűrő
-
Olyan találati listaszűrő, amely csak az adott találathalmazban ténylegesen előforduló szűrési feltételeket ajánlja fel. (→ Levéltári Információs Rendszer (LIR))
- distant reading (távoli olvasás)
-
Nagy szövegmennyiségben statisztikai módszerekkel mintázatokat kereső megközelítés, a szoros olvasás ellenpárja. (→ Adat a történettudományban)
- DOI
-
Digitális objektumazonosító; az adatpublikáció állandó, hivatkozható címe (lásd az ORCID és DOI fejezetet). (→ Adatok publikálása, dokumentáció, etika)
- DOI (Digital Object Identifier)
-
Digitális objektumazonosító: egyedi hivatkozás, amely információkat tartalmaz egy objektumról (pl. online dokumentumról vagy adatkészletről) és annak eléréséről. Biztosítja az online megjelenő közlemények egyértelmű azonosítását és hosszú távú elérhetőségét. (→ Szerzői és dokumentumazonosítók: ORCID és DOI)
- Dublin Core
-
Egyszerű, széles körben elfogadott metaadat-szabvány alapadatok tárolására. (→ Digitális forráskiadás)
E
- egyházi anyakönyv
-
1895 előtt a felekezetek által vezetett keresztelési, házassági és temetési nyilvántartás; nyelve gyakran latin vagy német. (→ Családfakutatás: felületek és forráskritika)
- elektronikus levéltári nyilvántartó rendszer
-
Egy levéltár hivatalos nyilvántartását tartalmazó, jogszabályok és szabványok szerint vezetett rendszer. (→ Elektronikus Levéltári Portál (ELP))
- elektronikus levéltári segédadatbázis
-
A levéltári anyag valamilyen szempontú, a hivatalos nyilvántartáson kívüli csoportosítása, tematikus vagy időrendi gyűjteményekbe rendezve. (→ Elektronikus Levéltári Portál (ELP))
- elhangzó szöveg
-
A hangos híradók narrációjának átirata; a korabeli nyilvánosság nyelvének közvetlen forrása. (→ Filmhíradók Online: a mozgókép mint forrás)
- elsődleges forrás
-
Olyan forrás, amely közvetlenül a vizsgált korszakból vagy eseményből származik, és nem rétegződik közé egy későbbi értelmezés. (→ Mi a forrás?)
- elsődleges kulcs (primary key)
-
A táblán belül minden rekordot egyedileg azonosító mező; nem lehet üres, és nem változik. (→ Mi az adatbázis?)
- entitás
-
Az adatmodell egy önálló objektumtípusa (személy, intézmény, esemény, hely). (→ Adatbázisépítés saját adatokon (haladó))
- entitástár
-
A kiadásban azonosított személyek, helyek, intézmények és művek nyilvántartása, amelyhez a szövegben szereplő említések hozzákapcsolódnak. (→ Digitális forráskiadás)
- eszközkritika
-
Annak módszeres vizsgálata, hogy egy digitális eszköz felépítése és tartalmi lefedettsége miként befolyásolja a kutatás eredményét. (→ Digitális bölcsészet és digitális történettudomány)
- Europeana
-
Az Európai Unió támogatásával működő közös hozzáférési pont Európa digitalizált kulturális örökségéhez; több mint kétezer intézmény anyagát aggregálja. (→ Europeana: európai közgyűjtemények egy felületen)
F
- FAIR alapelvek
-
Megtalálható, hozzáférhető, interoperábilis, újrahasználható – a nyílt adatpublikálás négy követelménye. (→ Adatok publikálása, dokumentáció, etika)
- fakszimile kiadás
-
Az eredeti dokumentum képi megjelenítése digitalizált formában, az eredeti külalak megőrzésével. (→ Digitális forráskiadás)
- fazetta
-
A rendszer által felkínált, előre paraméterezett szűrési lehetőség a találati listán. (→ Elektronikus Levéltári Portál (ELP))
- felbontás (dpi)
-
A digitalizált kép részletgazdagságának mértéke; szöveghez legalább 300 dpi, kézirathoz 600 dpi ajánlott. (→ Digitalizálás és optikai karakterfelismerés (OCR))
- felhőalapú tárhely
-
Interneten keresztül elérhető tárolószolgáltatás, amely helyfüggetlen hozzáférést, verziókövetést és közös munkát tesz lehetővé. (→ Adatkezelés és adatvédelem)
- feltételesen megengedett használat
-
Olyan MI-használat, amely csak meghatározott feltételek – BA szinten az oktató előzetes írásbeli engedélye, teljes dokumentáció és kritikai értékelés – mellett engedélyezett. (→ Mesterséges intelligencia a történeti kutatásban)
- filmhíradó
-
Rendszeresen készülő, mozikban a főfilm előtt vetített összeállítás önálló híradásokból; a televízió elterjedése előtt az egyetlen mozgóképes hírműfaj. (→ Filmhíradók Online: a mozgókép mint forrás)
- FKERES (VLOOKUP)
-
Táblázatkezelő függvény, amely egy azonosító alapján egy másik tartományból hoz be értéket; két munkalap összekapcsolására használják, de oszlopbeszúrásra törékeny. (→ A táblázattól az adatbázisig: Excel és Access (haladó))
- fond
-
Egy iratképző szerv szervesen összetartozó iratanyaga; a levéltári rendszerezés legfelső szintje. (→ A magyar levéltári rendszer és a levéltári források)
-
Levéltári alapfogalom: egy iratképző szerv (például egy minisztérium, egy megyei közgyűlés) iratainak szervesen összetartozó egysége; a levéltári rendszerezés legfelső szintje. A teljes hivatkozáshoz a fond mellett az állag, a sorozat és a tétel is szükséges. (→ Hungaricana Közgyűjteményi Portál)
- forrás
-
Minden olyan dokumentum, tárgy vagy emlék, amely a múltról közvetlen vagy közvetett információt hordoz, és amelynek alapján a történész következtetéseket vonhat le. A forrásként való azonosítás kérdésfüggő. (→ Mi a forrás?)
- forrásközlő oldal
-
Olyan digitális felület, amely nem kereshető adatbázis, hanem szerkesztői válogatásban, böngészhető szerkezetben tesz közzé forrásokat. (→ Tüntetések, demonstrációk 1988–1989)
- forráskritika
-
A források megbízhatóságának, keletkezési körülményeinek és torzításainak módszeres vizsgálata; külső és belső kritikára osztható. (→ Hogyan épül fel egy történeti kutatás?)
-
Az a módszertani eljárás, amellyel a történész a forrásokhoz kapcsolódó kérdéseket szisztematikusan felteszi (mikor, ki, miért, mit állít, milyen torzítással). (→ Mi a forrás?)
- Fortepan
-
Szabad felhasználású, közösségi fotóarchívum; anyaga adományokból áll, a leírásokat önkéntes szerkesztők írják. (→ Fortepan: közösségi fotóarchívum)
- fotóhagyaték
-
Egy fotós vagy egy család teljes fennmaradt képanyaga; korpuszként elemezve többet mond, mint az egyes képek külön-külön. (→ Fortepan: közösségi fotóarchívum)
G
- geokódolás
-
Az a folyamat, amely során a történeti adatokhoz földrajzi koordinátákat rendelünk hozzá, lehetővé téve azok térbeli megjelenítését. (→ Budapest Időgép)
-
Szöveges helymegjelölés (cím, településnév, helyrajzi szám) átalakítása koordinátává; kiindulópontja egy adat. (→ Térbeli adatbázisok: amikor az adat egy helyhez tartozik)
- georeferálás
-
Digitalizált térkép pontjainak valós koordináta-rendszerhez rendelése (részletesen lásd a Budapest Időgép fejezetben). (→ Digitális bölcsészet és digitális történettudomány)
-
Történeti térkép mai koordinátarendszerbe illesztése, amelynek révén a lapok egymásra fektethetők és összehasonlíthatók. (→ Digitalizált sajtó és térkép: az Arcanum forrásgyűjteményei)
-
Digitalizált térkép pontjainak valós koordináta-rendszerhez illesztése; kiindulópontja egy kép. (→ Térbeli adatbázisok: amikor az adat egy helyhez tartozik)
- georeferált térkép
-
Olyan digitális vagy digitalizált térkép, amelynek minden pontja hozzá van rendelve a Föld egy valós koordináta-rendszeréhez (pl. EOV vagy WGS 84). A beszkennelt raszteres képet néhány jól azonosítható pont vagy objektum segítségével kell ráilleszteni egy georeferált alaptérképre. (→ Budapest Időgép)
- gráfadatbázis
-
Csomópontokból (entitások) és élekből (kapcsolatok) álló adatbázis; a hálós modell mai megfelelője, prozopográfiai kapcsolathálók tárolására alkalmas. (→ Mi az adatbázis?)
- gyűjtemény (collection)
-
Tematikus mappa a Zoteróban a bibliográfiai tételek rendszerezésére. (→ Hivatkozáskezelés: a Zotero)
- gyűjtőkör
-
Annak meghatározása, hogy egy adatbázis mit vesz fel és mit nem; ismerete nélkül egy hiányzó találat nem értelmezhető. (→ Térbeli adatbázisok: amikor az adat egy helyhez tartozik)
H
- hallucináció
-
Az a jelenség, amikor az MI valósnak látszó, de nem létező információt (például bibliográfiai tételt vagy levéltári jelzetet) állít elő. (→ Mesterséges intelligencia a történeti kutatásban)
- hálózatelemzés
-
Kapcsolatok rendszerének (személyek, intézmények, szövegek közötti kötések) kvantitatív vizsgálata. (→ Digitális bölcsészet és digitális történettudomány)
- hálózati személy
-
Az a személy, aki az állambiztonsági szervezetek számára titokban, fedéssel és fedőnévvel jelentést adott, vagy ilyen jellegű beszervezési nyilatkozatot írt alá, vagy ilyen tevékenységért előnyben részesült. (→ Állambiztonsági archontológia)
- harmadlagos forrás
-
Olyan forrás, amely a másodlagos irodalmat foglalja össze (kézikönyv, lexikon, Wikipédia-szócikk). Tudományos hivatkozásra ritkán használjuk. (→ Mi a forrás?)
- helyrajzi szám
-
Az ingatlan hivatalos, közigazgatási azonosítója; történeti anyagon stabilabb hivatkozási alap, mint a házszám. (→ Térbeli adatbázisok: amikor az adat egy helyhez tartozik)
- helységnévtár
-
Segédkönyv, amely rögzíti, hogy egy település mikor milyen néven és melyik közigazgatási egységben szerepelt; nélküle a történeti földrajzi adat értelmezhetetlen. (→ Az Arcanum tudományos gyűjteményei)
- hiányzó kópia
-
Olyan rekord, amelynek adatai ismertek, de a filmfelvétel nem maradt fenn; negatív bizonyítékként hivatkozható. (→ Filmhíradók Online: a mozgókép mint forrás)
- hierarchikus adatbázis
-
Fa struktúrájú adatmodell, amelyben minden elemnek egy szülője van; ma XML-alapú formában (EAD, TEI) él tovább. (→ Mi az adatbázis?)
- historiográfia
-
A történetírás története; egy téma kutatástörténete, a korábbi értelmezések és viták számbavétele. (→ Hogyan épül fel egy történeti kutatás?)
- hivatásos alkalmazott
-
Az a személy, aki az állambiztonsági szervezetekkel hivatásos szolgálati viszonyban állt, ideértve a „titkos” és a „szigorúan titkos” állományú munkatársakat is (2003. évi III. törvény 1. § (2) 4.). (→ Levéltári Információs Rendszer (LIR))
-
Az a személy, aki az állambiztonsági szervezetekkel hivatásos szolgálati viszonyban állt, ideértve a „titkos” és a „szigorúan titkos” állományú munkatársakat is. (→ Állambiztonsági archontológia)
- hivatkozási stílus
-
Formai szabályrendszer, amely meghatározza a hivatkozások és az irodalomjegyzék felépítését (pl. Korall, APA, Chicago). (→ Hivatkozáskezelés: a Zotero)
- hivatkozáskezelő rendszer
-
Szoftver, amely bibliográfiai adatokat gyűjt és rendszerez, és a szövegszerkesztővel együttműködve automatikusan generálja a hivatkozásokat és az irodalomjegyzéket. (→ Hivatkozáskezelés: a Zotero)
- hozzájárulási nyilatkozat
-
Az interjúalany által aláírt dokumentum, amelyben meghatározza, milyen feltételekkel használható fel később az elbeszélése: megnevezhető-e, archiválható-e, felhasználható-e másodelemzéshez. (→ Oral history: az elbeszélt emlékezet mint forrás)
- HTR (handwritten text recognition)
-
Kézírás-felismerés: a kézzel írt szövegek gépi olvasására szolgáló, betanítást igénylő eljárás (pl. Transkribus). (→ Digitális forráskiadás)
- HTR (kézírás-felismerés)
-
Kézzel írt szövegek gépi olvasása; eredménye nem biztos átirat, hanem valószínűségi becslés. (→ AdatbázisokOnline: a levéltári adatbázisok gyűjtőhelye)
- HTR (kézírásfelismerés)
-
Kifejezetten kézírásos szövegek gépi felismerésére szolgáló technológia (pl. Transkribus). (→ Digitalizálás és optikai karakterfelismerés (OCR))
I
- idegen kulcs (foreign key)
-
Egy másik tábla elsődleges kulcsára hivatkozó mező, amely kapcsolatot teremt a két tábla között. (→ Mi az adatbázis?)
- idézettség
-
Annak mérőszáma, hányszor hivatkoztak egy műre; a téma feltárásában a hivatkozó munkák gyakran fontosabbak, mint a kiindulási mű. (→ Cikkszintű és nemzetközi keresés)
-
Annak mutatója, hogy egy publikációra hány másik tudományos munka hivatkozik. (→ Magyar Tudományos Művek Tára (MTMT))
- időmetszet (állapotfelvétel)
-
Olyan adatmodell, amely nem folyamatot, hanem egyetlen időpont állapotát rögzíti; rekordjai közvetlenül összevethetők, de a változásról nem tud beszámolni. (→ Térbeli adatbázisok: amikor az adat egy helyhez tartozik)
- idővonal
-
Olyan felhasználói felület, amely az eseményeket időrendi sorrendben jeleníti meg. (→ Tüntetések, demonstrációk 1988–1989)
- index
-
Egy forrás adatainak kereshetővé tett kivonata; megtaláló eszköz, nem forrás. (→ Családfakutatás: felületek és forráskritika)
- intézményi hozzáférés
-
Az egyetem előfizetése révén elérhető tartalom; belépés nélkül ugyanaz a felület mást mutat. (→ Cikkszintű és nemzetközi keresés)
- inzert (inzertszöveg)
-
A néma filmhíradókban a képre írt felirat; a felületen betűhív átiratban szerepel, és kereshető. (→ Filmhíradók Online: a mozgókép mint forrás)
- ISBN
-
Nemzetközi Szabványos Könyvazonosító: 13 (2007 előtt 10) számjegyű kód könyvek és önálló kiadványok azonosítására. (→ Szerzői és dokumentumazonosítók: ORCID és DOI)
J
- jelszókezelő
-
Alkalmazás, amely titkosított formában tárolja a jelszavainkat; egyetlen mesterjelszóval nyitható. (→ Adatkezelés és adatvédelem)
- jogállapot-jelzés (rights statement)
-
A szolgáltató intézmény nyilatkozata a digitális másolat jogi helyzetéről; nem azonos a mű tényleges jogi státuszával. (→ Europeana: európai közgyűjtemények egy felületen)
- JOIN (összekapcsolás)
-
Adatbázis-művelet, amely két táblát a közös kulcsmező mentén kapcsol össze; az FKERES tartós, karbantartást nem igénylő megfelelője. (→ A táblázattól az adatbázisig: Excel és Access (haladó))
K
- kapcsolótábla
-
Két tábla közé iktatott harmadik tábla, amely az N:M kapcsolatot azonosítópárokra bontja. (→ Mi az adatbázis?)
- kegyeleti jog
-
A Ptk. által védett jog, amely alapján a hozzátartozók felléphetnek elhunyt személy személyhez fűződő jogának sérelme esetén. (→ Adatok publikálása, dokumentáció, etika)
- képaláírás
-
A képhez utólag rendelt leíró szöveg; nem a forrás része, hanem megállapítás, amely több tudásréteget kever. (→ Fortepan: közösségi fotóarchívum)
- kétfaktoros azonosítás
-
A jelszó mellé második védelmi vonalat állító eljárás, jellemzően hitelesítő alkalmazás által generált kóddal. (→ Adatkezelés és adatvédelem)
- kétrétegű PDF
-
Olyan PDF-fájl, amely a dokumentum grafikai megjelenítése mellett egy szövegként azonosítható réteget is tartalmaz. (→ Digitalizálás és optikai karakterfelismerés (OCR))
- kettős datálás
-
Az az elv, hogy egy visszaemlékező forrásnál mindig két időpontot kell megadni és figyelembe venni: az elbeszélt eseményét és az elbeszélés keletkezéséét. (→ Oral history: az elbeszélt emlékezet mint forrás)
- kifejezéskeresés (idézőjeles keresés)
-
Több szóból álló kifejezés keresése egyetlen egységként, idézőjelek közé zárva; enélkül a kereső a szavak külön-külön előfordulását is elfogadja. (→ Digitalizált sajtó és térkép: az Arcanum forrásgyűjteményei)
- kliometria
-
Közgazdasági modellek tesztelése történeti anyagon. (→ Adat a történettudományban)
- kódkönyv (data dictionary)
-
Az adatbázis oszlopainak leírása: típus, lehetséges értékek, jelentés. (→ Adatok publikálása, dokumentáció, etika)
- kódtábla
-
Feloldó tábla, amely a szabad szöveges értékeket szabványosított kategóriákhoz rendeli. (→ Adatbázisépítés saját adatokon (haladó))
- kontrollforrás
-
Olyan további forrás, amellyel egy adat hitelessége ellenőrizhető (például parancsgyűjtemények aláírás–beosztás párjai az önéletrajzi adatok mellett). (→ Állambiztonsági archontológia)
- könyvtári katalógus
-
Egy vagy több könyvtár állományának nyilvántartása; arról ad választ, hogy egy mű fizikailag hol érhető el és kölcsönözhető-e. (→ Könyvtári keresőfelületek: katalógusok és közös keresők)
- korrektúrázott szöveg
-
Kézi szedéssel vagy utólagos emberi javítással készült digitális szöveg, szemben az OCR nyers kimenetével; itt a negatív találat erős bizonyíték. (→ Az Arcanum tudományos gyűjteményei)
- kötelespéldány
-
Jogszabályi kötelezettség, amelynek alapján minden Magyarországon megjelent kiadványból ingyenes példányt kell beszolgáltatni; ezért teljes a nemzeti könyvtár katalógusa. (→ Könyvtári keresőfelületek: katalógusok és közös keresők)
- közgyűjtemény
-
Olyan intézmény (levéltár, könyvtár, múzeum), amely közfeladatként őriz és tesz hozzáférhetővé kulturális javakat. (→ Hungaricana Közgyűjteményi Portál)
- közirat
-
Minden olyan irat, amely közfeladatot ellátó szerv irattári anyagába tartozik vagy tartozott, a keletkezés idejétől és az őrzés helyétől függetlenül. (→ A magyar levéltári rendszer és a levéltári források)
- közkincs (public domain)
-
Olyan mű, amelynek szerzői jogi védelmi ideje lejárt (Magyarországon a szerző halálától számított 70 év után), és így szabadon felhasználható. (→ Digitális forráskiadás)
- közlevéltár
-
A nem selejtezhető köziratokkal kapcsolatos levéltári feladatokat végző, közfeladatot ellátó szerv által fenntartott levéltár. (→ A magyar levéltári rendszer és a levéltári források)
- közös kereső (discovery)
-
Olyan keresőfelület, amely több független adatbázist szólít meg egyetlen űrlapról, és a válaszokat egységes formában jeleníti meg. (→ Könyvtári keresőfelületek: katalógusok és közös keresők)
- kritikai kiadás
-
A szöveg átírása jegyzetekkel, kritikai megjegyzésekkel és a szövegváltozatok bemutatásával. (→ Digitális forráskiadás)
- különleges adat
-
Szenzitív személyes adat: etnikai, faji származásra, politikai, vallási vagy világnézeti meggyőződésre utaló, illetve genetikai, biometrikus és egészségügyi adat. (→ Adatkezelés és adatvédelem)
- külső kritika
-
A forráskritika része, amely a forrás formai és anyagi sajátosságait vizsgálja: valódi-e, mikor keletkezett, ki készítette. (→ Mi a forrás?)
- kutatási kérdés
-
A kutatás vezérkérdése, amely időben és térben behatárolt, a források alapján megválaszolható, releváns és elemzésre ösztönző. (→ Hogyan épül fel egy történeti kutatás?)
- kutató
-
„A levéltárban érvényes látogatói jeggyel rendelkező, a levéltár által őrzött levéltári anyagban kutatást végző személy.” (Levéltári fogalomtár) (→ Levéltári Információs Rendszer (LIR))
L
- lapos (flat file) adatbázis
-
Egyetlen táblából álló adatbázis kapcsolatok nélkül; kis, egyszerű listákhoz alkalmas. (→ Mi az adatbázis?)
- leírás szintje
-
„A leírási egység helye a fond hierarchiájában.” (ISAD(G) fogalomtár) (→ Levéltári Információs Rendszer (LIR))
- leírási egység
-
A levéltári nyilvántartás egy rekordja, amely egy adott szintű iratanyagot (fond, állag, sorozat, tétel, darab) ír le. (→ Elektronikus Levéltári Portál (ELP))
-
A levéltári (leírási) egység önálló entitásként kezelt digitális megfelelője. Az ÁBTL-ben – az ISAD(G) leírástól eltérően – nemcsak a jelenleg fizikai formában létező dokumentumokat vagy dokumentumegyütteseket jelenti, hanem azoknak az iratoknak a digitális leképezését is magában foglalhatja, amelyek egykor (más iratok által bizonyíthatóan) léteztek, és metaadataik segítségével részben rekonstruálhatók. (ISAD(G) fogalomtár) (→ Levéltári Információs Rendszer (LIR))
- levéltári anyag
-
Az irattári anyagnak, továbbá a természetes személyek iratainak levéltárban őrzött maradandó értékű része, valamint a védetté nyilvánított maradandó értékű magánirat. (→ A magyar levéltári rendszer és a levéltári források)
- levéltári egység
-
„A levéltári anyag levéltári vertikális tagolódása (rendszerezés, rendezés) során keletkező része, amelynek a rendszerbeli helyét levéltári szintnek nevezzük.” Megkülönböztetünk felső szintű (levéltári intézmény anyaga, fondfőcsoport, szekció, levéltár, fondcsoport, fond, állag), középszintű (fősorozat, sorozat, alsorozat, kútfő, tétel, altétel) és alsó szintű (ügyirat, ügyiratdarab, egyes irat) levéltári egységeket. (Levéltári fogalomtár) (→ Levéltári Információs Rendszer (LIR))
- levéltári jelzet
-
Az iratanyag szabványos azonosítója, amely az országkódot, az intézmény azonosítóját és a hierarchia szintjeit tartalmazza; levéltári forrásra ezzel kell hivatkozni. (→ A magyar levéltári rendszer és a levéltári források)
-
Az iratanyag szabványos azonosítója, amely az országkódot, az intézmény azonosítóját és a hierarchia szintjeit tartalmazza. (→ Elektronikus Levéltári Portál (ELP))
-
„Levéltári egység egyedi azonosítására alkalmas kód, amely számok, betűk, írásjelek és szóközök rendszeréből áll”, és a legmagasabb levéltári szintből kiindulva tartalmazza mindazon levéltári egységek jelzeteit, amelyekbe az adott egység beletartozik. Nemzetközi adatcseréhez nélkülözhetetlen, ezért célszerű, ha tartalmazza az országot és a levéltári intézményt azonosító kódot, valamint a leírási egység egyedi azonosítóját is. (Levéltári fogalomtár) (→ Levéltári Információs Rendszer (LIR))
- levéltári struktúra
-
A levéltári anyag hierarchikus rendje, amely a fondtól az egyes iratokig tagolja az állományt. (→ Elektronikus Levéltári Portál (ELP))
- LOCKSS
-
Lots of Copies Keep Stuff Safe: a több helyen tárolás megőrzési elve. (→ Adatok publikálása, dokumentáció, etika)
M
- MACSE
-
Magyar Családtörténet-kutató Egyesület; amatőr kutatók önkéntes adatfelajánlásaiból épített adattárakat működtet. (→ Családfakutatás: felületek és forráskritika)
- magabiztossági küszöb
-
Beállítható érték, amely megszabja, mennyire legyen biztos a gépi felismerés ahhoz, hogy a találat megjelenjen; a kutatásban dokumentálandó paraméter. (→ AdatbázisokOnline: a levéltári adatbázisok gyűjtőhelye)
- maradandó értékű irat
-
Olyan irat, amely a történelmi múlt kutatásához, a közfeladatok ellátásához vagy az állampolgári jogok érvényesítéséhez nélkülözhetetlen, más forrásból nem vagy csak részlegesen megismerhető adatot tartalmaz. (→ A magyar levéltári rendszer és a levéltári források)
- másodelemzés
-
Egy korábbi kutatás céljára felvett anyag újraolvasása egy másik kutatási kérdés szempontjából; a kvalitatív kutatási archívumok egyik fő célja, hogy ezt lehetővé tegyék. (→ Oral history: az elbeszélt emlékezet mint forrás)
- másodlagos forrás
-
Olyan forrás, amelyet egy későbbi szerző készített az elsődleges források alapján, és amely már értelmezést is tartalmaz (monográfia, szakcikk, tankönyv). (→ Mi a forrás?)
- MATARKA
-
Magyar folyóiratok tartalomjegyzékeinek kereshető adatbázisa; a Miskolci Egyetem Könyvtár, Levéltár, Múzeum üzemelteti, ingyenes. (→ Cikkszintű és nemzetközi keresés)
- megbízható MI-szolgáltatás
-
Az egyetem szerződéses keretében, egyetemi fiókkal használt MI-környezet (a dékáni utasítás példája: az egyetemi Teams, Copilot). Csak a szerzői jogvédett tartalom bemenetként való használatát oldja fel; a személyes adatokra és a képzési szintű tiltásokra vonatkozó szabályokat nem érinti. (→ Mesterséges intelligencia a történeti kutatásban)
- mesterjelszó
-
Az a jelszó, amellyel a jelszókezelő tartalmához hozzáférünk. (→ Adatkezelés és adatvédelem)
- metaadat
-
Az iratokhoz vagy leírási egységekhez kapcsolódó strukturált információ, amely segíti azok azonosítását, kezelését, visszakeresését, értelmezését és hosszú távú megőrzését. (Levéltári fogalomtár alapján) (→ Levéltári Információs Rendszer (LIR))
-
A digitális dokumentumot leíró, rendszerező és kontextusba helyező információ; lehet deskriptív vagy technikai. (→ Digitális forráskiadás)
-
Egy dokumentumról szóló, strukturált leíró adat (szerző, cím, dátum, jelzet, terjedelem); a katalogizálás alapja. (→ Hungaricana Közgyűjteményi Portál)
- MI-használati nyilatkozat
-
A beadott írásműhöz csatolt, aláírt dokumentum, amelyben a hallgató számot ad arról, használt-e MI-eszközt, és ha igen, milyen céllal, milyen módon, melyiket és a dolgozat mely részében. A szakdolgozat kötelező eleme; a valótlan tartalmú nyilatkozat a plágiummal azonos megítélés alá esik. (→ Mesterséges intelligencia a történeti kutatásban)
- mikrotörténet
-
Olyan történetírási irányzat és módszer, amely a makroszintű folyamatok helyett egy kisebb, jól behatárolható egységet – egyetlen eseményt, személyt, családot vagy közösséget – vizsgál nagy alapossággal. (→ Budapest Időgép)
-
Olyan történetírási irányzat és módszer, amely a makroszintű folyamatok helyett egy kisebb, jól behatárolható egységet vizsgál nagy alapossággal. (→ Állambiztonsági archontológia)
- munkafüzet és munkalap
-
A táblázatkezelő fájlja (munkafüzet) és annak egy-egy lapja (munkalap); ökölszabály: egy munkalap egy jól körülhatárolt téma. (→ A táblázattól az adatbázisig: Excel és Access (haladó))
N
- nagy nyelvi modell
-
Statisztikai mintafelismerő rendszer, amely nagy szövegmennyiségen tanult, és valószínűségeket számol a következő szó előrejelzésére. (→ Mesterséges intelligencia a történeti kutatásban)
- névtér
-
Azonosított entitások (személy, testület, hely) nyilvántartása, amelyre betűsor helyett lehet keresni. (→ AdatbázisokOnline: a levéltári adatbázisok gyűjtőhelye)
- névtéradatbázis
-
Szabványosított névazonosítókat tartalmazó adatbázis, amely lehetővé teszi, hogy különböző gyűjtemények ugyanarra a személyre ugyanazzal az azonosítóval hivatkozzanak. (→ Digitális forráskiadás)
- névváltoztatás (névmagyarosítás)
-
Hivatalos családnév-változtatás; ha a kutató nem tud róla, ugyanaz a család két néven, egymástól elszakadva jelenik meg a forrásokban. (→ Családfakutatás: felületek és forráskritika)
- nézői címke
-
Regisztrált felhasználó által megadott címke; keresési segédlet, de nem forrásértékű állítás. (→ Filmhíradók Online: a mozgókép mint forrás)
- normalizálás
-
Az adatbázis szerkezetének olyan átalakítása, amely minimalizálja a redundanciát és maximalizálja az adatintegritást. (→ Mi az adatbázis?)
- NoSQL
-
Gyűjtőfogalom a nem relációs adatbázis-modellekre (Not Only SQL); rugalmas szerkezet és vízszintes skálázhatóság jellemzi. (→ Mi az adatbázis?)
- nyilvános magánlevéltár
-
Nem közfeladatot ellátó szerv vagy természetes személy által fenntartott, nyilvánosan kutatható levéltár; legfontosabb csoportjuk az egyházi levéltáraké. (→ A magyar levéltári rendszer és a levéltári források)
O
- OAI-PMH
-
Nyílt szabvány, amely a repozitóriumok metaadatainak gépi begyűjtését és más rendszerekbe való áttöltését teszi lehetővé. (→ Repozitóriumok és nyílt hozzáférés)
- OCR (optikai karakterfelismerés)
-
Kép típusú dokumentumból automatikusan előállított gépi szöveg; minősége a forrás állapotától, a betűtípustól és a szkennelési minőségtől függ. (→ Hungaricana Közgyűjteményi Portál)
- oldalszintű találat
-
Olyan keresési eredmény, amely nem egy dokumentumot, hanem egy dokumentum egy konkrét oldalát azonosítja. (→ Szaktárs: magyar szakkönyvek egy felületen)
-
Olyan keresési eredmény, amely nem egy megnevezett cikkre, hanem egy teljes újságoldalra mutat. (→ Digitalizált sajtó és térkép: az Arcanum forrásgyűjteményei)
- online repozitórium
-
Digitális archívum, amely tudományos publikációkat és forrásokat tesz szabadon vagy korlátozott hozzáféréssel elérhetővé. (→ Könyvtári keresőfelületek: katalógusok és közös keresők)
-
Digitális archívum, amely tudományos publikációkat és kutatási anyagokat tesz szabadon vagy korlátozott hozzáféréssel elérhetővé. (→ Magyar Tudományos Művek Tára (MTMT))
-
Digitális archívum, amely tudományos publikációkat és kutatási anyagokat tesz szabadon vagy korlátozott hozzáféréssel elérhetővé. (→ Repozitóriumok és nyílt hozzáférés)
-
Non-profit, intézményi hátterű digitális archívum, amely nyílt szabványok szerint teszi elérhetővé a tudományos publikációkat. (→ Academia.edu és ResearchGate)
- Open Access (nyílt hozzáférés)
-
A tudományos publikációk ingyenes, akadálymentes online elérhetősége. (→ Repozitóriumok és nyílt hozzáférés)
-
A tudományos publikációk ingyenes, akadálymentes online elérhetősége. (→ Academia.edu és ResearchGate)
- operatív kapcsolat
-
Az a személy, akit az állambiztonsági szervezetek „társadalmi kapcsolatként” vagy „alkalmi kapcsolatként” tartottak nyilván. (→ Állambiztonsági archontológia)
- optikai karakterfelismerés (OCR)
-
Technológia, amely a beszkennelt papírokat, PDF-fájlokat vagy digitális fényképeket szerkeszthető és kereshető szöveges adatokká alakítja át. (→ Digitalizálás és optikai karakterfelismerés (OCR))
- oral history
-
Kutatási módszer és forrástípus: kutatási céllal készített, rögzített és archivált visszaemlékező interjú egy esemény, folyamat vagy élethelyzet részesével vagy tanújával. (→ Oral history: az elbeszélt emlékezet mint forrás)
- ORCID (Open Researcher and Contributor ID)
-
Ingyenesen létrehozható, egyedi és tartós, 16 karakterből álló kutatói azonosító. Egyértelműen összekapcsolja a kutatót tudományos munkásságával, függetlenül attól, hogy a neve milyen formában jelenik meg, vagy hogy pályafutása során mely intézményben, országban vagy tudományterületen dolgozik. (→ Szerzői és dokumentumazonosítók: ORCID és DOI)
P
- paradigma
-
Értelmezési minta, amelyen belül egy adott korszak történészei a kérdéseiket megfogalmazzák; folyamatosan változik. (→ Hogyan épül fel egy történeti kutatás?)
- PDF/A
-
Archiválási célra optimalizált PDF-formátum, amely a hosszú távú olvashatóságot biztosítja, és tartalmazhat OCR-szövegréteget. (→ Digitalizálás és optikai karakterfelismerés (OCR))
- pertinencia elve
-
A proveniencia ellentéte: az iratok tárgy, hely vagy idő szerinti rendezése. Ma kivételes; jellemzően a középkori oklevélgyűjteményeknél és a tervtáraknál találkozni vele. (→ A magyar levéltári rendszer és a levéltári források)
- perzisztens link
-
Egy digitális dokumentum stabil, hosszú távon érvényes webcíme. A keresési vagy böngészési URL gyakran változó, a perzisztens link nem. (→ Hungaricana Közgyűjteményi Portál)
- pontadat
-
Egyetlen koordinátával azonosított hely az adatbázisban; sűrűség és elhelyezkedés vizsgálatára jó, területi állításra nem. (→ Térbeli adatbázisok: amikor az adat egy helyhez tartozik)
- possessor
-
Egy régi könyv vagy kézirat korábbi tulajdonosa; a nemzeti könyvtár katalógusában önálló keresőmező. (→ Könyvtári keresőfelületek: katalógusok és közös keresők)
- prompt
-
Az MI-nek adott utasítás vagy kérdés, amely meghatározza a kívánt kimenetet. Ahol a szakos szabályozás előírja, a nyilatkozatban a promptolást is pontosan dokumentálni kell. (→ Mesterséges intelligencia a történeti kutatásban)
- prompt engineering
-
Az utasítás olyan megszerkesztése, amelyet a generatív modell értelmezni és végrehajtani tud; jellemzői: világos, specifikus, strukturált. (→ Mesterséges intelligencia a történeti kutatásban)
- protokoll (interjúé)
-
A kérdező feljegyzése magáról az interjúhelyzetről – körülmények, jelenlévők, a felvételen kívül elhangzottak –, rendszerint rövid életrajzi összefoglalóval együtt. (→ Oral history: az elbeszélt emlékezet mint forrás)
- proveniencia elve
-
A levéltári rendezés alapelve: egy iratképző szerv anyagát nem szabad más szervek irataival összekeverni, és meg kell őrizni a szerv saját belső rendjét. (→ A magyar levéltári rendszer és a levéltári források)
- prozopográfia
-
Módszer, amely személyek egy csoportjának közös életrajzi jellemzőit vizsgálja a csoportra vonatkozó következtetések levonása érdekében. (→ Hogyan épül fel egy történeti kutatás?)
-
Kollektív életrajz: sok személy strukturált adatainak gyűjtése és elemzése egy csoport, hálózat vagy társadalmi réteg megismerése céljából. (→ Adat a történettudományban)
- publikációs lista
-
Egy szerző műveinek rendezett jegyzéke, az MTMT-ben automatikusan generált és karbantartott formában. (→ Magyar Tudományos Művek Tára (MTMT))
- publikus rekord
-
A LIR-ben olyan leírási egység vagy személyrekord, amelyet a levéltár bejelentkezés nélküli felhasználók számára is megjeleníthetőnek minősített. (→ Levéltári Információs Rendszer (LIR))
R
- RAG (visszakeresés-alapú generálás)
-
Olyan MI-megoldás, amely előbb egy megadott dokumentumgyűjteményben keres, és csak azután fogalmaz választ a megtalált szövegekből; ezért kevesebbet hallucinál és hivatkozni is tud a forrásaira. (→ Mesterséges intelligencia a történeti kutatásban)
- README
-
A repozitórium gyökerében álló dokumentáció, amely nélkül az adat nem értelmezhető. (→ Adatok publikálása, dokumentáció, etika)
- redundancia
-
Ugyanannak az adatnak a többszöri, felesleges tárolása; helypazarláshoz, nehézkes frissítéshez és inkonzisztenciához vezet. (→ Mi az adatbázis?)
- referenciális integritás
-
Az a szabály, amely garantálja, hogy az idegen kulcs mindig létező elsődleges kulcsra hivatkozik. (→ Mi az adatbázis?)
- referenciatábla (segédtábla)
-
A kódolt értékek külön tárolt listája, amelyből a legördülő menü és a hivatkozás dolgozik. (→ A táblázattól az adatbázisig: Excel és Access (haladó))
- regeszta
-
A forrás tartalmi kivonata, amely a teljes szöveg közlése helyett a lényegi információt rögzíti. (→ Digitális forráskiadás)
- reláció
-
Két entitás közötti kapcsolat (például személy–intézmény, személy–személy). (→ Adatbázisépítés saját adatokon (haladó))
- relációs adatbázis
-
Edgar F. Codd 1970-es modelljére épülő adatbázis, amelyben az adatok táblákban állnak, a táblák kulcsokkal kapcsolódnak, a lekérdezés pedig SQL-lel történik. (→ Mi az adatbázis?)
- relációs adatmodell
-
Több, egymással kapcsolatban álló táblába rendezett adatszerkezet. (→ Adatbázisépítés saját adatokon (haladó))
- remediáció
-
Az a folyamat, amelynek során egy közeg tartalma egy másik közegbe kerül át (pl. papír → digitális kép → OCR-szöveg), és amelynek során az eredeti és az új közeg sajátosságai egyaránt nyomot hagynak a forráson. (→ Mi a forrás?)
- repozitórium (adatrepozitórium)
-
Kutatási adatok tartós megőrzésére és közzétételére szolgáló szolgáltatás (pl. Zenodo, Dataverse, CLARIN). (→ Adatok publikálása, dokumentáció, etika)
- reprezentativitás
-
Annak kérdése, hogy a fennmaradt és vizsgált források mennyire tükrözik a vizsgált jelenség egészét. (→ Hogyan épül fel egy történeti kutatás?)
-
A forráskritika része, amely arra kérdez rá, hogy a fennmaradt forráshalmaz mit reprezentál a múltból, és mit hagy ki. (→ Mi a forrás?)
S
- Sankey-diagram
-
Áramlást ábrázoló ábratípus: azt mutatja, hogy egy kategóriából mennyi kerül át egy másikba. (→ Kutatási eredmények vizualizálása)
- scrollytelling
-
Görgetéssel vezetett, lépésenként épülő vizuális narratíva. (→ Kutatási eredmények vizualizálása)
- selejtezés
-
Az iratok meghatározott rend szerinti kiválogatása és megsemmisítése; a kutatható forrásbázis határa itt dől el. (→ A magyar levéltári rendszer és a levéltári források)
- Shibboleth
-
Intézményi azonosítási rendszer, amely lehetővé teszi, hogy az előfizető intézmény hallgatói otthonról is elérjék az előfizetett adatbázisokat. (→ Szaktárs: magyar szakkönyvek egy felületen)
- strukturálatlan adat
-
Szöveg, kép vagy hang formájában létező, előre definiált struktúra nélküli információ. (→ Adat a történettudományban)
- strukturált adat
-
Táblázatos formában, előre definiált mezőkkel létező adat. (→ Adat a történettudományban)
- szakmai címke
-
Az archívum feldolgozói által adott tárgyszó; az intézmény állítása, hivatkozható. (→ Filmhíradók Online: a mozgókép mint forrás)
- Szaktárs
-
A Szakkiadók Társulása adatbázisportálja: magyar szakkönyvkiadók műveinek közös, teljes szövegben kereshető felülete. (→ Szaktárs: magyar szakkönyvek egy felületen)
- személyes adat
-
Természetes személlyel kapcsolatba hozható minden adat, valamint az adatból levonható, az érintettre vonatkozó következtetés. (→ Adatkezelés és adatvédelem)
- személyiségi jog
-
A képen szereplő ember joga a képmásához; független attól, hogy a fotós szerzői jogi értelemben hozzájárult-e a felhasználáshoz. (→ Fortepan: közösségi fotóarchívum)
- szerkesztett életrajz
-
Interjúból készült, folyamatos elbeszéléssé formált szöveg, amely nem azonos a szó szerinti átirattal; a szerkesztés maga is értelmezői döntések sora. (→ Oral history: az elbeszélt emlékezet mint forrás)
- szervezettörténet
-
Egy adott intézmény, hivatal, vállalat vagy fegyveres testület belső struktúrájának, működési mechanizmusainak és felépítésének időbeli változását vizsgáló tudományterület. (→ Állambiztonsági archontológia)
- szolgáltató intézmény (providing institution)
-
Az a közgyűjtemény, amely a tárgyat őrzi és a digitális másolatot előállította; a hivatkozás mindig rá mutat. (→ Europeana: európai közgyűjtemények egy felületen)
- szövegbányászat
-
Nagy szövegmennyiségből automatizált módszerekkel mintázatok, összefüggések kinyerése. (→ Digitális bölcsészet és digitális történettudomány)
- szuffix (DOI-utótag)
-
A DOI pont utáni része, amelyet a kiadó vagy szerkesztőség állít össze saját séma szerint. (→ Szerzői és dokumentumazonosítók: ORCID és DOI)
T
- táblázatkezelő
-
Számolásra, elemzésre és vizualizációra tervezett program (Excel, Google Sheets, LibreOffice Calc); rugalmas, de nem kényszeríti ki az adatintegritást. (→ A táblázattól az adatbázisig: Excel és Access (haladó))
- takedown notice
-
Szerzői jogi jogosult által küldött felszólítás jogsértő tartalom eltávolítására. (→ Academia.edu és ResearchGate)
- tárgyszó
-
Ellenőrzött mező, amely azt rögzíti, miről szól a mű – szemben a szabad szavas kereséssel, amely csak a szó előfordulását keresi. (→ Könyvtári keresőfelületek: katalógusok és közös keresők)
- távolsági operátor
-
Keresési operátor (
nW,nN), amely megadott szótávolságon belül, kötött vagy szabad sorrendben keresi a kifejezéseket. (→ Szaktárs: magyar szakkönyvek egy felületen) -
Olyan keresőoperátor, amely két szó közötti legnagyobb távolságot szabja meg (
nWkötött,nNszabad sorrenddel). (→ Az Arcanum tudományos gyűjteményei) - TEI (Text Encoding Initiative)
-
Nemzetközi, XML-alapú kódolási szabvány történeti és irodalmi szövegek digitális kiadásához. (→ Digitális forráskiadás)
- teljes szöveges keresés
-
Olyan keresési mód, amely a dokumentum teljes szövegében (és nem csak a metaadatokban) keres. A Hungaricana esetében az OCR-szövegen alapul, ami egyúttal a hibaforrás is. (→ Hungaricana Közgyűjteményi Portál)
- teljes szövegű keresés
-
A dokumentum teljes szövegében végzett keresés, a metaadatoktól (cím, szerző, tárgyszó) függetlenül. (→ Szaktárs: magyar szakkönyvek egy felületen)
- térinformatika (GIS)
-
Interdiszciplináris tudományterület és informatikai eszközrendszer, amely a földrajzi helyhez kötött térbeli és leíró adatokat gyűjti, tárolja és elemzi. (→ Budapest Időgép)
- tiltott használat
-
A szabályzat által kifejezetten megtiltott MI-használat, amely a plágiummal azonos megítélés alá esik. (→ Mesterséges intelligencia a történeti kutatásban)
- transzparencia (MI-használatban)
-
Annak dokumentálása, hogy a kutató melyik eszközt mire és hogyan használta, és miként ellenőrizte az eredményt. (→ Mesterséges intelligencia a történeti kutatásban)
- tréningadat-torzítás (bias)
-
Az a jelenség, hogy az MI a tanítóadatok egyenetlenségeit (nyelvi, kulturális, perspektivikus túlsúlyokat) tükrözi és felerősíti. (→ Mesterséges intelligencia a történeti kutatásban)
- tudománymetria
-
Kvantitatív módszerekkel méri és elemzi kutatók, intézmények és kiadványok tudományos tevékenységét. (→ Magyar Tudományos Művek Tára (MTMT))
- tudományos keresőmotor
-
Olyan kereső, amely tudományos publikációk között keres, és rendszerint idézettségi adatokat is közöl (például Google Scholar). (→ Cikkszintű és nemzetközi keresés)
- tulajdonnév-index (entitáskeresés)
-
Olyan keresőmező, amely nem betűsorra, hanem a gép által személynek, helynek, intézménynek vagy eseménynek minősített névre keres. (→ Digitalizált sajtó és térkép: az Arcanum forrásgyűjteményei)
V
- validálás (validáció)
-
Az MI által generált eredmény emberi ellenőrzése és hitelesítése független, megbízható forrásból; az MI-használat kötelező kísérőlépése. (→ Mesterséges intelligencia a történeti kutatásban)
- válogatott forrás
-
Az adott eseményhez a szerkesztők által kiemelt forrásanyag; megkülönböztetendő az „összes forrás” nézettől. (→ Tüntetések, demonstrációk 1988–1989)
- várostörténet
-
A történettudomány és az urbanisztika interdiszciplináris ága, amely a városok keletkezését, fejlődését, térbeli szerkezetének változását, valamint a városi társadalom, gazdaság és igazgatás alakulását kutatja. (→ Budapest Időgép)
- védelmi idő
-
A személyes adatot tartalmazó levéltári anyag kutatási korlátozása: az érintett halálozási évét követő 30 év, illetve – ha a halálozás nem ismert – a születéstől számított 90 év, ha egyik sem ismert, az irat keletkezésétől számított 60 év. (→ A magyar levéltári rendszer és a levéltári források)
- vektorizálás
-
Térképi tartalom (utcavonalak, telekhatárok) rajzi elemekké alakítása, amelynek révén a térkép szövege és geometriája kereshetővé válik. (→ Térbeli adatbázisok: amikor az adat egy helyhez tartozik)
- vektorizált térkép
-
Olyan digitális térkép, amely pontokból, vonalakból és geometriai formákból épül fel; elemei kereshetők és szűrhetők. (→ Budapest Időgép)
- verziózás
-
Az eredeti és a feldolgozott adat párhuzamos megőrzése a visszakövethetőség érdekében. (→ Adatbázisépítés saját adatokon (haladó))
Z
- Zotero Connector
-
A Zotero böngészőbővítménye, amellyel egy kattintással menthetők a webes felületeken talált tételek bibliográfiai adatai. (→ Hivatkozáskezelés: a Zotero)
Linkgyűjtemény
A könyvben hivatkozott online eszközök és felületek gyűjteménye, a fejezetek „Linkek és eszközök” szakaszai alapján. A webes tartalmak változnak: minden tétel mellett szerepel az elérés dátuma.